Klasyfikacja ryzyka kredytowego za pomocą Rimay Quantum Feature Extraction firmy Kipu Quantum
Qiskit Functions to funkcja eksperymentalna dostępna tylko dla użytkowników planów IBM Quantum® Premium Plan, Flex Plan i On-Prem (przez IBM Quantum Platform API). Mają status wersji zapoznawczej i mogą ulec zmianie.
Szacowane zużycie: 2 minuty na procesorze Nighthawk r2. (UWAGA: To tylko szacunek. Twój czas wykonania może się różnić.)
Cele nauczania
-
Przygotuj dane tabelaryczne z kolumnami kategorialnymi i liczbowymi dla Qiskit Function Rimay.
-
Dopasuj kwantowe odwzorowanie cech na danych treningowych i odwzoruj dane testowe w tym samym uruchomieniu.
-
Wytrenuj klasyczne modele na kwantowo przekształconych cechach, samodzielnie i w połączeniu z oryginalnymi cechami.
-
Porównaj wyniki z czysto klasycznym punktem odniesienia.
Wymagania wstępne
Zanim zaczniesz ten samouczek, powinieneś znać następujące tematy:
-
Klasyfikacja nadzorowana z scikit-learn
Tło
Wiele problemów uczenia maszynowego w przemyśle dotyczy małych lub średnich zbiorów danych tabelarycznych, w których dodanie kolejnych danych nie wchodzi w grę, a dokładność modelu osiąga plateau. Typowym przykładem jest scoring ryzyka kredytowego. Kredytodawca na podstawie kilkudziesięciu atrybutów decyduje, czy wnioskodawca prawdopodobnie spłaci kredyt.
Rimay, Qiskit Function firmy Kipu Quantum, dodaje do takiego potoku kwantowy krok przetwarzania wstępnego. Implementuje algorytm cyfrowej kontradiabatycznej kwantowej ekstrakcji cech [1]. Każda cecha wejściowa jest odwzorowana na jeden kubit. Wartości cech oraz informacja wzajemna między cechami wyznaczają lokalne pola i sprzężenia hamiltonianu szkła spinowego. Dynamika kontradiabatyczna następnie ewoluuje układ kwantowy w stronę stanów o niskiej energii, a wartości oczekiwane jedno- i dwuciałowe zmierzone na końcu stają się nowymi, przekształconymi kwantowo cechami. Cechy te oddają nieliniowe korelacje między danymi wejściowymi i możesz je podać dowolnemu klasycznemu modelowi.
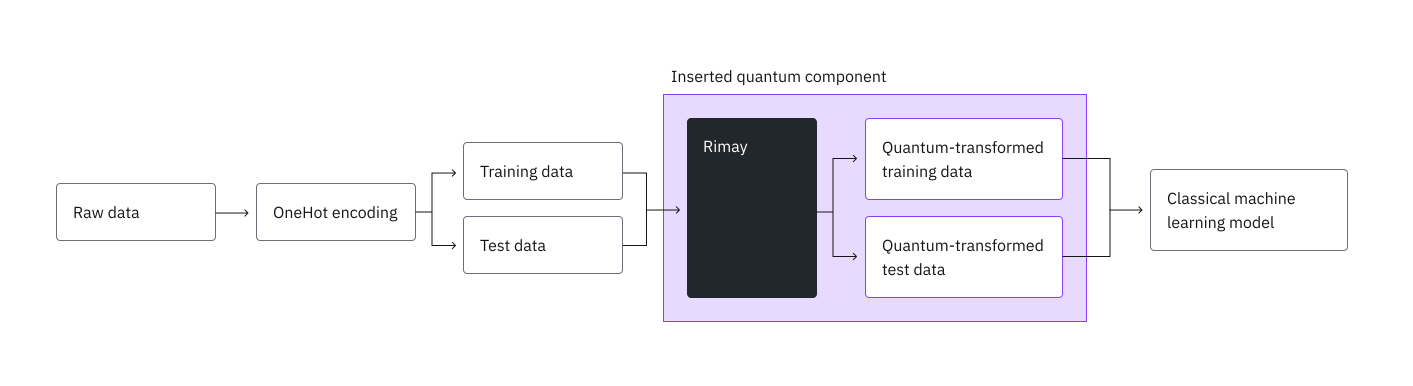
Ten samouczek używa zbioru danych German credit z OpenML [2], obejmującego 1000 wnioskodawców i 20 atrybutów, do wytrenowania klasyfikatora lasu losowego. Najpierw ustalasz klasyczny punkt odniesienia, potem wysyłasz dane do Rimay, a na koniec trenujesz ten sam rodzaj modelu na cechach przekształconych kwantowo, osobno oraz w połączeniu z oryginalnymi cechami.
Wymagania
Zanim zaczniesz ten samouczek, upewnij się, że masz zainstalowane następujące pakiety:
-
Klient IBM Quantum Compute (
pip install qiskit-ibm-runtime) -
Qiskit Functions (
pip install qiskit-ibm-catalog) -
scikit-learn (
pip install scikit-learn) -
pandas (
pip install pandas) -
Matplotlib (
pip install matplotlib)
Potrzebujesz też dostępu do funkcji Rimay z katalogu Qiskit Functions.
Konfiguracja
Zaimportuj pakiety i zdefiniuj dwie funkcje pomocnicze: jedną trenującą las losowy i drugą obliczającą metryki używane w całym samouczku.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "sklearn": "scikit-learn"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from sklearn.datasets import fetch_openml
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
    accuracy_score,
    f1_score,
    precision_score,
    recall_score,
    roc_auc_score,
)
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

def train_random_forest(x, y, n_estimators, max_depth):
    """Train a random forest classifier with fixed hyperparameters."""
    model = RandomForestClassifier(
        n_estimators=n_estimators,
        max_depth=max_depth,
        min_samples_split=5,
        min_samples_leaf=1,
        max_features="sqrt",
        random_state=42,
        n_jobs=-1,
    )
    return model.fit(x, y)

def evaluate(model, x, y):
    """Return the classification metrics of a trained model on a test set."""
    y_pred = model.predict(x)
    y_proba = model.predict_proba(x)[:, 1]
    return {
        "Accuracy": accuracy_score(y, y_pred),
        "AUC": roc_auc_score(y, y_proba),
        "F1 score": f1_score(y, y_pred),
        "Precision": precision_score(y, y_pred),
        "Recall": recall_score(y, y_pred),
    }
Skonfiguruj poświadczenia IBM Quantum
Uwierzytelnij się za pomocą klucza API IBM Quantum Platform, załaduj funkcję Rimay i wybierz najmniej obciążony procesor kwantowy dostępny w Twojej instancji.
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
rimay = catalog.load("kipu-quantum/rimay")

backend = catalog.least_busy(operational=True, simulator=False)
print(backend.name, backend.num_qubits)
ibm_fez 156
Krok 1: Odwzoruj klasyczne dane wejściowe na problem kwantowy
Rimay odwzorowuje każdą numeryczną cechę wejściową na jeden kubit, więc pierwszym krokiem jest zamiana surowej tabeli na cechy numeryczne.
Załaduj zbiór danych
Załaduj zbiór danych German credit bezpośrednio z OpenML. Kolumna class zawiera etykietę: good dla wnioskodawców, którzy spłacili kredyt, i bad dla tych, którzy tego nie zrobili.
df = fetch_openml(data_id=31, as_frame=True).frame
print(df.shape)
df.head()
(1000, 21)
checking_status  duration                  credit_history  \
0              <0         6  critical/other existing credit
1        0<=X<200        48                   existing paid
2     no checking        12  critical/other existing credit
3              <0        42                   existing paid
4              <0        24              delayed previously

               purpose  credit_amount    savings_status employment  \
0             radio/tv           1169  no known savings        >=7
1             radio/tv           5951              <100     1<=X<4
2            education           2096              <100     4<=X<7
3  furniture/equipment           7882              <100     4<=X<7
4              new car           4870              <100     1<=X<4

   installment_commitment     personal_status other_parties  ...  \
0                       4         male single          none  ...
1                       2  female div/dep/mar          none  ...
2                       2         male single          none  ...
3                       2         male single     guarantor  ...
4                       3         male single          none  ...

   property_magnitude age  other_payment_plans   housing existing_credits  \
0         real estate  67                 none       own                2
1         real estate  22                 none       own                1
2         real estate  49                 none       own                1
3      life insurance  45                 none  for free                1
4   no known property  53                 none  for free                2

                  job num_dependents  own_telephone foreign_worker class
0             skilled              1            yes            yes  good
1             skilled              1           none            yes   bad
2  unskilled resident              2           none            yes  good
3             skilled              2           none            yes  good
4             skilled              2           none            yes   bad

[5 rows x 21 columns]
Zakoduj cechy
Zamień etykietę na wartość binarną i zakoduj metodą one-hot 13 kolumn kategorialnych. Kod odrzuca pierwszą kategorię każdej kolumny, aby uniknąć redundantnych cech, co daje 48 cech numerycznych.
y = (df["class"] == "good").astype(int)

features = df.drop(columns="class")
categorical_cols = [
    col for col in features.columns if features[col].dtype.name == "category"
]
encoder = OneHotEncoder(
    sparse_output=False, handle_unknown="ignore", drop="first"
)
encoded = pd.DataFrame(
    encoder.fit_transform(features[categorical_cols]),
    columns=encoder.get_feature_names_out(categorical_cols),
    index=features.index,
)
x = pd.concat([features.drop(columns=categorical_cols), encoded], axis=1)
print(f"{x.shape[1]} features")
48 features
Podziel na zbiory treningowy i testowy
Odłóż 20% wnioskodawców jako zbiór testowy. Podział stratyfikowany zachowuje taki sam udział dobrych i złych kredytów w obu zbiorach.
x_train, x_test, y_train, y_test = train_test_split(
    x, y, test_size=0.2, random_state=42, stratify=y
)
print(f"Training set: {x_train.shape}, test set: {x_test.shape}")
Training set: (800, 48), test set: (200, 48)
Ustal klasyczny punkt odniesienia
Wytrenuj las losowy na cechach klasycznych. W kroku 4 porównasz z jego metrykami cechy przekształcone kwantowo.
baseline = train_random_forest(
    x_train, y_train, n_estimators=500, max_depth=12
)
results = {"Classical": evaluate(baseline, x_test, y_test)}
pd.DataFrame(results).T
Accuracy       AUC  F1 score  Precision    Recall
Classical     0.765  0.781071  0.845902   0.781818  0.921429
Prześlij dane do Rimay
Rimay odczytuje dane wejściowe z plików CSV, które przesyłasz do funkcji. Cechy i etykiety trafiają do osobnych plików. Przesyłasz też zbiór testowy, aby Rimay odwzorował go tym samym odwzorowaniem, które dopasował na zbiorze treningowym.
x_train.to_csv("x_train.csv", index=False)
y_train.to_csv("y_train.csv", index=False)
x_test.to_csv("x_test.csv", index=False)

for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
Krok 2: Zoptymalizuj problem pod wykonanie na sprzęcie kwantowym
Rimay buduje i transpiluje obwody dla wybranego procesora, więc nie ma obwodu do ręcznej optymalizacji. Określ liczbę strzałów (shots) na obwód, w ramach następujących ograniczeń:
-
Każda cecha wymaga jednego kubitu, więc procesor musi mieć co najmniej tyle kubitów, ile cech ma zbiór danych.
-
Rimay uruchamia jeden obwód na wiersz, razem wiersze treningowe i testowe. Pojedyncze zadanie może zażądać co najwyżej 10 milionów wykonań, więc liczba wierszy razy
shotsmusi mieścić się w tym budżecie.
Sprawdź oba limity przed przesłaniem zadania.
Zadanie musi się też zakończyć w ciągu 24 godzin, wliczając czas oczekiwania jego obwodów w kolejce, w przeciwnym razie zostanie zatrzymane bez wyniku.
shots = 5000

n_rows = len(x_train) + len(x_test)
n_features = x_train.shape[1]
print(f"Qubits needed: {n_features} of {backend.num_qubits} available")
print(f"Executions: {n_rows * shots:,} of 10,000,000 allowed")
Qubits needed: 48 of 156 available
Executions: 5,000,000 of 10,000,000 allowed
Oblicz rozmiar funkcji
Każde zadanie działa przy pewnym rozmiarze funkcji, S, M lub L, który wybiera zasoby obliczeniowe, na których zadanie się wykonuje. W przypadku Rimay rozmiar zależy od liczby wierszy odwzorowywanych przez zadanie, razem wierszy treningowych i testowych. Jeśli zażądasz zbyt małego rozmiaru, zadanie zakończy się błędem 4600. Rozmiary i ich limity opisano w sekcji Function sizes przewodnika Rimay.
Poniższa komórka definiuje kalkulator rozmiaru. Działa na Twoim komputerze, odczytuje tylko przekazane mu dane i niczego nie przesyła.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Przekaż zbiory danych w tej samej kolejności co pliki w input_file, razem z trybem uruchomienia:
size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Krok 3: Wykonaj za pomocą prymitywów Qiskit
Uruchom Rimay w trybie fit-transform. Dopasowuje on kwantowe odwzorowanie cech na x_train.csv i y_train.csv oraz odwzorowuje nim zarówno zbiór treningowy, jak i testowy. Kolejność plików w input_file ma znaczenie. Podaj cechy treningowe, etykiety treningowe, a następnie opcjonalne cechy testowe. Przekaż obliczony wcześniej rozmiar jako function_size.
job = rimay.run(
    mode="fit-transform",
    input_file=[
        "x_train.csv",
        "y_train.csv",
        "x_test.csv",
    ],  # This order matters
    backend_name=backend.name,
    shots=shots,
    function_size=size,
)
print(job.job_id)
de5094df-bb17-4924-9605-d6196a4aa999
Monitoruj zadanie
Sprawdzaj status zadania w trakcie jego działania. job.result() blokuje do zakończenia zadania.
print(job.status())
INITIALIZING
result = job.result()
print(result["output_files"])
['de5094df-bb17-4924-9605-d6196a4aa999_xq_train.csv', 'de5094df-bb17-4924-9605-d6196a4aa999_xq_test.csv']
Wynik zawiera mapping_id, który identyfikuje odwzorowanie dopasowane w tym uruchomieniu. Nie potrzebujesz go w tym samouczku, ponieważ zbiór testowy został odwzorowany w tym samym uruchomieniu. Zapisz ten identyfikator, jeśli chcesz później odwzorować nowe wiersze za pomocą mode="transform". To jedyny sposób dostępu do dopasowanego odwzorowania, a bez niego musisz dopasować i opłacić nowe. Odwzorowanie jest zbudowane dla układu kubitów tego procesora, więc późniejsze uruchomienie transform musi przekazać to samo backend_name.
mapping_id = result["mapping_id"]
Krok 4: Przetwórz końcowo i zwróć wynik w pożądanym formacie klasycznym
Pobierz cechy przekształcone kwantowo
Pobierz pliki zapisane przez zadanie, używając nazw z output_files. Każda nazwa zaczyna się od identyfikatora zadania, więc pliki tego uruchomienia pozostają dostępne po kolejnych uruchomieniach. Przekaż target_name, aby każdy plik został zapisany pod własną nazwą.
train_file, test_file = result["output_files"]
for file_name in (train_file, test_file):
    catalog.file_download(file_name, rimay, target_name=file_name)

xq_train = pd.read_csv(train_file).to_numpy()
xq_test = pd.read_csv(test_file).to_numpy()
print(f"Quantum-transformed features: {xq_train.shape[1]}")
586kiB [00:00, 1.13MiB/s]
147kiB [00:00, 336kiB/s]
Quantum-transformed features: 99
Trenuj na cechach przekształconych kwantowo
Wytrenuj las losowy wyłącznie na cechach przekształconych kwantowo.
quantum = train_random_forest(
    xq_train, y_train, n_estimators=900, max_depth=15
)
results["Quantum"] = evaluate(quantum, xq_test, y_test)
Trenuj na połączonych cechach klasycznych i kwantowych
Połącz oryginalne cechy z cechami przekształconymi kwantowo i wytrenuj ten sam model na tym połączeniu.
xh_train = np.hstack([x_train.to_numpy(), xq_train])
xh_test = np.hstack([x_test.to_numpy(), xq_test])

hybrid = train_random_forest(
    xh_train, y_train, n_estimators=900, max_depth=15
)
results["Hybrid"] = evaluate(hybrid, xh_test, y_test)
Porównaj wyniki
Porównaj trzy modele na zbiorze testowym.
comparison = pd.DataFrame(results).T
print(comparison.round(3))

comparison[["Accuracy", "AUC", "F1 score"]].T.plot.bar(rot=0, figsize=(8, 4))
plt.ylim(0.5, 1.0)
plt.ylabel("Score on the test set")
plt.title("Random forest on classical, quantum, and hybrid features")
plt.show()
Accuracy    AUC  F1 score  Precision  Recall
Classical     0.765  0.781     0.846      0.782   0.921
Quantum       0.730  0.784     0.827      0.750   0.921
Hybrid        0.730  0.791     0.825      0.756   0.907

AUC mierzy, jak dobrze model ustawia dobre kredyty wyżej niż złe, niezależnie od progu decyzyjnego, co czyni je najbardziej informatywną metryką w tym niezbalansowanym zbiorze danych (70% dobrych kredytów). W testach porównawczych Kipu Quantum cechy przekształcone kwantowo osiągnęły samodzielnie AUC zbliżone do klasycznego punktu odniesienia, a model hybrydowy, łączący oba rodzaje cech, uzyskał najwyższe AUC i wynik F1. Cechy przekształcone kwantowo wnoszą zatem informacje, których same cechy klasyczne nie dostarczają.
Porządkowanie (opcjonalnie)
Dopasowane odwzorowanie pozostaje dostępne, dopóki go nie usuniesz. Jeśli nie chcesz już za jego pomocą odwzorowywać kolejnych danych, usuń je. Usunięcie nie wykonuje żadnej pracy kwantowej, nie zużywa czasu QPU i nie można go cofnąć.
# rimay.run(mode="delete", mapping_id=mapping_id).result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': 'eUCy4EnZM7G9jYo5b2Pu-TuCXK7zX_wPTT67g9J1dVE',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Podsumowanie
Co udało Ci się osiągnąć
W tym samouczku udało Ci się zrobić następujące rzeczy:
-
Przygotowano rzeczywisty zbiór danych o ryzyku kredytowym z atrybutami kategorialnymi i numerycznymi do kwantowej ekstrakcji cech.
-
Ustalono klasyczny punkt odniesienia w postaci lasu losowego.
-
Użyto Rimay do dopasowania kwantowego odwzorowania cech na sprzęcie kwantowym i odwzorowania zbiorów treningowego i testowego w jednym uruchomieniu.
-
Wytrenowano ten sam model na cechach przekształconych kwantowo i na cechach połączonych oraz porównano je z punktem odniesienia.
Najważniejsze wnioski
-
Rimay wpasowuje się w istniejący potok uczenia maszynowego jako jeden dodatkowy krok przetwarzania wstępnego. Zachowujesz własne przygotowanie danych i swój klasyczny model.
-
Liczba kubitów ogranicza liczbę cech wejściowych, a liczba wierszy razy
shotsogranicza rozmiar pojedynczego zadania. -
Domyślnie używaj cech przekształconych kwantowo połączonych z oryginalnymi cechami, ponieważ model może korzystać z obu.
Kolejne kroki
- Przeczytaj przewodnik Rimay, aby poznać wszystkie dane wejściowe, odwzorowywać nowe dane za pomocą
mode="transform"i zobaczyć kolejne testy porównawcze. - Przeczytaj, jak kwantową ekstrakcję cech zastosowano do klasyfikacji obrazów satelitarnych [3].
Bibliografia
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.