Rimay Quantum Feature Extraction - Qiskit Function firmy Kipu Quantum
Zobacz dokumentację API.
Qiskit Functions to funkcja eksperymentalna dostępna wyłącznie dla użytkowników planów IBM Quantum® Premium Plan, Flex Plan i On-Prem (przez IBM Quantum Platform API). Mają status wersji zapoznawczej i mogą ulec zmianie.
Przegląd
Rimay uzupełnia klasyczne potoki uczenia maszynowego o cechy generowane na sprzęcie kwantowym. Funkcja przyjmuje klasyczne dane tabelaryczne i zwraca zestaw cech przekształconych kwantowo. Gdy system kwantowy przetwarza dane, generuje bogate cechy, które oddają nieliniowe zależności między wejściami. Wygenerowanych cech możesz używać samodzielnie lub w połączeniu z oryginalnymi cechami do trenowania dowolnego modelu klasycznego. W małych i średnich zbiorach danych cechy przekształcone kwantowo mogą poprawić jakość predykcji w porównaniu z czysto klasycznymi punktami odniesienia.
Ta funkcja jest przeznaczona dla następujących użytkowników:
-
Zespoły data science z istniejącym potokiem uczenia maszynowego dla małych i średnich zbiorów danych tabelarycznych, w którym jakość predykcji przestała rosnąć. Dodajesz Rimay jako jeden dodatkowy krok przetwarzania wstępnego, bez samodzielnego budowania obwodów kwantowych.
-
Badacze, którzy eksplorują metody kwantowe w zadaniach uczenia maszynowego.
Opis
Algorytm kwantowej ekstrakcji cech [1] łączy dwie zasady kwantowego uczenia maszynowego. Pierwsza to kwantowe mapy cech, które osadzają dane w wysokowymiarowej przestrzeni Hilberta i dzięki temu tworzą bardziej wyrazistą reprezentację. Druga to kwantowe przetwarzanie rezerwuarowe, które wykorzystuje dynamikę kwantowego układu wielu ciał jako nieliniowe przekształcenie danych wejściowych.
Rimay koduje wartości cech oraz informację wzajemną między cechami w polach lokalnych i współczynnikach sprzężeń hamiltonianu szkła spinowego. Kontradiabatyczna dynamika kwantowa prowadzi układ w stronę stanów o niskiej energii, które zawierają nieliniowe mieszaniny korelacji w danych wejściowych. Rimay wyodrębnia te korelacje, mierząc wartości oczekiwane jedno- i dwuciałowe. Wartości oczekiwane to kwantowo przekształcone cechy, które przekazujesz do swojego modelu uczenia maszynowego.
Przebieg pracy
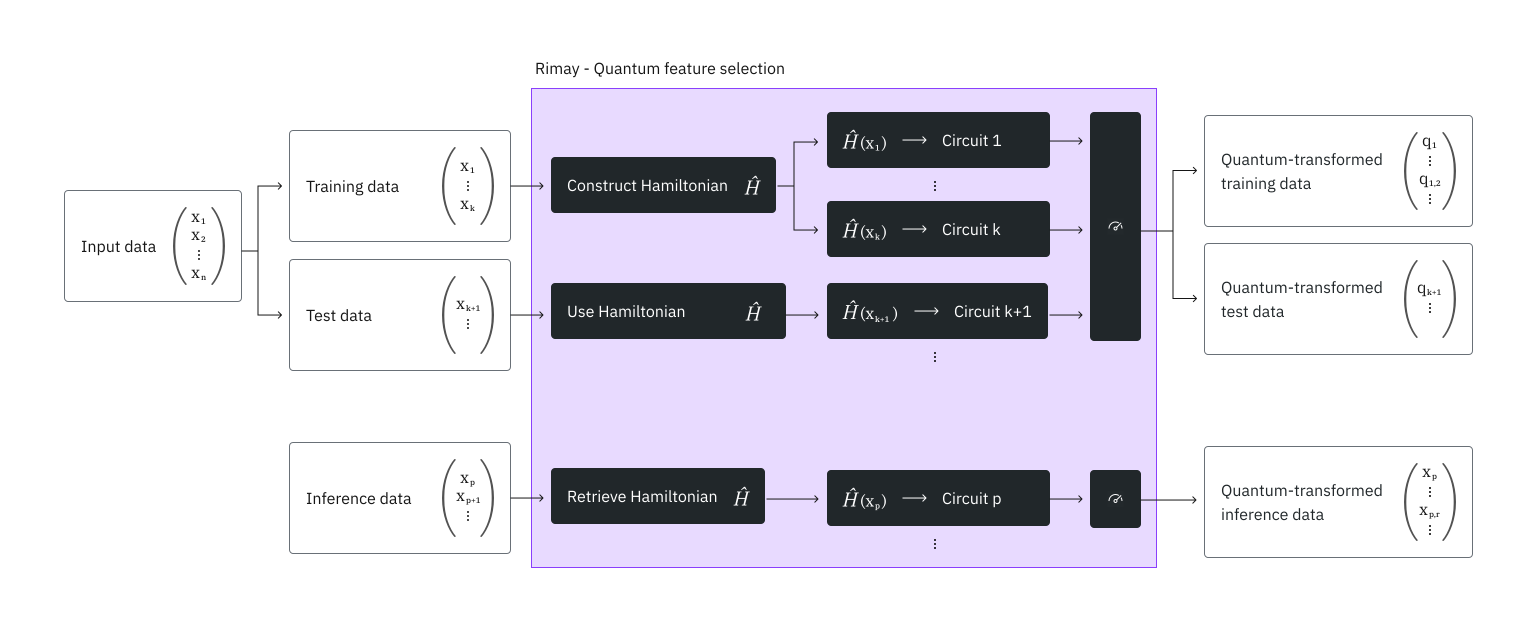
-
Wstępnie przetwórz dane tabelaryczne tak, jak w klasycznym uczeniu maszynowym. Rimay wymaga cech numerycznych, więc zamień cechy kategoryczne na numeryczne, na przykład za pomocą
OneHotEncoderz biblioteki scikit-learn. -
Podziel dane na zbiór treningowy i testowy i prześlij oba do funkcji, jak pokazano w sekcji Przykład.
-
Rimay używa danych treningowych do zbudowania hamiltonianu reprezentującego dane. Każda cecha odpowiada jednemu kubitowi, a cały zbiór treningowy decyduje, które cechy, a więc które kubity, oddziałują ze sobą. Rimay zapisuje tę strukturę, aby mapować dane testowe i późniejsze dane do wnioskowania za pomocą tego samego hamiltonianu.
-
Dla każdej próbki wartości cech ustalają pola lokalne hamiltonianu, a informacja wzajemna między cechami ustala współczynniki sprzężeń struktury z kroku 3. Rimay digitalizuje kontradiabatyczną ewolucję tego hamiltonianu do obwodu i uruchamia obwody na QPU.
-
Rimay mierzy powstałe ciągi bitów, a następnie oblicza wartości oczekiwane jednociałowe oraz wartości oczekiwane dwuciałowe dla fizycznie sprzężonych kubitów.
-
Pobierasz wartości oczekiwane w postaci, którą możesz przekazać bezpośrednio do swojego modelu lub połączyć z oryginalnymi cechami.
Z powodu tej struktury liczba kubitów potrzebnych do uruchomienia jest równa liczbie cech, a liczba przesyłanych obwodów jest równa liczbie próbek.
Po dopasowaniu mapowania możesz za jego pomocą mapować nowe dane, na przykład do wnioskowania. Rimay pobiera wtedy hamiltonian utworzony podczas dopasowania i na jego podstawie buduje obwody dla nowych próbek.
Zintegruj Rimay ze swoim potokiem uczenia maszynowego
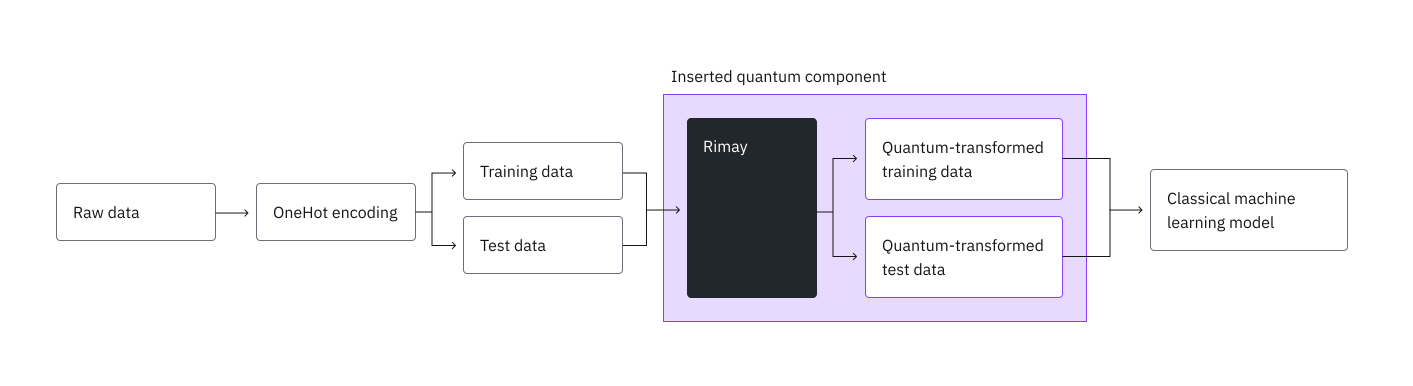
Podobnie jak w klasycznym potoku zaczynasz od wstępnego przetworzenia surowych danych, na przykład kodowania cech kategorycznych metodą one-hot, i dzielisz je na zbiór treningowy i testowy. Zamiast przekazywać oba zbiory bezpośrednio do modelu, przekazujesz je najpierw do Rimay i trenujesz model na kwantowo przekształconych cechach.
Testy wydajności
Kipu Quantum przetestowało Rimay na zbiorze danych German credit z OpenML [2], który klasyfikuje 1000 wnioskodawców kredytowych jako dobre lub złe ryzyko kredytowe. Zbiór ma 13 atrybutów kategorycznych i siedem numerycznych. Kodowanie one-hot atrybutów kategorycznych daje 48 cech numerycznych. W teście 20% próbek zostaje zachowane jako zbiór testowy.
Jako punkt odniesienia wytrenowano kilka klasycznych modeli na cechach klasycznych. Z Rimay wytrenowano las losowy na dwa sposoby: wyłącznie na kwantowo przekształconych cechach (Random forest Q) oraz na kwantowo przekształconych cechach połączonych z klasycznymi (Random forest H, od hybrydowy). Tabela podaje tylko las losowy, ponieważ osiągnął najlepsze wyniki na kwantowo przekształconych cechach.
| Model | Cechy | Dokładność | AUC | Wskaźnik F1 | Precyzja | Czułość |
|---|---|---|---|---|---|---|
| CatBoost | Klasyczne | 0.775 | 0.781 | 0.850 | 0.795 | 0.914 |
| Random forest | Klasyczne | 0.765 | 0.781 | 0.846 | 0.782 | 0.921 |
| XGBoost | Klasyczne | 0.760 | 0.758 | 0.835 | 0.803 | 0.871 |
| LightGBM | Klasyczne | 0.770 | 0.751 | 0.840 | 0.818 | 0.864 |
| Random forest Q | Kwantowe | 0.750 | 0.793 | 0.840 | 0.762 | 0.936 |
| Random forest H | Hybrydowe | 0.770 | 0.798 | 0.854 | 0.770 | 0.957 |
Cechy hybrydowe poprawiają wszystkie metryki lasu losowego z wyjątkiem precyzji, a hybrydowy las losowy osiąga wyższe AUC, wskaźnik F1 i czułość niż CatBoost na cechach klasycznych. Największy efekt widać w czułości, która rośnie z 0.921 do 0.957. Same kwantowo przekształcone cechy nie osiągają precyzji modeli klasycznych.
Zbiór testowy zawiera tylko 200 próbek, więc poprawne przewidzenie jeszcze jednej próbki zmienia dokładność o 0.005. Traktuj różnice jako trend wymagający dalszej weryfikacji, a nie jako istotny efekt. Dokładność predykcji może zależeć także od szumu sprzętowego w wyodrębnionych cechach. Dlatego używaj wystarczającej liczby powtórzeń (shots), aby szum statystyczny nie ograniczał wyniku.
W teście użyto następujących zasobów:
| Przykład | Liczba kubitów | Liczba próbek | Liczba powtórzeń | Całkowity czas (min) | Użycie QPU (min) | Procesor |
|---|---|---|---|---|---|---|
| German credit | 48 | 1000 | 5000 | 23 | 22 | ibm_boston |
| German credit | 48 | 1000 | 5000 | 3 | 2 | ibm_phoenix |
Liczba próbek, czyli liczba obwodów, decyduje o czasie QPU. Używaj typu procesora Nighthawk r2, ponieważ znacznie skraca wymagany czas QPU.
Dane wejściowe
Parametr mode określa, jakich parametrów wymaga uruchomienie. Opis każdego parametru wejściowego znajdziesz w dokumentacji API.
Pliki wejściowe
-
Prześlij każdy plik za pomocą
catalog.file_upload()przed uruchomieniem funkcji. -
Przesłanie zastępuje każdy wcześniejszy plik o tej samej nazwie, nawet dla zadania, które zostało wysłane, ale jeszcze się nie rozpoczęło. Aby uruchomić kilka zadań jednocześnie, nadaj plikom każdego zadania własne nazwy, na przykład
run1_x_train.csvirun2_x_train.csv. -
Każdy plik jest plikiem CSV z wierszem nagłówka. Każda kolumna pliku z cechami to jedna cecha, a każda wartość musi być liczbą.
-
y_trainzawiera dokładnie jedną kolumnę numeryczną, z jedną etykietą na wierszx_train. Zamapuj etykiety kategoryczne na liczby, na przykład dobry i zły na 1 i 0. -
x_testix_inferencemuszą mieć te same kolumny cox_train, w tej samej kolejności.
mapping_id to jedyny sposób dotarcia do mapowania utworzonego przez dopasowanie i nie można go sprawdzić ani odzyskać. Upoważnia on do użycia tego mapowania, więc traktuj go jak poświadczenie i nie udostępniaj. Jeśli go utracisz, musisz dopasować nowe mapowanie, co kosztuje kolejne uruchomienie na sprzęcie kwantowym. Zapisz też backend_name użyty przy dopasowaniu, ponieważ mapowanie działa tylko na tym procesorze.
Ograniczenia
-
Każda cecha jest mapowana na jeden kubit, więc procesor musi mieć co najmniej tyle kubitów, ile cech mają twoje dane. Jeśli masz więcej cech, najpierw zredukuj ich liczbę techniką selekcji cech.
-
Każda próbka staje się jednym obwodem, a uruchomienie liczy razem próbki treningowe i testowe. Jedno uruchomienie może zawierać najwyżej 15 000 próbek.
-
Pojedyncze zadanie może zażądać najwyżej 10 milionów wykonań, więc liczba próbek razy
shotsnie może przekraczać 10 milionów. -
Zadanie musi zakończyć się w ciągu 24 godzin, wliczając czas oczekiwania jego obwodów w kolejce procesora. Zadanie trwające dłużej zostaje zatrzymane bez wyniku. Na zajętym procesorze trzymaj duże zbiory danych znacznie poniżej tych limitów.
Dane wyjściowe
job.result() zwraca słownik. Same kwantowo przekształcone cechy są zapisywane w plikach CSV, które pobierasz za pomocą catalog.file_download(). Opis każdego klucza słownika znajdziesz w dokumentacji API. Czas trwania poszczególnych faz wykonania opisano w Metadanych uruchomienia.
Każdy plik wyjściowy zawiera jeden wiersz na wiersz wejściowy, w kolejności pliku wejściowego, oraz jedną kolumnę na kwantowo przekształconą cechę. Kolumny o nazwach zaczynających się od corr_ to wartości oczekiwane dwuciałowe. Pliki nie zawierają kolumny z etykietami. Etykiety danych treningowych pozostają w twoim pliku y_train.
Metadane uruchomienia
resource_usage zawiera jeden wpis dla każdej fazy wykonania, przez którą przeszło uruchomienie: "RUNNING: MAPPING", "RUNNING: POST_PROCESSING" oraz, na QPU, zwykle "RUNNING: WAITING_FOR_QPU". Każdy wpis zawiera CPU_TIME, czyli czas fazy w sekundach według zegara ściennego, oraz QPU_TIME, czyli czas QPU w sekundach. Na QPU czas QPU rozliczony przez IBM jest zapisany pod "RUNNING: MAPPING", w fazie, w której uruchamiano obwody.
"RUNNING: WAITING_FOR_QPU" to czas, który twoje zadania czekały w kolejce IBM. Uruchomienie pobiera ten czas ze znaczników czasu zadań IBM i nie wlicza go do "RUNNING: MAPPING". Jeśli IBM nie zgłasza tych znaczników czasu dla każdego zadania, wpisu nie ma, a czas oczekiwania wchodzi w skład "RUNNING: MAPPING".
IBM® kończy obliczanie zużycia jakiś czas po zakończeniu zadania. Uruchomienie czeka na to do około minuty. Zużycie, które nadal jest obliczane po tym czasie, nie jest uwzględnione w QPU_TIME, a końcowe zużycie jest widoczne w IBM Quantum Platform. Jeśli uruchomienie nie może odczytać zużycia z IBM, QPU_TIME ma wartość None.
Na przykład:
"metadata": {
    "version": "0.3.0",
    "resource_usage": {
        "RUNNING: MAPPING": {"CPU_TIME": 12.4, "QPU_TIME": 6.0},
        "RUNNING: WAITING_FOR_QPU": {"CPU_TIME": 28.8, "QPU_TIME": 0.0},
        "RUNNING: POST_PROCESSING": {"CPU_TIME": 0.3, "QPU_TIME": 0.0},
    },
}
Rozpoczęcie pracy
Uwierzytelnij się za pomocą klucza API IBM Quantum Platform i wybierz Qiskit Function w następujący sposób:
Poniższy kod zakłada, że zapisałeś swoje poświadczenia. Jeśli nie, postępuj zgodnie z instrukcjami w Install the Qiskit Functions Catalog client, aby zapisać konto z kluczem API.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(kipu-quantum/rimay)]
# Access function
rimay = catalog.load("kipu-quantum/rimay")
Rozmiary funkcji
Każde zadanie działa w jednym rozmiarze: S, M lub L. Jeśli podany rozmiar jest za mały, zadanie zostaje odrzucone. Jeśli rozmiar jest większy, niż potrzeba, zadanie działa na większym profilu obliczeniowym, niż wymaga praca.
Rozmiar zadania Rimay zależy od liczby mapowanych próbek: wierszy x_train i x_test dla fit-transform oraz wierszy x_inference dla transform. Etykiety w y_train nie są liczone, a uruchomienie delete nie mapuje żadnych próbek.
| Rozmiar | Próbki na zadanie | Profil obliczeniowy | vCPU | RAM |
|---|---|---|---|---|
S | Do 2 999 | 8x32 | 8 | 32 GB |
M | od 3 000 do 9 999 | 8x32 | 8 | 32 GB |
L | od 10 000 do 15 000 | 16x128 | 16 | 128 GB |
Liczba próbek jest jedynym kryterium. Rozmiar zmienia tylko profil obliczeniowy: ograniczenia dotyczące cech, próbek i powtórzeń są takie same dla każdego rozmiaru. S i M działają na tym samym profilu obliczeniowym i różnią się liczbą próbek, które obejmują.
Domyślny jest M, używany, gdy zadanie nie żąda rozmiaru. Zadanie z więcej niż 9 999 próbkami musi więc zażądać L.
Mapowanie możesz też odczytać z samej funkcji za pomocą rimay.sizes_map, a rozmiar, w którym działa zadanie niezgłaszające żądania, za pomocą rimay.default_size.
Oblicz rozmiar przed wysłaniem
Uruchom to na własnych danych wejściowych. Kalkulator tylko je odczytuje: nie wysyła żadnego zadania i niczego nie rezerwuje, więc możesz go wywoływać tak często, jak chcesz.
Przekaż same zbiory danych, a nie nazwy plików, w tej samej kolejności co input_file, razem z mode uruchomienia. Wywołanie pokazuje krok 2 przykładu.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Jeśli rozmiar jest za mały, zadanie kończy się błędem 4600, a komunikat podaje rozmiar, którego należy użyć. Jeśli jest większy, niż potrzeba, zadanie działa normalnie i zapisuje zdarzenie ostrzegawcze 4601.
Przykład
Ten przykład pokazuje, jak przesłać dane, uruchomić funkcję i pobrać kwantowo przekształcone cechy. Kompletny przykład obejmujący wstępne przetwarzanie i trenowanie klasycznego modelu znajdziesz w samouczku.
1. Prześlij dane
Ten przykład używa małego syntetycznego zbioru danych z czterema cechami numerycznymi i binarną etykietą, dzięki czemu uruchomienie potrzebuje tylko czterech kubitów i kończy się szybko. Następna komórka zapisuje go w czterech plikach CSV: cechy treningowe, etykiety treningowe, cechy testowe oraz cechy do kroku 4 tego przykładu. Aby użyć własnych danych, zapisz zamiast tego swoje wstępnie przetworzone zbiory treningowy i testowy w plikach o tym samym układzie.
from pathlib import Path

Path("x_train.csv").write_text("""f0,f1,f2,f3
0.7227,1.3355,1.9595,2.5562
0.2731,0.5779,0.8983,1.1624
0.1139,0.1817,0.2163,0.2426
0.0341,0.1311,0.0854,0.09
0.8996,1.6951,2.497,3.3407
0.9669,1.8906,2.7705,3.6569
0.6366,1.2821,1.8793,2.4602
0.7718,1.4979,2.2223,2.933
0.5465,1.1008,1.67,2.2195
0.9475,1.9423,2.8942,3.8199
0.8829,1.6842,2.4703,3.2865
0.0675,0.0365,0.0705,0.0162
""")
Path("y_train.csv").write_text("label\n1\n0\n0\n0\n1\n1\n0\n1\n0\n1\n1\n0\n")
Path("x_test.csv").write_text("""f0,f1,f2,f3
0.543,1.0786,1.5684,2.0607
0.9928,1.9037,2.9302,3.8422
0.2269,0.3637,0.4628,0.597
0.9896,1.9511,2.8913,3.8208
""")
Path("x_inference.csv").write_text("""f0,f1,f2,f3
0.2708,0.542,0.8506,1.0897
0.3585,0.6025,0.9517,1.2609
0.8871,1.6559,2.4577,3.2992
""")
95
Prześlij pliki treningowe i testowe. Plik x_inference.csv prześlesz w kroku 4.
for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
2. Uruchom funkcję
Oblicz rozmiar uruchomienia na podstawie przesłanych danych za pomocą kalkulatora z sekcji Rozmiary funkcji.
import pandas as pd

x_train = pd.read_csv("x_train.csv")
y_train = pd.read_csv("y_train.csv")
x_test = pd.read_csv("x_test.csv")

size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Wybierz procesor z co najmniej tyloma kubitami, ile cech mają twoje dane, i uruchom funkcję w trybie fit-transform z tym rozmiarem. Przykładowe dane mają cztery cechy, więc może je uruchomić dowolny procesor IBM Quantum.
backend = catalog.least_busy(operational=True, simulator=False)

job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv", "x_test.csv"],
    backend_name=backend.name,
    shots=5000,
    function_size=size,
)
print(job.job_id)
85dabc9f-a769-4f4a-8e92-f3be73f85ca2
Sprawdź status zadania lub pobierz wyniki w następujący sposób:
# Monitor the job status
job.status()
'DONE'
result = job.result()

# Keep both: the mapping_id is the only handle on the mapping this run
# fitted, and the mapping runs only on the processor it was fitted on.
mapping_id = result["mapping_id"]
fit_backend_name = result["backend_name"]
3. Pobierz wyniki
Pobierz kwantowo przekształcone cechy. Przekaż target_name, aby każdy plik został zapisany pod własną nazwą.
for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
693iB [00:00, 171kiB/s]
254iB [00:00, 111kiB/s]
4. Zmapuj nowe dane
Po wytrenowaniu modelu zmapuj nowe dane za pomocą dopasowanego mapowania, na przykład aby przeprowadzić wnioskowanie. Ten przykład mapuje x_inference.csv, który zapisała pierwsza komórka tego przykładu. Przekaż mapping_id zwrócony przez dopasowanie, aby nowe wiersze zostały zmapowane tym samym mapowaniem zamiast nowym.
Mapowanie jest budowane dla układu kubitów jednego procesora, więc przekaż ten sam backend_name co przy dopasowaniu, który dopasowanie zwróciło w result["backend_name"]. Nie używaj least_busy() do wyboru procesora, ponieważ może zwrócić inny. Rimay odrzuca każdy inny procesor, zanim cokolwiek wyśle. Liczba powtórzeń również pochodzi z dopasowania.
catalog.file_upload("x_inference.csv", rimay)

x_inference = pd.read_csv("x_inference.csv")
size = calculate_function_size([x_inference], mode="transform")

job = rimay.run(
    mode="transform",
    input_file=["x_inference.csv"],
    # The processor the mapping was fitted on
    backend_name=fit_backend_name,
    shots=5000,
    mapping_id=mapping_id,
    function_size=size,
)
# Monitor the job status
job.status()
'DONE'
result = job.result()

for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
202iB [00:00, 73.5kiB/s]
5. Usuń mapowanie
Gdy dopasowane mapowanie nie jest już potrzebne, usuń je. Uruchomienie delete nie wykonuje żadnej pracy kwantowej, więc nie potrzebuje procesora, powtórzeń ani rozmiaru funkcji. Usunięcia nie można cofnąć. Po usunięciu mapping_id nie odnosi się już do niczego, a uruchomienie transform z nim kończy się błędem.
job = rimay.run(mode="delete", mapping_id=mapping_id)
job.result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': '30L40joyUPYfnvgwo2d7MXXSzqvHkggR-Kzn81wfIYw',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Pobieranie komunikatów o błędach
Jeśli status twojego zadania to ERROR, użyj job.error_message(), aby pobrać komunikat o błędzie, w następujący sposób:
job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv"],
    backend_name=backend.name,
    shots=0,
)
job.error_message()
Każdy błąd zgłaszany przez Rimay zawiera kod z kodów błędów IBM Quantum, komunikat oraz rozwiązanie, które wskazuje przekazaną wartość i wartość dozwoloną. Poniższa tabela zawiera najczęstsze błędy:
| Kod | Przyczyna |
|---|---|
1221 | Brakuje parametru lub ma zły typ, mode jest nieprawidłowy, plik wymieniony w input_file nie został przesłany, pliki nie pasują do siebie, cecha nie jest numeryczna lub mapping_id nie odpowiada żadnemu zapisanemu mapowaniu. |
1221 | Uruchomienie "transform" podaje inny backend_name niż dopasowanie, które utworzyło jego mapowanie. |
1216 | Twoja instancja nie ma procesora o przekazanym backend_name. Rozwiązanie wymienia procesory, które ma. |
1200 | Twój klucz API nie ma dostępu do instancji, w której działa zadanie. |
3200 | backend_name nie zaczyna się od ibm_. |
4500 | Dane mają więcej cech, niż procesor ma kubitów. |
6000 | Liczba próbek razy shots przekracza 10 milionów wykonań. |
6001 | shots jest mniejsze niż 1. |
6002 | Dane mają więcej próbek, niż dopuszcza uruchomienie. |
Przypadki użycia
W klasyfikacji tabelarycznej na małych i średnich zbiorach danych Kipu Quantum zastosowało kwantową ekstrakcję cech do następujących zadań:
Poza danymi tabelarycznymi zamrożone sieci neuronowe mogą przekształcać obrazy w cechy numeryczne, które kwantowa ekstrakcja cech mapuje następnie na kwantowo przekształcone cechy:
Uzyskaj wsparcie
Aby uzyskać wsparcie, skontaktuj się z support@kipu-quantum.com.
Następne kroki
-
Odwiedź dokumentację API tej Qiskit Function.
-
Wypróbuj samouczek Classify credit risk with Kipu Quantum's Rimay quantum feature extraction.
-
Zapoznaj się z Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
-
Zapoznaj się z Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
Bibliografia
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
Dodatkowe informacje
Rimay to słowo z języka keczua, które znaczy „wyjaśniać”.