Dynamika spinu i ładunku w modelu Fermiego-Hubbarda
Szacowane zużycie: 5 minut na procesorze Heron r3. (UWAGA: To tylko szacunek. Twój czas działania może się różnić.)
Tło
Model Fermiego-Hubbarda opisuje elektrony przeskakujące po sieci z karą energetyczną za podwójne obsadzenie. Na jednowymiarowym łańcuchu o węzłach z otwartymi brzegami hamiltonian jest zdefiniowany następująco:
gdzie tworzy fermion o spinie w węźle , a je zlicza. Trzy składniki to amplituda przeskoku na wiązaniu między węzłami i , oddziaływanie lokalne oraz potencjał chemiczny . Samouczek mierzy energię w jednostkach , a czas w jednostkach .
Dynamikę tego modelu w czasie rzeczywistym trudno obliczyć klasycznie. Dokładna diagonalizacja kończy się w okolicach węzłów, a po kwenczu entropia splątania w solverze sieci tensorowych rośnie liniowo w czasie, więc wymiar wiązania potrzebny dla ustalonej dokładności rośnie wykładniczo.
W jednym wymiarze elementarnymi wzbudzeniami są spinony, które niosą spin, ale nie ładunek, oraz holony, które niosą ładunek, ale nie spin. Obie propagują się z różnymi prędkościami, więc zlokalizowane zaburzenie rozpada się na szybki i wolny front. Efekt ten nazywa się separacją spinu i ładunku, a ten samouczek ją mierzy [1].
Ten samouczek używa Qiskit Function Dynamics Simulator, która przyjmuje hamiltonian, stan początkowy, harmonogram Trottera i listę obserwabli, a zwraca wartości oczekiwane. Wewnętrznie obsługuje odwzorowanie Jordana-Wignera, trotteryzację, układ kubitów i tłumienie błędów, więc w tym samouczku nie ma obwodów do budowania ani transpilacji.
Wymagania
Zanim zaczniesz ten samouczek, upewnij się, że masz zainstalowane następujące pakiety:
-
Qiskit SDK v2.3.0 lub nowszy (
pip install qiskit) -
Qiskit Runtime v0.50.0 lub nowszy (
pip install qiskit-ibm-runtime) -
Katalog Qiskit Functions v0.21.0 lub nowszy (
pip install qiskit-ibm-catalog) -
NumPy v2.5.1 lub nowszy (
pip install numpy) -
Matplotlib v3.10.3 lub nowszy (
pip install matplotlib) -
Q-CTRL Visualizer v11.0.0 lub nowszy (
pip install qctrl-visualizer)
Konfiguracja
Najpierw uwierzytelnij się za pomocą klucza API IBM Quantum. Następnie wybierz Qiskit Function w następujący sposób. (Ten kod zakłada, że zapisano już Twoje konto w lokalnym środowisku.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qctrlvisualizer": "qctrlvisualizer", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "scipy": "scipy"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from qiskit_ibm_runtime import QiskitRuntimeService
import qctrlvisualizer as qv

plt.style.use(qv.get_qctrl_style())
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Access Function
sim_qf = catalog.load("q-ctrl/dynamics-simulator")
Krok 1: Odwzoruj klasyczne dane wejściowe na problem kwantowy
Zdefiniuj hamiltonian
Funkcja przyjmuje model jako słownik z trzema kluczami. Każdy z nich akceptuje albo pojedynczą liczbę zmiennoprzecinkową, która obowiązuje jednolicie wzdłuż łańcucha, albo listę określającą wartość dla każdego węzła z osobna. Listy mają elementów dla hopping_amplitude, ponieważ otwarty łańcuch ma o jedno wiązanie mniej niż węzłów, oraz elementów dla on_site_interaction i chemical_potential.
Ten samouczek używa jednorodnego łańcucha o 31 węzłach z oddziaływaniem odpychającym . Jednorodny potencjał chemiczny wnosi jedynie globalną fazę, gdy liczba cząstek jest ustalona, więc w tym przykładzie ustawiono go na zero. Potencjał chemiczny ma znaczenie tylko wtedy, gdy zmienia się między węzłami, na przykład przy dodaniu nieporządku lub pojedynczej domieszki.
site_count = 31
hopping_amplitude = 1.0
on_site_interaction = 8.0
chemical_potential = 0.0

model = {
    "hopping_amplitude": [hopping_amplitude] * (site_count - 1),
    "on_site_interaction": [on_site_interaction] * site_count,
    "chemical_potential": [chemical_potential] * site_count,
}

print(
    f"{site_count} sites, {2 * site_count} qubits, U/t_h = {on_site_interaction:.0f}"
)
31 sites, 62 qubits, U/t_h = 8
Ustaw harmonogram Trottera
Słownik simulation zawiera krok czasowy () i liczbę kroków Trottera, a całkowity czas ewolucji jest ich iloczynem. Większe kroki sięgają późniejszych czasów przy stałej głębokości obwodu, ale powodują większy błąd Trottera, który rośnie wraz z , ponieważ składniki hamiltonianu słabiej ze sobą komutują. Opublikowane badanie sprzętowe użyło dla [2], a ten samouczek używa tej samej wartości. Głębokość obwodu rośnie liniowo z liczbą kroków i w ogóle nie zależy od .
time_step = 0.15
step_count = 30

simulation = {"time_step": time_step, "step_count": step_count}

print(
    f"Total evolution time: t = {time_step * step_count:.2f} (units of 1/t_h)"
)
Total evolution time: t = 4.50 (units of 1/t_h)
Przygotuj stan początkowy
Każdy węzeł ma dwa orbitale spinowe, więc łańcuch o węzłach używa kubitów. Stan początkowy jest ciągiem obsadzeń Focka z jednym znakiem na węzeł:
Ciąg jest czytany od najmniej znaczącego węzła, więc znak położony najbardziej na prawo to węzeł 0, a fizyczny indeks węzła dla znaku liczonego od lewej to . Ciąg udud oznacza zatem, że węzeł 0 to d, węzeł 1 to u, węzeł 2 to d, a węzeł 3 to u.
Następnie przygotuj stan Néela w połowie wypełnienia, naprzemiennie u i d, z węzłem centralnym zastąpionym wakansem. Wakans to zaburzenie, którego rozchodzenie się jest śledzone.
vacancy_site = site_count // 2

# Build in increasing site order, then reverse: the leftmost character of the
# string is the highest site index.
site_occupations = [
    "u" if site % 2 == 0 else "d" for site in range(site_count)
]
site_occupations[vacancy_site] = "e"
initial_state = "".join(reversed(site_occupations))

print(f"Vacancy at site {vacancy_site}")
print(initial_state)
Vacancy at site 15
udududududududueudududududududu
Zbuduj obserwable
Każda obserwabla jest słownikiem reprezentującym ważoną sumę iloczynów operatorów obsadzenia:
Każdy element operators to jeden składnik , zapisany jako lista par [name, site], które się mnożą, a odpowiadający mu element coefficients to jego waga. Dwie nazwy to "Nup" dla i "Ndn" dla . Pojedynczą obserwablę jednopunktową zapisuje się następująco:
{"operators": [[["Nup", 3]]], "coefficients": [1.0]}
Następna komórka wypisuje najmniejszy kompletny zestaw danych wejściowych akceptowany przez funkcję, który przydaje się jako wzorzec struktury podczas czytania kolejnego kodu.
minimal_inputs = {
    "model": {
        "hopping_amplitude": 1.0,
        "on_site_interaction": [2.0, 2.5],
        "chemical_potential": 0.5,
    },
    "simulation": {"step_count": 5, "time_step": 0.1},
    "observables": [{"operators": [[["Nup", 0]]], "coefficients": [1.0]}],
    "initial_state": "ud",
    "shots": 4096,
}

for key, value in minimal_inputs.items():
    print(f"{key}: {value}")
model: {'hopping_amplitude': 1.0, 'on_site_interaction': [2.0, 2.5], 'chemical_potential': 0.5}
simulation: {'step_count': 5, 'time_step': 0.1}
observables: [{'operators': [[['Nup', 0]]], 'coefficients': [1.0]}]
initial_state: ud
shots: 4096
Potrzebne są trzy grupy obserwabli. Gęstość ładunku oraz spin lokalny są sumami dwóch składników z tych samych operatorów, różniącymi się tylko współczynnikami. Korelator spinowy między węzłem a węzłem wakansu rozwija się na cztery składniki dwupunktowe ze współczynnikami .
Operatory obsadzenia komutują, więc kolejność czynników w składniku nie ma znaczenia, ale kolejność listy observables ustala kolejność zwracanych wartości. Kod zapamiętuje indeks każdej grupy podczas budowania listy. Korelator pomija węzeł wakansu, w którym iloczyn powtarzałby czynnik.
observables = []
charge_indices = []
spin_indices = []
correlator_indices = []

# Charge density: n_i = n_{i,up} + n_{i,down}
for site in range(site_count):
    charge_indices.append(len(observables))
    observables.append(
        {
            "operators": [[["Nup", site]], [["Ndn", site]]],
            "coefficients": [1.0, 1.0],
        }
    )

# Local spin: S^z_i = (n_{i,up} - n_{i,down}) / 2
for site in range(site_count):
    spin_indices.append(len(observables))
    observables.append(
        {
            "operators": [[["Nup", site]], [["Ndn", site]]],
            "coefficients": [0.5, -0.5],
        }
    )

# Spin correlator: S^z_i S^z_{i_*}, expanded into four two-point terms.
correlator_sites = [
    site for site in range(site_count) if site != vacancy_site
]
for site in correlator_sites:
    correlator_indices.append(len(observables))
    observables.append(
        {
            "operators": [
                [["Nup", site], ["Nup", vacancy_site]],
                [["Nup", site], ["Ndn", vacancy_site]],
                [["Ndn", site], ["Nup", vacancy_site]],
                [["Ndn", site], ["Ndn", vacancy_site]],
            ],
            "coefficients": [0.25, -0.25, -0.25, 0.25],
        }
    )

print(f"{len(observables)} observables")
print("Example correlator:", observables[correlator_indices[0]])
92 observables
Example correlator: {'operators': [[['Nup', 0], ['Nup', 15]], [['Nup', 0], ['Ndn', 15]], [['Ndn', 0], ['Nup', 15]], [['Ndn', 0], ['Ndn', 15]]], 'coefficients': [0.25, -0.25, -0.25, 0.25]}
Krok 2: Zoptymalizuj problem pod wykonanie na sprzęcie kwantowym
Ten samouczek nie ma kroku transpilacji. Funkcja wewnętrznie wykonuje następujące kroki [2], a Ty nie możesz ich konfigurować z poziomu notebooka:
-
Odwzorowuje mody fermionowe na kubity w kolejności dobranej tak, aby wagi Pauliego były niskie na sieci heavy-hex
-
Używa fermionowej sieci SWAP, dzięki czemu każdy składnik przeskoku staje się rotacją dwukubitową
-
Osadza łańcuch wzdłuż ścieżki omijającej słabe kubity
-
Stosuje dynamiczne odsprzęganie i pauli twirling podczas kompilacji
Wybierasz Backend i liczbę strzałów. Funkcja przyjmuje nazwę Backendu jako ciąg znaków, więc ten samouczek wybiera najmniej obciążone urządzenie wystarczająco duże dla łańcucha i przekazuje jego nazwę.
Liczbę strzałów wyznacza najmniejszy sygnał, który trzeba rozróżnić. Tracer ładunku osiąga amplitudy bliskie , ale połączony tracer spinu ma maksimum około , czyli mniej więcej czterokrotnie mniej. Z tego powodu opublikowane badanie użyło 20 000 strzałów na obwód [2].
service = QiskitRuntimeService()
backend = service.backend("ibm_boston")
backend_name = backend.name
shot_count = 20_000

print(f"{backend_name}, {shot_count} shots per circuit")
ibm_boston, 20000 shots per circuit
Krok 3: Wykonaj za pomocą prymitywów Qiskit
Następnie prześlij symulację. run od razu zwraca uchwyt zadania zamiast blokować.
job = sim_qf.run(
    model=model,
    simulation=simulation,
    observables=observables,
    initial_state=initial_state,
    shots=shot_count,
    backend_name=backend_name,
)
print(job.job_id, job.status())
6261b073-be19-48a1-be60-2f369b25613c QUEUED
Użyj job.status(), aby śledzić postęp, i job.result(), aby zablokować do zakończenia zadania. Wynik to odwzorowanie, którego wpis observable_expectation_values jest indeksowany najpierw według obserwabli, w kolejności ich podania, a potem według czasu. Jest step_count + 1 punktów czasowych, ponieważ uwzględniono wartość dla .
result = job.result()

print("Result keys:", sorted(result.keys()))
Result keys: ['observable_expectation_values', 'observables', 'provider_job_ids', 'warnings']
Krok 4: Przetwórz końcowo i zwróć wynik w pożądanym formacie klasycznym
Zrekonstruuj korelatory
Podziel płaską tablicę z powrotem na trzy grupy, używając wcześniej zapisanych indeksów, a następnie utwórz dwa korelatory śladowe. Ślad ładunku to zmiana gęstości na węzeł względem :
Ślad spinu to skorelowany (connected) korelator między każdym węzłem a węzłem wakancji :
Oba są zbudowane z operatorów w bazie Focka, więc pochodzą z tych samych zmierzonych ciągów bitów, a drugi nie wymaga dodatkowego wykonania na sprzęcie.
Podczas konstruowania obserwabli kod zapisał pozycję każdego operatora ładunku (charge_indices), spinu (spin_indices) i korelacji spinowej (correlator_indices) na liście. Ponieważ symulator zwraca wartości oczekiwane w tej samej kolejności, możesz użyć tych pozycji, aby wyodrębnić odpowiadające im wyniki. W przypadku korelacji spinowych kod używa też correlator_sites, aby umieścić każdy wynik we właściwym miejscu sieci, a wakancję pozostawia jako NaN.
expectation_values = np.asarray(
    result["observable_expectation_values"], dtype=float
)
times = np.arange(expectation_values.shape[1]) * time_step

charge_density = expectation_values[charge_indices]
local_spin = expectation_values[spin_indices]
spin_correlator = np.full_like(charge_density, np.nan)
spin_correlator[correlator_sites] = expectation_values[correlator_indices]

# Charge tracer: change in per-site density relative to t = 0.
charge_tracer = charge_density - charge_density[:, [0]]

# Spin tracer: connected correlator with the vacancy site.
spin_tracer = 4.0 * (spin_correlator - local_spin * local_spin[vacancy_site])
spin_tracer[vacancy_site] = np.nan

print(
    f"{expectation_values.shape[0]} observables, "
    f"{expectation_values.shape[1]} time points up to t = {times[-1]:.2f}"
)
print(
    f"Peak amplitudes: charge {np.nanmax(np.abs(charge_tracer)):.3f}, "
    f"spin {np.nanmax(np.abs(spin_tracer)):.3f}"
)
92 observables, 31 time points up to t = 4.50
Peak amplitudes: charge 0.978, spin 0.168
Wizualizacja frontów fal
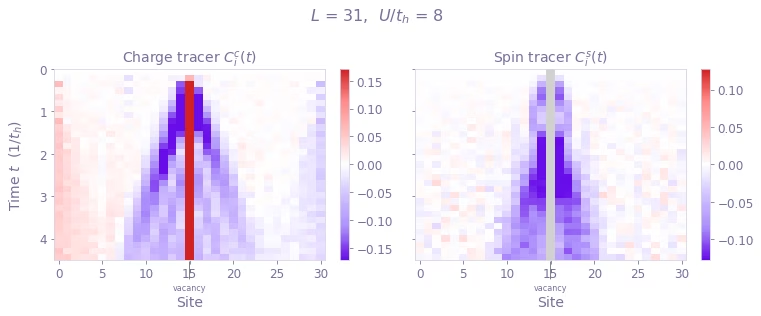
Jeśli narysujesz każdy korelator jako mapę cieplną w przestrzeni i czasie, stożek świetlny jest widoczny bezpośrednio. Czas płynie w dół, a oś pozioma to pozycja wzdłuż łańcucha.
def plot_tracer(axis, tracer, title):
    """Draw one tracer correlator as a space-time heatmap, time flowing down."""
    # Scale from the off-centre sites. The vacancy site carries an order-one
    # change in charge density and is left to clip rather than set the scale.
    off_center = np.ones(site_count, dtype=bool)
    off_center[vacancy_site] = False
    limit = np.nanpercentile(np.abs(tracer[off_center]), 98)

    colormap = qv.QCTRL_DIVERGENT_COLORMAP.reversed().copy()
    colormap.set_bad("0.82")  # the spin tracer has no value at the vacancy

    image = axis.imshow(
        tracer.T,
        aspect="auto",
        origin="upper",
        cmap=colormap,
        vmin=-limit,
        vmax=limit,
        extent=(-0.5, site_count - 0.5, times[-1], times[0]),
        interpolation="nearest",
    )

    axis.annotate(
        "vacancy",
        xy=(vacancy_site, times[-1]),
        xytext=(vacancy_site, times[-1] + 0.55),
        ha="center",
        va="top",
        fontsize=8,
        annotation_clip=False,
        arrowprops=dict(arrowstyle="-", lw=0.8, color="0.4"),
    )

    axis.set_title(title)
    axis.set_xlabel("Site")
    return image

fig, axes = plt.subplots(1, 2, figsize=(11, 4.5), sharey=True)

charge_image = plot_tracer(
    axes[0], charge_tracer, r"Charge tracer $C^{c}_{i}(t)$"
)
spin_image = plot_tracer(axes[1], spin_tracer, r"Spin tracer $C^{s}_{i}(t)$")

axes[0].set_ylabel(r"Time $t$  $(1/t_h)$")
fig.colorbar(charge_image, ax=axes[0], fraction=0.046)
fig.colorbar(spin_image, ax=axes[1], fraction=0.046)
fig.suptitle(f"$L$ = {site_count},  $U/t_h$ = {on_site_interaction:.0f}")
fig.tight_layout()
plt.show()
Wyznaczanie prędkości frontów fal
Zamień mapy cieplne na liczby, stosując protokół detekcji z opublikowanego badania [2]. W każdym przekroju czasowym symetryzuj profil przestrzenny względem wakancji, co uśrednia antysymetryczną część szumu sprzętowego, znormalizuj go przez największą amplitudę poza centrum i zapisz najbardziej zewnętrzny węzeł powyżej progu. Detekcje są następnie dzielone na serie kolejnych kroków czasowych i dopasowywana jest tylko najdłuższa seria, co wyklucza z wyniku wczesny stan przejściowy.
def front_distance(profile, center, threshold):
    """Distance from `center` to the outermost site above a relative threshold."""
    values = np.nan_to_num(np.asarray(profile, dtype=float))
    length = values.size

    symmetrized = values.copy()
    for site in range(length):
        mirror = 2 * center - site
        if 0 <= mirror < length:
            symmetrized[site] = 0.5 * (values[site] + values[mirror])

    amplitude = np.abs(symmetrized)
    off_center = np.ones(length, dtype=bool)
    off_center[center] = False

    peak = amplitude[off_center].max()
    if peak <= 0.0:
        return np.nan
    above = np.flatnonzero((amplitude / peak > threshold) & off_center)
    return float(np.abs(above - center).max()) if above.size else np.nan

def longest_run(mask):
    """Indices of the longest run of consecutive True values."""
    best, current = [], []
    for index, keep in enumerate(mask):
        current = current + [index] if keep else []
        if len(current) > len(best):
            best = current
    return np.array(best, dtype=int)

def front_velocity(tracer, center, threshold=0.3, quantile=0.75, min_block=5):
    """Fit front position against time, using only the longest contiguous run."""
    distances = np.array(
        [
            front_distance(tracer[:, k], center, threshold)
            for k in range(tracer.shape[1])
        ]
    )
    edge = max(center, tracer.shape[0] - 1 - center)
    usable = (
        np.isfinite(distances) & (distances >= 2) & (distances <= edge - 2)
    )

    block = longest_run(usable)
    if block.size < min_block:
        return np.nan, distances, np.array([], dtype=int), np.nan

    candidates = [
        stats.theilslopes(distances[block[:k]], times[block[:k]]).slope
        for k in range(min_block, block.size + 1)
    ]
    cutoff = np.quantile(candidates, quantile)
    keep = max(i for i, value in enumerate(candidates) if value >= cutoff)

    fit_block = block[: keep + min_block]
    slope, intercept = np.polyfit(times[fit_block], distances[fit_block], 1)
    return float(slope), distances, fit_block, float(intercept)
Dopasowana prędkość zależy od progu detekcji i kwantyla przycinania, a ta czułość dominuje nad szumem śrutowym. Przeskanuj oba parametry i podaj medianę wraz z pełną obwiednią, tak jak w opublikowanej analizie.
thresholds = [0.15, 0.225, 0.30, 0.375, 0.45]
quantiles = [0.60, 0.675, 0.75, 0.825, 0.90]

def velocity_envelope(tracer, center):
    """Median, minimum, and maximum velocity over the parameter scan."""
    values = [
        front_velocity(tracer, center, threshold=p, quantile=q)[0]
        for p in thresholds
        for q in quantiles
    ]
    values = np.array([v for v in values if np.isfinite(v)])
    if values.size == 0:
        return np.nan, np.nan, np.nan
    return float(np.median(values)), float(values.min()), float(values.max())

charge_velocity, charge_low, charge_high = velocity_envelope(
    charge_tracer, vacancy_site
)
spin_velocity, spin_low, spin_high = velocity_envelope(
    spin_tracer, vacancy_site
)

_, charge_front, charge_block, charge_intercept = front_velocity(
    charge_tracer, vacancy_site
)
_, spin_front, spin_block, spin_intercept = front_velocity(
    spin_tracer, vacancy_site
)

print(f"v_c = {charge_velocity:.2f}  [{charge_low:.2f}, {charge_high:.2f}]")
print(f"v_s = {spin_velocity:.2f}  [{spin_low:.2f}, {spin_high:.2f}]")
print(f"v_s / v_c = {spin_velocity / charge_velocity:.2f}")
v_c = 1.93  [1.81, 2.18]
v_s = 1.61  [1.23, 2.12]
v_s / v_c = 0.83
PUBLISHED = {"charge": 1.78, "spin": 1.46}

edge = max(vacancy_site, site_count - 1 - vacancy_site)
fig, axis = plt.subplots(figsize=(7, 4.6))

axis.axhspan(0, 2, color="0.92", zorder=0)
axis.axhspan(edge - 2, edge + 2, color="0.92", zorder=0)

series = [
    (
        "charge",
        "$v_c$",
        charge_front,
        charge_block,
        charge_velocity,
        charge_intercept,
        charge_low,
        charge_high,
        "C0",
        "o",
    ),
    (
        "spin",
        "$v_s$",
        spin_front,
        spin_block,
        spin_velocity,
        spin_intercept,
        spin_low,
        spin_high,
        "C1",
        "s",
    ),
]

for name, sym, front, block, v, b, lo, hi, color, marker in series:
    excluded = np.setdiff1d(np.arange(front.size), block)
    axis.plot(
        times[excluded],
        front[excluded],
        marker,
        color=color,
        markersize=5,
        markerfacecolor="none",
        alpha=0.45,
        zorder=2,
    )
    axis.plot(
        times[block],
        front[block],
        marker,
        color=color,
        markersize=5,
        label=f"{name}, {sym} = {v:.2f} [{lo:.2f}, {hi:.2f}]",
        zorder=3,
    )

    span = times[block]
    anchor = v * span[0] + b
    axis.plot(
        span,
        v * (span - span[0]) + anchor,
        "-",
        color=color,
        lw=1.6,
        zorder=4,
    )
    axis.fill_between(
        span,
        lo * (span - span[0]) + anchor,
        hi * (span - span[0]) + anchor,
        color=color,
        alpha=0.15,
        zorder=1,
    )
    axis.plot(
        span,
        PUBLISHED[name] * (span - span[0]) + anchor,
        "--",
        color=color,
        lw=1.2,
        alpha=0.8,
        zorder=4,
    )

axis.plot([], [], "--", color="0.4", lw=1.2, label="published [2]")
axis.plot(
    [],
    [],
    "o",
    color="0.5",
    markerfacecolor="none",
    label="excluded from fit",
)

axis.set_xlabel(r"Time $t$  $(1/t_h)$")
axis.set_ylabel("Front distance from vacancy (sites)")
axis.set_xlim(0, times[-1])
axis.set_ylim(
    0, min(edge + 1, np.nanmax(np.r_[charge_front, spin_front]) + 3)
)
axis.legend(loc="upper left", frameon=False, fontsize=9)
axis.set_title(
    f"L = {site_count}, $U/t_h$ = {on_site_interaction:.0f}, front propagation",
    fontsize=11,
)

fig.tight_layout()
plt.show()

Naniesienie detekcji z powrotem na mapy cieplne pokazuje, czy algorytm śledził front wiodący. Wypełnione znaczniki to detekcje, które weszły do dopasowania. Puste znaczniki zostały odrzucone przez reguły maskowania, ponieważ leżą zbyt blisko wakancji, zbyt blisko końca łańcucha albo były na tyle późne, że front się rozszerzył i jego pozycja nie jest już ostra. Linia przerywana to dopasowanie w użytym przedziale czasu, a jej nachylenie to prędkość podana w tytule każdego panelu.
Kolumna wakancji jest zaznaczona pod osią. Ładunek jest tam obcięty, ponieważ jego wartość jest rzędu jedności, a spin nie ma tam wartości, więc jest narysowany na szaro.
Stożek ładunku otwiera się szerzej niż stożek spinu. Oba zaburzenia opuszczają ten sam defekt w tym samym momencie i rozchodzą się na zewnątrz z różnymi prędkościami.
def plot_tracer_front(axis, tracer, front, block, velocity, intercept, title):
    """Overlay the detected wavefront and the fitted cone on a tracer heatmap."""
    image = plot_tracer(axis, tracer, title)

    excluded = np.setdiff1d(np.arange(front.size), block)
    for index, filled in ((block, True), (excluded, False)):
        good = index[np.isfinite(front[index])]
        if good.size == 0:
            continue
        for sign in (-1, 1):
            axis.plot(
                vacancy_site + sign * front[good],
                times[good],
                "o",
                markersize=4,
                color="k",
                markerfacecolor="k" if filled else "none",
                markeredgewidth=0.9,
                alpha=1.0 if filled else 0.4,
            )

    span = times[block]
    for sign in (-1, 1):
        axis.plot(
            vacancy_site + sign * (velocity * span + intercept),
            span,
            "--",
            color="k",
            lw=1.5,
        )

    axis.set_title(f"{title}    $v$ = {velocity:.2f}")
    return image

fig, axes = plt.subplots(1, 2, figsize=(11, 4.5), sharey=True)

charge_image = plot_tracer_front(
    axes[0],
    charge_tracer,
    charge_front,
    charge_block,
    charge_velocity,
    charge_intercept,
    r"Charge tracer $C^{c}_{i}(t)$",
)
spin_image = plot_tracer_front(
    axes[1],
    spin_tracer,
    spin_front,
    spin_block,
    spin_velocity,
    spin_intercept,
    r"Spin tracer $C^{s}_{i}(t)$",
)

axes[0].set_ylabel(r"Time $t$  $(1/t_h)$")
fig.colorbar(charge_image, ax=axes[0], fraction=0.046)
fig.colorbar(spin_image, ax=axes[1], fraction=0.046)
fig.suptitle(f"$L$ = {site_count},  $U/t_h$ = {on_site_interaction:.0f}")
fig.tight_layout()
plt.show()
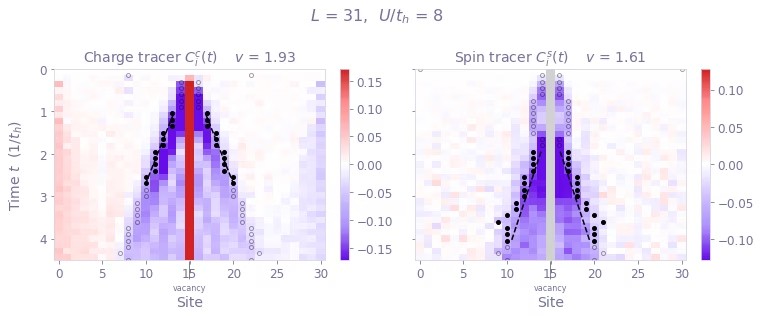
Front ładunku wyprzedza front spinu. Dziura w jednowymiarowym tle Motta nie porusza się jak elektron. Zamiast tego ulega frakcjonalizacji na holon niosący ładunek i spinon niosący zaburzenie spinu, a przy spinon jest wolniejszy z tych dwóch.
Kolejność zależy od oddziaływania. Przy model to swobodne fermiony z i , więc spin jest szybszy. Odpychanie tłumi transport spinu, pozostawiając transport ładunku prawie nietknięty, a przy opublikowane wartości ze sprzętu to i [2]. Ponowne uruchomienie dla kilku wartości i wykreślenie pokazuje przejście między tymi reżimami.
Zwróć uwagę na następujące zastrzeżenia dotyczące liczb. Detekcja oparta na progu jest nieznacznie zaniżona, więc prędkość ładunku o kilka procent niższa od opublikowanej jest oczekiwana. Obwiednia spinu jest szeroka, ponieważ skorelowany korelator leży bliżej poziomu szumu, dlatego podawana jest mediana ze skanu, a nie pojedyncze dopasowanie.
Bibliografia
[1] Essler, F. H. L., Frahm, H., Gohmann, F., Klumper, A., & Korepin, V. E. (2005). The One-Dimensional Hubbard Model. Cambridge University Press.
[2] Hartnett, G. S., Najafi, K. S., Khindanov, A., Liao, H., Schutzman, M., Hush, M. R., Biercuk, M. J., & Baum, Y. (2026). Fast, accurate, high-resolution simulation of large-scale Fermi-Hubbard models on a digital quantum processor. arXiv:2605.04025.