Formuły wieloproduktowe do redukcji błędu Trottera
Szacowane zużycie: cztery minuty na procesorze Heron r2 (UWAGA: to tylko szacunek. Twój czas wykonania może się różnić.)
Efekty uczenia się
-
Jak formuły wieloproduktowe (MPF) redukują błąd Trottera w symulacji hamiltonianu poprzez łączenie wartości oczekiwanych z wielu płytkich obwodów
-
Kiedy MPF są korzystne w porównaniu ze standardowymi formułami produktowymi, a kiedy nie są odpowiednim narzędziem
-
Jak obliczać statyczne i dynamiczne współczynniki MPF za pomocą pakietu
qiskit_addon_mpf -
Jak wykonać kompletny przepływ pracy MPF od początku do końca na sprzęcie IBM Quantum®, w tym transpilację, korekcję błędów i postprocessing
Wymagania wstępne
-
Metody kompilacji dla obwodów symulacji hamiltonianu — wprowadza obwody Trottera (formuły produktowej) w Qiskit.
-
Formuły produktowe w Qiskit, w szczególności klasy syntezy
SuzukiTrotteriLieTrotter.
Podstawy
Czym są formuły wieloproduktowe?
Podczas symulowania układów kwantowych na komputerze kwantowym centralnym zadaniem jest przybliżenie operatora ewolucji czasowej dla hamiltonianu . Standardowe podejście wykorzystuje formuły produktowe (PF), znane również jako dekompozycje Trottera-Suzukiego. Rozkładają one na człony, których poszczególne unitarne są wydajne do zaimplementowania, a następnie przybliżają pełną ewolucję jako uporządkowany iloczyn tych prostszych unitarnych.
Formuła produktowa pierwszego rzędu (Lie-Trotter) to:
co skutkuje błędem kwadratowym: . Formuły symetryczne wyższego rzędu , gdzie oznacza rząd symetrycznej formuły produktowej (patrz Ref. [1]), zbiegają szybciej jako , ale kosztem głębszych obwodów na krok.
Aby zmniejszyć błąd przy ustalonym rzędzie , zwykle dzieli się całkowity czas ewolucji na mniejszych kroków Trottera. Każdy krok przybliża za pomocą formuły produktowej, a kroki są łączone szeregowo:
Dla symetrycznej formuły rzędu pozostały błąd Trottera skaluje się wtedy jako . Zwiększanie szybko tłumi więc błąd Trottera — ale liniowo pogłębia też obwód, a na zaszumionym sprzęcie oznacza to więcej narastającego szumu bramek. To napięcie między błędem Trottera (faworyzującym większe ) a szumem sprzętowym (faworyzującym mniejsze ) jest właśnie tym, co formuły wieloproduktowe mają rozwiązać. Zauważ, że MPF polegają na łączeniu wyników z różnych wyborów przy ustalonym rzędzie — nie zmieniają rzędu bazowej formuły produktowej.
Formuły wieloproduktowe (MPF) [1] konstruują ważoną kombinację liniową wartości oczekiwanych uzyskanych z kilku płytszych obwodów Trottera, z których każdy używa innej liczby kroków Trottera (zbioru liczb kroków):
gdzie jest wartością oczekiwaną obserwabli w czasie oszacowaną z obwodu Trottera z krokami, a współczynniki są dobrane tak, aby wiodące człony błędu Trottera w kombinacji się znosiły. Powrócimy do tego wyrażenia w Kroku 4, gdzie oceniamy je jawnie, aby połączyć nasze wyniki Trottera. Kluczowy praktyczny punkt jest taki, że najgłębszy obwód w MPF potrzebuje tylko kroków, co jest znacznie mniejsze niż pojedyncze , które byłoby wymagane, aby bezpośrednio osiągnąć ten sam efektywny błąd Trottera. Płytsze obwody sprawiają, że podejście MPF lepiej nadaje się do zaszumionego sprzętu.
Jak wyznaczane są współczynniki?
Istnieją dwie rodziny współczynników MPF:
Współczynniki statyczne są niezależne od hamiltonianu, stanu początkowego i czasu ewolucji. Znajduje się je, rozwiązując układ liniowy , który wymusza zniesienie wiodących członów błędu Trottera. Dla zbioru kroków Trottera użytych z symetryczną formułą produktową rzędu , rozwinięcie błędu Trottera w odwrotnych potęgach prowadzi do równań ograniczających postaci:
gdzie całkowite wykładniki są rzędami kolejnych członów błędu Trottera dla wybranej formuły produktowej. Dla symetrycznej PF rzędu wiodący błąd w skaluje się jako , z kolejnymi poprawkami przy — więc wykładniki wynoszą . Dla niesymetrycznych PF przyczyniają się zarówno nieparzyste, jak i parzyste potęgi, a . Pełne wyprowadzenie znajduje się w Ref. [1]. Pierwsze równanie w powyższym układzie zapewnia nieobciążoność (MPF odtwarza dokładną wartość oczekiwaną w granicy ), a pozostałe równań kolejno znosi pierwsze członów błędu Trottera. Gdy wynikowa norma jest zbyt duża (co wzmacnia szum próbkowania), można zamiast tego rozwiązać przybliżoną optymalizację, która ogranicza , minimalizując jednocześnie .
Współczynniki dynamiczne [2], [3] dodatkowo zależą od hamiltonianu, stanu początkowego i czasu ewolucji . Minimalizują odległość w normie Frobeniusa między prawdziwym stanem ewoluowanym w czasie a przybliżeniem MPF:
gdzie jest macierzą Grama pokryć między stanami ewoluowanymi Trotterem dla różnych liczb kroków , a mierzy pokrycie z (przybliżonym) dokładnym stanem. W tym samouczku te wielkości są obliczane efektywnie za pomocą metod sieci tensorowych, konkretnie za pomocą backendów opartych na TeNPy w qiskit_addon_mpf.
Kiedy używać MPF
MPF są najbardziej korzystne, gdy:
-
Wąskim gardłem jest głębokość obwodu. Jeśli szum sprzętowy ogranicza głębokość, jaką możesz uruchomić, użyj MPF, aby uzyskać wyższą efektywną dokładność Trottera z płytszych obwodów.
-
Potrzebujesz dokładnych wartości oczekiwanych, a nie pełnego przygotowania stanu. MPF działają na poziomie wartości oczekiwanych — łączą liczby klasyczne, a nie stany kwantowe. Są więc idealne do estymacji obserwabli przy użyciu prymitywu Estimator.
-
Łączysz umiarkowaną liczbę liczb kroków Trottera. Zazwyczaj połączenie – różnych liczb kroków wystarcza, aby znieść kilka wiodących członów błędu Trottera przy zachowaniu zarządzalnego .
Kiedy MPF mogą nie pomóc
-
Bardzo krótkie czasy ewolucji. Gdy jest na tyle małe, że pojedyncza formuła Trottera niskiego rzędu jest już dokładna, koszt uruchamiania wielu obwodów jest niepotrzebny.
-
Zadania przygotowania stanu. MPF wytwarzają skorygowaną wartość oczekiwaną, a nie skorygowany stan kwantowy. Jeśli potrzebujesz rzeczywistego stanu ewoluowanego w czasie (na przykład jako wejście do innej podprocedury kwantowej), MPF nie mają zastosowania.
-
Liczby kroków Trottera naruszające reżim zbieżności. Wyprowadzenie współczynników statycznych rozwija każde indywidualne jako szereg w ; to rozwinięcie zbiega dobrze tylko wtedy, gdy . Jeśli jest wybrane zbyt małe dla danego , najpłytszy obwód jest daleko poza reżimem perturbacyjnym, człony błędu wyższego rzędu, których MPF nie znosi, stają się duże, a zniesienie może wymagać dużych współczynników. Norma jest praktycznym wskaźnikiem diagnostycznym: gdy , narzut próbkowania może przewyższyć redukcję błędu Trottera. Szczegóły znajdują się w przewodniku dotyczącym wyboru kroków Trottera.
Co obejmuje ten samouczek
Ten samouczek przeprowadza przez kompletny przepływ pracy MPF w dwóch etapach. Najpierw przykład na symulatorze w małej skali (10-kubitowy łańcuch Heisenberga) demonstruje, jak skonfigurować problem, obliczyć statyczne i dynamiczne współczynniki MPF oraz porównać wynikowe wartości oczekiwane z dokładną diagonalizacją. Następnie przykład na sprzęcie w dużej skali (50-kubitowy łańcuch XXZ) pokazuje, jak transpilować, wykonywać na sprzęcie IBM Quantum z korekcją błędów i przetwarzać wyniki za pomocą współczynników MPF. W całym tekście używamy pakietu qiskit_addon_mpf wraz ze standardowymi narzędziami Qiskit.
Wymagania
Przed rozpoczęciem tego samouczka upewnij się, że masz zainstalowane:
-
Qiskit SDK v2.0 lub nowszy, z obsługą wizualizacji
-
Qiskit Runtime v0.22 lub nowszy (
pip install qiskit-ibm-runtime) -
Symulator Qiskit Aer (
pip install qiskit-aer) -
Dodatek MPF Qiskit z backendem TeNPy (
pip install "qiskit-addon-mpf[tenpy]") -
Dodatek narzędziowy Qiskit (
pip install qiskit-addon-utils) -
SciPy (
pip install scipy)
Konfiguracja
Poniżej zbieramy wszystkie importy pakietów używane w tym samouczku w jednej komórce. Definiujemy też przebieg transpilera CollectAndCollapse, który łączy sąsiednie rotacje rxx i ryy w pojedynczą bramkę XXPlusYYGate. Ten przebieg jest stosowany zarówno podczas konstrukcji obwodu w Kroku 1 (aby utrzymać niską liczbę bramek), jak i pośrednio, gdy wyodrębniamy strukturę warstwową dla dynamicznego MPF w Kroku 4 (TeNPy oczekuje bramek dwukubitowych, a nie par nierozłączonych rotacji).
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-addon-mpf qiskit-addon-utils qiskit-aer qiskit-ibm-runtime scipy
import warnings

import numpy as np
import matplotlib.pyplot as plt
from functools import partial
from copy import deepcopy

from qiskit import QuantumCircuit
from qiskit.quantum_info import Pauli, SparsePauliOp, Statevector
from qiskit.synthesis import SuzukiTrotter
from qiskit.transpiler import CouplingMap, PassManager
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit.circuit.library import XXPlusYYGate
from qiskit.transpiler.passes.optimization.collect_and_collapse import (
    CollectAndCollapse,
    collect_using_filter_function,
    collapse_to_operation,
)

from qiskit_aer import AerSimulator
from qiskit_ibm_runtime import EstimatorV2 as Estimator, QiskitRuntimeService

from qiskit_addon_utils.problem_generators import (
    generate_xyz_hamiltonian,
    generate_time_evolution_circuit,
)
from qiskit_addon_utils.slicing import slice_by_depth
from qiskit_addon_mpf.static import setup_static_lse
from qiskit_addon_mpf.dynamic import setup_dynamic_lse
from qiskit_addon_mpf.costs import (
    setup_exact_problem,
    setup_sum_of_squares_problem,
    setup_frobenius_problem,
)
from qiskit_addon_mpf.backends.tenpy_layers import (
    LayerModel,
    LayerwiseEvolver,
)
from qiskit_addon_mpf.backends.tenpy_tebd import MPOState, MPS_neel_state

from scipy.linalg import expm

# Suppress TeNPy's `unit_cell_width` future-API warning. The default
# (`unit_cell_width=len(sites)`) is correct for Chain lattices, which is what
# `CouplingMap.from_line(...)` produces here, so the warning is informational.
warnings.filterwarnings(
    "ignore",
    message=r".*unit_cell_width.*",
    category=UserWarning,
)

# --- Helper: collect XX + YY rotations into a single gate ---
def filter_function(node):
    return node.op.name in {"rxx", "ryy"}

collect_function = partial(
    collect_using_filter_function,
    filter_function=filter_function,
    split_blocks=True,
    min_block_size=1,
)

def collapse_to_xx_plus_yy(block):
    param = 0.0
    for node in block.data:
        param += node.operation.params[0]
    return XXPlusYYGate(param)

collapse_function = partial(
    collapse_to_operation,
    collapse_function=collapse_to_xx_plus_yy,
)

pm = PassManager()
pm.append(CollectAndCollapse(collect_function, collapse_function))
Przykład na symulatorze w małej skali
Krok 1: Odwzorowanie danych wejściowych na problem kwantowy
Zaczynamy od 10-kubitowego modelu Heisenberga na linii, używając stanu Néela jako stanu początkowego. Hamiltonian to:
gdzie jest siłą sprzężenia między najbliższymi sąsiadami. Mierzymy korelator ZZ na parze kubitów w środku łańcucha i używamy kroków Trottera z formułą produktową drugiego rzędu.
L = 10

# Generate coupling map and Hamiltonian
coupling_map = CouplingMap.from_line(L, bidirectional=False)

hamiltonian = generate_xyz_hamiltonian(
    coupling_map,
    coupling_constants=(1.0, 1.0, 1.0),
    ext_magnetic_field=(0.0, 0.0, 0.0),
)
print(hamiltonian)
SparsePauliOp(['IIIIIIIXXI', 'IIIIIIIYYI', 'IIIIIIIZZI', 'IIIIIXXIII', 'IIIIIYYIII', 'IIIIIZZIII', 'IIIXXIIIII', 'IIIYYIIIII', 'IIIZZIIIII', 'IXXIIIIIII', 'IYYIIIIIII', 'IZZIIIIIII', 'IIIIIIIIXX', 'IIIIIIIIYY', 'IIIIIIIIZZ', 'IIIIIIXXII', 'IIIIIIYYII', 'IIIIIIZZII', 'IIIIXXIIII', 'IIIIYYIIII', 'IIIIZZIIII', 'IIXXIIIIII', 'IIYYIIIIII', 'IIZZIIIIII', 'XXIIIIIIII', 'YYIIIIIIII', 'ZZIIIIIIII'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])
# Observable: ZZ on the middle pair of qubits
observable = SparsePauliOp.from_sparse_list(
    [("ZZ", (L // 2 - 1, L // 2), 1.0)], num_qubits=L
)
print(observable)
SparsePauliOp(['IIIIZZIIII'],
              coeffs=[1.+0.j])
# MPF parameters
mpf_trotter_steps = [1, 2, 4]
order = 2
symmetric = False

trotter_times = np.arange(0.5, 1.55, 0.1)
exact_evolution_times = np.arange(trotter_times[0], 1.55, 0.05)
Budowanie obwodów Trottera
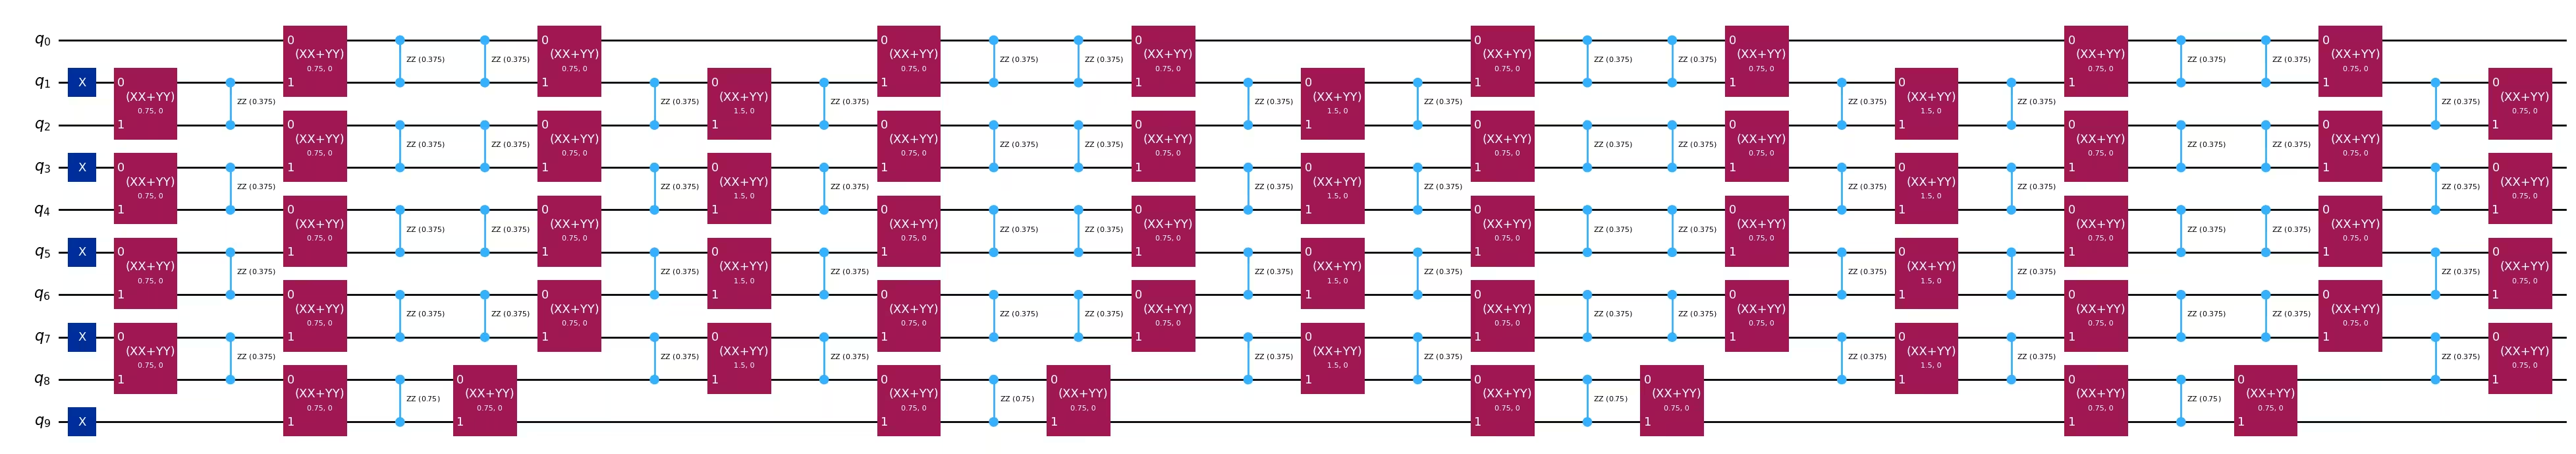
Tworzymy obwody implementujące przybliżone ewolucje czasowe Trottera dla każdego punktu czasowego i każdej liczby kroków Trottera. Przebieg CollectAndCollapse zdefiniowany w sekcji Konfiguracja łączy rotacje XX i YY w pojedyncze bramki XX+YY, aby przygotować się do wydajniejszej symulacji sieci tensorowej później.
# Initial Neel state preparation
initial_state_circ = QuantumCircuit(L)
initial_state_circ.x([i for i in range(L) if i % 2 != 0])

all_circs = []
for total_time in trotter_times:
    mpf_trotter_circs = [
        generate_time_evolution_circuit(
            hamiltonian,
            time=total_time,
            synthesis=SuzukiTrotter(reps=num_steps, order=order),
        )
        for num_steps in mpf_trotter_steps
    ]

    mpf_trotter_circs = pm.run(
        mpf_trotter_circs
    )  # Collect XX and YY into XX + YY

    mpf_circuits = [
        initial_state_circ.compose(circuit) for circuit in mpf_trotter_circs
    ]
    all_circs.append(mpf_circuits)
mpf_circuits[-1].draw("mpl", fold=-1)
Krok 2: Optymalizacja problemu pod kątem wykonania na sprzęcie kwantowym
Dla przykładu w małej skali celujemy w symulator Aer. Przed przygotowaniem obwodów do wykonania zachodzą dwie transformacje:
-
Łączenie bramek na poziomie symulacji hamiltonianu. W komórce Konfiguracja zbudowaliśmy przebieg
CollectAndCollapse, który łączy sąsiednie rotacjerxxiryyw pojedynczą bramkęXXPlusYYGate. Zastosowaliśmy już ten przebieg podczas budowania obwodów Trottera w Kroku 1 (wywołaniepm.run(...)). To zarówno zmniejsza liczbę bramek dwukubitowych, jak i tworzy strukturę bardziej podatną na symulację sieci tensorowej dla późniejszego obliczenia współczynników dynamicznych. -
Obniżenie do ISA symulatora. Poniżej uruchamiamy wstępnie zdefiniowany menedżer przebiegów Qiskit na
optimization_level=3, aby obniżyć każdy obwód Trottera do architektury zestawu instrukcji (ISA) symulatora.
aer_sim = AerSimulator()
pm_sim = generate_preset_pass_manager(backend=aer_sim, optimization_level=3)

isa_circs_all_times = [
    pm_sim.run([deepcopy(c) for c in mpf_circuits])
    for mpf_circuits in all_circs
]
Krok 3: Wykonanie przy użyciu prymitywów Qiskit
Dla przykładu w małej skali przepuszczamy obwody Trottera obniżone do ISA przez prymityw EstimatorV2 oparty na Aer. Daje to nam bezszumową wartość referencyjną dla każdej pary — są to wartości , które MPF połączy w Kroku 4. Przemiatamy zakres czasów ewolucji, abyśmy mogli później wykreślić pełną krzywą szeregu czasowego każdej indywidualnej formuły produktowej i MPF.
estimator = Estimator(mode=aer_sim)

mpf_expvals_all_times, mpf_stds_all_times = [], []
for isa_circuits in isa_circs_all_times:
    result = estimator.run(
        [(circuit, observable) for circuit in isa_circuits], precision=0.005
    ).result()
    mpf_expvals_all_times.append([res.data.evs for res in result])
    mpf_stds_all_times.append([res.data.stds for res in result])
Krok 4: Post-processing i zwrócenie wyniku w pożądanym formacie klasycznym
Krok 4 to miejsce, w którym MPF jest faktycznie konstruowana. Chociaż współczynniki są tu obliczane (a dla wariantu dynamicznego to obliczenie może być intensywne), koncepcyjnie stanowią one klasyczny przepis na łączenie pomiarów kwantowych z Kroku 3 w jedną skorygowaną wartość oczekiwaną — traktujemy więc cały przepływ obliczania współczynników i łączenia jako postprocessing.
Aby ocenić, jak dobrze MPF śledzi rzeczywistą dynamikę, najpierw obliczamy dokładne wartości oczekiwane ewoluowane w czasie poprzez bezpośrednie eksponencjowanie hamiltonianu. Jest to wykonalne jedynie dlatego, że ; w poniższym przykładzie na sprzęcie w dużej skali będziemy musieli zamiast tego polegać na szacunkach sieci tensorowej.
exact_expvals = []
for t in exact_evolution_times:
    exp_H = expm(-1j * t * hamiltonian.to_matrix())
    initial_state = Statevector(initial_state_circ).data
    time_evolved_state = exp_H @ initial_state

    exact_obs = (
        time_evolved_state.conj()
        @ observable.to_matrix()
        @ time_evolved_state
    ).real
    exact_expvals.append(exact_obs)
Statyczne współczynniki MPF
Statyczne MPF używają współczynników , które są niezależne od czasu ewolucji, hamiltonianu i stanu początkowego. Konfigurujemy układ liniowy opisany w sekcji Tło i rozwiązujemy dla współczynników. Macierz jest wyznaczana przez liczby kroków Trottera , rząd formuły produktowej oraz to, czy formuła jest symetryczna (co kontroluje wykładniki ).
Dla naszego przykładu w małej skali używamy z niesymetryczną formułą Suzukiego-Trottera rzędu (więc i , co daje ). Układ przyjmuje postać:
Pierwszy wiersz wymusza nieobciążoność (); drugi i trzeci wiersz znoszą odpowiednio wiodący człon błędu Trottera i kolejny człon .
Konfiguracja LSE
Używamy setup_static_lse z qiskit_addon_mpf.static, aby zestawić macierz i wektor prawej strony opisane powyżej. Macierz zależy nie tylko od , ale także od naszego wyboru formuły produktowej — w szczególności jej rzędu i tego, czy jest symetryczna. Flaga symmetric kontroluje wzorzec wykładników (formuły symetryczne generują tylko człony błędu Trottera o parzystej potędze; patrz Ref. [1]). Zauważ, że jak pokazano w Ref. [2], ustawienie symmetric=True nie jest ściśle konieczne, nawet gdy bazowa PF jest symetryczna — niesymetryczny LSE pozostaje ważny (wymusza dodatkowe, niepotrzebne ograniczenia).
Dla naszego przykładu ustawiliśmy już order = 2 i symmetric = False w Kroku 1.
lse = setup_static_lse(mpf_trotter_steps, order=order, symmetric=symmetric)
Sprawdź skonstruowaną macierz i wektor , aby potwierdzić, że odpowiadają układowi zapisanemu powyżej.
lse.A
array([[1.      , 1.      , 1.      ],
       [1.      , 0.25    , 0.0625  ],
       [1.      , 0.125   , 0.015625]])
lse.b
array([1., 0., 0.])
Mając gotowy LSE, rozwiązujemy dla statycznych współczynników za pomocą lse.solve() (jest to bezpośrednie rozwiązanie ).
mpf_coeffs = lse.solve()
print(
    f"The static coefficients associated with the ansatze are: {mpf_coeffs}"
)
The static coefficients associated with the ansatze are: [ 0.04761905 -0.57142857 1.52380952]
Optymalizacja za pomocą modelu dokładnego
Alternatywnie do obliczania , możesz użyć setup_exact_model, aby skonstruować instancję cvxpy.Problem, która używa LSE jako ograniczeń, a jej optymalne rozwiązanie daje .
model_exact, coeffs_exact = setup_exact_problem(lse)
model_exact.solve()
print(coeffs_exact.value)
[ 0.04761905 -0.57142857 1.52380952]
print(
    "L1 norm of the exact coefficients:",
    np.linalg.norm(coeffs_exact.value, ord=1),
)
L1 norm of the exact coefficients: 2.1428571428556378
Optymalizacja za pomocą modelu przybliżonego
Może się zdarzyć, że norma dla wybranego zestawu wartości zostanie uznana za zbyt wysoką. Jeśli tak jest i nie możesz wybrać innego zestawu wartości , możesz użyć przybliżonego rozwiązania, które ogranicza normę do wybranego progu, minimalizując jednocześnie . Zapoznaj się z przewodnikiem Jak używać modelu przybliżonego.
model_approx, coeffs_approx = setup_sum_of_squares_problem(
    lse, max_l1_norm=1.5
)
model_approx.solve()
print(coeffs_approx.value)
print(
    "L1 norm of the approximate coefficients:",
    np.linalg.norm(coeffs_approx.value, ord=1),
)
[-1.10294118e-03 -2.48897059e-01  1.25000000e+00]
L1 norm of the approximate coefficients: 1.5
Dynamiczne współczynniki MPF
Statyczny MPF znosi człony błędu Trottera w sposób niezależny od hamiltonianu i stanu, więc niekoniecznie daje najmniejszy możliwy błąd przybliżenia dla danego hamiltonianu i stanu początkowego. Dynamiczny MPF (Ref. [2], [3]) zamiast tego wyznacza zależne od czasu współczynniki , które minimalizują odległość w normie Frobeniusa w każdym czasie . Jak pokazano w sekcji Tło, wymaga to macierzy pokrycia między stanami ewoluowanymi Trotterem oraz pokrycia z dokładnym stanem — oba szacujemy za pomocą backendów sieci tensorowej (TeNPy) w qiskit_addon_mpf.
Aby skonfigurować dynamiczny LSE, potrzebujemy trzech składników:
-
Fabryki przybliżonego ewolwera, którą dodatek uruchomi dla każdego , aby wygenerować jako MPS/MPO. Budujemy ją ze struktury warstwowej obwodu Trottera drugiego rzędu (jedna warstwa na
slice_by_depth), opakowanej jakoLayerwiseEvolverz parametrami obcięcia TeNPy. -
Fabryki dokładnego ewolwera, która wytwarza referencję o wysokiej dokładności. Używamy obwodu Suzukiego-Trottera czwartego rzędu o małym kroku czasowym (
dt=0.1,order=4) jako namiastki dokładnej ewolucji. -
Fabryki tożsamości i początkowego MPS, które inicjują symulację TeNPy.
Poniższa komórka konstruuje fabrykę przybliżonego ewolwera.
# Create approximate time-evolution circuits
single_2nd_order_circ = generate_time_evolution_circuit(
    hamiltonian, time=1.0, synthesis=SuzukiTrotter(reps=1, order=order)
)
single_2nd_order_circ = pm.run(single_2nd_order_circ)  # collect XX and YY

# Find layers in the circuit
layers = slice_by_depth(single_2nd_order_circ, max_slice_depth=1)

# Create tensor network models
models = [
    LayerModel.from_quantum_circuit(layer, conserve="Sz") for layer in layers
]

# Create the time-evolution object
approx_factory = partial(
    LayerwiseEvolver,
    layers=models,
    options={
        "preserve_norm": False,
        "trunc_params": {
            "chi_max": 64,
            "svd_min": 1e-8,
            "trunc_cut": None,
        },
        "max_delta_t": 2,
    },
)
Opcje LayerwiseEvolver, które określają szczegóły symulacji sieci tensorowej, muszą być dobierane starannie, aby uniknąć skonfigurowania źle zdefiniowanego problemu optymalizacyjnego.
Przybliżamy dokładny stan ewoluujący w czasie za pomocą formuły Suzuki-Trottera czwartego rzędu, stosując mały krok czasowy dt=0.1. Parametry obcięcia TeNPy mogą wpływać na dokładność, więc ważne jest zbadanie zakresu wartości.
single_4th_order_circ = generate_time_evolution_circuit(
    hamiltonian, time=1.0, synthesis=SuzukiTrotter(reps=1, order=4)
)
single_4th_order_circ = pm.run(single_4th_order_circ)
exact_model_layers = [
    LayerModel.from_quantum_circuit(layer, conserve="Sz")
    for layer in slice_by_depth(single_4th_order_circ, max_slice_depth=1)
]

exact_factory = partial(
    LayerwiseEvolver,
    layers=exact_model_layers,
    dt=0.1,
    options={
        "preserve_norm": False,
        "trunc_params": {
            "chi_max": 64,
            "svd_min": 1e-8,
            "trunc_cut": None,
        },
        "max_delta_t": 2,
    },
)
Na koniec definiujemy identity_factory, który zwraca początkowy stan MPO, i przygotowujemy początkowy stan Néela jako MPS pasujący do sieci używanej przez warstwowy model Trottera.
def identity_factory():
    return MPOState.initialize_from_lattice(models[0].lat, conserve=True)

mps_initial_state = MPS_neel_state(models[0].lat)
Mając gotowe fabryki, obliczamy teraz dynamiczne współczynniki w każdym czasie ewolucji. Dla każdego setup_dynamic_lse buduje odpowiednie macierze pokrycia za pomocą TeNPy, a setup_frobenius_problem zwraca cvxpy.Problem, który minimalizuje koszt w normie Frobeniusa. Solver zwraca współczynniki dopasowane do danego czasu; zbieramy je w mpf_dynamic_coeffs_list. Jeśli solver zawiedzie dla danego , wracamy do zerowych współczynników, aby pętla mogła kontynuować.
mpf_dynamic_coeffs_list = []
for t in trotter_times:
    print(f"Computing dynamic coefficients for time={t}")
    lse = setup_dynamic_lse(
        mpf_trotter_steps,
        t,
        identity_factory,
        exact_factory,
        approx_factory,
        mps_initial_state,
    )
    problem, coeffs = setup_frobenius_problem(lse)
    try:
        problem.solve()
        mpf_dynamic_coeffs_list.append(coeffs.value)
    except Exception as error:
        mpf_dynamic_coeffs_list.append(np.zeros(len(mpf_trotter_steps)))
        print(error, "Calculation Failed for time", t)
    print("")
Computing dynamic coefficients for time=0.5

Computing dynamic coefficients for time=0.6

Computing dynamic coefficients for time=0.7

Computing dynamic coefficients for time=0.7999999999999999

Computing dynamic coefficients for time=0.8999999999999999

Computing dynamic coefficients for time=0.9999999999999999

Computing dynamic coefficients for time=1.0999999999999999

Computing dynamic coefficients for time=1.1999999999999997

Computing dynamic coefficients for time=1.2999999999999998

Computing dynamic coefficients for time=1.4

Computing dynamic coefficients for time=1.4999999999999998
Łączenie wartości oczekiwanych Trottera ze współczynnikami MPF
Teraz obliczamy dla każdego zestawu współczynników (statyczny-dokładny, statyczny-przybliżony i dynamiczny), propagujemy błędy standardowe poszczególnych obwodów i wykreślamy wynikowy szereg czasowy w porównaniu z krzywą dokładnej diagonalizacji.
sym = {1: "^", 2: "s", 4: "p"}
# Get expectation values at all times for each Trotter step
for k, step in enumerate(mpf_trotter_steps):
    trotter_curve, trotter_curve_error = [], []
    for trotter_expvals, trotter_stds in zip(
        mpf_expvals_all_times, mpf_stds_all_times
    ):
        trotter_curve.append(trotter_expvals[k])
        trotter_curve_error.append(trotter_stds[k])

    plt.errorbar(
        trotter_times,
        trotter_curve,
        yerr=trotter_curve_error,
        alpha=0.5,
        markersize=4,
        marker=sym[step],
        color="grey",
        label=f"{mpf_trotter_steps[k]} Trotter steps",
    )

# Get expectation values at all times for the static MPF with exact coeffs
exact_mpf_curve, exact_mpf_curve_error = [], []
for trotter_expvals, trotter_stds in zip(
    mpf_expvals_all_times, mpf_stds_all_times
):
    mpf_std = np.sqrt(
        sum(
            [
                (coeff**2) * (std**2)
                for coeff, std in zip(coeffs_exact.value, trotter_stds)
            ]
        )
    )
    exact_mpf_curve_error.append(mpf_std)
    exact_mpf_curve.append(trotter_expvals @ coeffs_exact.value)

plt.errorbar(
    trotter_times,
    exact_mpf_curve,
    yerr=exact_mpf_curve_error,
    markersize=4,
    marker="o",
    label="Static MPF - Exact",
    color="purple",
)

# Get expectation values at all times for the static MPF with approximate coeffs
approx_mpf_curve, approx_mpf_curve_error = [], []
for trotter_expvals, trotter_stds in zip(
    mpf_expvals_all_times, mpf_stds_all_times
):
    mpf_std = np.sqrt(
        sum(
            [
                (coeff**2) * (std**2)
                for coeff, std in zip(coeffs_approx.value, trotter_stds)
            ]
        )
    )
    approx_mpf_curve_error.append(mpf_std)
    approx_mpf_curve.append(trotter_expvals @ coeffs_approx.value)

plt.errorbar(
    trotter_times,
    approx_mpf_curve,
    yerr=approx_mpf_curve_error,
    markersize=4,
    marker="o",
    label="Static MPF - Approx",
    color="orange",
)

# Get expectation values at all times for the dynamic MPF
dynamic_mpf_curve, dynamic_mpf_curve_error = [], []
for trotter_expvals, trotter_stds, dynamic_coeffs in zip(
    mpf_expvals_all_times, mpf_stds_all_times, mpf_dynamic_coeffs_list
):
    mpf_std = np.sqrt(
        sum(
            [
                (coeff**2) * (std**2)
                for coeff, std in zip(dynamic_coeffs, trotter_stds)
            ]
        )
    )
    dynamic_mpf_curve_error.append(mpf_std)
    dynamic_mpf_curve.append(trotter_expvals @ dynamic_coeffs)

plt.errorbar(
    trotter_times,
    dynamic_mpf_curve,
    yerr=dynamic_mpf_curve_error,
    markersize=4,
    marker="o",
    label="Dynamic MPF",
    color="pink",
)

# Exact expectation values
plt.plot(
    exact_evolution_times,
    exact_expvals,
    color="red",
    linestyle="--",
    label="Exact time-evolution",
)

plt.title(f"$\\langle Z_{{{L//2-1}}} Z_{{{L//2}}} \\rangle$ vs time")
plt.xlabel("Time")
plt.ylabel("Expectation Value")
plt.legend(loc="upper center", bbox_to_anchor=(0.5, -0.2), ncol=2)
plt.grid(alpha=0.1)
plt.tight_layout()
plt.show()

Powyższy wykres ilustruje wzajemne oddziaływanie błędu Trottera i błędu próbkowania.
-
Błąd Trottera. Poszczególne formuły produktowe (szare znaczniki) odchylają się od dokładnej krzywej coraz bardziej wraz z upływem czasu. Obwód ma największe odchylenie i jest najpłytszy, ale znajduje się już również w reżimie, gdzie , więc wiodący człon błędu jest duży. Kombinacje MPF (kolorowe znaczniki) znoszą kilka z tych wiodących członów błędu Trottera, więc śledzą dokładną krzywą znacznie ściślej niż jakikolwiek pojedynczy obwód . Pozostała luka odzwierciedla człony Trottera wyższego rzędu, których MPF nie znosi: statyczny MPF rzędu , , znosi tylko pierwsze dwa rzędy błędu, a przy dużym nieznesiony ogon ostatecznie dominuje — więc MPF nie gwarantuje, że bardzo płytkie obwody pozostają dokładne w dowolnych czasach.
-
Błąd próbkowania. Szersze słupki błędu na krzywych MPF są bezpośrednią konsekwencją kombinacji liniowej: propagacja niezależnych błędów standardowych poszczególnych obwodów daje całkowitą wariancję . Dlatego im większe (a w praktyce , którym sterujemy), tym więcej strzałów jest wymaganych, aby osiągnąć zadaną niepewność docelową. To kompromis stojący za opcją solvera przybliżonego w sekcji Tło: ograniczamy , aby utrzymać ten narzut w ryzach. Co ważne, w przeciwieństwie do błędu Trottera, błąd próbkowania maleje jak , więc zawsze można go zredukować, wydając więcej strzałów.
W poniższym przykładzie na sprzęcie w dużej skali szum sprzętowy wchodzi jako dodatkowe źródło błędu na każde , które podobnie jest wzmacniane przez współczynniki MPF. Zobaczymy, jak korekcja błędów oddziałuje z MPF w tej sekcji.
Przykład sprzętu na dużą skalę
W tej części skalujemy problem poza to, co jest możliwe do dokładnej symulacji. Odtwarzamy niektóre wyniki przedstawione w Ref. [3], używając 50-kubitowego łańcucha XXZ w czasie . Podążamy za tym samym czteroetapowym przepływem pracy co w przykładzie małej skali, tym razem celując w prawdziwy sprzęt kwantowy z korekcją błędów. Podobnie jak w szablonie, każdy krok jest oznaczony w kodzie, a pojedynczy krok może obejmować wiele komórek, gdy warto sprawdzić wyniki pośrednie. Mapowanie odzwierciedla przykład małej skali: zdefiniuj hamiltonian, wybierz parametry Trottera, oblicz współczynniki MPF (statyczne i dynamiczne) oraz zbuduj obwody. Kluczowe różnice to:
-
Hamiltonian XXZ na 50 miejscach z losowymi sprzężeniami wybranymi z (Ref. [3]).
-
Symetryczna formuła Trottera drugiego rzędu z (więc ,
symmetric=True). -
Pojedynczy ustalony czas ewolucji . Przy daje to , utrzymując płytkie składowe w reżimie zbieżności Trottera, w którym model błędu wiodącego, na którym opiera się MPF, jest ważny.
-
Dodatkowe uruchomienie porównawcze pojedynczego obwodu z krokami Trottera, użyte jako punkt odniesienia. Wybraliśmy , ponieważ jego głębokość bramek dwukubitowych na sprzęcie jest głębsza niż najgłębsza składowa MPF () plus narzut wykonywania wielu obwodów MPF — wystarczająco głęboka, by być ograniczona szumem, co jest reżimem, w którym kombinacja MPF ma przewyższać pojedynczy obwód odniesienia. Jest to porównanie "pojedynczego głębokiego obwodu" z kombinacją MPF, a nie obwodu celującego w efektywny błąd Trottera MPF (co wymagałoby znacznie więcej kroków).
Zwróć uwagę, że mimo iż wciąż jesteśmy w Kroku 1 (mapowanie i konstrukcja obwodu), w tej komórce obliczamy z wyprzedzeniem także współczynniki dynamiczne obok statycznych. Współczynniki dynamiczne zależą od i , ale nie od pomiarów kwantowych, więc można je obliczyć w dowolnym momencie przed Krokiem 4. Robimy to teraz, aby całą konfigurację specyficzną dla MPF zebrać w jednym miejscu.
# -------------------------Step 1-------------------------
L = 50
coupling_map = CouplingMap.from_line(L, bidirectional=False)

# XXZ Hamiltonian with random couplings (Ref. [3])
np.random.seed(0)
even_edges = list(coupling_map.get_edges())[::2]
odd_edges = list(coupling_map.get_edges())[1::2]

Js = np.random.uniform(0.5, 1.5, size=L)
hamiltonian = SparsePauliOp(Pauli("I" * L))
for i, edge in enumerate(even_edges + odd_edges):
    hamiltonian += SparsePauliOp.from_sparse_list(
        [
            ("XX", (edge), 2 * Js[i]),
            ("YY", (edge), 2 * Js[i]),
            ("ZZ", (edge), 4 * Js[i]),
        ],
        num_qubits=L,
    )

observable = SparsePauliOp.from_sparse_list(
    [("ZZ", (L // 2 - 1, L // 2), 1.0)], num_qubits=L
)

total_time = 3
mpf_trotter_steps = [3, 4, 6]
order = 2
symmetric = True

# Static coefficients
lse = setup_static_lse(mpf_trotter_steps, order=order, symmetric=symmetric)
mpf_coeffs = lse.solve()
print(f"Static coefficients: {mpf_coeffs}")
print(f"L1 norm: {np.linalg.norm(mpf_coeffs, ord=1)}")

model_approx, coeffs_approx = setup_sum_of_squares_problem(
    lse, max_l1_norm=2.0
)
model_approx.solve()
print(f"Approximate coefficients: {coeffs_approx.value}")
print(f"L1 norm (approx): {np.linalg.norm(coeffs_approx.value, ord=1)}")

# -------------------------Dynamic coefficients-------------------------
single_2nd_order_circ = generate_time_evolution_circuit(
    hamiltonian, time=1.0, synthesis=SuzukiTrotter(reps=1, order=order)
)
single_2nd_order_circ = pm.run(single_2nd_order_circ)

layers = slice_by_depth(single_2nd_order_circ, max_slice_depth=1)
models = [
    LayerModel.from_quantum_circuit(layer, conserve="Sz") for layer in layers
]

approx_factory = partial(
    LayerwiseEvolver,
    layers=models,
    options={
        "preserve_norm": False,
        "trunc_params": {"chi_max": 64, "svd_min": 1e-8, "trunc_cut": None},
        "max_delta_t": 4,
    },
)

single_4th_order_circ = generate_time_evolution_circuit(
    hamiltonian, time=1.0, synthesis=SuzukiTrotter(reps=1, order=4)
)
single_4th_order_circ = pm.run(single_4th_order_circ)
exact_model_layers = [
    LayerModel.from_quantum_circuit(layer, conserve="Sz")
    for layer in slice_by_depth(single_4th_order_circ, max_slice_depth=1)
]

exact_factory = partial(
    LayerwiseEvolver,
    layers=exact_model_layers,
    dt=0.1,
    options={
        "preserve_norm": False,
        "trunc_params": {"chi_max": 64, "svd_min": 1e-8, "trunc_cut": None},
        "max_delta_t": 3,
    },
)

def identity_factory():
    return MPOState.initialize_from_lattice(models[0].lat, conserve=True)

mps_initial_state = MPS_neel_state(models[0].lat)

print(f"Computing dynamic coefficients for time={total_time}")
lse_dyn = setup_dynamic_lse(
    mpf_trotter_steps,
    total_time,
    identity_factory,
    exact_factory,
    approx_factory,
    mps_initial_state,
)
problem, coeffs_dyn = setup_frobenius_problem(lse_dyn)
try:
    problem.solve()
    mpf_dynamic_coeffs = coeffs_dyn.value
except Exception as error:
    mpf_dynamic_coeffs = np.zeros(len(mpf_trotter_steps))
    print(error, "Calculation Failed")

# -------------------------Step 1 (cont): Build circuits-------------------------
mpf_circuits = []
for k in mpf_trotter_steps:
    circuit = QuantumCircuit(L)
    circuit.x([i for i in range(L) if i % 2])
    trotter_circ = generate_time_evolution_circuit(
        hamiltonian,
        synthesis=SuzukiTrotter(reps=k, order=order),
        time=total_time,
    )
    circuit.compose(trotter_circ, qubits=range(L), inplace=True)
    mpf_circuits.append(circuit)

# Baseline "single deep circuit" comparison run with k=10 Trotter steps.
# Its two-qubit depth is deeper than the deepest MPF constituent (k_max=6) plus
# the overhead of running multiple circuits, pushing it into the noise-limited
# regime where MPF is expected to outperform. It does NOT target the MPF's effective
# Trotter error (which would require many more steps).
comp_circuit = QuantumCircuit(L)
comp_circuit.x([i for i in range(L) if i % 2])
trotter_circ = generate_time_evolution_circuit(
    hamiltonian,
    synthesis=SuzukiTrotter(reps=10, order=order),
    time=total_time,
)
comp_circuit.compose(trotter_circ, qubits=range(L), inplace=True)
mpf_circuits.append(comp_circuit)
Static coefficients: [ 0.42857143 -1.82857143  2.4       ]
L1 norm: 4.65714285714286
Approximate coefficients: [-0.4942491   0.40206845  1.09218065]
L1 norm (approx): 1.9884981979026675
Computing dynamic coefficients for time=3
Teraz optymalizujemy obwody pod wybrany backend. Używamy predefiniowanego menedżera przebiegów Qiskit na optimization_level=3, który automatycznie wybiera dobry zestaw fizycznych kubitów i routuje każdy obwód na topologię urządzenia.
# -------------------------Step 2-------------------------
service = QiskitRuntimeService()
# backend = service.least_busy(operational=True, simulator=False, min_num_qubits=L)
backend = service.backend("ibm_fez")
print(backend)

transpiler = generate_preset_pass_manager(
    optimization_level=3, backend=backend
)
transpiled_circuits = [transpiler.run(circ) for circ in mpf_circuits]

isa_observables = [
    observable.apply_layout(circ.layout) for circ in transpiled_circuits
]
<IBMBackend('ibm_fez')>
Uruchamianie głębszych obwodów na prawdziwym sprzęcie wymaga agresywnej korekcji błędów. Włączamy dynamiczne odsprzęganie (dynamical decoupling), twirling bramek i pomiarów, korekcję błędów pomiaru oraz ekstrapolację do zerowego szumu (ZNE). Zwróć uwagę, że współczynniki szumu ZNE, których tu używamy (1, 1.2, 1.4), są mniejsze niż w scenariuszu płytkiego obwodu, ponieważ głębsze składowe MPF są już bliskie progu szumu, a duże wzmocnienia szumu przesunęłyby je poza punkt, w którym ekstrapolacja ZNE jest wiarygodna.
Przesyłamy wszystkie cztery obwody (trzy składowe MPF przy plus punkt odniesienia ) w pojedynczym zadaniu Estimatora.
# -------------------------Step 3-------------------------
estimator = Estimator(mode=backend)
estimator.options.default_shots = 30000

# Error suppression/mitigation
estimator.options.dynamical_decoupling.enable = True
estimator.options.twirling.enable_gates = True
estimator.options.twirling.enable_measure = True
estimator.options.twirling.num_randomizations = "auto"
estimator.options.twirling.strategy = "active-accum"
estimator.options.resilience.measure_mitigation = True
estimator.options.experimental.execution_path = "gen3-turbo"

estimator.options.resilience.zne_mitigation = True
estimator.options.resilience.zne.noise_factors = (1, 1.2, 1.4)
estimator.options.resilience.zne.extrapolator = "linear"

estimator.options.environment.job_tags = ["TUT_MPF"]

job_50 = estimator.run(
    [
        (circ, observable)
        for circ, observable in zip(transpiled_circuits, isa_observables)
    ]
)
Pobieramy wartości oczekiwane i odchylenia standardowe dla poszczególnych obwodów z wyniku zadania, a następnie łączymy je z każdym zestawem współczynników MPF dokładnie tak, jak w przykładzie małej skali: , z propagowaną wariancją .
# -------------------------Step 4-------------------------
result = job_50.result()
evs = [res.data.evs for res in result]
std = [res.data.stds for res in result]

print(evs)
print(std)
[array(-0.07916195), array(-0.04479681), array(-0.2560756), array(-0.06045848)]
[array(0.04605538), array(0.10056336), array(0.14426151), array(0.04059092)]
exact_mpf_std = np.sqrt(
    sum([(coeff**2) * (std**2) for coeff, std in zip(mpf_coeffs, std[:3])])
)
print(
    "Exact static MPF expectation value: ",
    evs[:3] @ mpf_coeffs,
    "+-",
    exact_mpf_std,
)
approx_mpf_std = np.sqrt(
    sum(
        [
            (coeff**2) * (std**2)
            for coeff, std in zip(coeffs_approx.value, std[:3])
        ]
    )
)
print(
    "Approximate static MPF expectation value: ",
    evs[:3] @ coeffs_approx.value,
    "+-",
    approx_mpf_std,
)
dynamic_mpf_std = np.sqrt(
    sum(
        [
            (coeff**2) * (std**2)
            for coeff, std in zip(mpf_dynamic_coeffs, std[:3])
        ]
    )
)
print(
    "Dynamic MPF expectation value: ",
    evs[:3] @ mpf_dynamic_coeffs,
    "+-",
    dynamic_mpf_std,
)
Exact static MPF expectation value:  -0.5665938395816946 +- 0.3925273058119915
Approximate static MPF expectation value:  -0.25856647611537903 +- 0.164249927266166
Dynamic MPF expectation value:  -0.12667812062949296 +- 0.06059471006973169
sym = {3: "^", 4: "s", 6: "p"}
for k, step in enumerate(mpf_trotter_steps):
    plt.errorbar(
        k,
        evs[k],
        yerr=std[k],
        alpha=0.5,
        markersize=4,
        marker=sym[step],
        color="grey",
        label=f"{mpf_trotter_steps[k]} Trotter steps",
    )

plt.errorbar(
    3,
    evs[-1],
    yerr=std[-1],
    alpha=0.5,
    markersize=8,
    marker="x",
    color="blue",
    label="10 Trotter steps",
)

plt.errorbar(
    4,
    evs[:3] @ mpf_coeffs,
    yerr=exact_mpf_std,
    markersize=4,
    marker="o",
    color="purple",
    label="Static MPF",
)

plt.errorbar(
    5,
    evs[:3] @ coeffs_approx.value,
    yerr=approx_mpf_std,
    markersize=4,
    marker="o",
    color="orange",
    label="Approximate static MPF",
)

plt.errorbar(
    6,
    evs[:3] @ mpf_dynamic_coeffs,
    yerr=dynamic_mpf_std,
    markersize=4,
    marker="o",
    color="pink",
    label="Dynamic MPF",
)

exact_obs = -0.24384471447172074  # Calculated via Tensor Network calculation
plt.axhline(
    y=exact_obs, linestyle="--", color="red", label="Exact time-evolution"
)

plt.title(
    f"$\\langle Z_{{{L//2-1}}} Z_{{{L//2}}} \\rangle$ at time {total_time} for the different methods"
)
plt.xlabel("Method")
plt.ylabel("Expectation Value")
plt.legend(loc="upper center", bbox_to_anchor=(0.5, -0.2), ncol=2)
plt.grid(alpha=0.1)
plt.tight_layout()
plt.show()

Kilka obserwacji dotyczących powyższych wyników sprzętowych:
-
Zwiększanie głębokości nie jest darmowe na sprzęcie. Punkty odniesienia z pojedynczym obwodem mówią wprost: obwód jest zasadniczo dokładny ( wobec wartości referencyjnej ), jednak głębszy punkt odniesienia jest gorszy (, odchylenie o ), a nie lepszy. Gdy błąd Trottera jest już mały, dodawanie kroków głównie pogłębia obwód i kumuluje więcej szumu bramek oraz dekoherencji. To dokładnie ten reżim, dla którego zbudowano MPF: osiągnąć dokładność głębokiego obwodu, używając wyłącznie płytkich składowych.
-
MPF o małej normie pokonuje głęboki pojedynczy obwód. Przybliżony statyczny MPF (ograniczony do ) daje wynik , w granicach od wartości referencyjnej i znacznie bliższy niż punkt odniesienia . Dynamiczny MPF () także wyraźnie przewyższa ten punkt odniesienia. Oba łączą jedynie płytkie obwody , a mimo to odzyskują odpowiedź, której głęboki pojedynczy obwód nie był w stanie osiągnąć.
-
Norma współczynników ma większe znaczenie niż matematyczna optymalność. Dokładny statyczny MPF ma i jest najgorszym ze wszystkich estymatorów (, odchylenie ponad ): duża norma współczynników wzmacnia resztkowy szum bramek, dekoherencję i błąd ZNE dla każdego mniej więcej o ten sam czynnik, przytłaczając zysk z redukcji błędu Trottera. Ograniczenie normy (przybliżony statyczny solver, ) usuwa to przytłoczenie i daje najlepsze oszacowanie — mimo że jego współczynniki nie znoszą już dokładnie wiodącego błędu Trottera.
-
Pojedyncze płytkie obwody wciąż mogą być konkurencyjne. Sam pojedynczy składnik () jest tu sam w sobie zasadniczo dokładny — w tym przebiegu jest nawet nieznacznie bliższy niż przybliżony statyczny MPF. Problem polega na tym, że z góry nie wiadomo, który pojedynczy znajduje się w optymalnym punkcie "zbieżny, ale jeszcze nie ograniczony szumem", a pozornie bezpieczny wybór po prostu zwiększenia głębokości () w celu zagwarantowania zbieżności Trottera jest właśnie tym, który zawodzi. MPF daje uzasadnioną kombinację płytkich obwodów, która nie wymaga zgadywania właściwej głębokości.
Praktyczny wniosek jest taki, że na sprzęcie MPF-y powinny być łączone z silną korekcją błędów dla każdego pojedynczego , norma współczynników powinna być utrzymywana na umiarkowanym poziomie (użyj przybliżonego solvera lub dynamicznego MPF), a kroki Trottera powinny być dobrane tak, by — tutaj przy daje , utrzymując składowe w reżimie zbieżnym, w którym model błędu wiodącego, na którym opiera się statyczny MPF, jest ważny. Przy tych wyborach MPF-y o małej normie odpowiadają tu zbieżnemu pojedynczemu obwodowi, podczas gdy naiwny punkt odniesienia "po prostu idź głębiej" tego nie robi, odzyskując przewagę głębokości nad dokładnością pokazaną w Ref. [3]. Zwróć też uwagę, że pojedyncze przebiegi są zaszumione — przy innym przesłaniu tego samego zadania (lub innym backendzie) dokładna kolejność może się zmienić; solidne trendy są takie, że MPF-y o małym radzą sobie dobrze, dokładny statyczny MPF o dużym jest wzmacniany przez szum sprzętowy, a nadmiernie głęboki pojedynczy obwód jest ograniczony szumem.
Kolejne kroki
Jeśli ta praca była dla Ciebie interesująca, może zainteresują Cię następujące materiały:
- Jak wybrać kroki Trottera dla MPF — praktyczne wskazówki dotyczące wyboru wartości , aby uniknąć niestabilności
- Jak używać modelu przybliżonego — dostrajanie ograniczenia normy i opcji solvera dla przybliżonego statycznego MPF
- Dokumentacja API
qiskit-addon-mpf— pełna dokumentacja modułów statycznych, dynamicznych i backendowych
Referencje
[1] Vazquez, A. C., Egger, D. J., Ochsner, D., & Woerner, S. Well-conditioned multi-product formulas for hardware-friendly Hamiltonian simulation. Quantum, 7, 1067 (2023)
[2] Zhuk, S., Robertson, N. F., & Bravyi, S. Trotter error bounds and dynamic multi-product formulas for Hamiltonian simulation. Physical Review Research, 6(3), 033309 (2024)
[3] Robertson, N. F., et al. Tensor network enhanced dynamic multiproduct formulas. arXiv:2407.17405 (2024)