Parity Twine Optimizer: funkcja Qiskit firmy ParityQC
Zobacz dokumentację API
Qiskit Functions to funkcja eksperymentalna dostępna wyłącznie dla użytkowników planów IBM Quantum® Premium Plan, Flex Plan oraz On-Prem (poprzez IBM Quantum Platform API). Znajdują się w stanie wersji zapoznawczej (preview) i mogą ulec zmianie.
Przegląd
Parity Twine Optimizer umożliwia użytkownikom rozwiązywanie problemów optymalizacyjnych za pomocą komputerów kwantowych przy użyciu metody Parity Twine. To podejście, oparte na architekturze Parity Architecture, wykorzystuje kompilator ParityQC do minimalizowania liczby bramek i głębokości obwodu wymaganych do uruchomienia algorytmu kwantowego, uwzględniając przy tym łączność urządzenia.
Ta redukcja zasobów umożliwia rozwiązywanie istotnych dla przemysłu problemów optymalizacyjnych o rozmiarach niewykonalnych przy standardowych metodach transpilacji intensywnie wykorzystujących bramki SWAP. Parity Twine Optimizer automatyzuje kroki transpilacji i może być używany przy minimalnym udziale użytkownika.
Podejście Parity Twine przewyższa wszystkie inne metody kompilacji pod względem redukcji liczby bramek i głębokości obwodów dla algorytmów kwantowych, takich jak algorytm QAOA (quantum approximate optimization algorithm) oraz kwantowa transformata Fouriera (QFT). Dzięki abstrahowaniu informacji kwantowej od fizycznych kubitów, interakcje nielokalne są realizowane bez bramek SWAP. Zamiast tego łańcuchy Parity Twine (sekwencje bramek CNOT) systematycznie rozprowadzają logiczne informacje o parzystości między kubitami.
Optymalizator wykorzystuje QAOA do minimalizacji energii danej funkcji kosztu. QAOA to hybrydowy algorytm wariacyjny kwantowo-klasyczny zaprojektowany do rozwiązywania kombinatorycznych problemów optymalizacyjnych poprzez przybliżanie stanu podstawowego hamiltonianu kosztu (). Składnik mieszający () napędza przejścia między stanami w celu eksploracji przestrzeni rozwiązań. Naprzemienna sekwencja tych składników, kontrolowana przez parametry i , definiuje unitarną operację , która działa na stan początkowy.
Kodowanie unitarnej operacji problemu, exp(), wymaga zakodowania wszystkich logicznych operatorów rotacji -ciałowych (exp()). Można to osiągnąć za pomocą generatorów -ciałowych (sieci Parity Twine Networks), które zmniejszają głębokość obwodu QAOA oraz liczbę bramek dwukubitowych.
Opis
Dane wejściowe Parity Twine Optimizer składają się z problemu optymalizacyjnego, wybranej nazwy sprzętu IBM Quantum oraz dodatkowych opcjonalnych argumentów pozwalających dostosować ustawienia transpilacji i wykonania na sprzęcie. Funkcja optymalizatora przekazuje definicję problemu do kompilatora Parity Twine. Rysunek 1 przedstawia podsumowanie przebiegu pracy funkcji.
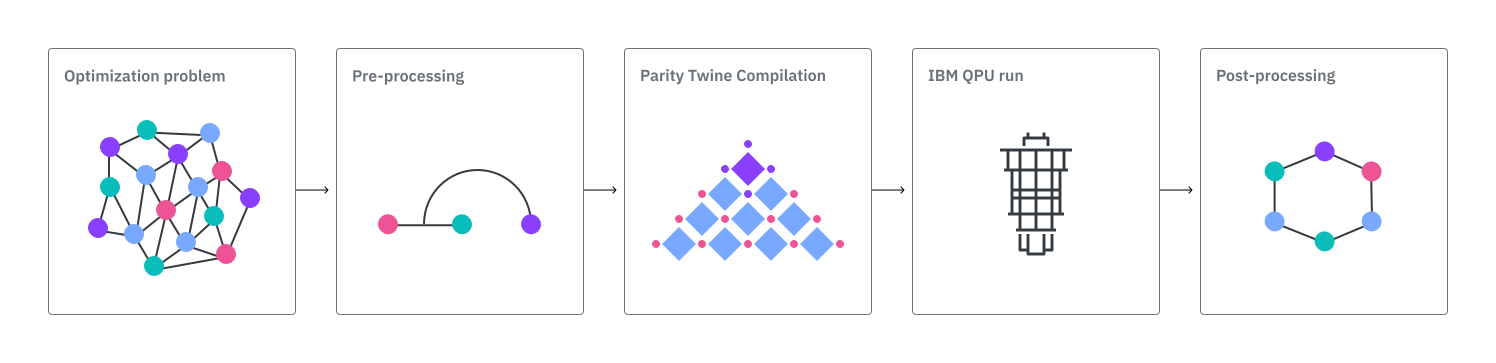
Wejściowy problem optymalizacyjny jest wstępnie przetwarzany do postaci (znormalizowanego) hamiltonianu. Kompilator ParityQC konstruuje następnie sparametryzowany obwód ansatz Parity Twine, który jest transpilowany do logicznego ansatzu dopasowanego do natywnego zestawu bramek wybranego sprzętu.
Parametry obwodu QAOA są optymalizowane klasycznie za pomocą podejścia "efficient depth one" i przypisywane do transpilowanego obwodu. Ponieważ używana jest jedna runda QAOA, optymalne parametry i są uzyskiwane za pomocą przeszukiwania siatki (grid search) na CPU, bez potrzeby kosztownej iteracyjnej optymalizacji przy wielu wywołaniach obwodu. To znacznie minimalizuje wymagany czas działania QPU optymalizatora. Czas wykonania pojedynczego obwodu zależy głównie od stałego narzutu związanego z uruchomieniem zadania na QPU. Gdy parametry obwodu są ustawione, zadanie jest przesyłane do wybranego QPU IBM®.
Surowe wyniki są następnie przetwarzane końcowo. Ten krok wykorzystuje lokalne przeszukiwanie zachłanne (greedy search), które losowo iteruje po ciągu rozwiązania i odwraca wartości bitów, jeśli zmniejsza to wartość funkcji kosztu.
Testy porównawcze
Wydajność może zależeć zarówno od instancji problemu, jak i kolejnych etapów przetwarzania. W niektórych przypadkach próbki klasyczne i próbki wygenerowane kwantowo mogą osiągnąć podobną ostateczną jakość rozwiązania po równoważnym przetwarzaniu końcowym. Dlatego ocena powinna uwzględniać cały przebieg procesu optymalizacji.
Model Sherringtona-Kirkpatricka
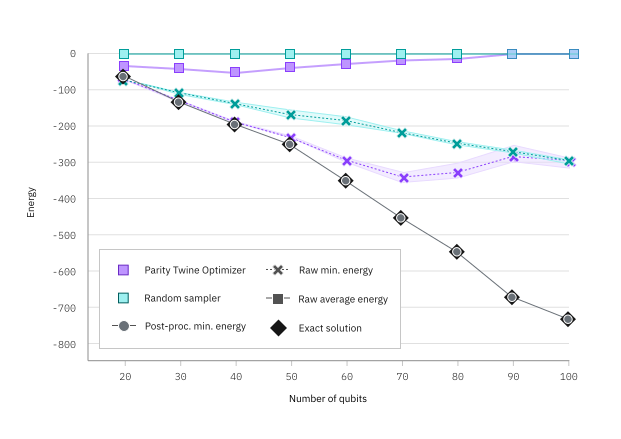
Rysunek 2 przedstawia skuteczność Parity Twine Optimizer. Porównuje on wyniki uzyskane za pomocą optymalizatora z losowym próbkowaniem dla modelu Sherringtona-Kirkpatricka przy rosnącej liczbie kubitów.
Przetwarzanie końcowe zarówno wyników losowych, jak i wyników optymalizatora prowadzi do dokładnych stanów podstawowych, ale surowy wynik minimalnej energii z Twine QAOA jest zawsze lepszy niż wartości losowe. Dla największych rozważanych liczb kubitów (90 i 100) szum sprzętowy pogarsza wynik optymalizatora, który wraca do surowych wartości zbliżonych do losowego próbkowania.
Zobacz ten samouczek, aby poznać wprowadzenie do modelu Sherringtona-Kirkpatricka oraz szczegóły dotyczące jego rozwiązywania za pomocą Parity Twine Optimizer.
Problem Market Split
Tabela 1 przedstawia konkretne metryki wydajności Parity Twine Optimizer zastosowanego do różnych instancji problemu Market Split (MS). Zostały one uzyskane z QOBLIB - Quantum Optimization Benchmarking Library i odpowiadają zgłoszeniom przesłanym do biblioteki za pomocą Parity Twine Optimizer.
Naruszenie MS (MS violation) to metryka dokładności mierząca, jak daleko rozwiązanie jest od spełnienia wszystkich ograniczeń, zdefiniowana jako . Niższe wartości tej metryki wskazują na dokładniejsze rozwiązania.
Tabela 1 przedstawia uśrednione wartości z pięciu uruchomień każdej instancji za pomocą Parity Twine Optimizer, wykorzystując urządzenie ibm_boston jako backend oraz 100 000 strzałów.
Raportowana jest minimalna wartość MS violation uzyskana z uruchomień każdej instancji.
| Instancja | Kubity | Bramki dwukubitowe | Głębokość dwukubitowa | Naruszenie MS | Czas mapowania (s) | Czas działania QPU (s) | Czas przetwarzania końcowego (s) |
|---|---|---|---|---|---|---|---|
| ms_03_050_002 | 20 | 399 | 76 | 0 | 45 | 29 | 71 |
| ms_03_100_022 | 20 | 399 | 76 | 0 | 30 | 29 | 77 |
| ms_03_200_177 | 20 | 399 | 76 | 0 | 33 | 29 | 63 |
| ms_04_050_001 | 30 | 899 | 116 | 1 | 68 | 29 | 216 |
| ms_04_100_003 | 30 | 899 | 116 | 2 | 89 | 29 | 187 |
| ms_04_200_030 | 30 | 899 | 116 | 3 | 89 | 29 | 219 |
| ms_05_100_003 | 40 | 1599 | 156 | 3 | 237 | 30 | 364 |
| ms_06_050_001 | 50 | 2499 | 196 | 4 | 499 | 30 | 464 |
| ms_07_050_001 | 60 | 3599 | 236 | 17 | 858 | 31 | 637 |
| ms_08_050_001 | 70 | 4899 | 276 | 36 | 1561 | 31 | 773 |
Tabela 1: Metryki wydajności dla różnych instancji problemu market split. Nazwy instancji odpowiadają przykładom w bibliotece problemów QOBLIB. Jak wspomniano wcześniej w sekcji opisu, czas QPU jest minimalny i niemal stały, ponieważ używana jest tylko jedna runda QAOA z optymalnymi parametrami obwodu uzyskanymi na CPU.
Zobacz ten samouczek, aby poznać wprowadzenie do problemu Market Split oraz szczegóły dotyczące jego rozwiązywania za pomocą Parity Twine Optimizer.
Problem Maximum Independent Set
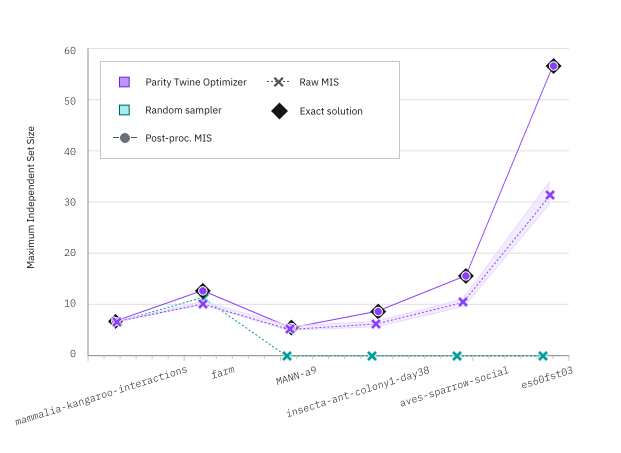
Rysunek 3 porównuje wyniki uzyskane za pomocą optymalizatora Parity Twine z losowym próbkowaniem dla problemu maximum independent set na wybranych instancjach uzyskanych z QOBLIB - Quantum Optimization Benchmarking Library. Zakres ten obejmuje od 18 (mammalia-kangaroo-interactions) do 114 (es60fst03) kubitów.
Dla małych instancji surowe wyniki rozmiaru Maximum Independent Set z optymalizatora i losowego próbkowania są podobne, ale dla większych instancji optymalizator daje znacznie lepsze wyniki. Przetwarzanie końcowe wyników zarówno z losowego próbkowania, jak i optymalizatora ponownie prowadzi do rozmiarów zbiorów zgodnych z dokładnymi wartościami.
Rozpoczęcie pracy
Uwierzytelnij się za pomocą swojego tokenu API IBM Quantum Platform i wybierz funkcję Qiskit w następujący sposób:
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

# Authenticate and load the Qiskit Function
catalog = QiskitFunctionsCatalog(
    channel="ibm_quantum_platform",
)
function = catalog.load("parityqc/parity-twine-optimizer")
Przykład
Parity Twine Optimizer można zastosować do prostego przykładu QUBO w następujący sposób. Problem jest najpierw definiowany za pomocą słownika:
problem = {"()": 3, "(0,)": 1, "(0, 1)": 2, "(1, 2)": -1}
Następnie typ zmiennej musi zostać zdefiniowany jako binary lub spin:
variable_type = "spin"
To definiuje funkcję celu , gdzie .
Wybierz backend. Na przykład:
backend_name = "ibm_phoenix"
Użyj catalog.backends(), aby zobaczyć listę dostępnych backendów z konta/instancji użytkownika.
Jeśli backend nie zostanie określony, automatycznie wybierany jest najmniej obciążony backend (ten z najmniejszą liczbą oczekujących zadań).
Gdy optymalizator zostanie wczytany (patrz wcześniej), możesz uruchomić go na problemie, używając domyślnych opcji:
function_job = function.run(
    problem=problem, variable_type=variable_type, backend_name=backend_name
)
print(f"Job ID: {function_job.job_id}")
Sprawdź status zadania w następujący sposób:
# Monitor the job status
function_job.status()
Pobierz wyniki w następujący sposób:
# Retrieve the job result if the status is DONE
result = function_job.result()

result
Wypisanie wyników daje następujący rezultat:
{
    'solution': {'0': -1, '1': 1, '2': 1},
    'objective_value': -1.0,
    'solution_bitstring': '100',
    'metadata': {
        'circuit_metrics': {
            'depth': 20,
            'gate_count': 198,
            'two_qubit_gate_depth': 4,
            'two_qubit_gate_count': 4,
            'num_qubits': 3,
            'operations': {'delay': 158, 'rz': 17, 'sx': 14, 'cz': 4, 'measure': 3, 'x': 2}
        },
        'solver_info': {
            'variable_mapping': {'0': 0, '1': 1, '2': 2},
            'bitstring_distributions': {
                'before_postprocessing': {'100': 71760, ... },
                'after_postprocessing': {'100': 88440, '011': 11560}
            },
            'best_parameters': {
                'beta': [-0.46259546391008877],
                'gamma': [0.6181957189727373]
            }
        },
        'resource_usage': {
            'RUNNING: MAPPING': {'CPU_TIME': 42.878},
            'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 0.094},
            'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 790.623},
            'RUNNING: EXECUTING_QPU': {'QPU_TIME': 28.0},
            'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.828}
        }
    }
}
Słownik solution odpowiada kubitom zdefiniowanym w problemie ( i ) i podaje ich zoptymalizowane wartości spinu.
objective_value to koszt lub energia problemu optymalizacyjnego. Określa ona ilościowo jakość solution.
metadata dostarcza informacji o transpilacji (liczba/głębokość bramek dwukubitowych, użyte bramki, aktywne kubity) oraz różnych czasach wykonania zarówno dla obliczeń kwantowych, jak i klasycznych.
Dodatkowo metadata daje wgląd w wewnętrzne działanie algorytmu. Możesz zobaczyć zoptymalizowane parametry wariacyjne (beta i gamma) oraz sprawdzić, jak poprawił się rozkład zmierzonych ciągów bitowych po zastosowaniu klasycznego przetwarzania końcowego do surowych wyników kwantowych.
Wszystkie ciągi bitowe w wyniku wyjściowym można zmapować na zmienne problemu za pomocą variable_mapping.
Na przykład możesz zmapować 'solution_bitstring': '100' z 'variable_mapping': {'0': 0, '1': 1, '2': 2} na rozwiązanie binarne: {'0': 1, '1': 0, '2': 0}.
Ponieważ rozwiązujesz problem w kategoriach zmiennych spinowych, musisz zastosować transformację z postaci binarnej do spinowej (0 -> 1, 1 -> -1 ).
Otrzymujesz wtedy ostateczne rozwiązanie 'solution': {'0': -1, '1': 1, '2': 1}.
Zapoznaj się z dokumentacją API, aby uzyskać pełne szczegóły dotyczące danych wejściowych i wyjściowych funkcji Parity Twine Optimizer.
Dziennik zmian
[1.0.2] - 2026-09-15
Notes
To wydanie stanowi pierwszą stabilną wersję produkcyjną funkcji Qiskit Parity Twine Optimizer. Przyszłe wydania mają wprowadzić:
- kompilację problemów wyższego rzędu,
- dodatkowe algorytmy optymalizacyjne oraz
- ulepszenia w przetwarzaniu wstępnym i końcowym.
Funkcje
- Rozwiązuj rzadkie i gęste problemy QUBO za pomocą wydajnego kompilatora Parity Twine Compiler.
Dokumentacja
- Przewodnik dla początkujących.
- Samouczki z przykładami dla problemów Market Split i Sherringtona-Kirkpatricka.
- Dokumentacja API.
Uzyskaj pomoc
Skontaktuj się z ParityQC w przypadku pytań lub problemów.
Kolejne kroki
- Poproś o dostęp do funkcji, wypełniając ten formularz.
- Odwiedź dokumentację API dla tej funkcji Qiskit.
- Wypróbuj samouczek dotyczący zastosowania Parity Twine Optimizer do problemu Market Split.
- Wypróbuj samouczek dotyczący zastosowania Parity Twine Optimizer do modelu Sherringtona-Kirkpatricka.
- Zapoznaj się z preprintem ArXiv Connectivity-aware Synthesis of Quantum Algorithms, Drier et al. (2025).