Optimization Solver: Funkcja Qiskit od Q-CTRL Fire Opal
Zobacz dokumentację API
Funkcje Qiskit to funkcja eksperymentalna dostępna wyłącznie dla użytkowników planów IBM Quantum® Premium Plan, Flex Plan oraz On-Prem (przez IBM Quantum Platform API). Są one w stanie podglądu (preview) i mogą ulec zmianie.
Wersje pakietów
Kod na tej stronie został opracowany przy użyciu następujących wymagań. Zalecamy używanie tych lub nowszych wersji.
qiskit-ibm-runtime~=0.47.0
sympy~=1.14.0
Przegląd
Dzięki Fire Opal Optimization Solver możesz rozwiązywać problemy optymalizacyjne w skali użytkowej na sprzęcie kwantowym bez konieczności posiadania wiedzy z zakresu informatyki kwantowej. Po prostu podaj definicję problemu na wysokim poziomie, a Solver zajmie się resztą. Cały przepływ pracy jest świadomy szumów i pod spodem korzysta z Fire Opal Performance Management. Solver konsekwentnie dostarcza dokładnych rozwiązań klasycznie trudnych problemów, nawet w pełnej skali urządzenia na największych QPU IBM®.
Solver jest elastyczny i można go używać do rozwiązywania kombinatorycznych problemów optymalizacyjnych zdefiniowanych jako funkcje celu lub dowolne grafy. Problemy nie muszą być mapowane na topologię urządzenia. Można rozwiązywać zarówno problemy nieograniczone, jak i ograniczone, z wymuszanymi ograniczeniami jako sztywne ograniczenia Hamminga wagi 1, a nie jako człony kary. Przykłady zawarte w tym przewodniku pokazują, jak rozwiązać nieograniczony i ograniczony problem optymalizacyjny w skali użytkowej przy użyciu różnych typów danych wejściowych Solvera. Pierwszy przykład dotyczy problemu Max-Cut zdefiniowanego na grafie 3-regularnym o 156 węzłach, podczas gdy drugi przykład dotyczy problemu partycjonowania grafu (50 węzłów) zdefiniowanego przez funkcję kosztu.
Aby uzyskać dostęp do Optimization Solver, skontaktuj się z Q-CTRL.
Opis funkcji
Solver w pełni optymalizuje i automatyzuje cały algorytm – od tłumienia błędów na poziomie sprzętu po wydajne mapowanie problemu i zamkniętą pętlę optymalizacji klasycznej. Za kulisami potok Solvera redukuje błędy na każdym etapie, umożliwiając zwiększoną wydajność niezbędną do sensownego skalowania. Bazowy przepływ pracy jest inspirowany Quantum Approximate Optimization Algorithm (QAOA), który jest hybrydowym algorytmem kwantowo-klasycznym. Szczegółowe podsumowanie pełnego przepływu pracy Optimization Solver znajdziesz w opublikowanym artykule.

Aby rozwiązać ogólny problem za pomocą Optimization Solver:
- Zdefiniuj swój problem jako funkcję celu, graf lub łańcuch spinowy
SparsePauliOp. - Połącz się z funkcją przez katalog Qiskit Functions Catalog.
- Uruchom problem za pomocą Solvera i pobierz wyniki.
Akceptowane formaty problemu
-
Reprezentacja wyrażenia wielomianowego funkcji celu. Najlepiej tworzona w Pythonie za pomocą istniejącego obiektu SymPy Poly i formatowana do postaci ciągu znaków przy użyciu sympy.srepr.
-
Reprezentacja grafowa określonego typu problemu. Graf powinien być tworzony przy użyciu biblioteki networkx w Pythonie, a następnie konwertowany do ciągu znaków za pomocą funkcji networkx
nx.readwrite.json_graph.adjacency_data. -
Reprezentacja łańcucha spinowego określonego problemu. Łańcuch spinowy powinien być reprezentowany jako obiekt
SparsePauliOp; więcej szczegółów znajdziesz w dokumentacji.
Jeśli chcesz użyć Backend-u, który nie jest obecnie obsługiwany przez tę funkcję, skontaktuj się z Q-CTRL, aby dodać obsługę.
Benchmarki
Wydajność może zależeć zarówno od instancji problemu, jak i od kolejnych etapów przetwarzania. W niektórych przypadkach próbki klasyczne i próbki wygenerowane kwantowo mogą osiągnąć podobną ostateczną jakość rozwiązania po równoważnym przetwarzaniu końcowym. Ocena powinna więc uwzględniać cały przepływ pracy optymalizacji.
Opublikowane wyniki testów porównawczych pokazują, że Solver skutecznie rozwiązuje problemy z ponad 120 Qubitami, a nawet przewyższa wcześniej opublikowane wyniki na urządzeniach do wyżarzania kwantowego i pułapkowania jonów. Poniższe metryki benchmarkowe dają przybliżone wskazanie dokładności i skalowalności typów problemów na podstawie kilku przykładów. Rzeczywiste metryki mogą się różnić w zależności od różnych cech problemu, takich jak liczba składników w funkcji celu (gęstość) i ich lokalność, liczba zmiennych oraz rząd wielomianu.
„Liczba Qubitów" podana w tabeli nie jest twardym ograniczeniem, lecz przybliżonym progiem, powyżej którego możesz oczekiwać bardzo spójnej dokładności rozwiązania. Większe rozmiary problemów zostały z powodzeniem rozwiązane i zachęcamy do testowania powyżej tych limitów.
Dowolna łączność Qubitów jest obsługiwana dla wszystkich typów problemów.
| Typ problemu | Liczba Qubitów | Przykład | Dokładność | Całkowity czas (s) | Użycie środowiska uruchomieniowego (s) | Liczba iteracji |
|---|---|---|---|---|---|---|
| Rzadko połączone problemy kwadratowe | 156 | max-cut 3-regularny | 100% | 1764 | 293 | 16 |
| Optymalizacja binarna wyższego rzędu | 156 | Model szkła spinowego Isinga | 100% | 1461 | 272 | 16 |
| Gęsto połączone problemy kwadratowe | 50 | max-cut w pełni połączony | 100% | 1758 | 268 | 12 |
| Problem ograniczony z ograniczeniami twardymi | 50 | Ważone partycjonowanie grafu z gęstością krawędzi 8% | 100% | 1074 | 215 | 10 |
Pierwsze kroki
Najpierw uwierzytelnij się przy użyciu swojego klucza API IBM Quantum. Następnie wybierz Funkcję Qiskit w sposób podany poniżej. (Ten fragment zakłada, że masz już zapisane konto w lokalnym środowisku.)
# Added by doQumentation — required packages for this notebook
!pip install -q networkx numpy qiskit-ibm-catalog qiskit-ibm-runtime sympy
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access Function
solver = catalog.load("q-ctrl/optimization-solver")
Przykład: Optymalizacja nieograniczona
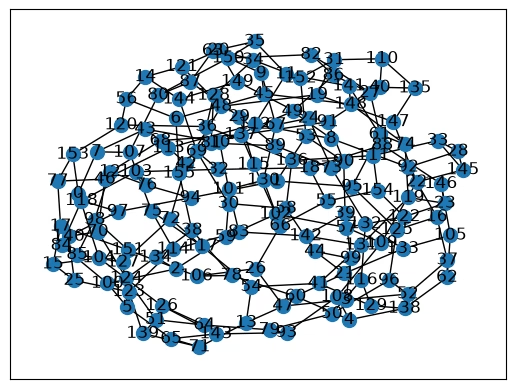
Uruchom problem maksymalnego cięcia (max-cut). Poniższy przykład demonstruje możliwości Solvera na problemie max-cut na nieważonym grafie 3-regularnym o 156 węzłach, ale możesz też rozwiązywać problemy na grafach ważonych.
Oprócz qiskit-ibm-catalog będziesz również używać następujących pakietów do uruchomienia tego przykładu: networkx i numpy. Możesz zainstalować te pakiety, odkomentowując poniższą komórkę, jeśli uruchamiasz ten przykład w notatniku z jądrem IPython.
# %pip install networkx numpy
1. Zdefiniuj problem
Możesz uruchomić problem Max-Cut, definiując problem grafowy i określając problem_type='maxcut'.
import networkx as nx
import numpy as np

# Generate a random graph with 156 nodes
maxcut_graph = nx.random_regular_graph(d=3, n=156, seed=8)
# Optionally, visualize the graph
nx.draw_networkx(
    maxcut_graph, nx.kamada_kawai_layout(maxcut_graph), node_size=100
)
Solver przyjmuje ciąg znaków jako dane wejściowe definicji problemu.
# Convert graph to string
problem_as_str = nx.readwrite.json_graph.adjacency_data(maxcut_graph)
2. Uruchom problem
Gdy używasz metody wejściowej opartej na grafie, określ typ problemu.
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy(n_qubits=156).name
# Solve the problem
maxcut_job = solver.run(
    problem=problem_as_str,
    problem_type="maxcut",
    backend_name=backend_name,  # E.g. "ibm_fez"
)
Sprawdź status obciążenia swojej Funkcji Qiskit lub pobierz wyniki w następujący sposób:
# Print the ID so you can use it later, if necessary
print(maxcut_job.job_id)

# Get job status
print(maxcut_job.status())
34b53970-d95a-4e24-8763-fc6f3d112843
QUEUED
3. Pobierz wynik
Pobierz optymalną wartość cięcia ze słownika wyników.
Mapowanie zmiennych do bitstring-u mogło ulec zmianie. Słownik wyjściowy zawiera pod-słownik variables_to_bitstring_index_map, który pomaga zweryfikować kolejność.
# Poll for results
maxcut_result = maxcut_job.result()

# Take the absolute value of the solution since the cost function is minimized
qctrl_maxcut = abs(maxcut_result["solution_bitstring_cost"])

# Print the optimal cut value found by the Optimization Solver
print(f"Optimal cut value: {qctrl_maxcut}")
Optimal cut value: 210.0
Możesz zweryfikować dokładność wyniku, rozwiązując problem klasycznie za pomocą solverów open-source, takich jak PuLP, jeśli graf nie jest gęsto połączony. W przypadku problemów o dużej gęstości do walidacji rozwiązania mogą być wymagane zaawansowane solwery klasyczne.
Przykład: Optymalizacja ograniczona
Poprzedni przykład max-cut to powszechny problem kwadratowej bezwarunkowej optymalizacji binarnej. Optimization Solver firmy Q-CTRL może również rozwiązywać ograniczone problemy optymalizacyjne, przekazując twarde ograniczenia bezpośrednio do Solvera za pomocą wejścia constraint, zamiast kodować je jako składniki kary w funkcji celu. Solver obecnie obsługuje ograniczenia typu Hamming-weight-1: każde ograniczenie określa grupę zmiennych, w której dokładnie jedna zmienna musi być równa 1, a pozostałe muszą być równe 0.
Poniższy przykład pokazuje, jak skonstruować funkcję kosztu oraz zestaw twardych ograniczeń dla ograniczonego problemu optymalizacyjnego, podziału grafu, przypisując każdy węzeł w grafie do dokładnie jednej z kilku grup, minimalizując przy tym łączną wagę krawędzi, których końce znajdują się w tej samej grupie.
Oprócz pakietów qiskit-ibm-catalog i qiskit będziesz również używać następujących pakietów do uruchomienia tego przykładu: numpy, networkx i sympy. Możesz zainstalować te pakiety, odkomentowując poniższą komórkę, jeśli uruchamiasz ten przykład w notatniku z jądrem IPython.
# %pip install numpy networkx sympy
1. Zdefiniuj problem
Zdefiniuj losowy problem podziału grafu, generując graf z losowo ważonymi węzłami.
import networkx as nx
from sympy import Symbol, Poly, srepr

# To change the weights, change the seed to any integer.
rng_seed = 18
_rng = np.random.default_rng(rng_seed)
node_count = 50
edge_probability = 0.08
graph = nx.erdos_renyi_graph(
    node_count, edge_probability, seed=rng_seed, directed=False
)

# add node weights
min_weight = -1.0
max_weight = 1.0
for i in graph.nodes:
    weight = (max_weight - min_weight) * _rng.random() + min_weight
    graph.add_node(i, weight=weight)

# Optionally, visualize the graph
nx.draw_networkx(graph, nx.kamada_kawai_layout(graph), node_size=200)
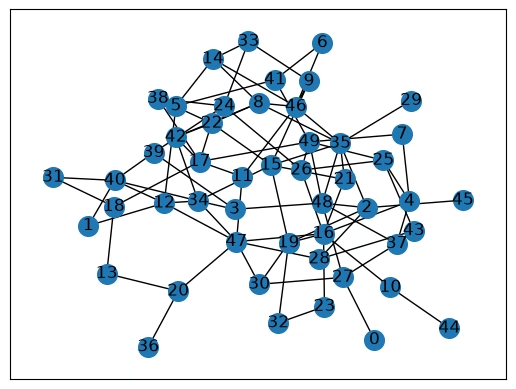
Standardowy model optymalizacyjny dla ważonego podziału grafu można sformułować następująco. Podziel węzły grafu na trzy grupy i niech , jeśli węzeł jest przypisany do grupy , a w przeciwnym razie. Celem jest zminimalizowanie łącznej wagi krawędzi, których końce są przypisane do tej samej grupy, gdzie waga krawędzi to łączna waga jej dwóch końców, :
# Construct the cost function.
group_count = 3
variables = [
    Symbol(f"n[{i},{g}]")
    for i in range(node_count)
    for g in range(group_count)
]
node_group_var = {
    (i, g): variables[i * group_count + g]
    for i in range(node_count)
    for g in range(group_count)
}
cost_function = Poly(0, *variables)

for i, j in graph.edges():
    edge_weight = graph.nodes[i]["weight"] + graph.nodes[j]["weight"]
    for g in range(group_count):
        cost_function += (
            edge_weight * node_group_var[(i, g)] * node_group_var[(j, g)]
        )
Każdy węzeł musi być przypisany do dokładnie jednej z trzech grup. Jest to ograniczenie typu Hamming-weight-1: dla każdego węzła dokładnie jedna z wartości musi być równa 1, a pozostałe muszą być równe 0:
Zamiast kodować ten wymóg jako składnik kary w funkcji kosztu, przekaż go bezpośrednio do Solvera jako twarde ograniczenie za pomocą wejścia constraint.
# Build the hard constraint: exactly one group per node.
constraint_dict = {
    str(tuple(f"n[{i},{g}]" for g in range(group_count))): 1
    for i in range(node_count)
}
print(f"Problem constraints: {constraint_dict}")
Problem constraints: {"('n[0,0]', 'n[0,1]', 'n[0,2]')": 1, "('n[1,0]', 'n[1,1]', 'n[1,2]')": 1, "('n[2,0]', 'n[2,1]', 'n[2,2]')": 1, "('n[3,0]', 'n[3,1]', 'n[3,2]')": 1, "('n[4,0]', 'n[4,1]', 'n[4,2]')": 1, "('n[5,0]', 'n[5,1]', 'n[5,2]')": 1, "('n[6,0]', 'n[6,1]', 'n[6,2]')": 1, "('n[7,0]', 'n[7,1]', 'n[7,2]')": 1, "('n[8,0]', 'n[8,1]', 'n[8,2]')": 1, "('n[9,0]', 'n[9,1]', 'n[9,2]')": 1, "('n[10,0]', 'n[10,1]', 'n[10,2]')": 1, "('n[11,0]', 'n[11,1]', 'n[11,2]')": 1, "('n[12,0]', 'n[12,1]', 'n[12,2]')": 1, "('n[13,0]', 'n[13,1]', 'n[13,2]')": 1, "('n[14,0]', 'n[14,1]', 'n[14,2]')": 1, "('n[15,0]', 'n[15,1]', 'n[15,2]')": 1, "('n[16,0]', 'n[16,1]', 'n[16,2]')": 1, "('n[17,0]', 'n[17,1]', 'n[17,2]')": 1, "('n[18,0]', 'n[18,1]', 'n[18,2]')": 1, "('n[19,0]', 'n[19,1]', 'n[19,2]')": 1, "('n[20,0]', 'n[20,1]', 'n[20,2]')": 1, "('n[21,0]', 'n[21,1]', 'n[21,2]')": 1, "('n[22,0]', 'n[22,1]', 'n[22,2]')": 1, "('n[23,0]', 'n[23,1]', 'n[23,2]')": 1, "('n[24,0]', 'n[24,1]', 'n[24,2]')": 1, "('n[25,0]', 'n[25,1]', 'n[25,2]')": 1, "('n[26,0]', 'n[26,1]', 'n[26,2]')": 1, "('n[27,0]', 'n[27,1]', 'n[27,2]')": 1, "('n[28,0]', 'n[28,1]', 'n[28,2]')": 1, "('n[29,0]', 'n[29,1]', 'n[29,2]')": 1, "('n[30,0]', 'n[30,1]', 'n[30,2]')": 1, "('n[31,0]', 'n[31,1]', 'n[31,2]')": 1, "('n[32,0]', 'n[32,1]', 'n[32,2]')": 1, "('n[33,0]', 'n[33,1]', 'n[33,2]')": 1, "('n[34,0]', 'n[34,1]', 'n[34,2]')": 1, "('n[35,0]', 'n[35,1]', 'n[35,2]')": 1, "('n[36,0]', 'n[36,1]', 'n[36,2]')": 1, "('n[37,0]', 'n[37,1]', 'n[37,2]')": 1, "('n[38,0]', 'n[38,1]', 'n[38,2]')": 1, "('n[39,0]', 'n[39,1]', 'n[39,2]')": 1, "('n[40,0]', 'n[40,1]', 'n[40,2]')": 1, "('n[41,0]', 'n[41,1]', 'n[41,2]')": 1, "('n[42,0]', 'n[42,1]', 'n[42,2]')": 1, "('n[43,0]', 'n[43,1]', 'n[43,2]')": 1, "('n[44,0]', 'n[44,1]', 'n[44,2]')": 1, "('n[45,0]', 'n[45,1]', 'n[45,2]')": 1, "('n[46,0]', 'n[46,1]', 'n[46,2]')": 1, "('n[47,0]', 'n[47,1]', 'n[47,2]')": 1, "('n[48,0]', 'n[48,1]', 'n[48,2]')": 1, "('n[49,0]', 'n[49,1]', 'n[49,2]')": 1}
Nie musisz dodawać każdej zmiennej do constraint. Każda zmienna pominięta w słowniku pozostaje nieograniczona, więc możesz łączyć twardo ograniczone grupy zmiennych ze zmiennymi swobodnymi w tym samym problemie.
2. Uruchom problem
# Solve the problem
partition_job = solver.run(
    problem=srepr(cost_function),
    constraint=constraint_dict,
    backend_name="ibm_marrakesh",  # E.g. "ibm_marrakesh"
)
Sprawdź status obciążenia swojej Funkcji Qiskit lub pobierz wyniki w następujący sposób:
# Print the ID so you can use it later, if necessary
print(partition_job.job_id)

# Get job status
print(partition_job.status())
b8085944-f313-444e-be39-ea61b1b47ebd
QUEUED
3. Pobierz wynik
Pobierz rozwiązanie i przeanalizuj wyniki. Koszt rozwiązania reprezentuje łączną wagę krawędzi, których końce znalazły się w tej samej grupie, więc niższy koszt oznacza lepszy podział grafu.
partition_result = partition_job.result()
qctrl_cost = partition_result["solution_bitstring_cost"]
solution_bitstring = partition_result["solution_bitstring"]

# Print results
print(f"Total weight of same-group edges: {qctrl_cost}")
print(f"Solution bitstring: {solution_bitstring}")
Total weight of same-group edges: -36.5539
Solution bitstring: 100100100100100001100100100100100100100100100100100001010100010100100100100010001001100100100001100001100001010001001010100100100100100010100100100100
Uzyskaj wsparcie
W razie pytań lub problemów skontaktuj się z Q-CTRL.
Dziennik zmian
-
2026-08-10: Dodano obsługę twardych ograniczeń (Hamming weight 1) za pomocą wejścia
constraintoraz zaktualizowano przykład ograniczonej optymalizacji, aby z nich korzystał. -
2026-02-11: Dodano obsługę
ibm_miami
Następne kroki
-
Poproś o dostęp do Q-CTRL Optimization Solver.
-
Odwiedź dokumentację API dla tej Funkcji Qiskit.
-
Wypróbuj samouczek Rozwiązywanie problemów binarnej optymalizacji wyższego rzędu z Optimization Solver Q-CTRL.
-
Zapoznaj się ze studium przypadku Mazda.
-
Zapoznaj się ze studium przypadku Network Rail.
-
Zapoznaj się ze studium przypadku Australian Army.
-
Zapoznaj się ze studium przypadku Transport for New South Wales.