Odświeżanie właściwości backendu za pomocą benchmarkingu w czasie rzeczywistym
Szacowany czas: 3 minuty na ibm_kingston (UWAGA: To tylko szacunek. Rzeczywisty czas wykonania może się różnić.)
Czego się nauczysz
-
Dlaczego właściwości zgłaszane przez QPU mogą być opóźnione w stosunku do bieżącego zachowania urządzenia i kiedy warto zmierzyć je samodzielnie ponownie
-
Co mierzy każdy z pięciu standardowych eksperymentów charakteryzacyjnych (odczyt, randomizowany benchmarking pojedynczego kubitu, warstwowy randomizowany benchmarking dwóch kubitów, i )
-
Jak uruchomić pełny pakiet charakteryzacji w jednym wywołaniu lub krok po kroku i uzyskać obiekt backendu z odświeżonymi właściwościami
-
Jak porównać zmierzone właściwości ze zgłoszonymi i dlaczego niektóre różnice odzwierciedlają metodologię pomiaru, a nie dryf urządzenia
Wymagania wstępne
-
Przepływ pracy wzorców Qiskit
-
Tryby wykonania Qiskit Runtime, w szczególności batch mode
-
Jak przeglądać informacje o QPU, takie jak właściwości backendu i dane kalibracyjne
Kontekst
Każdy procesor IBM Quantum® zgłasza zestaw właściwości opisujących, jak dobrze aktualnie działa każdy z jego kubitów: czasy relaksacji (), czasy koherencji (), błędy odczytu oraz błędy bramek jedno- i dwukubitowych. Te liczby mają znaczenie w praktyce. Transpiler wykorzystuje je do decydowania, na których kubitach fizycznych powinien działać twój obwód, techniki mitygacji błędów na nich polegają, a ty możesz ich użyć, aby ocenić, czy urządzenie działa wystarczająco dobrze dla danego eksperymentu.
Zgłaszane właściwości pochodzą z procedur kalibracyjnych, które zwykle uruchamiane są mniej więcej raz dziennie. Kubity nadprzewodzące mogą jednak dryfować w krótszych skalach czasowych, a przejściowe defekty (tzw. systemy dwupoziomowe) mogą tymczasowo pogorszyć jakość kubitu, który w czasie kalibracji wyglądał doskonale. Ponadto zadanie jest często transpilowane na długo przed faktycznym wykonaniem, więc decyzje oparte na zgłaszanych właściwościach mogą opierać się na nieaktualnych informacjach. Samouczek Benchmarking w czasie rzeczywistym do wyboru kubitów pokazuje, jak bardzo te właściwości mogą się wahać z dnia na dzień, i buduje pełny przepływ pracy charakteryzacyjnej ręcznie z poszczególnych Qiskit Experiments.
Ten samouczek pokazuje uproszczoną wersję tego przepływu pracy, wykorzystując narzędzie BackendCharacterization z Qiskit Device Benchmarking, które łączy budowę eksperymentów, przesyłanie zadań i dopasowywanie krzywych w kilka wywołań. Zużywasz około 70 sekund czasu QPU i otrzymujesz obiekt backendu, którego właściwości odzwierciedlają urządzenie teraz, gotowy do porównania ze zgłoszonymi wartościami lub przekazania do dalszych narzędzi.
Eksperymenty charakteryzacyjne
Pakiet mierzy pięć właściwości, każdą za pomocą standardowego eksperymentu:
-
Błąd odczytu (
readout): Każdy kubit jest przygotowywany w stanie lub i natychmiast mierzony. Prawdopodobieństwo odczytania błędnego stanu daje błąd przygotowania i pomiaru stanu (SPAM). -
Błąd bramki jednokubitowej (
rb_1q): Randomizowany benchmarking (RB) uruchamia sekwencje losowych jednokubitowych bramek Clifforda, które w idealnym przypadku składają się do identyczności. Sposób, w jaki prawdopodobieństwo przetrwania maleje wraz z długością sekwencji, daje średni błąd na bramkę, niezależnie od błędów SPAM. -
Błąd bramki dwukubitowej (
rb_2q): Ta sama idea RB zastosowana do pełnych warstw nienachodzących na siebie bramek dwukubitowych wykonywanych jednocześnie, jak w eksperymencie wierności warstwy. Ponieważ wiele bramek działa jednocześnie, wynikowe wskaźniki błędów obejmują efekty przesłuchów i są bliższe temu, czego faktycznie doświadcza głęboki obwód. -
(
t1): Każdy kubit jest wzbudzany i mierzony po coraz dłuższych opóźnieniach. Zanik populacji stanu wzbudzonego daje czas relaksacji. -
(
t2): Eksperyment echa Hahna umieszcza każdy kubit w superpozycji, stosuje impuls echa w połowie opóźnienia i mierzy, jak szybko traci się koherencję fazową. Domyślnie stosowane jest pojedyncze echo; wariant wieloechowy (w stylu CPMG) jest zademonstrowany na końcu tego samouczka.
Co robi, a czego nie robi odświeżanie
Pamiętaj o trzech kwestiach podczas korzystania z tego przepływu pracy:
-
Odświeżone właściwości istnieją tylko w obiekcie backendu zwróconym tobie. Nic nie zmienia się na samym urządzeniu ani w danych kalibracyjnych zgłaszanych przez IBM Quantum innym użytkownikom.
-
Zmierzone wartości to migawka wykonana z użyciem konkretnej metodologii. Niektóre z nich, zwłaszcza warstwowe błędy dwukubitowe i równoległe wartości z pojedynczym echem, są mierzone inaczej niż zgłaszane dane kalibracyjne, więc część zaobserwowanej różnicy wynika z metodologii, a nie z dryfu. Ten samouczek wskazuje, kiedy tak się dzieje.
-
Sama charakteryzacja kosztuje czas QPU (około 70 sekund dla pełnego pakietu na procesorze Heron r2), co jest ceną za aktualne informacje.
Przepływ pracy postępuje zgodnie z czterema krokami wzorca Qiskit:
-
Krok 1: Odwzorowanie danych klasycznych na problem kwantowy. Wybierz urządzenie i zestaw właściwości do zmierzenia.
-
Krok 2: Optymalizacja problemu pod kątem wykonania na sprzęcie kwantowym. Narzędzie buduje obwody eksperymentalne bezpośrednio w bramkach natywnych urządzenia i zrównolegla je na całym chipie.
-
Krok 3: Wykonanie z użyciem prymitywów Qiskit. Eksperymenty są uruchamiane jako zadania Sampler wewnątrz batcha.
-
Krok 4: Przetworzenie końcowe i zwrot wyniku w żądanym formacie klasycznym. Dopasuj dane pomiarowe do map błędów na kubit, odśwież backend i porównaj zmierzone właściwości ze zgłoszonymi.
Wymagania
Przed rozpoczęciem tego samouczka upewnij się, że masz zainstalowane:
-
Qiskit SDK w wersji 2.0 lub nowszej, z obsługą wizualizacji
-
Qiskit Runtime w wersji 0.40 lub nowszej (
pip install qiskit-ibm-runtime) -
Qiskit Device Benchmarking, który instaluje również Qiskit Experiments (
pip install git+https://github.com/qiskit-community/qiskit-device-benchmarking.git)
Konfiguracja
Zaimportuj wymagane biblioteki.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit_device_benchmarking": "git+https://github.com/qiskit-community/qiskit-device-benchmarking.git", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import logging
import sys

import numpy as np
from qiskit_ibm_runtime import Batch, QiskitRuntimeService

from qiskit_device_benchmarking.utilities.characterization_utils import (
    BackendCharacterization,
    plot_characterization_comparison,
)
Pakiet charakteryzacyjny buduje kilka eksperymentów, przesyła wiele zadań i dopasowuje wyniki, co może zająć w sumie kilka minut. Włącz logowanie na poziomie INFO, aby każdy etap wyświetlał swój postęp w miarę jego wykonywania.
logger = logging.getLogger("qiskit_device_benchmarking")
logger.setLevel(logging.INFO)
logger.addHandler(logging.StreamHandler(stream=sys.stdout))
Przykład symulatora na małą skalę
Ten samouczek nie zawiera przykładu symulatora. Przepływ pracy mierzy fizyczne niedoskonałości konkretnego urządzenia: jak szybko jego kubity ulegają relaksacji i utracie fazy oraz jak często zawodzą jego bramki i odczyt. Idealny symulator nie ma żadnej z tych niedoskonałości, więc nie ma nic do scharakteryzowania. Można by dołączyć syntetyczny model szumu do fałszywego backendu, ale eksperymenty odzyskałyby wtedy tylko wartości, które sam wprowadziłeś. Z tego powodu przechodzimy bezpośrednio do sprzętu, podzielonego na cztery kroki wzorca Qiskit.
Przykład sprzętu na dużą skalę
Krok 1: Odwzorowanie danych klasycznych na problem kwantowy
W tym przepływie pracy „problemem” jest samo urządzenie: danymi klasycznymi są QPU, który chcesz scharakteryzować, oraz lista właściwości do zmierzenia, a eksperymentami kwantowymi są wygenerowane z nich obwody charakteryzacyjne.
Najpierw wybierz backend. Ten samouczek używa ibm_kingston, 156-kubitowego procesora Heron r2; możesz podstawić dowolne urządzenie IBM Quantum, do którego masz dostęp (lub wybrać takie za pomocą service.least_busy()).
service = QiskitRuntimeService()
device = "ibm_kingston"
backend = service.backend(device)
Następnie wybierz, które właściwości zmierzyć. Możesz przekazać dowolny podzbiór następujących eksperymentów:
-
readout: eksperyment SPAM (przygotowania i pomiaru stanu) -
rb_1q: izolowany randomizowany benchmarking jednokubitowy -
rb_2q: równoczesny randomizowany benchmarking dwukubitowy z eksperymentu wierności warstwy -
t2: eksperyment echa Hahna (domyślnie pojedyncze echo) -
t1: eksperyment relaksacji
Uruchom pełny pakiet, aby uzyskać pełny obraz urządzenia; usuń pozycje z listy, jeśli zależy ci tylko na niektórych właściwościach i chcesz zaoszczędzić czas QPU.
experiments = ["readout", "rb_1q", "rb_2q", "t1", "t2"]
Krok 2: Optymalizacja problemu pod kątem wykonania na sprzęcie kwantowym
W większości samouczków w tym miejscu transpilowałbyś swoje obwody. Tutaj BackendCharacterization zajmuje się tym wewnętrznie. Buduje obwody eksperymentalne bezpośrednio w bramkach natywnych urządzenia, uruchamia eksperymenty jednokubitowe na wszystkich kubitach równolegle i planuje benchmarking dwukubitowy na rozłącznych warstwach mapy sprzężeń, tak aby całe urządzenie było pokryte za pomocą kilku zadań. Dzięki tej równoległości cały pakiet zużywa jedynie około 70 sekund czasu QPU.
Zainicjuj klasę zarządzającą przepływem pracy:
# Initialize the class used to run the experiments
characterizer = BackendCharacterization(backend)
Krok 3: Wykonanie z użyciem prymitywów Qiskit
Metoda run_experiments buduje obwody i przesyła je jako zadania Sampler. Uruchom ją w kontekście Batch, aby zadania zostały zaplanowane razem na QPU, a metoda zwraca wynik po przesłaniu wszystkich zadań. (Można ją też uruchomić poza trybem wsadowym lub wewnątrz Session.)
Możesz zobaczyć ostrzeżenie dotyczące przekazania backendu, gdy otwarty jest menedżer kontekstu sesji. Jest to oczekiwane i można je bezpiecznie zignorować.
# Run the characterization experiments inside a Batch
with Batch(backend=backend):
    jobs = characterizer.run_experiments(experiments=experiments)
base_primitive.get_mode_service_backend:WARNING:2026-07-14 14:23:02,051: A backend was passed in as the mode but a session context manager is open so this job will run inside this session/batch instead of in job mode.
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7tfu6hjac73ffba2g', 'd9b7tjug26ic73dfju3g', 'd9b7u3u6hjac73ffban0', 'd9b7u7rv6alc73csmicg']
Readout job submitted: d9b7u8bv6alc73csmidg
T1 experiment submitted: ['d9b7u8ug26ic73dfjuqg']
T2 (Hahn) experiment submitted: ['d9b7u9fu62qs738othg0']
Single-qubit RB submitted: ['d9b7v8m6hjac73ffbc40', 'd9b7veeg26ic73dfk040']
Metoda zwraca przesłane zadania jako słownik indeksowany nazwą eksperymentu, co jest przydatne do śledzenia ich na pulpicie IBM Quantum Platform lub do debugowania.
# Print all the job IDs for debugging purposes
jobs
{'rb_2q': [<RuntimeJobV2('d9b7tfu6hjac73ffba2g', 'sampler')>,
  <RuntimeJobV2('d9b7tjug26ic73dfju3g', 'sampler')>,
  <RuntimeJobV2('d9b7u3u6hjac73ffban0', 'sampler')>,
  <RuntimeJobV2('d9b7u7rv6alc73csmicg', 'sampler')>],
 'readout': [<RuntimeJobV2('d9b7u8bv6alc73csmidg', 'sampler')>],
 't1': [<RuntimeJobV2('d9b7u8ug26ic73dfjuqg', 'sampler')>],
 't2': [<RuntimeJobV2('d9b7u9fu62qs738othg0', 'sampler')>],
 'rb_1q': [<RuntimeJobV2('d9b7v8m6hjac73ffbc40', 'sampler')>,
  <RuntimeJobV2('d9b7veeg26ic73dfk040', 'sampler')>]}
Krok 4: Przetworzenie końcowe i zwrot wyniku w żądanym formacie klasycznym
Analiza wyników
Metoda analyze_results czeka na zakończenie zadań i dopasowuje dane pomiarowe: wykładnicze zaniki dla i , zaniki prawdopodobieństwa przetrwania dla eksperymentów RB oraz macierze przypisania dla odczytu. Zwraca słownik map błędów, po jednej pozycji na zmierzoną właściwość, każda mapująca kubit (lub parę kubitów) na jego zmierzoną wartość.
error_maps = characterizer.analyze_results()
print(f"The following error maps are available: {list(error_maps.keys())}")
readout_q0 = error_maps["readout_error"][0]
print(f"For example, readout error for qubit 0 is {readout_q0}")
The following error maps are available: ['readout_error', 'oneq_error_x', 'oneq_error_sx', 'lf_error_map', 't1_map', 't2_map']
For example, readout error for qubit 0 is 0.007600000000000051
Mapy obejmują błąd odczytu, błędy bramek jednokubitowych x i sx, warstwowe błędy dwukubitowe (lf_error_map, z eksperymentu wierności warstwy) oraz czasy i w sekundach.
Aktualizacja właściwości backendu
Metoda update_backend zapisuje zmierzone wartości we właściwościach kopii backendu i ją zwraca. Oryginalny obiekt backend zachowuje zgłoszone dane kalibracyjne, dzięki czemu możemy porównać oba, jak pokazano poniżej. Pamiętaj, że ta aktualizacja jest wyłącznie lokalna dla twojej sesji Pythona; nie zmienia niczego na urządzeniu ani dla innych użytkowników.
backend_updated = characterizer.update_backend()
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
Porównanie zmierzonych właściwości ze zgłoszonymi
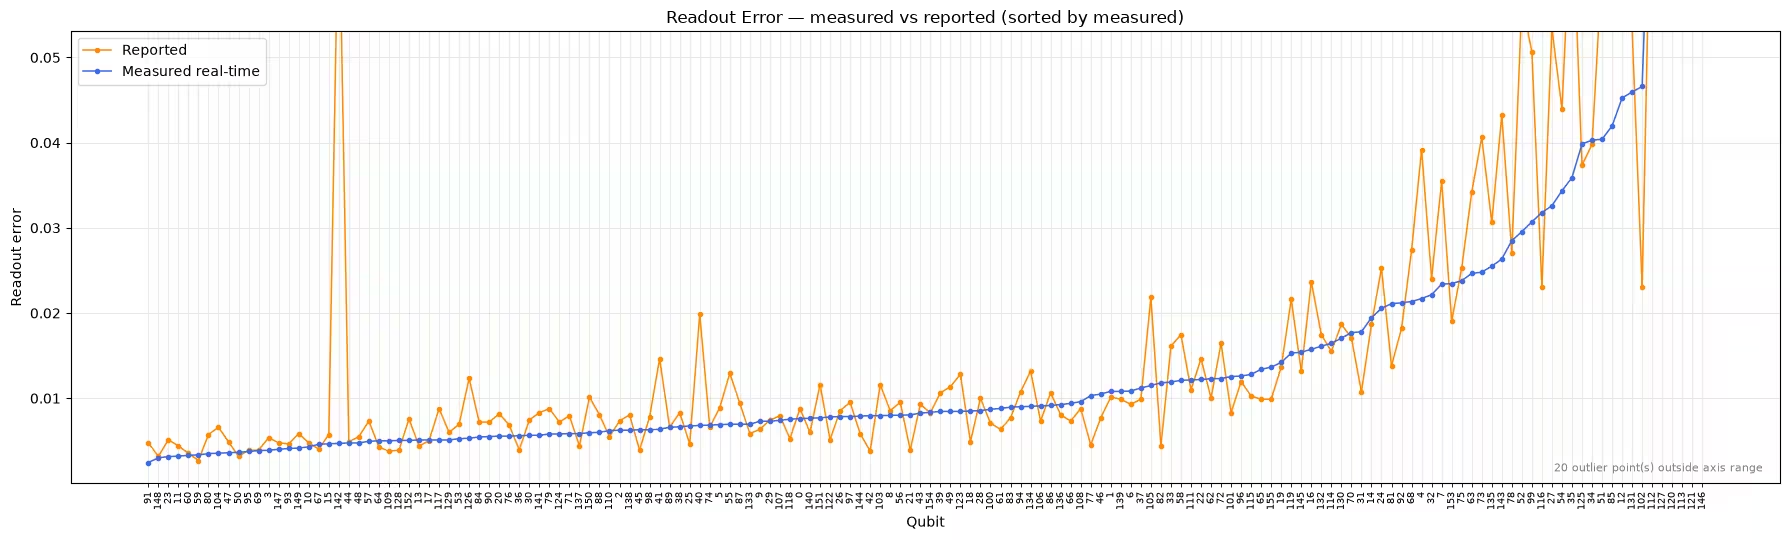
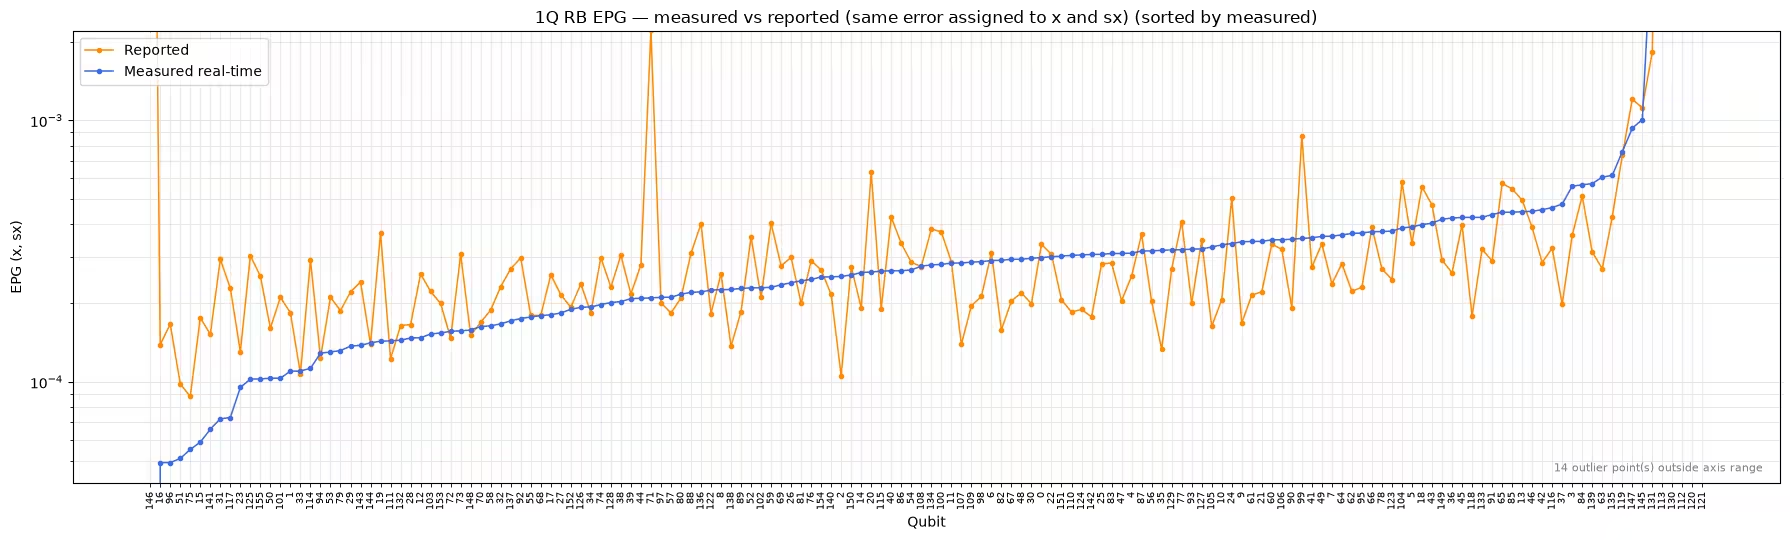
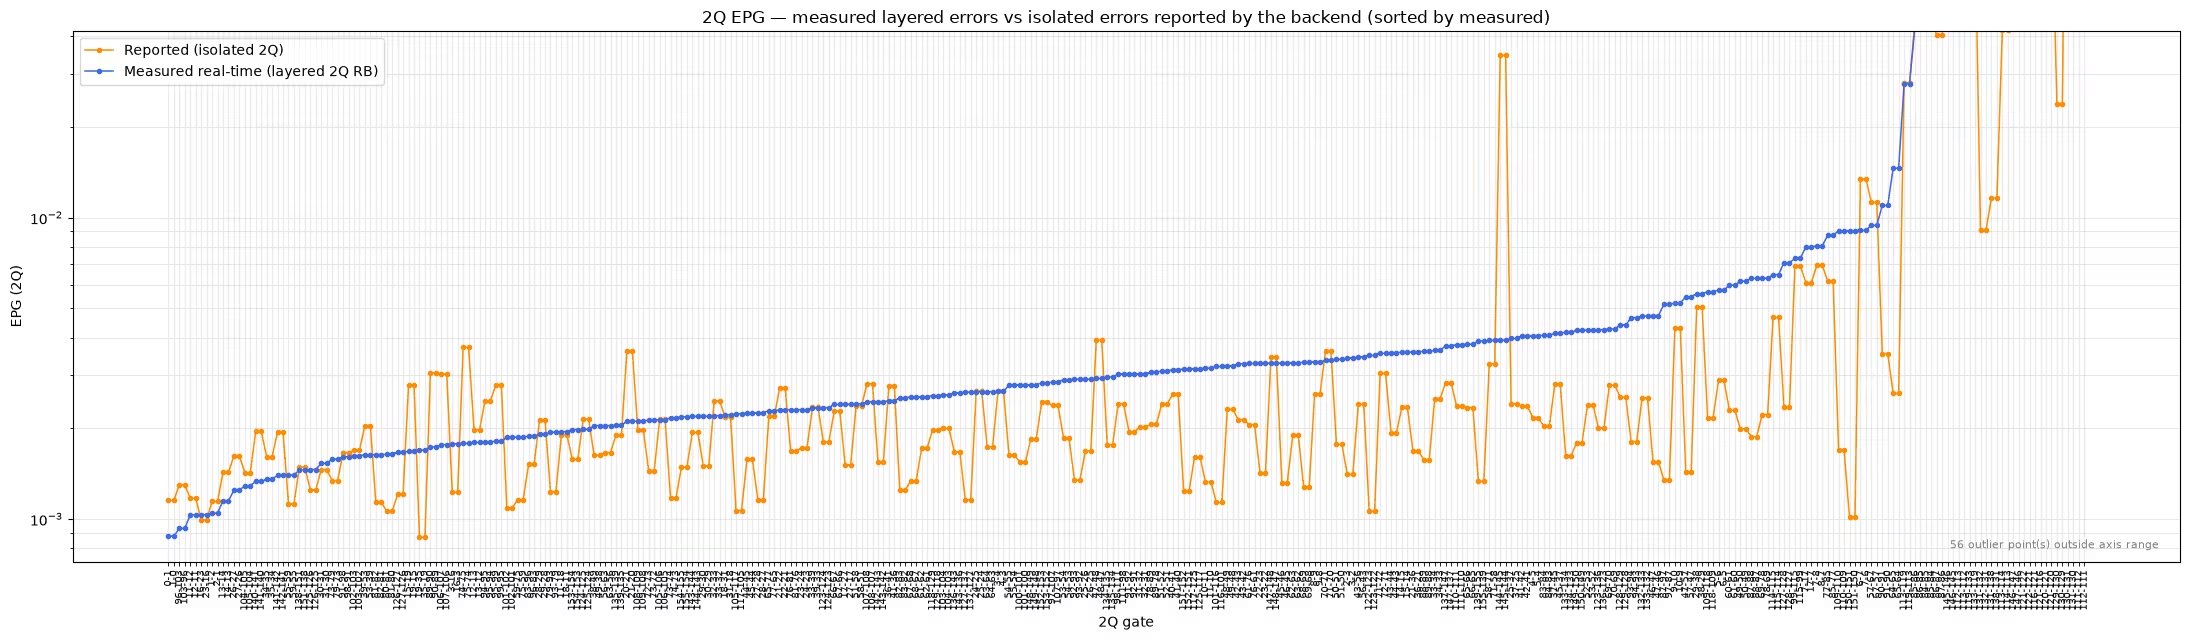
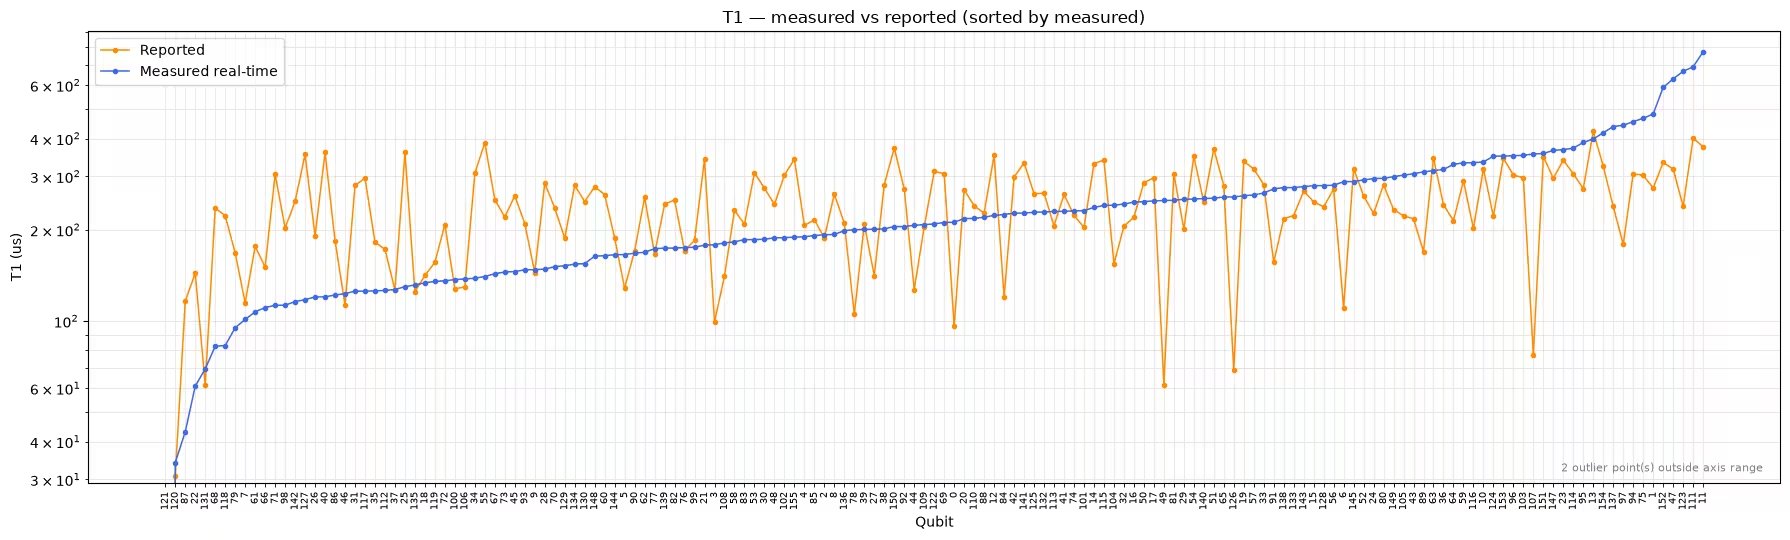
Na koniec wykreśl zmierzone w czasie rzeczywistym właściwości na tle wartości zgłaszanych przez backend. Na każdym panelu kubity (lub pary kubitów) są posortowane według zmierzonej wartości, więc zmierzona krzywa jest z definicji gładka, a rozrzut zgłoszonych wartości wokół niej pokazuje, gdzie oba zbiory się nie zgadzają. Dla RB jednokubitowego pokazany jest pojedynczy wykres, ponieważ ten sam zmierzony błąd na bramkę jest przypisywany zarówno bramce x, jak i sx. Granice osi są dobierane na podstawie masy danych, tak aby kilka skrajnych wartości odstających nie kompresowało wykresów; wszelkie punkty poza zakresem są liczone w adnotacji na wykresie (lub przekaż ylim, aby nadpisać granice).
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated.properties().to_dict(),
    plots=["readout", "rb_1q", "rb_2q", "t1", "t2"],
)
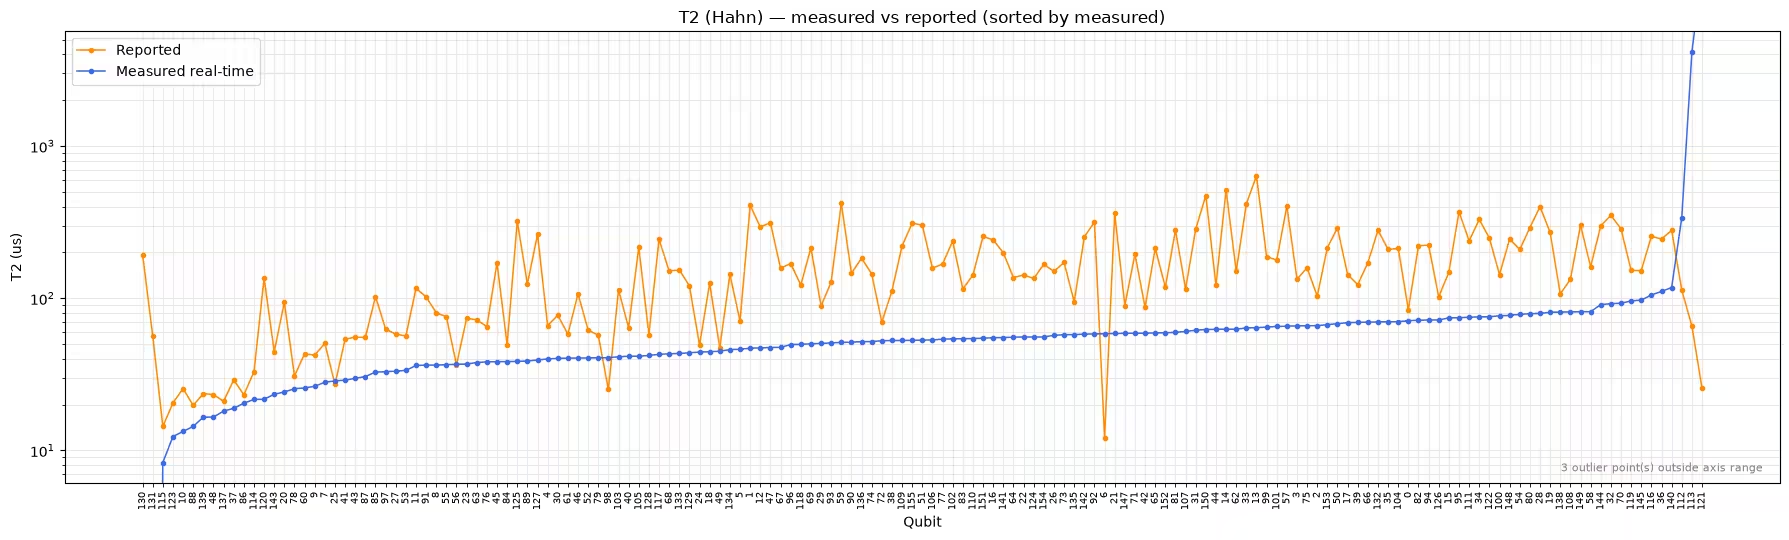
Te wykresy wymagają starannej interpretacji, ponieważ nie każda różnica między obiema krzywymi oznacza, że urządzenie dryfowało:
-
Błędy odczytu i jednokubitowe: Zmierzone wartości podążają za zgłoszonymi dla większości kubitów, podczas gdy zgłoszona wartość dla garstki kubitów jest znacznie oddalona od zmierzonej krzywej. Te zlokalizowane rozbieżności to właśnie dryf, który ten przepływ pracy ma za zadanie wychwycić.
-
: Oba zbiory danych rozpraszają się wokół siebie bez systematycznego przesunięcia, co jest zgodne z naturalnym wahaniem w czasie.
-
Błędy dwukubitowe: Zmierzone wartości leżą systematycznie powyżej zgłoszonych. Jest to oczekiwane, ponieważ zgłoszone wartości są mierzone na izolowanych bramkach, podczas gdy eksperyment wierności warstwy uruchamia wiele bramek jednocześnie i dlatego uwzględnia przesłuchy. Wartości warstwowe są bardziej istotne dla głębokich obwodów, ale nie są bezpośrednio porównywalne ze zgłoszonymi danymi kalibracyjnymi.
-
: Zmierzone wartości leżą znacznie poniżej zgłoszonych dla większości kubitów. Ponownie, metodologia odgrywa dużą rolę, co zostanie zbadane w następnej sekcji.
Sprawdzanie wyników poszczególnych eksperymentów
Możesz również sprawdzić surowe wyniki poszczególnych eksperymentów charakteryzacyjnych za pomocą właściwości experiment_data, która zwraca bazowe obiekty ExperimentData z Qiskit Experiments. Na przykład poniżej wyświetlana jest zmierzona krzywa zaniku pojedynczego kubitu, co jest przydatne do sprawdzenia jakości dopasowania przed zaufaniem uzyskanej liczbie.
t1_data = characterizer.experiment_data["t1"]

# Each qubit has its own fit figure
n_figs = len(t1_data.figure_names)
print(f"{n_figs} figures available, e.g. {t1_data.figure_names[0]}")

# Show the T1 decay curve of the first qubit
t1_data.figure(0)
156 figures available, e.g. T1_Q0_c78ef792.svg

Pomiar T2 z sekwencją impulsów dynamicznego rozprzęgania
Domyślnie eksperyment stosuje pojedyncze echo Hahna i mierzy wszystkie kubity równolegle, co, jak pokazał powyższy wykres porównawczy, może dawać wyraźnie niższe wartości niż zgłasza backend. Jedną z hipotez jest liczba ech: zgłoszone wartości mogą być kalibrowane z dynamicznym rozprzęganiem, które tłumi szum o niskiej częstotliwości. Aby to sprawdzić, uruchom charakteryzację obejmującą wyłącznie z opcją t2_num_echoes ustawioną na większą wartość, co stosuje pociąg impulsów echa w stylu CPMG. Opóźnienia w obu przypadkach reprezentują całkowity czas swobodnej ewolucji, więc dopasowane wartości są bezpośrednio porównywalne z wynikami pojedynczego echa.
# Run a T2-only characterization using a CPMG-style train of 8 echoes
characterizer_dd = BackendCharacterization(backend)
backend_updated_dd = characterizer_dd.run_and_update(
    experiments=["t2"], t2_num_echoes=8
)
Building T2 experiments
T2 (Hahn) experiment submitted: ['d9b96s6g26ic73dflcn0']
Updating T2
# Compare the multi-echo T2 against the backend-reported values
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated_dd.properties().to_dict(),
    plots=["t2"],
    title_prefix="8-echo CPMG",
)

# Compare medians across the reported values, the single-echo run,
# and the 8-echo run
reported_t2s = [
    prop["value"]
    for qubit in backend.properties().to_dict()["qubits"]
    for prop in qubit
    if prop["name"] == "T2"
]
t2_reported = np.median(reported_t2s)
t2_single = np.median(list(error_maps["t2_map"].values())) * 1e6
t2_dd = (
    np.median(list(characterizer_dd.analyze_results()["t2_map"].values()))
    * 1e6
)
print(
    f"Median T2 — reported: {t2_reported:.0f} us | "
    f"single echo: {t2_single:.0f} us | 8-echo CPMG: {t2_dd:.0f} us"
)
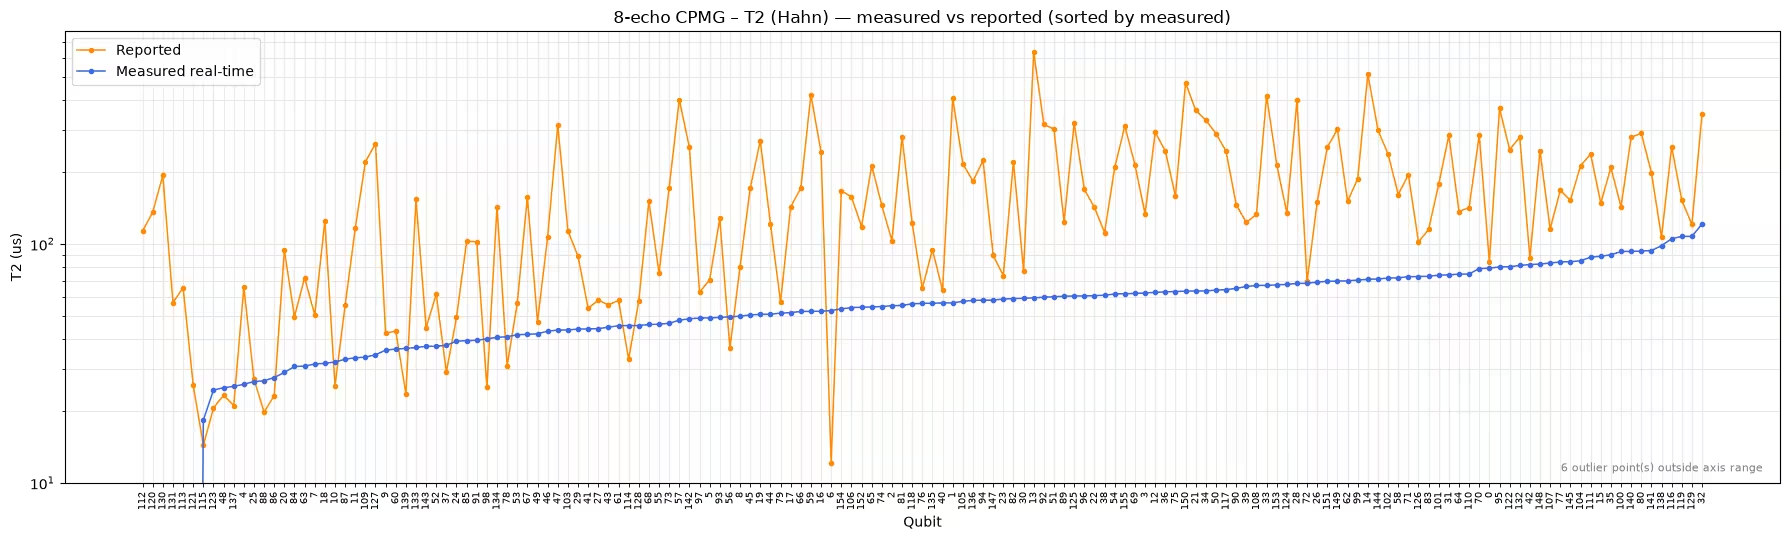
Median T2 — reported: 142 us | single echo: 53 us | 8-echo CPMG: 56 us
W tym przebiegu dodatkowe echa niemal nie zmieniły wyniku: mediana dla 8 ech (56 µs) jest bliska medianie dla pojedynczego echa (53 µs), a obie pozostają znacznie poniżej zgłoszonej mediany (142 µs). Sama liczba ech nie wyjaśnia tej różnicy; zaangażowane są inne różnice metodologiczne, takie jak szczegóły procedury kalibracyjnej, pomiar wszystkich kubitów równolegle zamiast pojedynczo i tak dalej.
Praktyczną lekcją jest ostrożne traktowanie porównań (i warstwowego błędu dwukubitowego) między metodologiami. Odświeżone wartości to spójna wewnętrznie migawka wykonana w warunkach zbliżonych do rzeczywistego obciążenia, dzięki czemu dobrze nadają się do porównywania kubitów między sobą lub śledzenia urządzenia w czasie. Różnica względem zgłoszonych danych kalibracyjnych nie jest jednak automatycznie dowodem dryfu.
Kroki 1–4 skompresowane w jedno wywołanie
Na co dzień rzadko potrzebujesz wyników pośrednich. Metoda run_and_update łączy wszystko, co zrobiłeś powyżej (budowanie, przesyłanie, dopasowywanie i aktualizację) w jedno wywołanie, które zwraca odświeżony backend. Przyjmuje tę samą listę experiments (i przekazuje dalej opcje takie jak t2_num_echoes) i podobnie może zostać opakowana w kontekst Batch lub Session.
Poniższa komórka nie zwraca wyniku, dopóki wszystkie zadania i przetwarzanie końcowe nie zostaną zakończone.
# Initialize a fresh characterizer
characterizer = BackendCharacterization(backend)

# Run all of the experiments and update the backend in a single call
backend_updated = characterizer.run_and_update(experiments=experiments)
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7oqnu62qs738otat0', 'd9b7p76g26ic73dfjolg', 'd9b7pnm6hjac73ffb57g', 'd9b7q4fu62qs738otce0']
Readout job submitted: d9b7q4mg26ic73dfjprg
T1 experiment submitted: ['d9b7q57u62qs738otcfg']
T2 (Hahn) experiment submitted: ['d9b7q5m6hjac73ffb5pg']
Single-qubit RB submitted: ['d9b7r4e6hjac73ffb71g', 'd9b7reu6hjac73ffb7d0']
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
Odświeżony obiekt backend_updated jest teraz gotowy do użycia wszędzie tam, gdzie właściwości backendu zasilają twój przepływ pracy. Wypróbuj ten proces w połączeniu z samouczkiem Benchmarking w czasie rzeczywistym do wyboru kubitów, aby wybrać najlepiej działające kubity podczas transpilacji obwodu. Ponieważ urządzenie stale dryfuje, odświeżaj właściwości blisko momentu faktycznego wykonania obciążenia.
Kolejne kroki
Jeśli ta praca cię zainteresowała, może zainteresować cię również następujący materiał:
- Użyj odświeżonych właściwości, aby wybrać lepsze kubity w samouczku Benchmarking w czasie rzeczywistym do wyboru kubitów
- Dowiedz się, jak zgłoszone dane kalibracyjne są udostępniane w przewodniku Informacje o QPU
- Poznaj poszczególne eksperymenty charakteryzacyjne w dokumentacji Qiskit Experiments
- Przeglądaj dalsze benchmarki na poziomie urządzenia w repozytorium Qiskit Device Benchmarking