Symulacja hamiltoniana Isinga z kopnięciami przy użyciu obwodów dynamicznych
Szacowane użycie: 7,5 minuty na procesorze Heron r3. (UWAGA: To jedynie szacunek. Rzeczywisty czas wykonania może się różnić.) Obwody dynamiczne to obwody z klasycznym sprzężeniem w przód (feedforward) — innymi słowy, są to pomiary w trakcie obwodu, po których następują klasyczne operacje logiczne warunkujące operacje kwantowe na podstawie klasycznego wyniku. W tym samouczku symulujemy model Isinga z kopnięciami na heksagonalnej sieci spinów i używamy obwodów dynamicznych do realizacji oddziaływań wykraczających poza fizyczną łączność sprzętu.
Model Isinga był szeroko badany w różnych dziedzinach fizyki. Opisuje spiny podlegające oddziaływaniom Isinga między węzłami sieci, a także kopnięciom lokalnego pola magnetycznego w każdym węźle. Trotteryzowana ewolucja czasowa spinów rozważana w tym samouczku, zaczerpnięta z [1], dana jest przez następujący operator unitarny:
Aby zbadać dynamikę spinów, badamy średnie namagnesowanie spinów w każdym węźle w funkcji kroków Trottera. W tym celu konstruujemy następującą obserwowalną:
Aby zrealizować oddziaływanie ZZ między węzłami sieci, przedstawiamy rozwiązanie wykorzystujące funkcję obwodów dynamicznych, prowadzące do znacznie krótszej głębokości dwuqubitowej w porównaniu ze standardową metodą trasowania z bramkami SWAP. Z drugiej strony klasyczne operacje sprzężenia w przód (feedforward) w obwodach dynamicznych mają zazwyczaj dłuższy czas wykonania niż bramki kwantowe; dlatego obwody dynamiczne mają swoje ograniczenia i kompromisy. Pokazujemy również sposób dodawania sekwencji dynamicznego rozsprzęgania na bezczynnych qubitach podczas operacji klasycznego sprzężenia w przód (feedforward) przy użyciu czasu trwania stretch.
Wymagania
Przed rozpoczęciem tego samouczka upewnij się, że masz zainstalowane następujące elementy:
-
Qiskit SDK v2.0 lub nowszy z obsługą wizualizacji
-
Qiskit Runtime v0.37 lub nowszy z obsługą wizualizacji (
pip install 'qiskit-ibm-runtime[visualization]') -
Biblioteka grafów Rustworkx (
pip install rustworkx) -
Qiskit Aer (
pip install qiskit-aer)
Konfiguracja
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "rustworkx": "rustworkx"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import numpy as np
from typing import List
import rustworkx as rx
import matplotlib.pyplot as plt
from rustworkx.visualization import mpl_draw
from qiskit.circuit import (
    Parameter,
    QuantumCircuit,
    QuantumRegister,
    ClassicalRegister,
)
from qiskit.transpiler import CouplingMap
from qiskit.quantum_info import SparsePauliOp
from qiskit.circuit.classical import expr
from qiskit.transpiler.preset_passmanagers import (
    generate_preset_pass_manager,
)
from qiskit.transpiler import PassManager
from qiskit.circuit.library import RZGate, XGate
from qiskit.transpiler.passes import (
    ALAPScheduleAnalysis,
    PadDynamicalDecoupling,
)

from qiskit.transpiler.basepasses import TransformationPass
from qiskit.circuit.measure import Measure
from qiskit.transpiler.passes.utils.remove_final_measurements import (
    calc_final_ops,
)
from qiskit.circuit import Instruction

from qiskit.visualization import plot_circuit_layout
from qiskit.circuit.tools import pi_check

from qiskit_aer import AerSimulator
from qiskit_aer.primitives import SamplerV2 as Aer_Sampler

from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    Batch,
    SamplerV2 as Sampler,
)
from qiskit.providers.exceptions import QiskitBackendNotFoundError
from qiskit_ibm_runtime.visualization import (
    draw_circuit_schedule_timing,
)
Krok 1: Odwzorowanie klasycznych danych wejściowych na obwód kwantowy
Zaczynamy od zdefiniowania sieci do symulacji. Wybieramy sieć plastra miodu (zwaną też hexagonalną), która jest planarnym grafem o węzłach stopnia 3. Tutaj określamy rozmiar sieci oraz istotne parametry obwodu dla trotteryzowanej dynamiki. Symulujemy trotteryzowaną ewolucję czasową w modelu Isinga dla trzech różnych wartości lokalnego pola magnetycznego.
hex_rows = 3  # specify lattice size
hex_cols = 5
depths = range(9)  # specify Trotter steps
zz_angle = np.pi / 8  # parameter for ZZ interaction
max_angle = np.pi / 2  # max theta angle
points = 3  # number of theta parameters

θ = Parameter("θ")
params = np.linspace(0, max_angle, points)
def make_hex_lattice(hex_rows=1, hex_cols=1):
    """Define hexagon lattice."""
    hex_cmap = CouplingMap.from_hexagonal_lattice(
        hex_rows, hex_cols, bidirectional=False
    )
    data = list(hex_cmap.physical_qubits)
    graph = hex_cmap.graph.to_undirected(multigraph=False)
    edge_colors = rx.graph_misra_gries_edge_color(graph)
    layer_edges = {color: [] for color in edge_colors.values()}
    for edge_index, color in edge_colors.items():
        layer_edges[color].append(graph.edge_list()[edge_index])
    return data, layer_edges, hex_cmap, graph
Zacznijmy od małego przykładu testowego:
hex_rows_test = 1
hex_cols_test = 2

data_test, layer_edges_test, hex_cmap_test, graph_test = make_hex_lattice(
    hex_rows=hex_rows_test, hex_cols=hex_cols_test
)

# display a small example for illustration
node_colors_test = ["lightblue"] * len(graph_test.node_indices())
pos = rx.graph_spring_layout(
    graph_test,
    k=5 / np.sqrt(len(graph_test.nodes())),
    repulsive_exponent=1,
    num_iter=150,
)
mpl_draw(graph_test, node_color=node_colors_test, pos=pos)

Użyjemy małego przykładu do ilustracji i symulacji. Poniżej konstruujemy też duży przykład, aby pokazać, że przepływ pracy można rozszerzyć do większych rozmiarów.
data, layer_edges, hex_cmap, graph = make_hex_lattice(
    hex_rows=hex_rows, hex_cols=hex_cols
)
num_qubits = len(data)
print(f"num_qubits = {num_qubits}")

# display the honeycomb lattice to simulate
node_colors = ["lightblue"] * len(graph.node_indices())
pos = rx.graph_spring_layout(
    graph,
    k=5 / np.sqrt(num_qubits),
    repulsive_exponent=1,
    num_iter=150,
)
mpl_draw(graph, node_color=node_colors, pos=pos)
plt.show()
num_qubits = 46

Budowanie obwodów unitarnych
Po określeniu rozmiaru problemu i parametrów jesteśmy gotowi do zbudowania sparametryzowanego obwodu symulującego trotteryzowaną ewolucję czasową przy różnych krokach Trottera, określonych przez argument depth. Konstruowany obwód ma naprzemienne warstwy bramek Rx() i bramek Rzz. Bramki Rzz realizują oddziaływania ZZ między sprzężonymi spinami, które będą umieszczone między każdym węzłem sieci określonym przez argument layer_edges.
def gen_hex_unitary(
    num_qubits=6,
    zz_angle=np.pi / 8,
    layer_edges=[
        [(0, 1), (2, 3), (4, 5)],
        [(1, 2), (3, 4), (5, 0)],
    ],
    θ=Parameter("θ"),
    depth=1,
    measure=False,
    final_rot=True,
):
    """Build unitary circuit."""
    circuit = QuantumCircuit(num_qubits)
    # Build trotter layers
    for _ in range(depth):
        for i in range(num_qubits):
            circuit.rx(θ, i)
        circuit.barrier()
        for coloring in layer_edges.keys():
            for e in layer_edges[coloring]:
                circuit.rzz(zz_angle, e[0], e[1])
        circuit.barrier()
    # Optional final rotation, set True to be consistent with Ref. [1]
    if final_rot:
        for i in range(num_qubits):
            circuit.rx(θ, i)
    if measure:
        circuit.measure_all()

    return circuit
Zwizualizuj mały obwód testowy:
circ_unitary_test = gen_hex_unitary(
    num_qubits=len(data_test),
    layer_edges=layer_edges_test,
    θ=Parameter("θ"),
    depth=1,
    measure=True,
)
circ_unitary_test.draw(output="mpl", fold=-1)

Podobnie, skonstruuj obwody unitarne dużego przykładu przy różnych krokach Trottera oraz obserwowalną do szacowania wartości oczekiwanej.
circuits_unitary = []
for depth in depths:
    circ = gen_hex_unitary(
        num_qubits=num_qubits,
        layer_edges=layer_edges,
        θ=Parameter("θ"),
        depth=depth,
        measure=True,
    )
    circuits_unitary.append(circ)
observables_unitary = SparsePauliOp.from_sparse_list(
    [("Z", [i], 1 / num_qubits) for i in range(num_qubits)],
    num_qubits=num_qubits,
)
Budowanie implementacji z obwodem dynamicznym
Ta sekcja demonstruje główną implementację z obwodem dynamicznym służącą do symulacji tej samej trotteryzowanej ewolucji czasowej. Zauważ, że sieć plastra miodu, którą chcemy symulować, nie odpowiada ciężkiej sieci qubitów sprzętowych. Jednym prostym sposobem odwzorowania obwodu na sprzęt jest wprowadzenie serii operacji SWAP w celu zbliżenia oddziałujących qubitów, aby zrealizować oddziaływanie ZZ. Tutaj wyróżniamy alternatywne podejście z użyciem obwodów dynamicznych, które ilustruje, że możemy połączyć obliczenia kwantowe z klasycznymi obliczeniami w czasie rzeczywistym wewnątrz obwodu w Qiskit, aby realizować oddziaływania wykraczające poza sąsiedztwo.
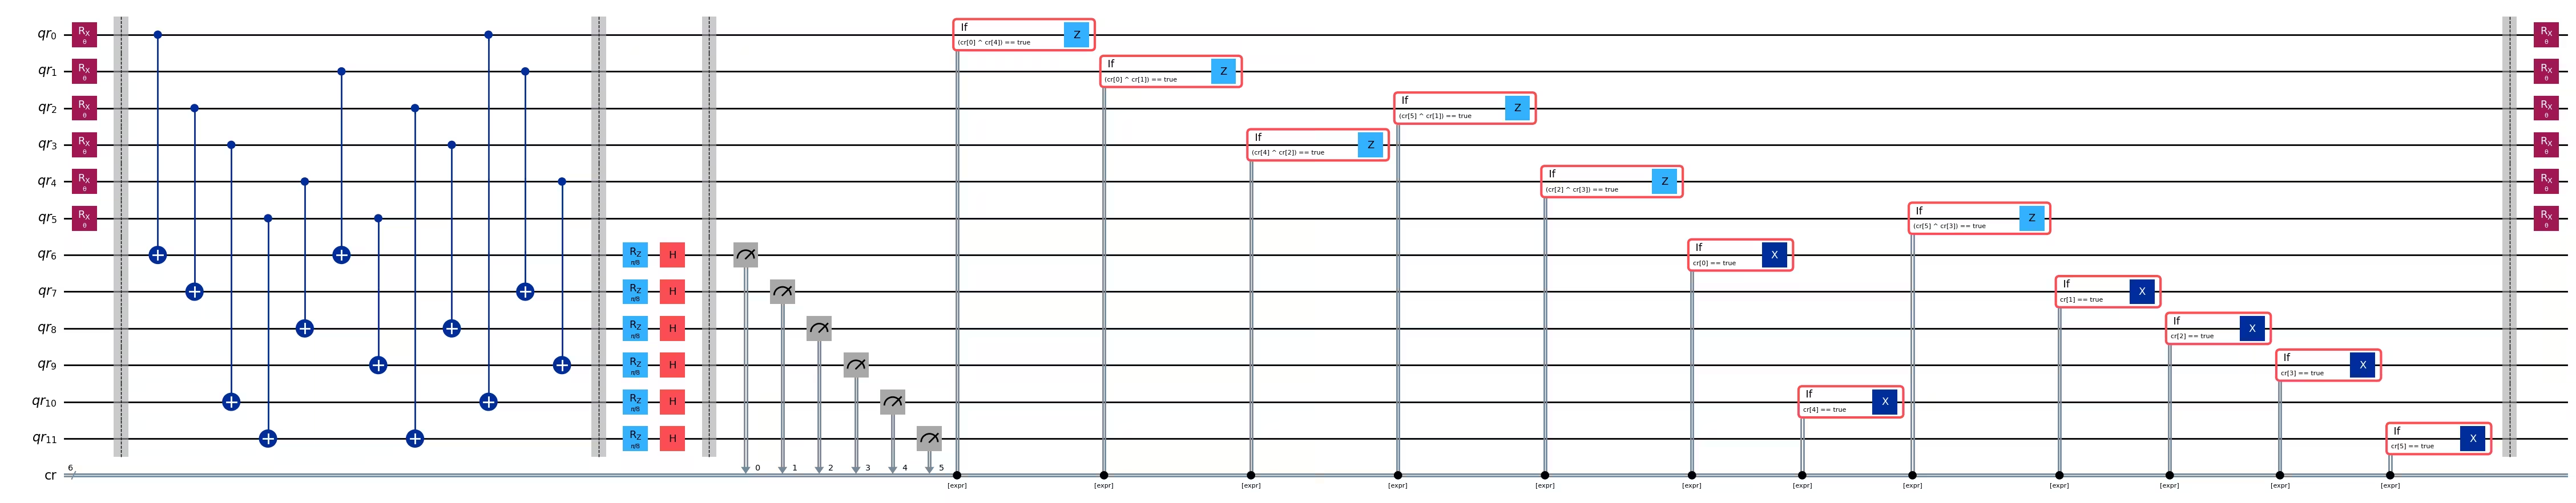
W implementacji z obwodem dynamicznym oddziaływanie ZZ jest efektywnie realizowane przy użyciu qubitów pomocniczych, pomiaru w trakcie obwodu i sprzężenia w przód (feedforward). Aby to zrozumieć, zauważmy, że rotacje ZZ nadają czynnik fazowy stanowi w zależności od jego parzystości. Dla dwóch qubitów stany bazowe obliczeniowe to , , i . Bramka rotacji ZZ nadaje czynnik fazowy stanom i , których parzystość (liczba jedynek w stanie) jest nieparzysta, i pozostawia stany parzyste bez zmian. Poniżej opisujemy, jak można efektywnie zrealizować oddziaływania ZZ na dwóch qubitach przy użyciu obwodów dynamicznych.
-
Oblicz parzystość do qubitu pomocniczego: zamiast bezpośrednio stosować ZZ do dwóch qubitów, wprowadzamy trzeci qubit — qubit pomocniczy — do przechowywania informacji o parzystości dwóch qubitów danych. Splątujemy qubit pomocniczy z każdym qubitem danych za pomocą bramek CX od qubitu danych do qubitu pomocniczego.
-
Zastosuj jednoqubitową rotację Z do qubitu pomocniczego: ponieważ qubit pomocniczy zawiera informację o parzystości dwóch qubitów danych, efektywnie realizuje to rotację ZZ na qubitach danych.
-
Zmierz qubit pomocniczy w bazie X: to kluczowy krok, który powoduje kolaps stanu qubitu pomocniczego, a wynik pomiaru mówi nam, co się stało:
-
Wynik 0: gdy obserwowany jest wynik 0, poprawnie zastosowaliśmy rotację do naszych qubitów danych.
-
Wynik 1: gdy obserwowany jest wynik 1, zastosowaliśmy .
-
-
Zastosuj bramkę korekcyjną przy wyniku 1: jeśli zmierzono 1, stosujemy bramki Z do qubitów danych, aby „naprawić" dodatkową fazę .
Wynikowy obwód jest następujący:
 Gdy przyjmiemy to podejście do symulacji sieci plastra miodu, wynikowy obwód doskonale wbudowuje się w sprzęt z siecią heavy-hex: wszystkie qubity danych leżą na węzłach stopnia 3 sieci, tworząc sieć hexagonalną. Każda para qubitów danych dzieli qubit pomocniczy leżący na węźle stopnia 2. Poniżej konstruujemy sieć qubitów dla implementacji z obwodem dynamicznym, wprowadzając qubity pomocnicze (pokazane ciemnofioletowymi okręgami).
def make_lattice(hex_rows=1, hex_cols=1):
    """Define heavy-hex lattice and corresponding lists of data and ancilla nodes."""
    hex_cmap = CouplingMap.from_hexagonal_lattice(
        hex_rows, hex_cols, bidirectional=False
    )
    data = list(hex_cmap.physical_qubits)

    heavyhex_cmap = CouplingMap()
    for d in data:
        heavyhex_cmap.add_physical_qubit(d)

    # make coupling map
    a = len(data)
    for edge in hex_cmap.get_edges():
        heavyhex_cmap.add_physical_qubit(a)
        heavyhex_cmap.add_edge(edge[0], a)
        heavyhex_cmap.add_edge(edge[1], a)
        a += 1
    ancilla = list(range(len(data), a))
    qubits = data + ancilla

    # color edges
    graph = heavyhex_cmap.graph.to_undirected(multigraph=False)
    edge_colors = rx.graph_misra_gries_edge_color(graph)
    layer_edges = {color: [] for color in edge_colors.values()}
    for edge_index, color in edge_colors.items():
        layer_edges[color].append(graph.edge_list()[edge_index])

    # construct observable
    obs_hex = SparsePauliOp.from_sparse_list(
        [("Z", [i], 1 / len(data)) for i in data],
        num_qubits=len(qubits),
    )

    return (data, qubits, ancilla, layer_edges, heavyhex_cmap, graph, obs_hex)
Zwizualizuj sieć heavy-hex z qubitami danych i qubitami pomocniczymi w małej skali:
(data, qubits, ancilla, layer_edges, heavyhex_cmap, graph, obs_hex) = (
    make_lattice(hex_rows=hex_rows, hex_cols=hex_cols)
)

print(f"number of data qubits = {len(data)}")
print(f"number of ancilla qubits = {len(ancilla)}")

node_colors = []
for node in graph.node_indices():
    if node in ancilla:
        node_colors.append("purple")
    else:
        node_colors.append("lightblue")

pos = rx.graph_spring_layout(
    graph,
    k=1 / np.sqrt(len(qubits)),
    repulsive_exponent=2,
    num_iter=200,
)

# Visualize the graph, blue circles are data qubits and purple circles are ancillas
mpl_draw(graph, node_color=node_colors, pos=pos)
plt.show()
number of data qubits = 46
number of ancilla qubits = 60
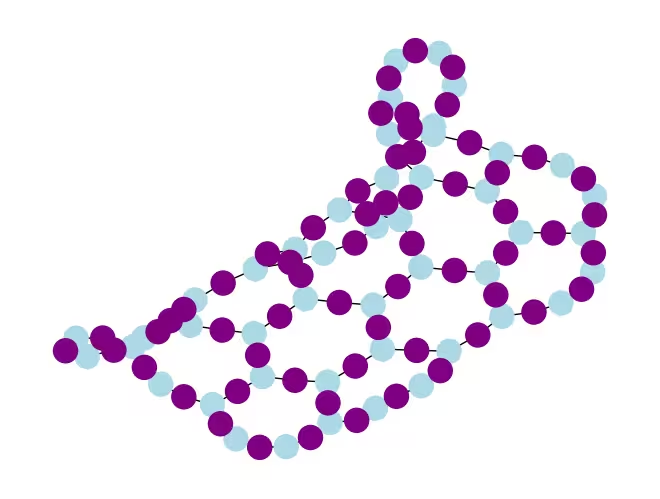
Poniżej konstruujemy obwód dynamiczny dla trotteryzowanej ewolucji czasowej. Bramki RZZ są zastępowane implementacją z obwodem dynamicznym zgodnie z opisanymi powyżej krokami.
def gen_hex_dynamic(
    depth=1,
    zz_angle=np.pi / 8,
    θ=Parameter("θ"),
    hex_rows=1,
    hex_cols=1,
    measure=False,
    add_dd=True,
):
    """Build dynamic circuits."""
    (data, qubits, ancilla, layer_edges, heavyhex_cmap, graph, obs_hex) = (
        make_lattice(hex_rows=hex_rows, hex_cols=hex_cols)
    )
    # Initialize circuit
    qr = QuantumRegister(len(qubits), "qr")
    cr = ClassicalRegister(len(ancilla), "cr")
    circuit = QuantumCircuit(qr, cr)

    for k in range(depth):
        # Single-qubit Rx layer
        for d in data:
            circuit.rx(θ, d)
        circuit.barrier()

        # CX gates from data qubits to ancilla qubits
        for same_color_edges in layer_edges.values():
            for e in same_color_edges:
                circuit.cx(e[0], e[1])
        circuit.barrier()

        # Apply Rz rotation on ancilla qubits and rotate into X basis
        for a in ancilla:
            circuit.rz(zz_angle, a)
            circuit.h(a)
        # Add barrier to align terminal measurement
        circuit.barrier()

        # Measure ancilla qubits
        for i, a in enumerate(ancilla):
            circuit.measure(a, i)
        d2ros = {}
        a2ro = {}
        # Retrieve ancilla measurement outcomes
        for a in ancilla:
            a2ro[a] = cr[ancilla.index(a)]

        # For each data qubit, retrieve measurement outcomes of neighboring
        # ancilla qubits
        for d in data:
            ros = [a2ro[a] for a in heavyhex_cmap.neighbors(d)]
            d2ros[d] = ros

        # Build classical feedforward operations (optionally add DD on idling
        # data qubits)
        for d in data:
            if add_dd:
                circuit = add_stretch_dd(circuit, d, f"data_{d}_depth_{k}")

            # # XOR the neighboring readouts of the data qubit;
            # if True, apply Z to it
            ros = d2ros[d]
            parity = ros[0]
            for ro in ros[1:]:
                parity = expr.bit_xor(parity, ro)
            with circuit.if_test(expr.equal(parity, True)):
                circuit.z(d)

        # Reset the ancilla if its readout is 1
        for a in ancilla:
            with circuit.if_test(expr.equal(a2ro[a], True)):
                circuit.x(a)
        circuit.barrier()

    # Final single-qubit Rx layer to match the unitary circuits
    for d in data:
        circuit.rx(θ, d)

    if measure:
        circuit.measure_all()
    return circuit, obs_hex

def add_stretch_dd(qc, q, name):
    """Add XpXm DD sequence."""
    s = qc.add_stretch(name)
    qc.delay(s, q)
    qc.x(q)
    qc.delay(s, q)
    qc.delay(s, q)
    qc.rz(np.pi, q)
    qc.x(q)
    qc.rz(-np.pi, q)
    qc.delay(s, q)
    return qc
Dynamiczne rozsprzęganie (DD) i obsługa czasu trwania stretch
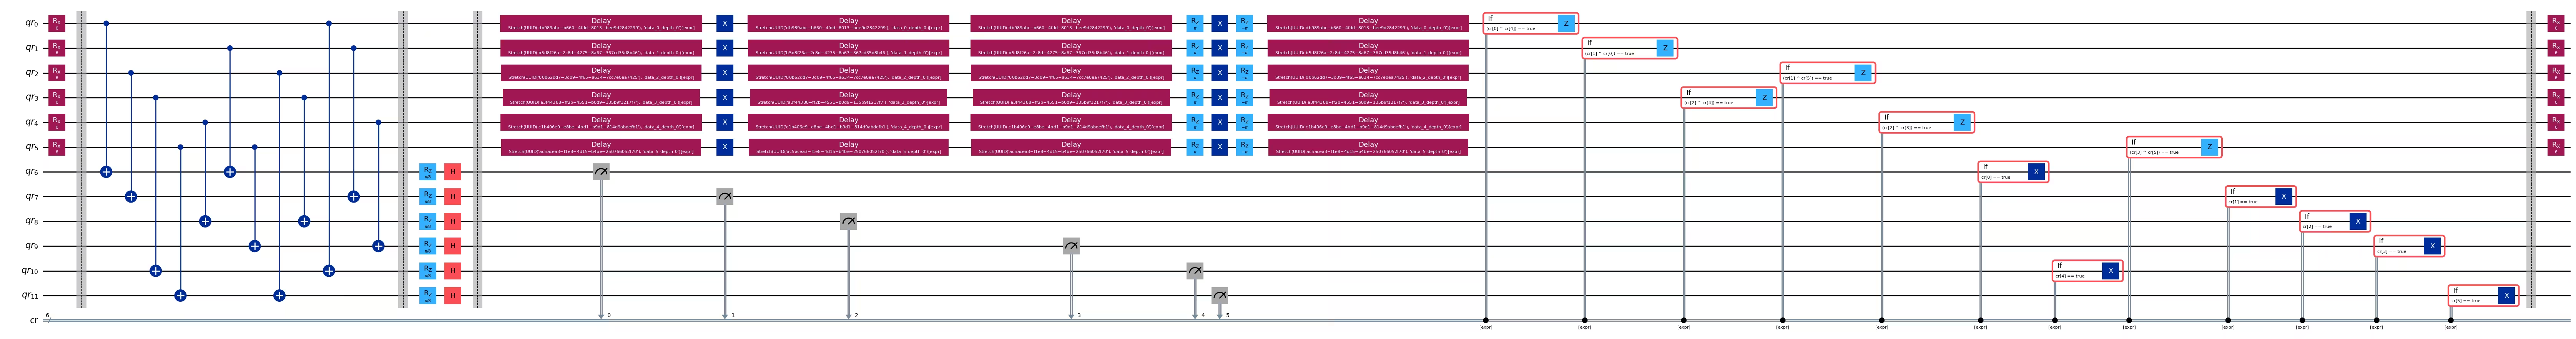
Jednym zastrzeżeniem dotyczącym użycia implementacji z obwodem dynamicznym do realizacji oddziaływania ZZ jest to, że pomiar w trakcie obwodu i klasyczne operacje sprzężenia w przód (feedforward) zazwyczaj wymagają dłuższego czasu wykonania niż bramki kwantowe. Aby tłumić dekoherencję qubitów podczas czasu bezczynności potrzebnego na przeprowadzenie operacji klasycznych, dodaliśmy sekwencję dynamicznego rozsprzęgania (DD) po operacji pomiaru qubitów pomocniczych, a przed warunkową operacją Z na qubicie danych, przed instrukcją if_test.
Sekwencja DD jest dodawana przez funkcję add_stretch_dd(), która używa czasu trwania stretch do określenia przedziałów czasowych między bramkami DD. Czas trwania stretch to sposób na określenie rozciągliwego czasu trwania dla operacji delay, tak aby czas opóźnienia mógł rosnąć i wypełniać czas bezczynności qubitu. Zmienne czasu trwania określone przez stretch są rozwiązywane w czasie kompilacji do pożądanych czasów trwania spełniających określone ograniczenie. Jest to bardzo przydatne, gdy synchronizacja sekwencji DD jest istotna dla dobrej wydajności tłumienia błędów. Więcej szczegółów na temat typu stretch znajdziesz w dokumentacji OpenQASM. Obecnie obsługa typu stretch jest eksperymentalna. Szczegóły dotyczące ograniczeń użycia znajdziesz w sekcji ograniczeń dokumentacji stretch.
Używając zdefiniowanych powyżej funkcji, budujemy obwody trotteryzowanej ewolucji czasowej z DD i bez DD oraz odpowiadające im obserwowalne. Zaczniemy od wizualizacji obwodu dynamicznego na małym przykładzie:
hex_rows_test = 1
hex_cols_test = 1

(
    data_test,
    qubits_test,
    ancilla_test,
    layer_edges_test,
    heavyhex_cmap_test,
    graph_test,
    obs_hex_test,
) = make_lattice(hex_rows=hex_rows_test, hex_cols=hex_cols_test)

node_colors = []
for node in graph_test.node_indices():
    if node in ancilla_test:
        node_colors.append("purple")
    else:
        node_colors.append("lightblue")
pos = rx.graph_spring_layout(
    graph_test,
    k=5 / np.sqrt(len(qubits_test)),
    repulsive_exponent=2,
    num_iter=150,
)

# display a small example for illustration
node_colors_test = ["lightblue"] * len(graph_test.node_indices())
mpl_draw(graph_test, node_color=node_colors, pos=pos)

circuit_dynamic_test, obs_dynamic_test = gen_hex_dynamic(
    depth=1,
    θ=Parameter("θ"),
    hex_rows=hex_rows_test,
    hex_cols=hex_cols_test,
    measure=False,
    add_dd=False,
)
circuit_dynamic_test.draw("mpl", fold=-1)
circuit_dynamic_dd_test, _ = gen_hex_dynamic(
    depth=1,
    θ=Parameter("θ"),
    hex_rows=hex_rows_test,
    hex_cols=hex_cols_test,
    measure=False,
    add_dd=True,
)
circuit_dynamic_dd_test.draw("mpl", fold=-1)
Podobnie, skonstruuj obwody dynamiczne dla dużego przykładu:
circuits_dynamic = []
circuits_dynamic_dd = []
observables_dynamic = []
for depth in depths:
    circuit, obs = gen_hex_dynamic(
        depth=depth,
        θ=Parameter("θ"),
        hex_rows=hex_rows,
        hex_cols=hex_cols,
        measure=True,
        add_dd=False,
    )
    circuits_dynamic.append(circuit)

    circuit_dd, _ = gen_hex_dynamic(
        depth=depth,
        θ=Parameter("θ"),
        hex_rows=hex_rows,
        hex_cols=hex_cols,
        measure=True,
        add_dd=True,
    )
    circuits_dynamic_dd.append(circuit_dd)
    observables_dynamic.append(obs)
Krok 2: Optymalizacja problemu pod kątem wykonania na sprzęcie
Jesteśmy teraz gotowi do transpilacji obwodu na sprzęt. Przetranspilujemy zarówno standardową implementację unitarną, jak i implementację opartą na obwodach dynamicznych.
Aby dokonać transpilacji na sprzęt, najpierw tworzymy instancję backendu. Jeśli jest dostępny, wybierzemy backend, który obsługuje instrukcję MidCircuitMeasure (measure_2).
service = QiskitRuntimeService()
try:
    backend = service.least_busy(
        operational=True,
        simulator=False,
        use_fractional_gates=True,
        filters=lambda b: "measure_2" in b.supported_instructions,
    )
except QiskitBackendNotFoundError:
    backend = service.least_busy(
        operational=True,
        simulator=False,
        use_fractional_gates=True,
    )
Transpilacja dla obwodów dynamicznych
Najpierw transpilujemy obwody dynamiczne — z sekwencją DD i bez niej. Aby zapewnić spójność wyników, używamy tego samego zestawu fizycznych qubitów we wszystkich obwodach. W tym celu transpilujemy obwód jeden raz, a następnie używamy jego rozkładu dla wszystkich kolejnych obwodów, podając go przez parametr initial_layout w menedżerze przebiegów. Następnie konstruujemy primitive unified blocs (PUBs) jako dane wejściowe dla prymitywu Sampler.
pm_temp = generate_preset_pass_manager(
    optimization_level=3,
    backend=backend,
)
isa_temp = pm_temp.run(circuits_dynamic[-1])
dynamic_layout = isa_temp.layout.initial_index_layout(filter_ancillas=True)

pm = generate_preset_pass_manager(
    optimization_level=3, backend=backend, initial_layout=dynamic_layout
)

dynamic_isa_circuits = [pm.run(circ) for circ in circuits_dynamic]
dynamic_pubs = [(circ, params) for circ in dynamic_isa_circuits]

dynamic_isa_circuits_dd = [pm.run(circ) for circ in circuits_dynamic_dd]
dynamic_pubs_dd = [(circ, params) for circ in dynamic_isa_circuits_dd]
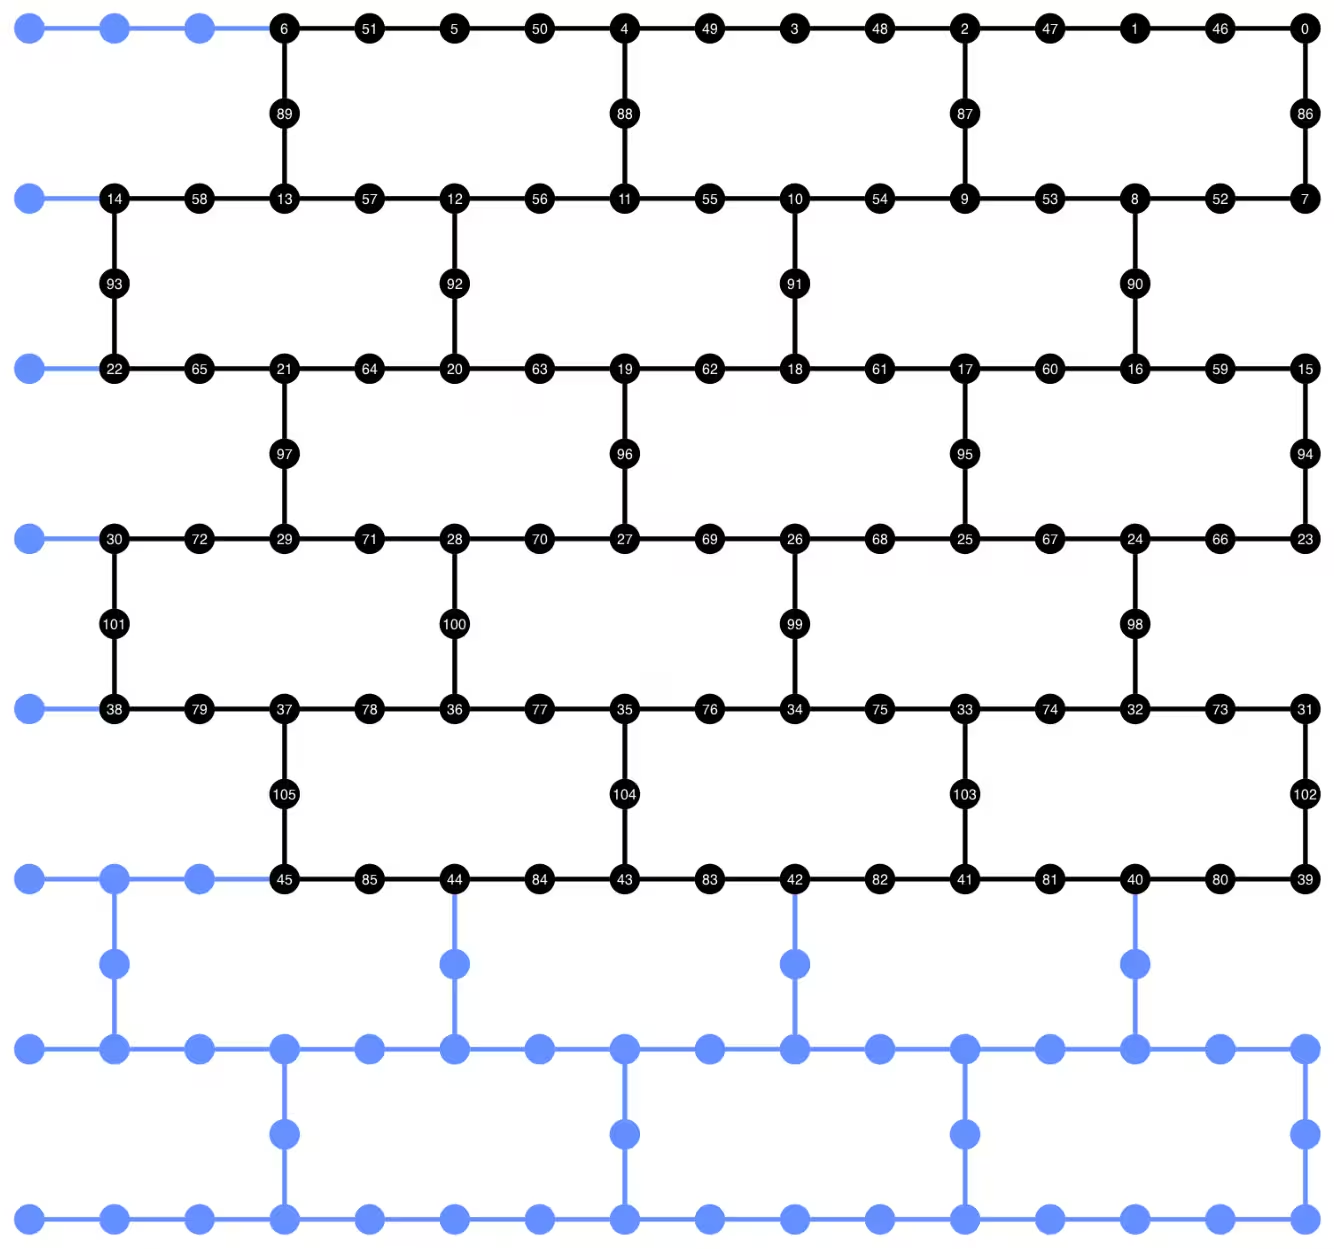
Poniżej możemy zwizualizować rozkład qubitów w przetranspilowanym obwodzie. Czarne kółka oznaczają qubity danych oraz qubity pomocnicze (ancilla) użyte w implementacji z obwodami dynamicznymi.
def _heron_coords_r2():
    cord_map = np.array(
        [
            [
                0,
                1,
                2,
                3,
                4,
                5,
                6,
                7,
                8,
                9,
                10,
                11,
                12,
                13,
                14,
                15,
                3,
                7,
                11,
                15,
                0,
                1,
                2,
                3,
                4,
                5,
                6,
                7,
                8,
                9,
                10,
                11,
                12,
                13,
                14,
                15,
                1,
                5,
                9,
                13,
                0,
                1,
                2,
                3,
                4,
                5,
                6,
                7,
                8,
                9,
                10,
                11,
                12,
                13,
                14,
                15,
                3,
                7,
                11,
                15,
                0,
                1,
                2,
                3,
                4,
                5,
                6,
                7,
                8,
                9,
                10,
                11,
                12,
                13,
                14,
                15,
                1,
                5,
                9,
                13,
                0,
                1,
                2,
                3,
                4,
                5,
                6,
                7,
                8,
                9,
                10,
                11,
                12,
                13,
                14,
                15,
                3,
                7,
                11,
                15,
                0,
                1,
                2,
                3,
                4,
                5,
                6,
                7,
                8,
                9,
                10,
                11,
                12,
                13,
                14,
                15,
                1,
                5,
                9,
                13,
                0,
                1,
                2,
                3,
                4,
                5,
                6,
                7,
                8,
                9,
                10,
                11,
                12,
                13,
                14,
                15,
                3,
                7,
                11,
                15,
                0,
                1,
                2,
                3,
                4,
                5,
                6,
                7,
                8,
                9,
                10,
                11,
                12,
                13,
                14,
                15,
            ],
            -1
            * np.array([j for i in range(15) for j in [i] * [16, 4][i % 2]]),
        ],
        dtype=int,
    )

    hcords = []
    ycords = cord_map[0]
    xcords = cord_map[1]
    for i in range(156):
        hcords.append([xcords[i] + 1, np.abs(ycords[i]) + 1])

    return hcords
plot_circuit_layout(
    dynamic_isa_circuits_dd[8],
    backend,
    qubit_coordinates=_heron_coords_r2(),
    view="virtual",
)
Jeśli pojawią się błędy związane z nieznalezieniem neato w plot_circuit_layout(), upewnij się, że pakiet graphviz jest zainstalowany i dostępny w zmiennej PATH. Jeśli zainstaluje się w niestandardowej lokalizacji (np. przy użyciu homebrew na MacOS), może być konieczna ręczna aktualizacja zmiennej środowiskowej PATH. Można to zrobić wewnątrz tego notebooka w następujący sposób:
import os
os.environ['PATH'] = f"path/to/neato{os.pathsep}{os.environ['PATH']}"
dynamic_isa_circuits[1].draw(fold=-1, output="mpl", idle_wires=False)
dynamic_isa_circuits_dd[1].draw(fold=-1, output="mpl", idle_wires=False)
Transpilacja z użyciem MidCircuitMeasure
MidCircuitMeasure to rozszerzenie dostępnych operacji pomiarowych, skalibrowane specjalnie do wykonywania pomiarów w trakcie obwodu. Instrukcja MidCircuitMeasure mapuje się na instrukcję measure_2 obsługiwaną przez backendy. Należy zauważyć, że measure_2 nie jest obsługiwane przez wszystkie backendy. Możesz użyć service.backends(filters=lambda b: "measure_2" in b.supported_instructions), aby znaleźć backendy, które go obsługują. Poniżej pokazujemy, jak przetranspilować obwód tak, aby pomiary w trakcie jego trwania były wykonywane przy użyciu operacji MidCircuitMeasure, jeśli backend to obsługuje.
Poniżej wyświetlamy czas trwania instrukcji measure_2 oraz standardowej instrukcji measure.
print(
    f'Mid-circuit measurement `measure_2` duration: '
    f"{backend.instruction_durations.get('measure_2',0) * backend.dt * 1e9/1e3} μs"
)
print(
    f'Terminal measurement `measure` duration: '
    f"{backend.instruction_durations.get('measure',0) * backend.dt *1e9/1e3} μs"
)
Mid-circuit measurement `measure_2` duration: 1.3800000000000003 μs
Terminal measurement `measure` duration: 2.1800000000000006 μs
"""Pass that replaces terminal measures in the middle of the circuit with
MidCircuitMeasure instructions."""

class ConvertToMidCircuitMeasure(TransformationPass):
    """This pass replaces terminal measures in the middle of the circuit with
    MidCircuitMeasure instructions.
    """

    def __init__(self, target):
        super().__init__()
        self.target = target

    def run(self, dag):
        """Run the pass on a dag."""
        mid_circ_measure = None
        for inst in self.target.instructions:
            if isinstance(inst[0], Instruction) and inst[0].name.startswith(
                "measure_"
            ):
                mid_circ_measure = inst[0]
                break
        if not mid_circ_measure:
            return dag

        final_measure_nodes = calc_final_ops(dag, {"measure"})
        for node in dag.op_nodes(Measure):
            if node not in final_measure_nodes:
                dag.substitute_node(node, mid_circ_measure, inplace=True)

        return dag

pm = PassManager(ConvertToMidCircuitMeasure(backend.target))

dynamic_isa_circuits_meas2 = [pm.run(circ) for circ in dynamic_isa_circuits]
dynamic_pubs_meas2 = [(circ, params) for circ in dynamic_isa_circuits_meas2]

dynamic_isa_circuits_dd_meas2 = [
    pm.run(circ) for circ in dynamic_isa_circuits_dd
]
dynamic_pubs_dd_meas2 = [
    (circ, params) for circ in dynamic_isa_circuits_dd_meas2
]
Transpilacja dla obwodów unitarnych
Aby zapewnić uczciwe porównanie między obwodami dynamicznymi a ich unitarnym odpowiednikiem, używamy tego samego zestawu fizycznych qubitów co w obwodach dynamicznych (dla qubitów danych) jako rozkładu przy transpilacji obwodów unitarnych.
init_layout = [
    dynamic_layout[ind] for ind in range(circuits_unitary[0].num_qubits)
]

pm = generate_preset_pass_manager(
    target=backend.target,
    initial_layout=init_layout,
    optimization_level=3,
)

def transpile_minimize(circ: QuantumCircuit, pm: PassManager, iterations=10):
    """Transpile circuits for specified number of iterations and return the one
    with smallest two-qubit gate depth"""
    circs = [pm.run(circ) for i in range(iterations)]
    circs_sorted = sorted(
        circs,
        key=lambda x: x.depth(lambda x: x.operation.num_qubits == 2),
    )
    return circs_sorted[0]

unitary_isa_circuits = []
for circ in circuits_unitary:
    circ_t = transpile_minimize(circ, pm, iterations=100)
    unitary_isa_circuits.append(circ_t)

unitary_pubs = [(circ, params) for circ in unitary_isa_circuits]
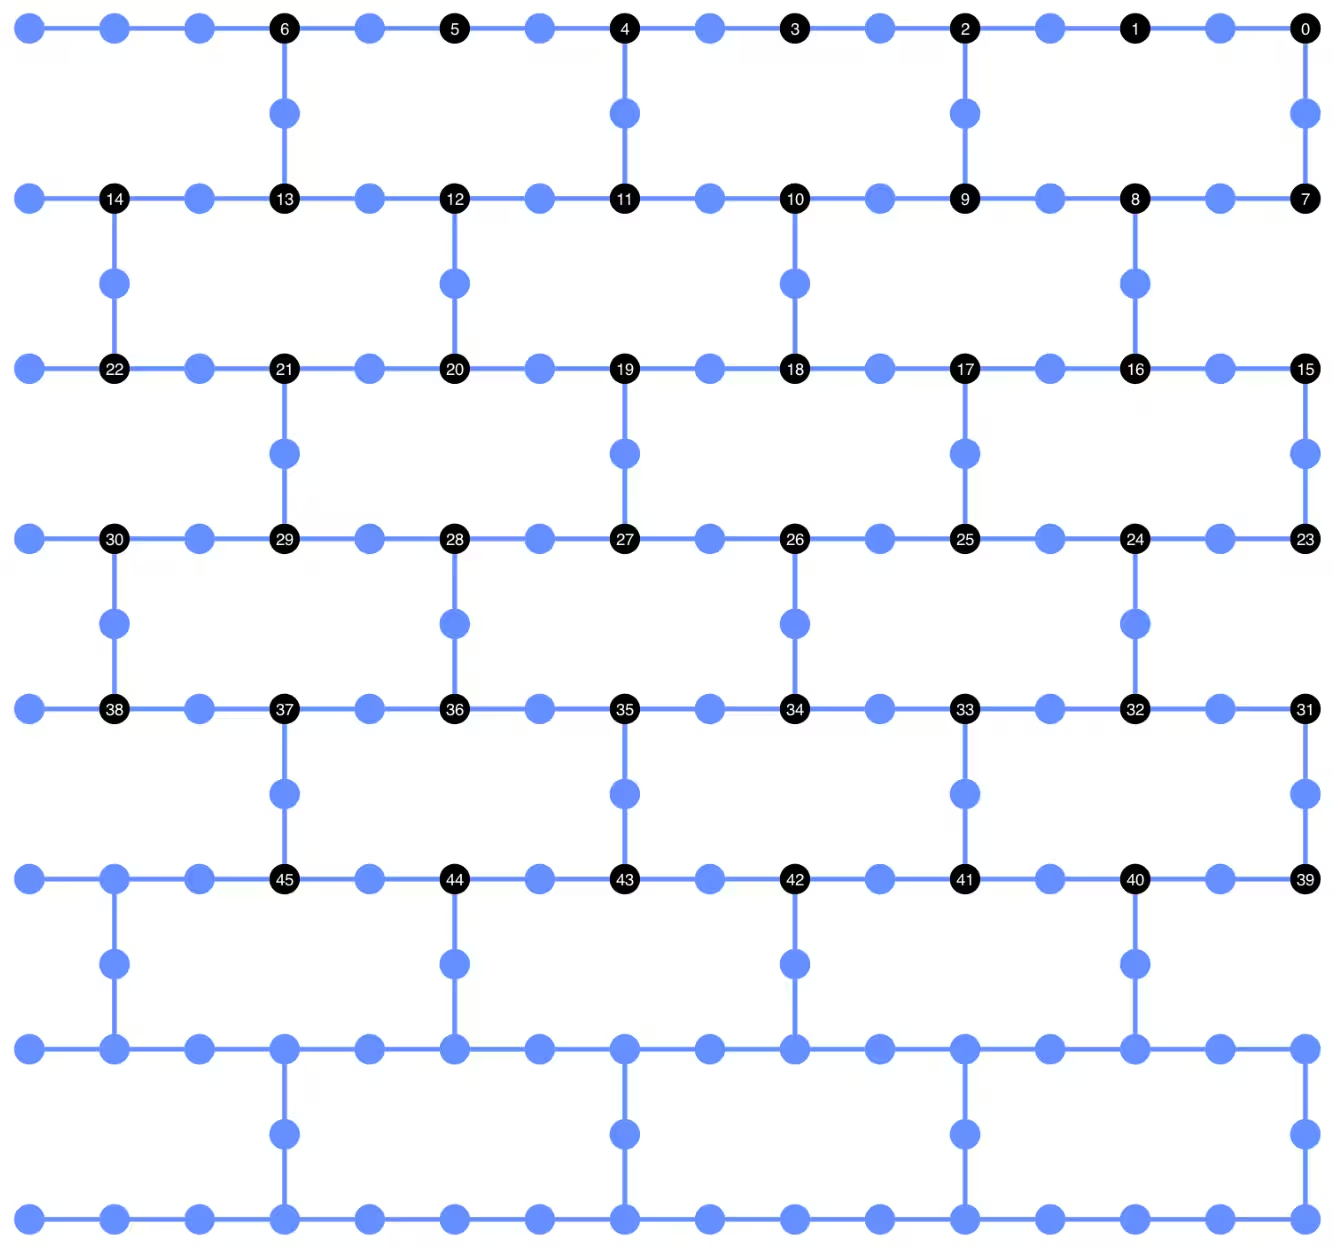
Wizualizujemy rozkład qubitów przetranspilowanych obwodów unitarnych. Czarne kółka wskazują fizyczne qubity użyte do transpilacji obwodów unitarnych, a ich indeksy odpowiadają indeksom wirtualnych qubitów. Porównując to z rozkładem przedstawionym dla obwodów dynamicznych, możemy potwierdzić, że obwody unitarne używają tego samego zestawu fizycznych qubitów co qubity danych w obwodach dynamicznych.
plot_circuit_layout(
    unitary_isa_circuits[-1],
    backend,
    qubit_coordinates=_heron_coords_r2(),
    view="virtual",
)
Teraz dodajemy sekwencję DD do przetranspilowanych obwodów i konstruujemy odpowiadające im PUBs do przesłania zadania.
pm_dd = PassManager(
    [
        ALAPScheduleAnalysis(target=backend.target),
        PadDynamicalDecoupling(
            dd_sequence=[
                XGate(),
                RZGate(np.pi),
                XGate(),
                RZGate(-np.pi),
            ],
            spacing=[1 / 4, 1 / 2, 0, 0, 1 / 4],
            target=backend.target,
        ),
    ]
)

unitary_isa_circuits_dd = pm_dd.run(unitary_isa_circuits)
unitary_pubs_dd = [(circ, params) for circ in unitary_isa_circuits_dd]
Porównanie głębokości dwuqubitowej obwodów unitarnych i dynamicznych
# compare circuit depth of unitary and dynamic circuit implementations
unitary_depth = [
    unitary_isa_circuits[i].depth(lambda x: x.operation.num_qubits == 2)
    for i in range(len(unitary_isa_circuits))
]

dynamic_depth = [
    dynamic_isa_circuits[i].depth(lambda x: x.operation.num_qubits == 2)
    for i in range(len(dynamic_isa_circuits))
]

plt.plot(
    list(range(len(unitary_depth))),
    unitary_depth,
    label="unitary circuits",
    color="#be95ff",
)
plt.plot(
    list(range(len(dynamic_depth))),
    dynamic_depth,
    label="dynamic circuits",
    color="#ff7eb6",
)
plt.xlabel("Trotter steps")
plt.ylabel("Two-qubit depth")
plt.legend()
<matplotlib.legend.Legend at 0x12628b0e0>

Główną zaletą obwodu opartego na pomiarach jest to, że przy implementowaniu wielu oddziaływań ZZ warstwy CX mogą być zrównoleglone, a pomiary mogą odbywać się jednocześnie. Wynika to z faktu, że wszystkie oddziaływania ZZ komutują ze sobą, dzięki czemu obliczenia można wykonać przy głębokości pomiarowej równej 1. Po przetranspilowaniu obwodów obserwujemy, że podejście z dynamicznymi obwodami daje znacznie mniejszą głębokość dwuqubitową niż standardowe podejście unitarne, choć należy pamiętać, że dodatkowe pomiary w trakcie obwodu oraz klasyczne sprzężenie w przód (feedforward) same zajmują czas i wprowadzają własne źródła błędów.
Krok 3: Wykonanie przy użyciu prymitywów Qiskit
Lokalny tryb testowy
Przed wysłaniem zadań na sprzęt możemy przeprowadzić małą symulację testową obwodu dynamicznego przy użyciu lokalnego trybu testowego.
aer_sim = AerSimulator()
pm = generate_preset_pass_manager(backend=aer_sim, optimization_level=1)
circuit_dynamic_test.measure_all()
isa_qc = pm.run(circuit_dynamic_test)
with Batch(backend=aer_sim) as batch:
    sampler = Sampler(mode=batch)
    result = sampler.run([(isa_qc, params)]).result()

print(
    "Simulated average magnetization at trotter step = 1 at three theta values"
)
result[0].data["meas"].expectation_values(obs_dynamic_test[0])
Simulated average magnetization at trotter step = 1 at three theta values
array([ 0.16666667, 0.01529948, -0.14290365])
Symulacja MPS
W przypadku dużych obwodów można użyć symulatora matrix_product_state (MPS), który dostarcza przybliżony wynik wartości oczekiwanej zgodnie z wybranym wymiarem więzów. Wyniki symulacji MPS wykorzystujemy później jako punkt odniesienia do porównania z wynikami ze sprzętu.
# The MPS simulation below took approximately 7 minutes to run on a
# laptop with Apple M1 chip

mps_backend = AerSimulator(
    method="matrix_product_state",
    matrix_product_state_truncation_threshold=1e-5,
    matrix_product_state_max_bond_dimension=100,
)
mps_sampler = Aer_Sampler.from_backend(mps_backend)

shots = 4096

data_sim = []
for j in range(points):
    circ_list = [
        circ.assign_parameters([params[j]]) for circ in circuits_unitary
    ]

    mps_job = mps_sampler.run(circ_list, shots=shots)
    result = mps_job.result()

    point_data = [
        result[d].data["meas"].expectation_values(observables_unitary)
        for d in depths
    ]

    data_sim.append(point_data)  # data at one theta value

data_sim = np.array(data_sim)
Mając przygotowane obwody i obserwable, wykonujemy je teraz na sprzęcie przy użyciu prymitywu Sampler.
Przesyłamy trzy zadania dla unitary_pubs, dynamic_pubs oraz dynamic_pubs_dd. Każde z nich to lista sparametryzowanych obwodów odpowiadających dziewięciu różnym krokom Trottera z trzema różnymi parametrami .
shots = 10000

with Batch(backend=backend) as batch:
    sampler = Sampler(mode=batch)

    sampler.options.experimental = {
        "execution": {
            "scheduler_timing": True
        },  # set to True to retrieve circuit timing info
    }

    job_unitary = sampler.run(unitary_pubs, shots=shots)
    print(f"unitary: {job_unitary.job_id()}")

    job_unitary_dd = sampler.run(unitary_pubs_dd, shots=shots)
    print(f"unitary_dd: {job_unitary_dd.job_id()}")

    job_dynamic = sampler.run(dynamic_pubs, shots=shots)
    print(f"dynamic: {job_dynamic.job_id()}")

    job_dynamic_dd = sampler.run(dynamic_pubs_dd, shots=shots)
    print(f"dynamic_dd: {job_dynamic_dd.job_id()}")

    job_dynamic_meas2 = sampler.run(dynamic_pubs_meas2, shots=shots)
    print(f"dynamic_meas2: {job_dynamic_meas2.job_id()}")

    job_dynamic_dd_meas2 = sampler.run(dynamic_pubs_dd_meas2, shots=shots)
    print(f"dynamic_dd_meas2: {job_dynamic_dd_meas2.job_id()}")
unitary: d96s4b52su3c739hakrg
unitary_dd: d96s4bt2su3c739haksg
dynamic: d96s4c0tcv6s73dk55mg
dynamic_dd: d96s4ckqp3as739qvid0
dynamic_meas2: d96s4csqp3as739qvie0
dynamic_dd_meas2: d96s4daf47jc73a5v8s0
Krok 4: Przetwarzanie końcowe i zwracanie wyników w żądanym formacie klasycznym
Po zakończeniu zadań możemy pobrać czas trwania obwodu z metadanych wyników zadania i zwizualizować informacje o harmonogramie obwodu. Aby dowiedzieć się więcej o wizualizacji informacji o harmonogramowaniu obwodu, zajrzyj na tę stronę.
# Circuit durations is reported in the unit of `dt`
# which can be retrieved from `Backend` object
unitary_durations = [
    job_unitary.result()[i].metadata["compilation"]["scheduler_timing"][
        "circuit_duration"
    ]
    for i in depths
]

dynamic_durations = [
    job_dynamic.result()[i].metadata["compilation"]["scheduler_timing"][
        "circuit_duration"
    ]
    for i in depths
]

dynamic_durations_meas2 = [
    job_dynamic_meas2.result()[i].metadata["compilation"]["scheduler_timing"][
        "circuit_duration"
    ]
    for i in depths
]

result_dd = job_dynamic_dd.result()[1]
circuit_schedule_dd = result_dd.metadata["compilation"]["scheduler_timing"][
    "timing"
]

# to visualize the circuit schedule, one can show the figure below
fig_dd = draw_circuit_schedule_timing(
    circuit_schedule=circuit_schedule_dd,
    included_channels=None,
    filter_readout_channels=False,
    filter_barriers=False,
    width=1000,
)

# Save to a file since the figure is large
fig_dd.write_html("scheduler_timing_dd.html")
Poniżej wykreślamy czasy trwania obwodów unitarnych i dynamicznych. Z wykresu wynika, że pomimo czasu potrzebnego na pomiary w trakcie obwodu i operacje klasyczne, implementacja obwodu dynamicznego z measure_2 daje porównywalne czasy trwania obwodu jak implementacja unitarna.
# visualize circuit durations

def convert_dt_to_microseconds(circ_duration: List, backend_dt: float):
    dt = backend_dt * 1e6  # dt in microseconds
    return list(map(lambda x: x * dt, circ_duration))

dt = backend.target.dt
plt.plot(
    depths,
    convert_dt_to_microseconds(unitary_durations, dt),
    color="#be95ff",
    linestyle=":",
    label="unitary",
)
plt.plot(
    depths,
    convert_dt_to_microseconds(dynamic_durations, dt),
    color="#ff7eb6",
    linestyle="-.",
    label="dynamic",
)
plt.plot(
    depths,
    convert_dt_to_microseconds(dynamic_durations_meas2, dt),
    color="#ff7eb6",
    linestyle="-.",
    marker="s",
    mfc="none",
    label="dynamic w/ meas2",
)

plt.xlabel("Trotter steps")
plt.ylabel(r"Circuit durations in $\mu$s")
plt.legend()
<matplotlib.legend.Legend at 0x12bfde270>

Po zakończeniu zadań pobieramy poniższe dane i obliczamy średnie namagnesowanie oszacowane przez obserwable observables_unitary lub observables_dynamic, które zbudowaliśmy wcześniej.
runs = {
    "unitary": (
        job_unitary,
        [observables_unitary] * len(circuits_unitary),
    ),
    "unitary_dd": (
        job_unitary_dd,
        [observables_unitary] * len(circuits_unitary),
    ),
    # Omitting Dyn w/o DD and Dynamic w/ DD plots for better readability
    # "dynamic": (job_dynamic, observables_dynamic),
    # "dynamic_dd": (job_dynamic_dd, observables_dynamic),
    "dynamic_meas2": (job_dynamic_meas2, observables_dynamic),
    "dynamic_dd_meas2": (
        job_dynamic_dd_meas2,
        observables_dynamic,
    ),
}
data_dict = {}
for key, (job, obs) in runs.items():
    data = []
    for i in range(points):
        data.append(
            [
                job.result()[ind].data["meas"].expectation_values(obs[ind])[i]
                for ind in depths
            ]
        )
    data_dict[key] = data
Poniżej wykreślamy namagnesowanie spinowe w funkcji kroków Trottera dla różnych wartości , odpowiadających różnym natężeniom lokalnego pola magnetycznego. Przedstawiamy zarówno wstępnie obliczone wyniki symulacji MPS dla unitarnych, idealnych obwodów, jak i wyniki eksperymentalne z:
-
uruchamiania obwodów unitarnych z DD
-
uruchamiania obwodów dynamicznych z DD i
MidCircuitMeasure
plt.figure(figsize=(10, 6))

colors = ["#0f62fe", "#be95ff", "#ff7eb6"]
for i in range(points):
    plt.plot(
        depths,
        data_sim[i],
        color=colors[i],
        linestyle="solid",
        label=f"θ={pi_check(i*max_angle/(points-1))} (MPS)",
    )
    # plt.plot(
    #     depths,
    #     data_dict["unitary"][i],
    #     color=colors[i],
    #     linestyle=":",
    #     label=f"θ={pi_check(i*max_angle/(points-1))} (Unitary)",
    # )

    plt.plot(
        depths,
        data_dict["unitary_dd"][i],
        color=colors[i],
        marker="o",
        mfc="none",
        linestyle=":",
        label=f"θ={pi_check(i*max_angle/(points-1))} (Unitary w/DD)",
    )

    # Omitting Dyn w/o DD and Dynamic w/ DD plots for better readability
    # plt.plot(
    #     depths,
    #     data_dict["dynamic"][i],
    #     color=colors[i],
    #     linestyle="-.",
    #     label=f"θ={pi_check(i*max_angle/(points-1))} (Dyn w/o DD)",
    # )
    # plt.plot(
    #     depths,
    #     data_dict["dynamic_dd"][i],
    #     marker="D",
    #     mfc="none",
    #     color=colors[i],
    #     linestyle="-.",
    #     label=f"θ={pi_check(i*max_angle/(points-1))} (Dynamic w/ DD)",
    # )

    # plt.plot(
    #     depths,
    #     data_dict["dynamic_meas2"][i],
    #     color=colors[i],
    #     marker="s",
    #     mfc="none",
    #     linestyle=':',
    #     label=f"θ={pi_check(i*max_angle/(points-1))} (Dynamic w/ MidCircuitMeas)",
    # )

    plt.plot(
        depths,
        data_dict["dynamic_dd_meas2"][i],
        color=colors[i],
        marker="*",
        markersize=8,
        linestyle=":",
        label=f"θ={pi_check(i*max_angle/(points-1))} "
        f"(Dynamic w/ DD & MidCircuitMeas)",
    )

plt.xlabel("Trotter steps", fontsize=16)
plt.ylabel("Average magnetization", fontsize=16)
plt.xticks(rotation=45)
handles, labels = plt.gca().get_legend_handles_labels()
plt.legend(
    handles,
    labels,
    loc="upper right",
    bbox_to_anchor=(1.46, 1.0),
    shadow=True,
    ncol=1,
)
plt.title(
    f"{hex_rows}x{hex_cols} hex ring, {num_qubits} data qubits, "
    f"{len(ancilla)} ancilla qubits \n{backend.name}: Sampler"
)
plt.show()
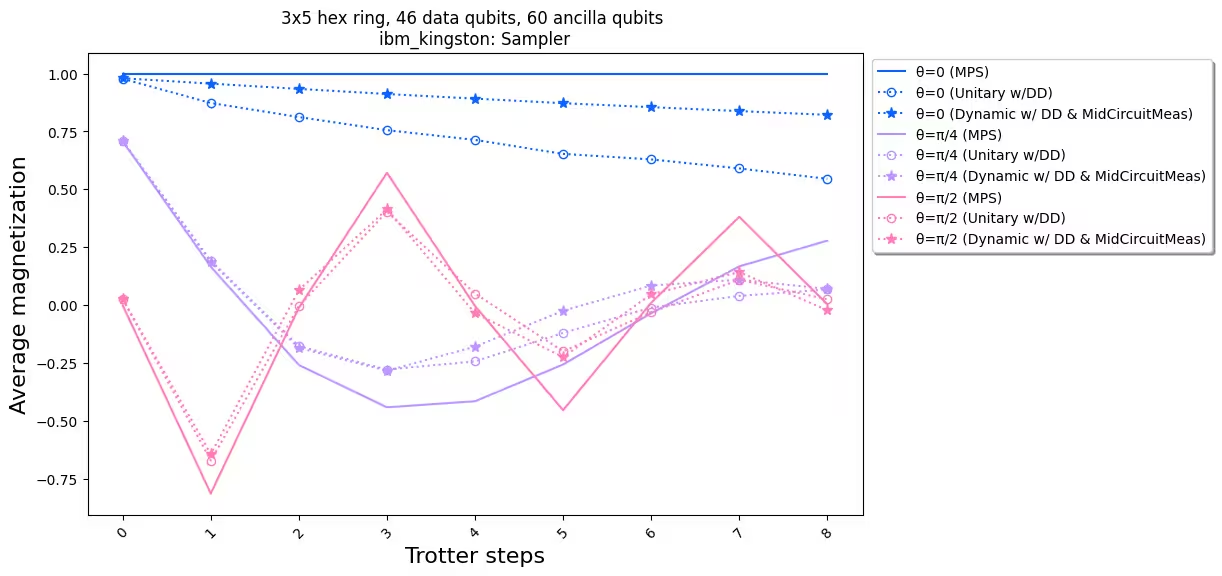
Porównując wyniki eksperymentalne z symulacją, widzimy, że implementacja obwodu dynamicznego (linia kropkowana z gwiazdkami) ogólnie osiąga lepsze wyniki niż standardowa implementacja unitarna (linia kropkowana z kółkami). Podsumowując, przedstawiamy obwody dynamiczne jako rozwiązanie do symulacji modeli spinowych Isinga na sieci plastra miodu — topologii, która nie jest natywna dla sprzętu. Rozwiązanie z obwodami dynamicznymi umożliwia oddziaływania ZZ między qubitami, które nie są najbliższymi sąsiadami, przy krótszej głębokości bramek dwuqubitowych niż przy użyciu bramek SWAP, kosztem wprowadzenia dodatkowych qubitów pomocniczych i operacji klasycznego sprzężenia w przód (feedforward).
Odniesienia
[1] Quantum computing with Qiskit, by Javadi-Abhari, A., Treinish, M., Krsulich, K., Wood, C.J., Lishman, J., Gacon, J., Martiel, S., Nation, P.D., Bishop, L.S., Cross, A.W. and Johnson, B.R., 2024. arXiv preprint arXiv:2405.08810 (2024)