Uczenie zaszumionych stanów kwantowych za pomocą cieni klasycznych
Szacowane użycie: 34 minuty na procesorze Heron r2 (UWAGA: To tylko szacunek. Twój czas działania może się różnić.)
Cele nauki
-
Zbierz losowe pomiary na procesorze kwantowym IBM® z poziomu Julii i zapisz je do późniejszej analizy
-
Sprawdź dane pomiarowe pod kątem wadliwych kubitów i bramek przed uczeniem
-
Dopasuj model operatora iloczynu macierzowego (MPO) zaszumionego stanu do cieni klasycznych
-
Zweryfikuj model na wstrzymanych pomiarach i porównaj go z idealnym obwodem
Wymagania wstępne
-
Cienie klasyczne, wprowadzone w samouczku Tomografia cieniowa stanu Greenbergera-Horne'a-Zeilingera (GHZ)
-
Macierze gęstości i stany mieszane, omówione w Podstawy informacji kwantowej
-
Uruchamianie obwodów z Julii przy użyciu
Qiskit.jliQiskitIBMRuntime.jl, wprowadzone w samouczku Symulacja ewolucji czasowej modelu Isinga w polu poprzecznym
Tło
Na rzeczywistym procesorze kwantowym szum zamienia czysty stan , który obwód ma przygotować, w stan mieszany . Pełna tomografia stanu kwantowego może zrekonstruować , ale liczba potrzebnych pomiarów rośnie wykładniczo wraz z liczbą kubitów. Votto i in. [1] zamiast tego nauczyli się zwartego modelu dla do 96 kubitów z losowych pomiarów. Ten samouczek podąża za ich przepływem pracy.
W pomiarze losowym [2] każdy kubit jest obracany niezależną losową macierzą unitarną , a następnie mierzony w bazie obliczeniowej. Jedno losowanie obrotów nazywa się ustawieniem pomiarowym, a każde ustawienie jest powtarzane przez strzałów. Strzał z wynikowymi bitami daje cień klasyczny [3]
którego średnia po ustawieniach i strzałach wynosi . Samouczek wymagany wcześniej losuje każde z trzech baz Pauliego; ten samouczek, tak jak artykuł, losuje je jednostajnie ze wszystkich jednokubitowych macierzy unitarnych (losowo według miary Haara), a ten sam wzór ma zastosowanie.
Cienie szacują właściwości kilku kubitów naraz. Artykuł łączy je w operator iloczynu macierzowego (MPO), który zapisuje macierz gęstości jako łańcuch małych tensorów, po jednym na kubit; zaszumione stany z korelacjami krótkiego zasięgu potrzebują tylko małych wiązań między sąsiednimi tensorami. Podobnie jak algorytm renormalizacji macierzy gęstości (DMRG), uczący się przechodzi wzdłuż łańcucha i aktualizuje po jednym tensorze, tak aby model zgadzał się z cieniami w oknie kubitów wyśrodkowanym na tym tensorze (równanie 4 w artykule). Wymiar wiązania pozostaje stały podczas tych aktualizacji, więc uczący się nigdy nie obcina modelu. Ponieważ dane wchodzą tylko przez te okna, liczba potrzebnych ustawień nie rośnie wraz z długością łańcucha.
Ustawienia są dzielone na zbiór treningowy i testowy. Na zbiorze testowym artykuł szacuje maksymalną wierność między a modelem ,
Bezpośredni pomiar wymagałby wykładniczo wielu pomiarów. Zamiast tego artykuł zakłada warunek przybliżonej faktoryzacji (AFC): korelacje w zanikają w obrębie kilku kubitów, więc globalne nakładania i czystości rozkładają się na składniki na blokach sąsiednich kubitów. Czystość daje także entropię Rényiego-2 , która mierzy, jak bardzo stan jest mieszany.
Artykuł przygotowuje stan kicked-Ising o głębokości
na 96 kubitach ibm_brisbane, procesora Eagle, z 2048 ustawieniami po 1024 strzały dla . Rysunek 1(c,d) artykułu podaje dwa wyniki dla :
-
Nauczony model osiąga ze stanem eksperymentalnym dla , znacznie powyżej nakładania idealnego stanu z eksperymentem.
-
Entropia rośnie liniowo, , a entropia modelu zgadza się z niezależnym oszacowaniem ze zbioru testowego.
Ten samouczek sprawdza oba wyniki, najpierw w ośmiokubitowej symulacji, w której dokładne odpowiedzi są znane, a następnie w nowym 96-kubitowym uruchomieniu na ibm_fez, procesorze Heron r2. Uczący się to niezależna implementacja w Julii równań z artykułu i jego suplementu.
Wymagania
Ten samouczek wymaga macOS lub Linuksa, ponieważ Qiskit.jl nie obsługuje jeszcze Windowsa (Qiskit.jl issue #15). Potrzebujesz także następujących elementów:
-
Julia 1.11, ze strony pobierania Julii lub za pomocą
juliaup add 1.11, oraz pakietIJulia:julia -e 'using Pkg; Pkg.add("IJulia")' -
Do przykładu sprzętowego konto IBM Quantum® Platform z dostępem do QPU z co najmniej 96 kubitami oraz zapisane dane uwierzytelniające. Bez konta możesz uruchomić przykład sprzętowy na zapisanych pomiarach z uruchomienia
ibm_fez, które dało wyniki w tym samouczku. Pozostałe sekcje działają bez konta.
Notebook używa Qiskit.jl i QiskitIBMRuntime.jl do budowania i uruchamiania obwodów, RandomMeas.jl [4] do losowych pomiarów (dostarcza też ITensors.jl i ITensorMPS.jl) oraz NPZ.jl, JSON.jl i Plots.jl. Ten samouczek został przetestowany z Qiskit.jl 0.6.1, QiskitIBMRuntime.jl 0.3.2 i RandomMeas.jl 0.3.1.
Są dwa sposoby skonfigurowania środowiska:
-
Opcja 1: Zainstaluj najnowsze zgodne wersje pakietów w tymczasowym środowisku. Uruchom poniższą komórkę bez zmian.
-
Opcja 2: Odtwórz dokładnie przetestowane środowisko. Ustaw
download_toml_files = truew poniższej komórce. Komórka pobieraProject.tomliManifest.tomlz repozytorium dokumentacji do folderuenv_tutorial/classical-shadows/obok tego notebooka, a następnie instaluje dokładną wersję każdego pakietu zapisanego w manifeście, w tym zależności pośrednich. Szczegóły znajdziesz w dokumentacji Julii o tych plikach.
using Pkg
using Downloads

download_toml_files = false

if !download_toml_files
    # Option 1: Install the latest compatible versions into a temporary environment
    Pkg.activate(mktempdir(); io=devnull)
    Pkg.add([
        PackageSpec(name="Qiskit", version="0.6"),
        PackageSpec(name="QiskitIBMRuntime", version="0.3"),
        PackageSpec(name="RandomMeas", version="0.3"),
        PackageSpec(name="NPZ"),
        PackageSpec(name="JSON"),
        PackageSpec(name="Plots"),
    ]; io=devnull)
else
    # Option 2: Install the exact tested versions recorded in Project.toml and Manifest.toml
    base_url = "https://raw.githubusercontent.com/Qiskit/documentation/main/docs/tutorials/assets/classical-shadows/julia"
    env_dir = joinpath(@__DIR__, "env_tutorial", "classical-shadows")
    mkpath(env_dir)
    for file in ("Project.toml", "Manifest.toml")
        Downloads.download("$base_url/$file", joinpath(env_dir, file))
    end
    Pkg.activate(env_dir; io=devnull)
    Pkg.instantiate(; io=devnull)
end
Konfiguracja
using RandomMeas  # also loads ITensors and ITensorMPS
using Qiskit, QiskitIBMRuntime
using Random, LinearAlgebra, Statistics
using Downloads, SHA, NPZ, JSON, Plots

# Download the helper module that implements the learner, unless a copy exists
docs_url = "https://raw.githubusercontent.com/Qiskit/documentation/main"
helper_file = joinpath(@__DIR__, "env_tutorial", "classical-shadows", "mpo_learning.jl")
if !isfile(helper_file)
    mkpath(dirname(helper_file))
    helper_url = "$docs_url/docs/tutorials/assets/classical-shadows/julia/mpo_learning.jl"
    Downloads.download(helper_url, helper_file)
end
include(helper_file)
using .ShadowMPOLearning
BLAS.set_num_threads(1)  # the learner multiplies many small matrices
Moduł pomocniczy mpo_learning.jl, który pobiera komórka konfiguracji, implementuje uczącego się. Samouczek wywołuje z niego następujące funkcje:
| Funkcja | Cel |
|---|---|
kicked_ising_reference(N, D; depolarization) | Dokładne MPO idealnego stanu kicked-Ising lub stanu po lokalnym szumie depolaryzującym |
split_settings(group; seed, train_fraction) | Losowe przypisanie ustawień pomiarowych do zbiorów treningowego i testowego (domyślnie po połowie) |
training_marginals(train; ell, prior) | Szacunki cieni dla każdego okna uczenia, tylko z ustawień treningowych |
fitted_prior(ideal, train) | Prior dla wspólnych pomiarów losowych (CRM), dopasowany do zmierzonej czystości każdego okna, jak w artykule |
learn_mpo(marginals, N; ell, maxbond, sweeps) | Przeprowadź aktualizację jednego węzła z artykułu wzdłuż łańcucha, zaczynając od stanu maksymalnie zmieszanego |
max_fidelity(a, b), mpo_overlap(a, b) | Dokładne i między dwoma MPO |
afc_estimate, afc_statistics, afc_prefix_curve | Szacunki AFC i ze zbioru testowego, z słupkami błędów jackknife |
Uczący się przechowuje MPO w bazie Pauliego. Dzięki temu model pozostaje hermitowski ze śladem jednostkowym, ale nie wymusza to dodatniej półokreśloności modelu, więc notebook raportuje, jak ujemne stają się jego wartości własne.
Przykład w małej skali na symulatorze
Zacznij od układu na tyle małego, że można wszystko obliczyć dokładnie: stan kicked-Ising o głębokości jeden na ośmiu kubitach, z 12% lokalnym szumem depolaryzującym modelującym sprzęt. Ponieważ zaszumiony stan jest znany, możesz bezpośrednio porównać z nim nauczony model.
Krok 1: Odwzoruj klasyczne dane wejściowe na problem kwantowy
Funkcja kicked_ising_reference zwraca dokładny stan jako MPO. Dla depolarization=0.12 wektor Blocha każdego kubitu kurczy się po obwodzie o 12%.
N = 8
ideal = kicked_ising_reference(N, 1)
rho = kicked_ising_reference(N, 1; depolarization=0.12)
println("Purity of the noisy state: ", round(mpo_overlap(rho, rho), digits=3))
println("F_max between the noisy and ideal states: ", round(max_fidelity(rho, ideal), digits=3))
Purity of the noisy state: 0.327
F_max between the noisy and ideal states: 0.56
Krok 2: Zoptymalizuj problem do wykonania na sprzęcie kwantowym
Ten przykład próbkuje wyniki pomiarów klasycznie, więc nie ma obwodu do transpilacji. Ten krok omawia przykład sprzętowy.
Krok 3: Wykonaj za pomocą prymitywów Qiskit
Użyj RandomMeas.jl, aby wylosować 2048 ustawień pomiarowych losowych według miary Haara i pobrać po 256 strzałów z każdego, a następnie podziel ustawienia po równo na zbiory treningowy i testowy. Dziel według ustawienia, a nie według strzału: strzały z tego samego ustawienia dzielą jego obroty, więc nie są niezależne.
Random.seed!(20260921)
sites = siteinds("Qubit", N)
settings = [LocalUnitaryMeasurementSetting(N; site_indices=sites, ensemble=Haar) for _ in 1:2048]
measurements = MeasurementGroup(to_itensor_mpo(rho, sites), settings, 256)
split = split_settings(measurements; seed=20260921)
println(length(split.train_ids), " training settings, ", length(split.test_ids), " testing settings")
1024 training settings,
1024 testing settings
Krok 4: Przetwórz wyniki i zwróć je w wybranym formacie klasycznym
Naucz model z parametrami z artykułu dla głębokości jeden: okna rozciągające się na kubity po każdej stronie aktualizowanego tensora, wymiar wiązania 4 i 20 przejść, zaczynając od stanu maksymalnie zmieszanego. Pierwsze przejście aktualizuje sąsiednie pary tensorów, co pozwala wymiarowi wiązania wzrosnąć z 1 do 4; każde kolejne przejście aktualizuje po jednym tensorze przy tym stałym wymiarze wiązania.
Aby zmniejszyć szum statystyczny cieni, artykuł używa wspólnych pomiarów losowych (CRM) [5]. Dla każdego ustawienia odejmuje średni cień, jaki wstępne przypuszczenie stanu wytworzyłoby w tym samym ustawieniu, a następnie dodaje z powrotem dokładną wartość priora. Korekta uśrednia się do zera, więc prior zmienia wielkość błędu statystycznego, ale nie to, co jest szacowane. Tutaj priorem jest stan idealny z 10% lokalną depolaryzacją, bliski prawdziwym 12%. Na sprzęcie poziom szumu jest nieznany, więc przykład sprzętowy dopasowuje prior do zmierzonych czystości, tak jak w artykule.
prior = kicked_ising_reference(N, 1; depolarization=0.10)
marginals = training_marginals(split.train; ell=2, prior)
fit = learn_mpo(marginals, N; ell=2, maxbond=4, sweeps=20)
sigma = fit.model
plot([h.sweep for h in fit.history], [h.local_loss for h in fit.history];
    xlabel="sweep", ylabel="mean squared residual", label="training windows",
    size=(680, 320), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
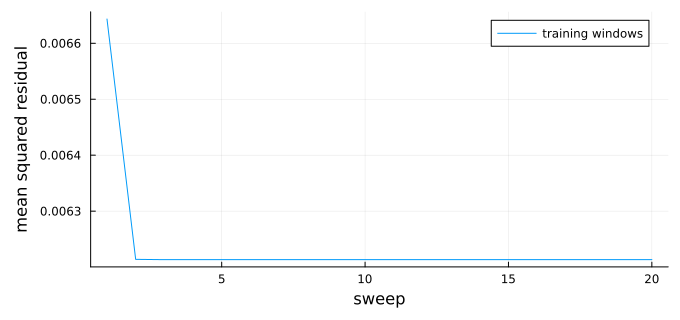
Residuum mierzy, jak daleko okna modelu są od cieni treningowych. Spada, gdy zaczynają się aktualizacje jednego węzła, w drugim przejściu, a następnie pozostaje w przybliżeniu stałe zamiast osiągać zero, ponieważ cienie zawierają szum statystyczny, którego model o małym wymiarze wiązania nie potrafi odtworzyć.
Ponieważ ten stan jest znany, możesz dokładnie porównać z nim nauczony model, a także porównać z nim dwa najprostsze przypuszczenia: prior CRM i stan idealny.
eigenvalues = eigvals(Hermitian(dense_operator(sigma)))
println("F_max with the noisy state")
println("  learned model: ", round(max_fidelity(rho, sigma), digits=3))
println("  CRM prior:     ", round(max_fidelity(rho, prior), digits=3))
println("  ideal state:   ", round(max_fidelity(rho, ideal), digits=3))
println("Most negative eigenvalue of the model: ", round(minimum(eigenvalues), digits=4))
println("Total negative eigenvalue weight:      ", round(-sum(min.(eigenvalues, 0)), digits=4))
F_max with the noisy state
learned model: 0.993
  CRM prior:     0.911
  ideal state:   0.56
Most negative eigenvalue of the model: -0.0076
Total negative eigenvalue weight:      0.0348
Nauczony model jest bliższy zaszumionemu stanowi niż prior czy stan idealny, więc nauczył się szumu z danych. Jego małe ujemne wartości własne wynikają ze skończonej liczby pomiarów.
Na sprzęcie stan jest nieznany, więc zamiast tego szacujesz na podstawie ustawień testowych. AFC dzieli łańcuch na bloki po kubitów i przybliża czystość przez
a tym samym ilorazem lokalnych nakładań. Dla dwa bloki obejmują wszystkie osiem kubitów i wzór jest dokładny; dla opiera się na założeniu faktoryzacji. Słupki błędów jackknife, które pomijają po jednym ustawieniu testowym, obejmują tylko błąd statystyczny danych testowych, a nie losowość treningu ani przybliżenie AFC.
for k in (2, 4)
    estimate = afc_estimate(sigma, split.test; k, statistics=afc_statistics(split.test, k; prior))
    println("k = $k: held-out F_max = ", round(estimate.fidelity, digits=3), " ± ",
        round(estimate.fidelity_sem, digits=3))
end
println("Exact F_max:              ", round(max_fidelity(rho, sigma), digits=3))
k = 2: held-out F_max = 0.966
± 0.036
k = 4: held-out F_max =
0.958 ± 0.049
Exact F_max:              0.993
Oba oszacowania na wstrzymanych danych zgadzają się z dokładną wartością w granicach swoich słupków błędów.
Przykład sprzętowy w dużej skali
Teraz uruchom eksperyment na 96-kubitowym łańcuchu ibm_fez, procesora Heron r2. Podobnie jak ibm_brisbane ma on mapę połączeń heavy-hex i podobny poziom szumu.
Zebranie danych wymaga 1024 zadań Sampler i około 34 minut czasu QPU. Jeśli nie masz dostępu do QPU z co najmniej 96 kubitami albo kolejka jest długa, uruchom przykład sprzętowy na podstawie pomiarów zarejestrowanych na ibm_fez 27 września 2026 r., które dały wyniki pokazane w tym samouczku. Przy use_saved_data = true notebook pobiera te pomiary (15 MB) z Zenodo [6] w kroku 1 i pomija wysyłanie zadań w kroku 3. Aby zebrać własne dane, ustaw tę wartość na false.
use_saved_data = true; # set to false to collect new measurements on hardware
Krok 1: Odwzoruj klasyczne dane wejściowe na problem kwantowy
Każde ustawienie wymaga jednego obwodu: obwodu kicked-Ising, bramki na każdym kubicie dla oraz pomiaru każdego kubitu. Losowanie , gdzie , i mają rozkład jednostajny w , sprawia, że jest losowa według miary Haara. Funkcja u3_matrix zwraca macierz , której używa krok 4.
Budżet to 1024 ustawienia po 1024 strzały (shots), czyli połowa liczby ustawień z artykułu, podzielone po równo między trening i testowanie. Przy zapisanych danych komórka wczytuje zarejestrowane kąty. W przeciwnym razie losuje nowe kąty i zapisuje je, zanim cokolwiek wyślesz, ponieważ bez nich nie da się analizować wyników. Jeśli plik już istnieje, komórka go wczytuje, dzięki czemu po ponownym uruchomieniu sesji kąty nadal odpowiadają zapisanym wynikom.
"Matrix of the U(θ, ϕ, λ) gate, as used by `qc.u` in Qiskit."
u3_matrix(θ, ϕ, λ) = [cos(θ/2)              -exp(im*λ)*sin(θ/2);
                      exp(im*ϕ)*sin(θ/2)    exp(im*(ϕ + λ))*cos(θ/2)]

"Angles (θ, ϕ, λ) for which `u3_matrix(θ, ϕ, λ)` is a Haar-random unitary."
random_u3_angles() = (2asin(sqrt(rand())), 2π*rand(), 2π*rand())

N_hw, NU_hw, NM_hw = 96, 1024, 1024
data_directory = joinpath(@__DIR__, "classical-shadows-data")
saved_file = joinpath(data_directory, "ibm-fez-run.npz")
run_directory = joinpath(data_directory, "new-run")
settings_file = joinpath(run_directory, "settings.npz")
if use_saved_data
    saved_url = "https://zenodo.org/records/24116174/files/ibm-fez-run.npz?download=1"
    saved_sha256 = "c42f4d8d42e5083e9e152b4fec0846884ebe3be003e5ab528deebf4f00c9fe50"
    if !isfile(saved_file)
        mkpath(data_directory)
        println("Downloading the saved ibm_fez run (15 MB)...")
        Downloads.download(saved_url, saved_file * ".part")
        mv(saved_file * ".part", saved_file)
    end
    bytes2hex(open(sha256, saved_file)) == saved_sha256 ||
        error("$saved_file is incomplete or corrupted; delete it and run this cell again")
    saved_run = npzread(saved_file)
    angles = saved_run["angles"]
elseif isfile(settings_file)
    angles = npzread(settings_file)["angles"]
else
    mkpath(joinpath(run_directory, "outcomes"))
    Random.seed!(20260927)
    angles = Array{Float64}(undef, NU_hw, N_hw, 3)
    for r in 1:NU_hw, i in 1:N_hw
        angles[r, i, :] .= random_u3_angles()
    end
    npzwrite(settings_file, Dict("angles" => angles))
end
println("Measurement settings: ", size(angles, 1), " × ", size(angles, 2), " qubits")
Measurement settings: 1024
× 96 qubits
Krok 2: Zoptymalizuj problem pod kątem wykonania na sprzęcie kwantowym
Łańcuch jest tak dobry, jak jego najgorszy kubit, więc 96 fizycznych kubitów wybierz samodzielnie. Funkcja transpile z Qiskit.jl nie potrafi jeszcze przyjąć ustalonego początkowego układu (layout), a w teście na ibm_phoenix wybrany przez nią układ zawierał kubit z 51% błędem odczytu. Poniższy łańcuch to 96-kubitowa ścieżka w mapie połączeń ibm_fez, którą wybrał uwzględniający błędy układ funkcji transpile z Pythonowego Qiskit (z optimization_level=3) na podstawie danych kalibracyjnych z 27 września 2026 r. Jego średni błąd odczytu wynosi 1,6%, ale sieć heavy-hex ma niewiele 96-kubitowych ścieżek, a ta zawiera kubit 35 z 15% błędem odczytu. Kalibracje się zmieniają, więc przed uruchomieniem w innym dniu lub na innym QPU wybierz nowy łańcuch z aktualnych danych kalibracyjnych.
Aby zachować ten łańcuch, zapisz obwody bezpośrednio w bramkach natywnych zamiast je transpilować. Bramka jest równa z dokładnością do globalnej fazy. Ten rozkład obejmuje zarówno losowe obroty, jak i uderzenie (kick) . Bramka jest równa bramce CZ, po której następuje na obu kubitach, z dokładnością do globalnej fazy. Ponieważ te bramki są diagonalne, komutują z bramkami CZ, więc każdy kubit zbiera jedną bramkę na wiązanie przed swoim obrotem pomiarowym.
num_device_qubits = 156
# Physical qubits of ibm_fez, in IBM numbering, forming the chain
chain_physical = [
    2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 19, 35, 34, 33, 39, 53, 54, 55, 59, 75, 74,
    73, 79, 93, 94, 95, 99, 115, 114, 113, 119, 133, 132, 131, 130, 129, 128, 127, 137, 147, 146,
    145, 144, 143, 136, 123, 124, 125, 117, 105, 106, 107, 108, 109, 110, 111, 98, 91, 90, 89,
    88, 87, 86, 85, 77, 65, 66, 67, 68, 69, 70, 71, 58, 51, 50, 49, 48, 47, 46, 45, 37, 25, 24,
    23, 22, 21, 36, 41, 42, 43, 56, 63]
chain = chain_physical .+ 1  # Qiskit.jl numbers qubits from 1

"Apply U(θ, ϕ, λ) to qubit q with native gates: rz(λ), sx, rz(θ + π), sx, rz(ϕ + π)."
function native_u!(qc, q, θ, ϕ, λ)
    qc.rz(λ, q)
    qc.sx(q)
    qc.rz(θ + π, q)
    qc.sx(q)
    qc.rz(ϕ + π, q)
end

"Kicked-Ising circuit on `chain`, then the rotations of one setting and a measurement."
function native_setting_circuit(chain, angles, num_device_qubits)
    n = length(chain)
    qc = QuantumCircuit(num_device_qubits, n)
    for q in chain
        native_u!(qc, q, π/4, -π/2, π/2)       # e^{-iπ/8 X}
    end
    for i in 1:n-1
        qc.cz(chain[i], chain[i + 1])          # e^{iπ/4 ZZ}, up to the S† gates below
    end
    for (i, q) in enumerate(chain)
        bonds = (i > 1) + (i < n)
        qc.rz(-π/2 * bonds, q)                 # one S† per bond
        native_u!(qc, q, angles[i, 1], angles[i, 2], angles[i, 3])
        qc.measure(q, i)                       # outcome of chain qubit i goes to bit i
    end
    qc
end

circuits = [native_setting_circuit(chain, angles[r, :, :], num_device_qubits) for r in 1:NU_hw]
println(length(circuits), " circuits, each with ", count(inst -> inst.name == "cz", circuits[1].data), " CZ gates")
1024 circuits, each with
95 CZ gates
Krok 3: Wykonaj za pomocą prymitywów Qiskit
QiskitIBMRuntime.jl uruchamia jeden obwód na zadanie Sampler, więc zebranie danych wymaga 1024 zadań. Poniższa komórka utrzymuje w kolejce do 32 zadań i zapisuje wyniki każdego ustawienia zaraz po zakończeniu jego zadania. Każdy strzał (shot) jest zwracany jako wektor bitów, w którym element jest wynikiem kubitu łańcucha.
Wyniki musisz pobrać w tej samej sesji, która wysłała zadania, ponieważ QiskitIBMRuntime.jl nie potrafi jeszcze wyszukać zadania po jego ID (qiskit-ibm-runtime-c issue #28). Jeśli zadanie się nie powiedzie, komórka wyświetla ostrzeżenie i kontynuuje. Jeśli sesja się zatrzyma, uruchom kroki od 1 do 3 ponownie. Ponowne uruchomienie komórki wysyła tylko te ustawienia, których wyników brakuje. Przy use_saved_data = true komórka niczego nie wysyła.
outcome_file(r) = joinpath(run_directory, "outcomes", "setting_$(lpad(r, 4, '0')).npz")

"Save the outcomes of setting `r` as a (shots × N) matrix of 0/1 values."
function save_outcomes(r, job)
    try
        samples = get_sampler_job_results(job, service)
        bits = UInt8.(permutedims(reduce(hcat, samples)))
        npzwrite(outcome_file(r), Dict("bits" => bits))
    catch err
        @warn "Setting $r failed and was not saved; run this cell again to resubmit it" err
    end
end

if use_saved_data
    println("Using the saved ibm_fez measurements; no jobs submitted")
else
    backend_name = "ibm_fez"
    service = Service()  # uses the credentials saved on this computer
    backend = only(b for b in backend_search(service) if b.name == backend_name)
    open(joinpath(run_directory, "metadata.json"), "w") do io
        JSON.print(io, Dict("backend" => backend_name, "N" => N_hw, "depth" => 1, "settings" => NU_hw,
                            "shots" => NM_hw, "chain" => chain_physical), 2)
    end
    in_flight = []
    for r in 1:NU_hw
        isfile(outcome_file(r)) && continue
        push!(in_flight, (r, run_sampler_job(service, backend, circuits[r], NM_hw)))
        length(in_flight) >= 32 && save_outcomes(popfirst!(in_flight)...)
    end
    foreach(job -> save_outcomes(job...), in_flight)
    println("Saved outcomes: ", count(r -> isfile(outcome_file(r)), 1:NU_hw), " of ", NU_hw, " settings")
end
Using the saved ibm_fez measurements; no jobs submitted
Krok 4: Przetwórz wyniki i zwróć rezultat w wybranym formacie klasycznym
Ten krok odczytuje wyłącznie zapisane dane: pobrane uruchomienie ibm_fez, jeśli use_saved_data ma wartość true, lub w przeciwnym razie pliki zapisane w kroku 3. Możesz więc uruchomić go w nowej sesji bez wysyłania zadań (najpierw uruchom komórkę Setup, komórkę use_saved_data i krok 1). Pobrany plik przechowuje 96 wyników każdego strzału spakowanych w 12 bajtów, od najbardziej znaczącego bitu, więc ładowarka je rozpakowuje. RandomMeas.jl oznacza wyniki jako 1 i 2, więc ładowarka dodaje też 1 do każdego bitu.
"Build a `MeasurementGroup` from the angles and a function `outcomes(r)` that returns
the (shots × N) 0/1 outcomes of setting `r`."
function measurement_group(angles, outcomes)
    settings_count, n = size(angles, 1), size(angles, 2)
    sites = siteinds("Qubit", n)
    data = map(1:settings_count) do r
        rotations = Array{ComplexF64}(undef, n, 2, 2)
        for i in 1:n
            rotations[i, :, :] = u3_matrix(angles[r, i, :]...)
        end
        MeasurementData(Int.(outcomes(r)) .+ 1;
            measurement_setting=LocalUnitaryMeasurementSetting(rotations; site_indices=sites))
    end
    MeasurementGroup(data)
end

if use_saved_data
    packed = saved_run["outcomes"]  # settings × shots × 12 bytes
    # Bit i of a shot is in byte (i - 1) ÷ 8 + 1, most significant bit first
    unpack(r) = [(packed[r, s, (i - 1) ÷ 8 + 1] >> (7 - (i - 1) % 8)) & 0x01
                 for s in 1:size(packed, 2), i in 1:N_hw]
    group_hw = measurement_group(angles, unpack)
else
    group_hw = measurement_group(angles, r -> npzread(outcome_file(r))["bits"])
end
println(group_hw.NU, " settings × ", group_hw.NM, " shots on ", group_hw.N, " qubits")
1024 settings ×
1024 shots on 96 qubits
Przed uczeniem sprawdź dane. Zepsuty kubit lub źle skalibrowana bramka sprawia, że zmierzony stan wokół niego jest znacznie bardziej zmieszany i może powodować rozbieżność uczenia. Czystość kilku sąsiednich kubitów jest niezależnym od modelu testem porównawczym tego szumu: funkcja get_purity z RandomMeas.jl szacuje dla podukładu , porównując pary strzałów z tego samego ustawienia. Oblicz entropię Rényiego-2 każdego okna sześciu sąsiednich kubitów i porównaj ją z tym samym oknem stanu idealnego. Wartość idealna nie jest zerem, ponieważ każde okno jest splątane z resztą łańcucha; szum ją zwiększa, a zepsuty kubit przesuwa każde okno, które go zawiera, w stronę maksimum równego sześć.
ideal_hw = kicked_ising_reference(N_hw, 1)
width = 6
starts = 1:N_hw - width + 1
window_entropy(rho, w) = -log2(mpo_overlap(segment_mpo(rho, w), segment_mpo(rho, w)))
measured_entropy = [-log2(get_purity(group_hw, collect(j:j + width - 1))) for j in starts]
ideal_entropy = [window_entropy(ideal_hw, j:j + width - 1) for j in starts]
worst = argmax(measured_entropy)
println("S₂ of six-qubit windows: median ", round(median(measured_entropy), digits=2), "; highest ",
    round(measured_entropy[worst], digits=2), " (chain positions ", worst, " to ", worst + width - 1, ")")
println("Ideal state: ", round(minimum(ideal_entropy), digits=2), " to ", round(maximum(ideal_entropy), digits=2))
plot(starts, measured_entropy; marker=:circle, markersize=2, label="measured",
    xlabel="first chain position of the window", ylabel="S₂ of six qubits", ylims=(0, width),
    legend=:topright, size=(800, 280), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
plot!(starts, ideal_entropy; linestyle=:dash, label="ideal state")
S₂ of six-qubit windows: median 0.9
; highest 1.43 (chain positions 30 to 35)
Ideal state: 0.19 to 0.39
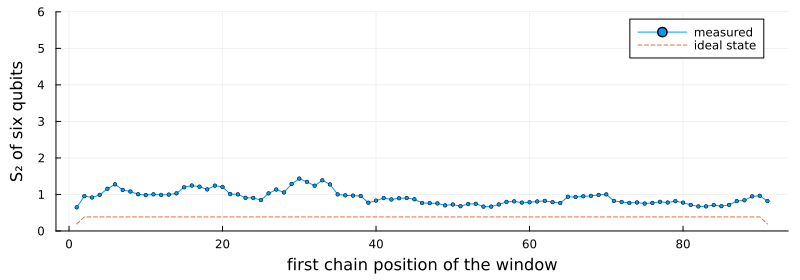
Każde okno jest bardziej zmieszane niż stan idealny, o około pół do jednego bitu, a najbardziej zaszumiony odcinek to okolice pozycji łańcucha od 30 do 35. Żadne okno nie zbliża się do maksimum równego sześć, więc żaden kubit nie jest zepsuty, a analiza wykorzystuje cały 96-kubitowy łańcuch. Gdyby niektóre okna miały entropię bliską sześciu, usunąłbyś kubit wspólny dla tych okien i uczył się najdłuższej części łańcucha bez niego.
Te same czystości wyznaczają priorytet CRM. Dla każdego okna fitted_prior bierze stan idealny i dopasowuje lokalną siłę depolaryzacji tak, aby jego czystość odpowiadała czystości zmierzonej w ustawieniach treningowych, tak jak w artykule.
Funkcja learn_and_validate w poniższej komórce wykonuje resztę analizy. Uczy model na ustawieniach treningowych, a następnie szacuje i na ustawieniach testowych dla pierwszych kubitów łańcucha, w krokach co 12. Są to wielkości z rysunku 1(c,d) w artykule. Stan idealny jest oceniany na tych samych danych testowych jako punkt odniesienia.
Komórka uruchamia funkcję z , a następnie powtarza ją z i , aby sprawdzić, jak bardzo rozmiar okien uczenia ma znaczenie. Wymiar wiązania może wynosić co najwyżej , więc uczy stanu produktowego: każdy kubit osobno, bez korelacji między kubitami.
function learn_and_validate(group; ideal, ell=2, k=3, sizes=12:12:group.N, seed=20260921, train_fraction=0.5)
    split = split_settings(group; seed, train_fraction)
    prior = fitted_prior(ideal, split.train)
    marginals = training_marginals(split.train; ell, prior)
    fit = learn_mpo(marginals, group.N; ell, maxbond=min(4, 4^ell), sweeps=20)
    last(fit.history).purity <= 1 ||
        @warn "The model has purity above one, so the fit diverged. Collect more settings or shots."
    statistics = afc_statistics(split.test, k; prior)
    learned = afc_prefix_curve(fit.model, statistics, split.test.NU; k, sizes)
    baseline = afc_prefix_curve(ideal, statistics, split.test.NU; k, sizes)
    model_entropy = [-log2(mpo_overlap(prefix_mpo(fit.model, n), prefix_mpo(fit.model, n))) for n in sizes]
    (; ell, fit, split, learned, baseline, model_entropy)
end

function plot_validation(results, title)
    n = [r.n for r in first(results).learned]
    # Marker, size, and line style per ℓ. The ℓ = 1 squares are small enough to sit inside the
    # ℓ = 2 circles, so both stay visible where the two curves overlap.
    style = Dict(2 => (:circle, 7, :solid), 1 => (:rect, 3.5, :dash), 0 => (:utriangle, 5, :dot))
    fidelity = plot(yscale=:log10, ylims=(1e-6, 1.5), legend=:bottomleft, xlabel="number of qubits N",
        ylabel="held-out F_max", title=title)
    entropy = plot(xlabel="number of qubits N", ylabel="Rényi-2 entropy S₂", legend=:topleft)
    held_out = first(results).learned
    # Draw every error bar before any marker, so the bars stay behind the symbols
    for (color, result) in enumerate(results)
        scatter!(fidelity, n, [r.fidelity for r in result.learned]; yerror=[r.fidelity_sem for r in result.learned],
            markersize=0, markerstrokecolor=color, label="")
    end
    scatter!(entropy, n, [r.entropy for r in held_out]; yerror=[r.entropy_sem for r in held_out],
        markersize=0, markerstrokecolor=:black, label="")
    for (color, result) in enumerate(results)
        marker, markersize, linestyle = style[result.ell]
        label = "learned model, ℓ = $(result.ell)"
        plot!(fidelity, n, [r.fidelity for r in result.learned]; color, marker, markersize, linestyle,
            markerstrokewidth=0, label)
        plot!(entropy, n, result.model_entropy; color, linestyle, linewidth=2, label)
    end
    plot!(fidelity, n, [r.fidelity for r in first(results).baseline]; marker=:diamond, markersize=5,
        linestyle=:dashdot, color=:black, label="ideal state")
    scatter!(entropy, n, [r.entropy for r in held_out]; marker=:circle, markersize=4, color=:black,
        label="held-out AFC estimate")
    plot(fidelity, entropy; layout=(1, 2), size=(1000, 400), left_margin=7Plots.mm, bottom_margin=7Plots.mm)
end

function summarize(result)
    final = last(result.learned)
    println("ℓ = ", result.ell, ", N = ", final.n, ": held-out F_max = ", round(final.fidelity, sigdigits=3), " ± ",
        round(final.fidelity_sem, sigdigits=2), " (ideal state: ", round(last(result.baseline).fidelity, sigdigits=2), ")")
    println("  S₂ = ", round(final.entropy, digits=2), " ± ", round(final.entropy_sem, digits=2),
        " held out; ", round(last(result.model_entropy), digits=2), " from the model")
    lowest = minimum(minimum(eigvals(Hermitian(operator_from_coefficients(local_coefficients(result.fit.model, w)))))
                     for w in unique(learning_windows(final.n, max(result.ell, 1))))
    println("  Most negative eigenvalue in any learning window: ", round(lowest, digits=4))
end

results_hw = [learn_and_validate(group_hw; ideal=ideal_hw, ell) for ell in (2, 1, 0)]
foreach(summarize, results_hw)
plot_validation(results_hw, "ibm_fez, 96-qubit chain")
ℓ = 2
, N = 96: held-out F_max = 0.591 ± 0.1 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.21 from the model
  Most negative eigenvalue in any learning window: -0.0523
ℓ = 1, N = 96: held-out F_max = 0.554 ± 0.094 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.26 from the model
  Most negative eigenvalue in any learning window: -0.0215
ℓ = 0, N = 96: held-out F_max = 6.18e-6 ± 1.1e-6 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 32.01 from the model
  Most negative eigenvalue in any learning window: 0.0012
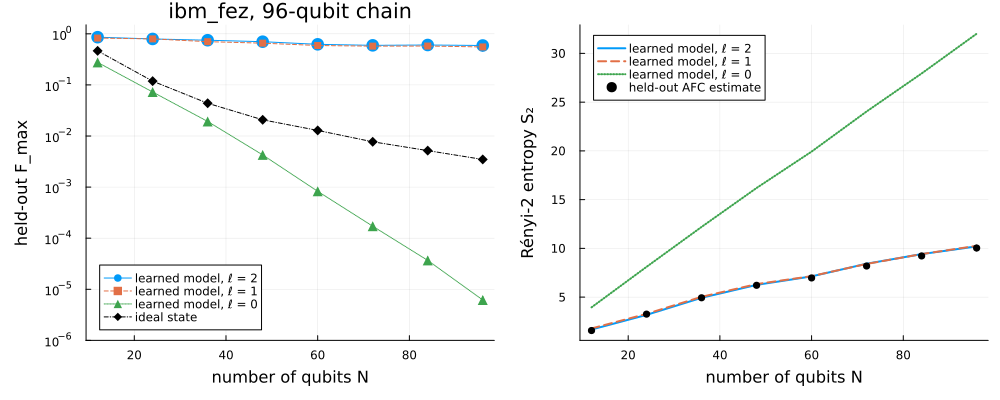
Wyniki odtwarzają oba twierdzenia z artykułu na innym procesorze:
-
Model opisuje dane znacznie lepiej niż stan idealny. Przy zachowane (held-out) modelu z wynosi 0,59 ± 0,10, w porównaniu z 0,0035 dla stanu idealnego. Artykuł podaje około 0,75 na
ibm_brisbane. -
Entropia modelu zgadza się z danymi testowymi dla każdego . Przy wynosi 10,2 z modelu i 10,0 ± 0,3 z danych testowych, czyli , w porównaniu z 0,14 do 0,15 na starszym
ibm_brisbane.
Porównanie rozmiarów okien pokazuje, gdzie leży informacja. Przy model jest prawie tak samo dobry (), więc dla tych danych korelacje wykraczające poza kilka kubitów niewiele wnoszą. Przy stan produktowy pomija splątanie między sąsiednimi kubitami: jego entropia rośnie do 32 zamiast 10, a jego spada nawet szybciej niż w przypadku stanu idealnego, do przy .
Czytając te liczby, pamiętaj o następujących ograniczeniach:
-
Podział treningowy. Słupki błędów obejmują tylko błąd statystyczny danych testowych. Inne losowe podziały tych samych ustawień dają między 0,49 a 0,59 przy dla .
-
Ostatnie przejście. Algorytm uczący zawsze zwraca model z ostatniego przejścia (sweep), więc dane testowe nigdy nie wpływają na model.
-
Dodatniość. Model nie jest ograniczony do dodatniej półokreśloności; jego najbardziej ujemna wartość własna w oknie uczenia wynosi około . Jego i opisują więc operator, a nie certyfikowane właściwości stanu fizycznego.
-
Faktoryzacja. Każde zachowane (held-out) oszacowanie opiera się na założeniu AFC, którego same pomiary nie mogą potwierdzić.
Dalsze kroki
-
Powtórz eksperyment na głębokości dwa z parametrami z artykułu dla tej głębokości ( i maksymalny wymiar wiązania 8) i ustal, ile ustawień pomiarowych potrzebuje algorytm uczący.
-
Ucz za pomocą aktualizacji dwumiejscowej (
update=:two_sitewtraining_marginalsilearn_mpo), która obcina wymiar wiązania po każdym kroku, i sprawdź, jak zachowuje się przy mniejszej liczbie ustawień treningowych. -
Ucz bez priorytetu CRM (
prior=nothing) i porównaj zachowaną (held-out) wierność. -
Zastosuj tę samą analizę do opublikowanych przez autorów pomiarów
ibm_brisbane. -
Przeczytaj suplement do artykułu, aby poznać wyprowadzenie aktualizacji i estymatorów AFC.
-
Poznaj inne protokoły pomiarów losowych w przykładach
RandomMeas.jl.
Bibliografia
-
M. Votto, M. Ljubotina, C. Lancien, J. I. Cirac, P. Zoller, M. Serbyn, L. Piroli, and B. Vermersch, "Learning mixed quantum states in large-scale experiments", Phys. Rev. Lett. 136, 090801 (2026). arXiv:2507.12550
-
A. Elben, S. T. Flammia, H.-Y. Huang, R. Kueng, J. Preskill, B. Vermersch, and P. Zoller, "The randomized measurement toolbox", Nat. Rev. Phys. 5, 9 (2023). arXiv:2203.11374
-
H.-Y. Huang, R. Kueng, and J. Preskill, "Predicting many properties of a quantum system from very few measurements", Nat. Phys. 16, 1050 (2020). arXiv:2002.08953
-
A. Elben and B. Vermersch, "RandomMeas.jl: A Julia package for randomized measurements in quantum devices", Quantum 10, 2086 (2026). arXiv:2509.12749
-
B. Vermersch, A. Rath, B. Sundar, C. Branciard, J. Preskill, and A. Elben, "Enhanced estimation of quantum properties with common randomized measurements", PRX Quantum 5, 010352 (2024). arXiv:2304.12292
-
H. Zou, "Randomized measurements of a 96-qubit kicked-Ising state on ibm_fez", Zenodo (2026). doi:10.5281/zenodo.24116174