Kwantowa diagonalizacja Krylova sieciowych hamiltonianów
Szacowany czas wykonania: 70 minut na procesorze Heron lub Nighthawk (UWAGA: To jedynie szacunek. Rzeczywisty czas może się różnić.)
Efekty uczenia się
-
Jak interpretować diagonalizację kwantową Kryłowa (KQD) jako uczenie się skończonej funkcji hamiltonianu, która działa jak filtr spektralny.
-
Jak zbudować rzutowany hamiltonian i macierze pokrycia za pomocą rozszerzonych pomiarów testu swap.
-
Jak rozwiązać wynikowy uogólniony problem wartości własnych (GEVP) i odzyskać oszacowanie energii stanu podstawowego dla hamiltonianu sieciowego.
Wymagania wstępne
Podstawy teoretyczne
Ten samouczek pokazuje, jak zaimplementować algorytm kwantowej diagonalizacji Krylova (KQD) w kontekście wzorców Qiskit. Najpierw poznasz teorię stojącą za algorytmem, a następnie zobaczysz demonstrację jego wykonania na QPU.
Szacowanie własności niskoenergetycznych hamiltonianów wielociałowych jest centralnym zadaniem w symulacji kwantowej. Na przykład energie stanu podstawowego i niskie wzbudzenia są bezpośrednio powiązane ze stabilnością chemiczną, uporządkowaniem magnetycznym, przejściami fazowymi kwantowymi i odpowiedzią materiału. Na komputerze klasycznym wymiar przestrzeni Hilberta rośnie wykładniczo wraz z liczbą orbitali lub spinów, więc bezpośrednia diagonalizacja szybko staje się niepraktyczna.
Istnieje kilka podejść obliczeń kwantowych do tego problemu. Metody wariacyjne bliskiego zasięgu, takie jak wariacyjny solver wartości własnych (VQE), wykorzystują stosunkowo płytkie sparametryzowane obwody, ale wymagają nieliniowej pętli optymalizacji klasycznej z wieloma ocenami obwodów kwantowych. Z drugiej strony, estymacja fazy kwantowej (QPE) zapewnia bardziej bezpośrednią drogę do szacowania wartości własnych z rygorystycznymi gwarancjami, ale standardowa QPE wymaga długich koherentnych obwodów i jest przeznaczona głównie dla komputerów kwantowych odpornych na błędy. KQD znajduje się pomiędzy tymi dwoma podejściami: wykorzystuje ewolucję hamiltonianu w czasie rzeczywistym, tak jak w algorytmach opartych na estymacji fazy, ale zastępuje pełną estymację fazy zwartym rzutowanym problemem wartości własnych, który można rozwiązać klasycznie.
Rozważmy hamiltonian na kubitach oraz stan referencyjny . Metoda KQD buduje podprzestrzeń Kryłowa ze stanów ewoluujących w czasie rzeczywistym,
gdzie to wymiar Kryłowa, a to krok czasowy. Każdy stan w podprzestrzeni Kryłowa jest wtedy reprezentowany jako kombinacja liniowa tych stanów bazowych,
where the denominator normalizes the state.
Przy pomocy prostej algebry widzimy, że odpowiadająca energia jest zapisana jako iloraz Rayleigha,
Tutaj macierze i ,
definiują rzutowane macierze pokrycia i hamiltonianu. Ich elementy są szacowane za pomocą pomiarów obwodów kwantowych.
Naszym celem jest znalezienie współczynnika , który daje minimalne :
Zgodnie z twierdzeniem Rayleigha-Ritza minimalizacja ta jest równoważna rozwiązaniu uogólnionego problemu wartości własnych (GEVP),
Zauważ, że wymiar może być wystarczająco mały, aby komputer klasyczny mógł rozwiązać GEVP.
Jest to ta sama zasada wariacyjna używana w klasycznej diagonalizacji podprzestrzeni, ale tutaj stany bazowe są generowane przez kwantową ewolucję czasową. W porównaniu z VQE, KQD zazwyczaj wymaga głębszych obwodów, ponieważ opiera się na ewolucji w czasie rzeczywistym. W zamian KQD unika nieliniowej optymalizacji parametrów i iteracyjnego wykonywania na sprzęcie kwantowym, a jego dokładność systematycznie się poprawia w miarę powiększania rzutowanej podprzestrzeni. Algorytm został zademonstrowany na dużą skalę na istniejącym sprzęcie kwantowym [2], a jego wydajność można analizować z możliwymi do udowodnienia gwarancjami [1].
Wymagania
Przed rozpoczęciem tego samouczka upewnij się, że masz zainstalowane:
-
Qiskit SDK v2.3 lub nowszy, z obsługą wizualizacji
-
Qiskit Runtime v0.22 lub nowszy (
pip install qiskit-ibm-runtime) -
SciPy (
pip install scipy) -
Matplotlib (
pip install matplotlib) -
Pandas (
pip install pandas)
Wykonanie na sprzęcie wymaga qiskit-ibm-runtime oraz dostępu do konta IBM Quantum®.
Konfiguracja
Komórka konfiguracyjna importuje wymagane moduły i definiuje funkcje pomocnicze dla obiegu pracy:
-
budowa hamiltonianu Heisenberga;
-
rozwiązanie progowanego GEVP;
-
ocena wyuczonego filtru Kryłowa;
-
konwersja wartości filtru na wagi spektralne;
-
wykreślenie rozkładów energii referencyjnej i przefiltrowanej.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy pandas qiskit qiskit-ibm-runtime scipy
from __future__ import annotations

import warnings

import numpy as np
import pandas as pd
import scipy.linalg as la
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit, transpile
from qiskit.circuit import Parameter
from qiskit.circuit.library import PauliEvolutionGate
from qiskit.primitives import StatevectorEstimator
from qiskit.quantum_info import Operator, SparsePauliOp
from qiskit.synthesis import LieTrotter, SuzukiTrotter
from qiskit.transpiler import PassManager, Layout
from qiskit.transpiler.passes import CommutativeOptimization
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Batch
from qiskit_ibm_runtime.fake_provider import FakeMarrakesh

warnings.filterwarnings("ignore")

def make_heisenberg_hamiltonian(
    num_qubits: int,
    coupling: float = 1.0,
) -> SparsePauliOp:
    """Make a Heisenberg Hamiltonian for a 1D chain of qubits with nearest-neighbor interactions."""
    terms: list[tuple[str, complex]] = []

    def append_term(q0: int, q1: int, pauli: str):
        label = ["I"] * num_qubits
        label[num_qubits - 1 - q0] = pauli[0]
        label[num_qubits - 1 - q1] = pauli[1]
        terms.append(("".join(label), coupling))

    for pauli in ("XX", "YY", "ZZ"):
        for q in range(num_qubits - 1):
            append_term(q, q + 1, pauli)
    return SparsePauliOp.from_list(terms).simplify()

def _basis_state_transition_amplitude_sparse(
    hamiltonian: SparsePauliOp,
    bra_state: int,
    ket_state: int,
) -> complex:
    """Evaluate <bra_state|H|ket_state> for computational-basis states."""
    num_qubits = hamiltonian.num_qubits
    amplitude = 0.0 + 0.0j
    for pauli, coeff in zip(hamiltonian.paulis, hamiltonian.coeffs):
        new_state = ket_state
        phase = 1.0 + 0.0j
        for q in range(num_qubits):
            x = bool(pauli.x[q])
            z = bool(pauli.z[q])
            if not x and not z:
                continue
            bit = (new_state >> q) & 1
            if x and z:
                # Y|0> = i|1>, Y|1> = -i|0>
                phase *= 1j if bit == 0 else -1j
                new_state ^= 1 << q
            elif x:
                new_state ^= 1 << q
            else:
                # Z|0> = |0>, Z|1> = -|1>
                if bit:
                    phase *= -1
        if new_state == bra_state:
            amplitude += coeff * phase
    return amplitude

def basis_state_expectation_sparse(
    hamiltonian: SparsePauliOp,
    bitstring: str,
) -> complex:
    """Evaluate <bitstring|H|bitstring>."""
    state = int(bitstring, 2)
    return _basis_state_transition_amplitude_sparse(
        hamiltonian,
        bra_state=state,
        ket_state=state,
    )

def diagonalize_single_1_subspace(
    hamiltonian: SparsePauliOp,
) -> np.ndarray:
    """Diagonalize the Hamiltonian projected onto the single-excitation subspace."""
    num_qubits = hamiltonian.num_qubits

    # Integer basis states |...010...>, with the excitation at qubit k.
    basis = [1 << k for k in range(num_qubits)]

    h_single = np.empty((num_qubits, num_qubits), dtype=complex)

    for row, bra_state in enumerate(basis):
        for col, ket_state in enumerate(basis):
            h_single[row, col] = _basis_state_transition_amplitude_sparse(
                hamiltonian,
                bra_state=bra_state,
                ket_state=ket_state,
            )
    # Remove floating-point-level asymmetry.
    h_single = 0.5 * (h_single + h_single.conj().T)
    evals, _ = np.linalg.eigh(h_single)
    return np.real(evals)

def simple_transpilation(circuit: QuantumCircuit) -> QuantumCircuit:
    """Transpilation to simplify the circuit"""
    pm = PassManager(
        [
            CommutativeOptimization(),
        ]
    )
    circuit = transpile(circuit, optimization_level=3)
    circuit = pm.run(circuit)
    return circuit

def summarize_circuit(circuit: QuantumCircuit) -> dict[str, int | str]:
    """Summarize the circuit with depth, size, and 2-qubit gate information."""
    two_qubit_total = sum(
        inst.operation.num_qubits == 2 for inst in circuit.data
    )
    two_qubit_depth = circuit.depth(lambda x: x[0].num_qubits == 2)
    return {
        "depth": circuit.depth(),
        "size": circuit.size(),
        "2q gates": two_qubit_total,
        "2q depth": two_qubit_depth,
    }

def solve_thresholded_gevp(
    h_matrix: np.ndarray,
    s_matrix: np.ndarray,
    threshold: float = 1e-10,
) -> tuple[float, np.ndarray, int]:
    """Solve H c = E S c using canonical orthogonalization of S."""
    s_vals, s_vecs = la.eigh(s_matrix)

    valid = s_vals > threshold
    if not np.any(valid):
        raise ValueError(
            "All overlap eigenvalues were removed by thresholding."
        )

    keep = valid

    orthogonalizer = s_vecs[:, keep] @ np.diag(1.0 / np.sqrt(s_vals[keep]))
    h_orth = orthogonalizer.conj().T @ h_matrix @ orthogonalizer
    h_orth = 0.5 * (h_orth + h_orth.conj().T)

    eigvals, eigvecs = la.eigh(h_orth)

    coeffs = orthogonalizer @ eigvecs[:, 0]
    normalization = np.sqrt(np.real(coeffs.conj().T @ s_matrix @ coeffs))
    coeffs /= normalization

    return float(np.real(eigvals[0])), coeffs, int(np.sum(keep))
W pierwszej części tego samouczka demonstrujemy metodę KQD, wykorzystując lokalny symulator wektora stanu. Później używamy rzeczywistego backendu kwantowego, aby zająć się problemem o skali użytkowej.
Definiujemy również fałszywy backend, aby zademonstrować transpilację specyficzną dla backendu i zbadać wynikowy obwód.
try:
    service = QiskitRuntimeService()
except Exception:
    QiskitRuntimeService.save_account(
        token="<api_token>", instance="<instance>", overwrite=True
    )
    service = QiskitRuntimeService()

backend = FakeMarrakesh()
Przykład na małą skalę z symulatorem
Krok 1: Odwzorowanie klasycznych danych wejściowych na problem kwantowy
Hamiltonian i stan referencyjny
W tym przykładzie wykorzystujemy 12-kubitowy łańcuch Heisenberga o otwartych granicach (),
ze stanem produktowym z pojedynczym wzbudzeniem
jako stan referencyjny. Ponieważ zdefiniowany powyżej hamiltonian Heisenberga zachowuje całkowitą liczbę wzbudzeń, stan referencyjny pozostaje w podprzestrzeni pojedynczego wzbudzenia, której wymiar rośnie tylko liniowo wraz z liczbą kubitów. Możemy zatem efektywnie obliczyć dokładną energię stanu podstawowego, diagonalizując hamiltonian ograniczony do tej podprzestrzeni, i użyć jej wyłącznie jako diagnostycznego punktu odniesienia dla oszacowania KQD. Sam obieg pracy KQD szacuje rzutowane elementy macierzowe przy użyciu prymitywów Qiskit i rozwiązuje wynikowy rzutowany problem klasycznie.
# Problem definition for the simulator example
num_qubits = 12
hamiltonian = make_heisenberg_hamiltonian(num_qubits=num_qubits, coupling=1.0)
ref_bitstring = "000001000000"
ref_energy = basis_state_expectation_sparse(hamiltonian, ref_bitstring)

print("Hamiltonian:")
print(hamiltonian)
print(f"Reference state: |{ref_bitstring}>")
print("Reference energy: ", ref_energy)
Hamiltonian:
SparsePauliOp(['IIIIIIIIIIXX', 'IIIIIIIIIXXI', 'IIIIIIIIXXII', 'IIIIIIIXXIII', 'IIIIIIXXIIII', 'IIIIIXXIIIII', 'IIIIXXIIIIII', 'IIIXXIIIIIII', 'IIXXIIIIIIII', 'IXXIIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIIYYI', 'IIIIIIIIYYII', 'IIIIIIIYYIII', 'IIIIIIYYIIII', 'IIIIIYYIIIII', 'IIIIYYIIIIII', 'IIIYYIIIIIII', 'IIYYIIIIIIII', 'IYYIIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIIZZI', 'IIIIIIIIZZII', 'IIIIIIIZZIII', 'IIIIIIZZIIII', 'IIIIIZZIIIII', 'IIIIZZIIIIII', 'IIIZZIIIIIII', 'IIZZIIIIIIII', 'IZZIIIIIIIII', 'ZZIIIIIIIIII'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])
Reference state: |000001000000>
Reference energy:  (7+0j)
Ustawianie parametrów algorytmu
Na podstawie górnych ograniczeń normy hamiltonianu, [1] heurystycznie sugeruje krok czasowy jako . Ponieważ norma spektralna jest trudna do obliczenia, zamiast tego używamy jej górnego ograniczenia:
Ustawiamy wymiar Kryłowa na , a liczbę kroków Trottera na krok czasowy na : wystarczająco duża przestrzeń Kryłowa, aby rozwiązać niskoenergetyczne widmo, przy jednoczesnym utrzymaniu przystępnego kosztu najgłębszego obwodu (), oraz wystarczająco dużo kroków Trottera, aby utrzymać mały błąd dyskretyzacji przy tym najgłębszym obwodzie.
dt = np.pi / (3 * (num_qubits - 1))
print("dt in Krylov basis:  ", dt)

krylov_dim = 10
num_trotter_steps = 5
dt in Krylov basis: 0.09519977738150888
Budowa obwodu
Tutaj budujemy obwody do oszacowania elementów macierzowych i . Ponieważ wszystkie potęgi komutują, mamy
Such matrices where the elements depend on the index differences in this manner are called Toeplitz and can be reconstructed from first-row elements indexed by .
Tutaj przedstawiamy obwód, zwany rozszerzonym testem swap, który przygotowuje
gdzie .
Stan referencyjny
Przygotowujemy stan referencyjny .
qc_ref = QuantumCircuit(num_qubits)
for i, b in enumerate(reversed(ref_bitstring)):
    if b == "1":
        qc_ref.x(i)
display(qc_ref.draw("mpl", scale=0.5))

Ewolucja czasowa
Zrealizuj operator ewolucji czasowej generowany przez hamiltonian, przybliżony za pomocą prostej Lie-Trotteryzacji.
t = Parameter("t")

evol_gate = PauliEvolutionGate(
    hamiltonian,
    time=t,
    synthesis=LieTrotter(reps=num_trotter_steps),
    label="U(t)",
)

# Synthesize U(t) first and then control the synthesized circuit.
# This makes the controlled structure visible in the circuit drawer.
evolution_circuit = QuantumCircuit(num_qubits, name="U(t)")
evolution_circuit.append(evol_gate, range(num_qubits))
evolution_circuit = simple_transpilation(evolution_circuit)

# Make a controlled version of the evolution circuit.
controlled_evolution_gate = evolution_circuit.to_gate(label="U(t)").control(
    1, label="C-U(t)"
)
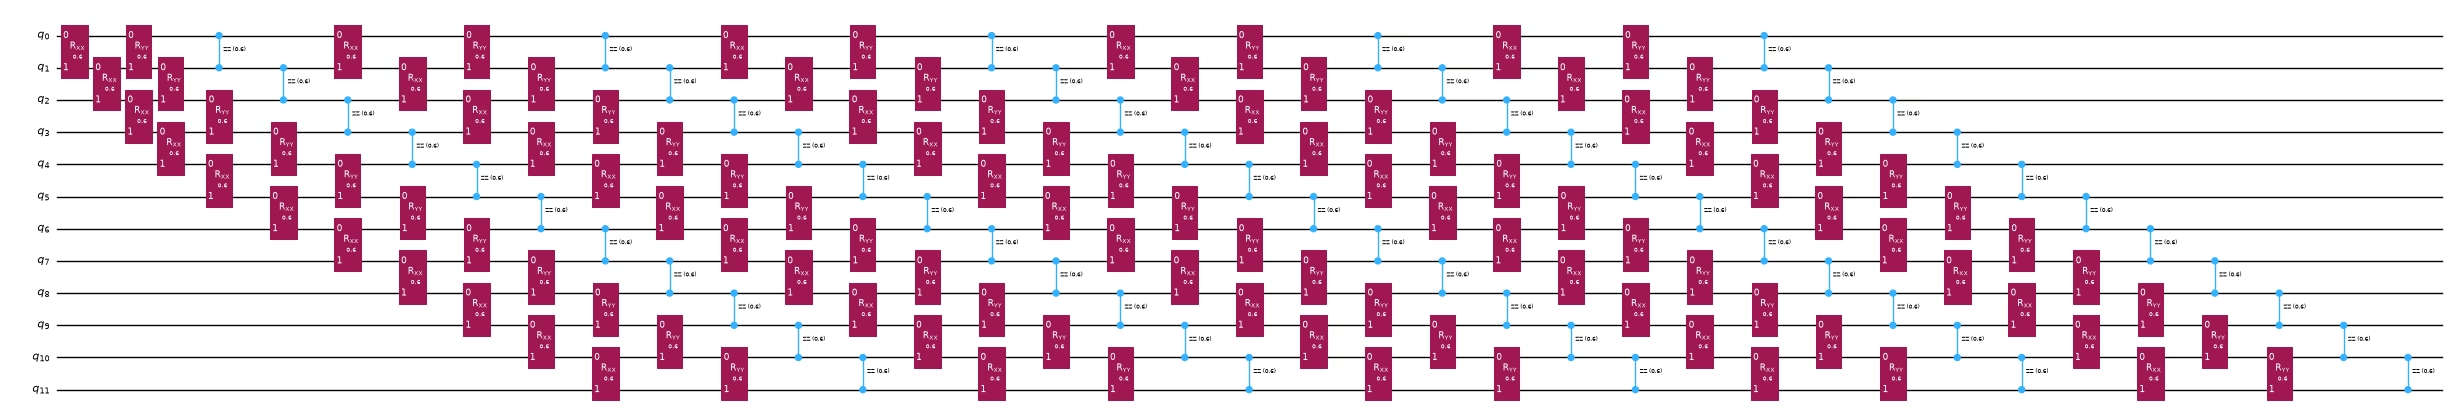
display(
    evolution_circuit.assign_parameters({t: 1.5}).draw(
        "mpl", scale=0.5, fold=-1
    )
)
Obwód testu rozszerzonego swap [3]
Obwód najpierw przygotowuje stan referencyjny w rejestrze systemowym, podczas gdy ancilla pozostaje w stanie :
Następnie zastosowanie bramki Hadamarda do ancilli tworzy koherentną superpozycję dwóch gałęzi:
Na koniec stosowana jest kontrolowana bramka ewolucji czasowej:
tylko wtedy, gdy ancilla znajduje się w gałęzi . Dlatego,
W następnym bloku kodu implementujemy:
co zostanie przypisane jako dla w kroku wykonania.
ancilla = 0
system_qubits = list(range(1, num_qubits + 1))

extended_swap_test = QuantumCircuit(num_qubits + 1)

# Append state preparation part
extended_swap_test = extended_swap_test.compose(qc_ref, system_qubits)

# Prepare the coherent branch label, (|0> + |1>) / sqrt(2).
extended_swap_test.h(ancilla)

# Apply U(t) only to the |1> branch of the ancilla.
extended_swap_test.append(
    controlled_evolution_gate, [ancilla] + system_qubits
)

# Decompose once more for visualization so that control bullets are visible.
display(extended_swap_test.draw("mpl", fold=-1))

Obserwable
Dla dowolnej hermitowskiej obserwabli systemu , ustawiamy tutaj obserwable do obliczenia:
Wynika to z faktu, że daje element przekrywania , podczas gdy daje element hamiltonianu .
Używając , mamy
Podobnie, używając ,
Zatem mamy
Na koniec, dla każdego stanu , musimy zmierzyć:
n_qubits = hamiltonian.num_qubits

observable_labels = [
    "Re S_0d",
    "Im S_0d",
    "Re H_0d",
    "Im H_0d",
]

# X ⊗ I and Y ⊗ I.
# Qiskit's Pauli-label convention places qubit 0 on the rightmost character,
# so the ancilla Pauli is appended to the right.
obs_x_identity = SparsePauliOp("I" * n_qubits + "X")
obs_y_identity = SparsePauliOp("I" * n_qubits + "Y")

# X ⊗ H and Y ⊗ H.
obs_x_hamiltonian = SparsePauliOp.from_list(
    [
        (label + "X", coeff)
        for label, coeff in zip(
            hamiltonian.paulis.to_labels(),
            hamiltonian.coeffs,
        )
    ]
)

obs_y_hamiltonian = SparsePauliOp.from_list(
    [
        (label + "Y", coeff)
        for label, coeff in zip(
            hamiltonian.paulis.to_labels(),
            hamiltonian.coeffs,
        )
    ]
)

observables = [
    obs_x_identity,
    obs_y_identity,
    obs_x_hamiltonian,
    obs_y_hamiltonian,
]

for obs, label in zip(observables, observable_labels):
    print(f"Observable: {label}")
    print(obs)
    print()
Observable: Re S_0d
SparsePauliOp(['IIIIIIIIIIIIX'],
              coeffs=[1.+0.j])

Observable: Im S_0d
SparsePauliOp(['IIIIIIIIIIIIY'],
              coeffs=[1.+0.j])

Observable: Re H_0d
SparsePauliOp(['IIIIIIIIIIXXX', 'IIIIIIIIIXXIX', 'IIIIIIIIXXIIX', 'IIIIIIIXXIIIX', 'IIIIIIXXIIIIX', 'IIIIIXXIIIIIX', 'IIIIXXIIIIIIX', 'IIIXXIIIIIIIX', 'IIXXIIIIIIIIX', 'IXXIIIIIIIIIX', 'XXIIIIIIIIIIX', 'IIIIIIIIIIYYX', 'IIIIIIIIIYYIX', 'IIIIIIIIYYIIX', 'IIIIIIIYYIIIX', 'IIIIIIYYIIIIX', 'IIIIIYYIIIIIX', 'IIIIYYIIIIIIX', 'IIIYYIIIIIIIX', 'IIYYIIIIIIIIX', 'IYYIIIIIIIIIX', 'YYIIIIIIIIIIX', 'IIIIIIIIIIZZX', 'IIIIIIIIIZZIX', 'IIIIIIIIZZIIX', 'IIIIIIIZZIIIX', 'IIIIIIZZIIIIX', 'IIIIIZZIIIIIX', 'IIIIZZIIIIIIX', 'IIIZZIIIIIIIX', 'IIZZIIIIIIIIX', 'IZZIIIIIIIIIX', 'ZZIIIIIIIIIIX'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])

Observable: Im H_0d
SparsePauliOp(['IIIIIIIIIIXXY', 'IIIIIIIIIXXIY', 'IIIIIIIIXXIIY', 'IIIIIIIXXIIIY', 'IIIIIIXXIIIIY', 'IIIIIXXIIIIIY', 'IIIIXXIIIIIIY', 'IIIXXIIIIIIIY', 'IIXXIIIIIIIIY', 'IXXIIIIIIIIIY', 'XXIIIIIIIIIIY', 'IIIIIIIIIIYYY', 'IIIIIIIIIYYIY', 'IIIIIIIIYYIIY', 'IIIIIIIYYIIIY', 'IIIIIIYYIIIIY', 'IIIIIYYIIIIIY', 'IIIIYYIIIIIIY', 'IIIYYIIIIIIIY', 'IIYYIIIIIIIIY', 'IYYIIIIIIIIIY', 'YYIIIIIIIIIIY', 'IIIIIIIIIIZZY', 'IIIIIIIIIZZIY', 'IIIIIIIIZZIIY', 'IIIIIIIZZIIIY', 'IIIIIIZZIIIIY', 'IIIIIZZIIIIIY', 'IIIIZZIIIIIIY', 'IIIZZIIIIIIIY', 'IIZZIIIIIIIIY', 'IZZIIIIIIIIIY', 'ZZIIIIIIIIIIY'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])
Dla estymacji elementów macierzy , liczba wyrazów Pauliego jest znacznie większa niż dla elementów macierzy .
Możemy teraz zmniejszyć liczbę mierzonych wyrazów hamiltonianu, stosując technikę przesunięcia [4]. Dzielimy hamiltonian jako:
gdzie jest wybrane tak, aby stan referencyjny był jego stanem własnym,
Then,
Here,
jest przesuniętym elementem macierzy hamiltonianu. Dlatego musimy mierzyć jedynie i . Wkład od jest odtwarzany klasycznie przy użyciu już zmierzonego elementu macierzy przekrywania .
W tym przykładzie naturalnym wyborem jest diagonalna część hamiltonianu Heisenberga,
Ponieważ stan referencyjny jest stanem bazy obliczeniowej, jest on stanem własnym każdego wyrazu .
Jednak bardziej korzystny wybór obejmuje nie tylko diagonalne wyrazy , ale także wyrazy , które anihilują stan referencyjny.
Dla każdej sąsiedniej pary operator spełnia
and
Dlatego wyraz wnosi wkład tylko wtedy, gdy dwa sąsiednie kubity mają różne obsadzenia w referencyjnym ciągu bitów. Jeśli oba kubity są albo oba są , wyraz anihiluje stan referencyjny i również może zostać przesunięty na zewnątrz.
Niech , gdzie . Możemy zatem wybrać
Ten operator nadal spełnia
ponieważ wyrazy działają diagonalnie na , podczas gdy przesunięte wyrazy dają zero. Odpowiadająca wartość własna jest zatem wyznaczona wyłącznie przez wyrazy ,
Przy tym wyborze przesunięty hamiltonian staje się:
W rezultacie mierzone muszą być jedynie krawędzie o różnych obsadzeniach w stanie referencyjnym. Wszystkie wyrazy oraz wszystkie nieaktywne wyrazy są odtwarzane poprzez wkład przekrywania , albo dają zerowy wkład z konstrukcji.
Daje to mniejszą obserwablę niż przesunięcie samej części diagonalnej. W szczególności, dla stanu referencyjnego bazy obliczeniowej ze zlokalizowanym wzbudzeniem, w pozostają jedynie krawędzie sąsiadujące ze wzbudzeniem. Dlatego liczbę wyrazów Pauliego w i można znacznie zmniejszyć, podczas gdy odtworzony element macierzy
pozostaje dokładnie taki sam.
def make_reduced_heisenberg_observables(
    ref_bitstring: str,
    coupling: float = 1.0,
) -> tuple[SparsePauliOp, SparsePauliOp, float]:
    """Build X⊗(H-T), Y⊗(H-T), and tau."""
    n_qubits = len(ref_bitstring)

    shifted_terms: list[tuple[str, complex]] = []
    tau = 0.0

    def bit(q: int) -> str:
        return ref_bitstring[n_qubits - 1 - q]

    def append_term(q0: int, q1: int, pauli: str):
        label = ["I"] * n_qubits
        label[n_qubits - 1 - q0] = pauli[0]
        label[n_qubits - 1 - q1] = pauli[1]
        shifted_terms.append(("".join(label), coupling))

    for q in range(n_qubits - 1):
        same_occupation = bit(q) == bit(q + 1)

        # ZZ contribution to tau
        tau += coupling * (1.0 if same_occupation else -1.0)

        # XX + YY survives only for opposite occupations.
        if not same_occupation:
            append_term(q, q + 1, "XX")
            append_term(q, q + 1, "YY")

    if shifted_terms:
        obs_x_shifted_hamiltonian = SparsePauliOp.from_list(
            [(label + "X", coeff) for label, coeff in shifted_terms]
        )
        obs_y_shifted_hamiltonian = SparsePauliOp.from_list(
            [(label + "Y", coeff) for label, coeff in shifted_terms]
        )
    else:
        obs_x_shifted_hamiltonian = SparsePauliOp(
            "I" * n_qubits + "X", coeffs=[0.0]
        )
        obs_y_shifted_hamiltonian = SparsePauliOp(
            "I" * n_qubits + "Y", coeffs=[0.0]
        )

    return obs_x_shifted_hamiltonian, obs_y_shifted_hamiltonian, tau

obs_x_shifted_hamiltonian, obs_y_shifted_hamiltonian, shift_tau = (
    make_reduced_heisenberg_observables(ref_bitstring)
)

print("Observable: Re shifted H_0d")
print(obs_x_shifted_hamiltonian)
print()

print("Observable: Im shifted H_0d")
print(obs_y_shifted_hamiltonian)
print()

print("tau =", shift_tau)

observables = [
    obs_x_identity,
    obs_y_identity,
    obs_x_shifted_hamiltonian,
    obs_y_shifted_hamiltonian,
]
observable_labels = [
    "Re S_0d",
    "Im S_0d",
    "Re shifted H_0d",
    "Im shifted H_0d",
]
Observable: Re shifted H_0d
SparsePauliOp(['IIIIIXXIIIIIX', 'IIIIIYYIIIIIX', 'IIIIXXIIIIIIX', 'IIIIYYIIIIIIX'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])

Observable: Im shifted H_0d
SparsePauliOp(['IIIIIXXIIIIIY', 'IIIIIYYIIIIIY', 'IIIIXXIIIIIIY', 'IIIIYYIIIIIIY'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])

tau = 7.0
Krok 2: Optymalizacja problemu pod kątem wykonania na sprzęcie kwantowym
Teraz przekształcamy abstrakcyjny obwód rozszerzonego testu swap w szablon zorientowany na sprzęt. Zanim to zrobimy, dodatkowo optymalizujemy obwód najpierw na poziomie abstrakcyjnym.
Porównanie kolejności wyrazów hamiltonianu
Najpierw porównujemy różne kolejności wyrazów Pauliego w hamiltonianie Heisenberga dla symulacji hamiltonianu. Sam hamiltonian pozostaje niezmieniony, ale kolejność wpływa na sposób generowania obwodu formuły produktowej oraz na to, jak bardzo struktura może być zrównoleglona w obwodzie. Na przykład naiwna kolejność wymienia najpierw wszystkie wyrazy dla najbliższych sąsiadów, następnie wszystkie wyrazy , a na końcu wszystkie wyrazy . Umieszcza to sąsiadujące krawędzie, takie jak i , obok siebie, więc nie mogą być wykonane równolegle. Kolejność parzyste-potem-nieparzyste odwiedza najpierw rozłączne parzyste krawędzie, a następnie nieparzyste, co odsłania równoległe warstwy dwukubitowe. Kolejność parzysto-nieparzysta z grupowaniem krawędzi idzie o krok dalej: dla każdej krawędzi utrzymuje razem lokalne wyrazy , i , wciąż odwiedzając parzyste krawędzie przed nieparzystymi. Spodziewamy się, że kolejności parzyste-potem-nieparzyste oraz parzysto-nieparzysta z grupowaniem krawędzi zmniejszą głębokość obwodu poprzez odsłonięcie równoległych warstw dwukubitowych, a kolejność z grupowaniem krawędzi dodatkowo zmniejszy błąd Trottera, ponieważ lokalna interakcja dwukubitowa na tej samej krawędzi jest obsługiwana jako zwarty blok.
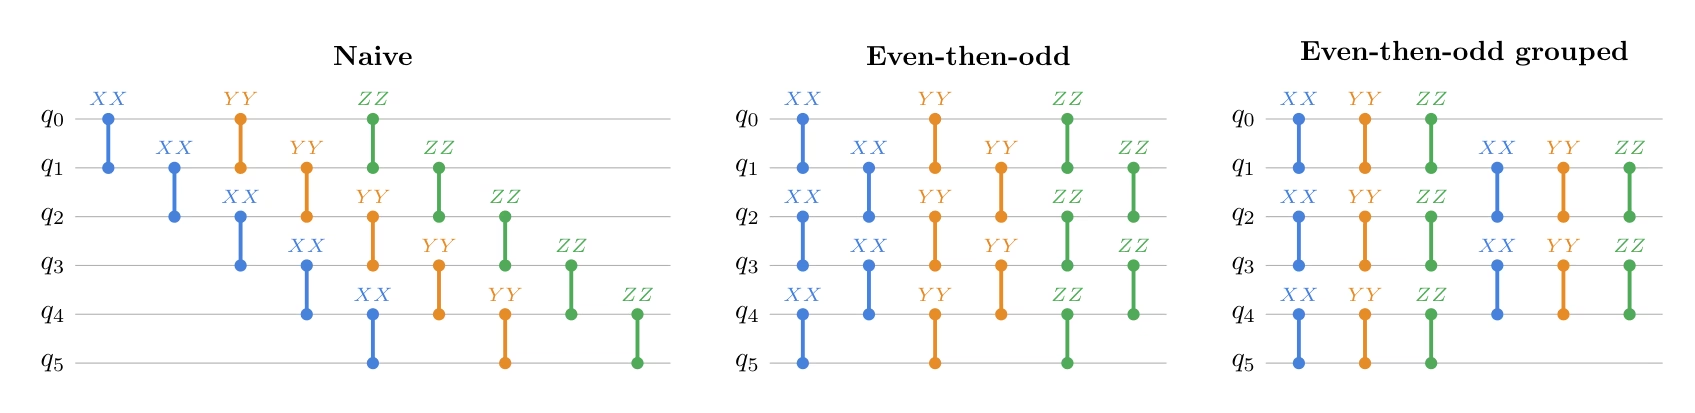
Kolejność hamiltonianu wpływa również na błąd Trottera. Jeśli umieścimy niekomutujące wyrazy obok siebie, przejścia bazowe następują częściej, co powoduje większy błąd Trottera. Grupując wyrazy wymagające tej samej transformacji bazy Pauliego, można uniknąć zbędnych zmian bazy.
Tutaj porównanie wykorzystuje największy czas ewolucji, który pojawia się w estymacjach Kryłowa pierwszego wiersza, przy użyciu tego samego warunku transpilacji.
Aby zmierzyć błąd Trottera, używamy nieporzeczności procesu (process infidelity) między obwodem Trotterowskim a dokładną ewolucją hamiltonianu w czasie rzeczywistym,
where is the dimension of the Hilbert space.
Ten diagnostyk wykorzystuje macierze gęste, więc jest odpowiedni dla tego małego 12-kubitowego przykładu, ale nie jest przeznaczony jako skalowalna podprocedura.
# The comparison uses the largest time that appears in the first-row Krylov estimates.
# Circuit depth does not depend on this numeric value, but the Trotter error does.
comparison_time = (krylov_dim - 1) * dt

def make_heisenberg_hamiltonian_ordered(
    num_qubits: int,
    ordering: str,
    coupling: float = 1.0,
) -> SparsePauliOp:
    """Return the same Heisenberg Hamiltonian with a specified term ordering."""
    terms: list[tuple[str, complex]] = []
    even_edges = [(q, q + 1) for q in range(0, num_qubits - 1, 2)]
    odd_edges = [(q, q + 1) for q in range(1, num_qubits - 1, 2)]

    def append_term(q0: int, q1: int, pauli: str):
        label = ["I"] * num_qubits
        label[num_qubits - 1 - q0] = pauli[0]
        label[num_qubits - 1 - q1] = pauli[1]
        terms.append(("".join(label), coupling))

    if ordering == "naive":
        for pauli in ("XX", "YY", "ZZ"):
            for q in range(num_qubits - 1):
                append_term(q, q + 1, pauli)
    elif ordering == "even-then-odd":
        for pauli in ("XX", "YY", "ZZ"):
            for q0, q1 in even_edges + odd_edges:
                append_term(q0, q1, pauli)
    elif ordering == "even-odd edge-grouped":
        for q0, q1 in even_edges + odd_edges:
            for pauli in ("XX", "YY", "ZZ"):
                append_term(q0, q1, pauli)
    else:
        raise ValueError(f"Unknown ordering: {ordering}")

    return SparsePauliOp.from_list(terms).simplify()

def build_numeric_evolution_circuit(
    hamiltonian: SparsePauliOp,
    synthesis,
    time_value: float,
    **synthesis_kwargs,
) -> QuantumCircuit:
    """Build a numeric circuit for exp(-i H t) with a chosen synthesis rule."""
    evolution_gate = PauliEvolutionGate(
        hamiltonian,
        time=time_value,
        synthesis=synthesis(**synthesis_kwargs),
    )
    circuit = QuantumCircuit(hamiltonian.num_qubits)
    circuit.append(evolution_gate, range(hamiltonian.num_qubits))
    return circuit

def process_infidelity(
    circuit: QuantumCircuit,
    exact_matrix: np.ndarray,
) -> float:
    """Return 1 - |Tr(U_circuit† U_exact) / d|²."""
    circuit_matrix = np.asarray(Operator(circuit).data)
    dim = circuit_matrix.shape[0]
    normalized_trace = np.vdot(circuit_matrix, exact_matrix) / dim
    fidelity = np.abs(normalized_trace) ** 2
    return float(np.clip(1.0 - fidelity, 0.0, 1.0))

hamiltonians_by_ordering = {
    ordering: make_heisenberg_hamiltonian_ordered(
        num_qubits, ordering, coupling=1.0
    )
    for ordering in ["naive", "even-then-odd", "even-odd edge-grouped"]
}

print(f"Comparison time: {comparison_time}\n")

for order_name, ham_ordered in hamiltonians_by_ordering.items():
    print(f"{order_name}:")
    print([op for op, _ in ham_ordered.to_list()])
    print()

print("Precomputing the exact evolution operator... ", end="")
exact_matrix = la.expm(-1j * comparison_time * hamiltonian.to_matrix())
print("Done")
Comparison time: 0.8567979964335799

naive:
['IIIIIIIIIIXX', 'IIIIIIIIIXXI', 'IIIIIIIIXXII', 'IIIIIIIXXIII', 'IIIIIIXXIIII', 'IIIIIXXIIIII', 'IIIIXXIIIIII', 'IIIXXIIIIIII', 'IIXXIIIIIIII', 'IXXIIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIIYYI', 'IIIIIIIIYYII', 'IIIIIIIYYIII', 'IIIIIIYYIIII', 'IIIIIYYIIIII', 'IIIIYYIIIIII', 'IIIYYIIIIIII', 'IIYYIIIIIIII', 'IYYIIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIIZZI', 'IIIIIIIIZZII', 'IIIIIIIZZIII', 'IIIIIIZZIIII', 'IIIIIZZIIIII', 'IIIIZZIIIIII', 'IIIZZIIIIIII', 'IIZZIIIIIIII', 'IZZIIIIIIIII', 'ZZIIIIIIIIII']

even-then-odd:
['IIIIIIIIIIXX', 'IIIIIIIIXXII', 'IIIIIIXXIIII', 'IIIIXXIIIIII', 'IIXXIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIXXI', 'IIIIIIIXXIII', 'IIIIIXXIIIII', 'IIIXXIIIIIII', 'IXXIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIYYII', 'IIIIIIYYIIII', 'IIIIYYIIIIII', 'IIYYIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIYYI', 'IIIIIIIYYIII', 'IIIIIYYIIIII', 'IIIYYIIIIIII', 'IYYIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIZZII', 'IIIIIIZZIIII', 'IIIIZZIIIIII', 'IIZZIIIIIIII', 'ZZIIIIIIIIII', 'IIIIIIIIIZZI', 'IIIIIIIZZIII', 'IIIIIZZIIIII', 'IIIZZIIIIIII', 'IZZIIIIIIIII']

even-odd edge-grouped:
['IIIIIIIIIIXX', 'IIIIIIIIIIYY', 'IIIIIIIIIIZZ', 'IIIIIIIIXXII', 'IIIIIIIIYYII', 'IIIIIIIIZZII', 'IIIIIIXXIIII', 'IIIIIIYYIIII', 'IIIIIIZZIIII', 'IIIIXXIIIIII', 'IIIIYYIIIIII', 'IIIIZZIIIIII', 'IIXXIIIIIIII', 'IIYYIIIIIIII', 'IIZZIIIIIIII', 'XXIIIIIIIIII', 'YYIIIIIIIIII', 'ZZIIIIIIIIII', 'IIIIIIIIIXXI', 'IIIIIIIIIYYI', 'IIIIIIIIIZZI', 'IIIIIIIXXIII', 'IIIIIIIYYIII', 'IIIIIIIZZIII', 'IIIIIXXIIIII', 'IIIIIYYIIIII', 'IIIIIZZIIIII', 'IIIXXIIIIIII', 'IIIYYIIIIIII', 'IIIZZIIIIIII', 'IXXIIIIIIIII', 'IYYIIIIIIIII', 'IZZIIIIIIIII']

Precomputing the exact evolution operator... Done
Najpierw utrzymujemy regułę syntezy stałą na jeden krok Trottera pierwszego rzędu i zmieniamy jedynie kolejność wyrazów Pauliego. Celem tego porównania jest głównie zobaczenie, o ile można zmniejszyć głębokość obwodu i koszt bramek dwukubitowych, odsłaniając rozłączne krawędzie najbliższych sąsiadów dla transpilera.
ordering_comparison_rows = []
infidelity_reps = [1, 2, 4, 8]

for ordering, ham_ordered in hamiltonians_by_ordering.items():
    for reps in infidelity_reps:
        circuit = build_numeric_evolution_circuit(
            ham_ordered,
            LieTrotter,
            comparison_time,
            reps=reps,
        )
        decomposed_circuit = simple_transpilation(circuit)
        infidelity = process_infidelity(decomposed_circuit, exact_matrix)
        ordering_comparison_rows.append(
            {
                "ordering": ordering,
                "synthesis": f"LieTrotter(reps={reps})",
                "infidelity": infidelity,
                **summarize_circuit(decomposed_circuit),
            }
        )
        if reps == 1:
            print(f"Circuit for {ordering} ordering:")
            print([op for op, _ in ham_ordered.to_list()])
            display(decomposed_circuit.draw("mpl", fold=-1, scale=0.6))

ordering_comparison_df = pd.DataFrame(ordering_comparison_rows)
display(ordering_comparison_df)

hamiltonian_for_synthesis = hamiltonians_by_ordering["even-odd edge-grouped"]
Circuit for naive ordering:
['IIIIIIIIIIXX', 'IIIIIIIIIXXI', 'IIIIIIIIXXII', 'IIIIIIIXXIII', 'IIIIIIXXIIII', 'IIIIIXXIIIII', 'IIIIXXIIIIII', 'IIIXXIIIIIII', 'IIXXIIIIIIII', 'IXXIIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIIYYI', 'IIIIIIIIYYII', 'IIIIIIIYYIII', 'IIIIIIYYIIII', 'IIIIIYYIIIII', 'IIIIYYIIIIII', 'IIIYYIIIIIII', 'IIYYIIIIIIII', 'IYYIIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIIZZI', 'IIIIIIIIZZII', 'IIIIIIIZZIII', 'IIIIIIZZIIII', 'IIIIIZZIIIII', 'IIIIZZIIIIII', 'IIIZZIIIIIII', 'IIZZIIIIIIII', 'IZZIIIIIIIII', 'ZZIIIIIIIIII']

Circuit for even-then-odd ordering:
['IIIIIIIIIIXX', 'IIIIIIIIXXII', 'IIIIIIXXIIII', 'IIIIXXIIIIII', 'IIXXIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIXXI', 'IIIIIIIXXIII', 'IIIIIXXIIIII', 'IIIXXIIIIIII', 'IXXIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIYYII', 'IIIIIIYYIIII', 'IIIIYYIIIIII', 'IIYYIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIYYI', 'IIIIIIIYYIII', 'IIIIIYYIIIII', 'IIIYYIIIIIII', 'IYYIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIZZII', 'IIIIIIZZIIII', 'IIIIZZIIIIII', 'IIZZIIIIIIII', 'ZZIIIIIIIIII', 'IIIIIIIIIZZI', 'IIIIIIIZZIII', 'IIIIIZZIIIII', 'IIIZZIIIIIII', 'IZZIIIIIIIII']

Circuit for even-odd edge-grouped ordering:
['IIIIIIIIIIXX', 'IIIIIIIIIIYY', 'IIIIIIIIIIZZ', 'IIIIIIIIXXII', 'IIIIIIIIYYII', 'IIIIIIIIZZII', 'IIIIIIXXIIII', 'IIIIIIYYIIII', 'IIIIIIZZIIII', 'IIIIXXIIIIII', 'IIIIYYIIIIII', 'IIIIZZIIIIII', 'IIXXIIIIIIII', 'IIYYIIIIIIII', 'IIZZIIIIIIII', 'XXIIIIIIIIII', 'YYIIIIIIIIII', 'ZZIIIIIIIIII', 'IIIIIIIIIXXI', 'IIIIIIIIIYYI', 'IIIIIIIIIZZI', 'IIIIIIIXXIII', 'IIIIIIIYYIII', 'IIIIIIIZZIII', 'IIIIIXXIIIII', 'IIIIIYYIIIII', 'IIIIIZZIIIII', 'IIIXXIIIIIII', 'IIIYYIIIIIII', 'IIIZZIIIIIII', 'IXXIIIIIIIII', 'IYYIIIIIIIII', 'IZZIIIIIIIII']

ordering           synthesis  infidelity  depth  size  \
0                   naive  LieTrotter(reps=1)    0.999917     15    33
1                   naive  LieTrotter(reps=2)    0.805998     21    66
2                   naive  LieTrotter(reps=4)    0.271389     33   132
3                   naive  LieTrotter(reps=8)    0.074590     57   264
4           even-then-odd  LieTrotter(reps=1)    0.999917      6    33
5           even-then-odd  LieTrotter(reps=2)    0.805998     12    66
6           even-then-odd  LieTrotter(reps=4)    0.271389     24   132
7           even-then-odd  LieTrotter(reps=8)    0.074590     48   264
8   even-odd edge-grouped  LieTrotter(reps=1)    0.998432      6    33
9   even-odd edge-grouped  LieTrotter(reps=2)    0.653843     12    66
10  even-odd edge-grouped  LieTrotter(reps=4)    0.181529     24   132
11  even-odd edge-grouped  LieTrotter(reps=8)    0.045244     48   264

    2q gates  2q depth
0         33        15
1         66        21
2        132        33
3        264        57
4         33         6
5         66        12
6        132        24
7        264        48
8         33         6
9         66        12
10       132        24
11       264        48
Przy reps=1 obserwujemy, że zarówno kolejność parzyste-potem-nieparzyste, jak i parzysto-nieparzysta z grupowaniem krawędzi, zmniejszają głębokość z 15 do 6 poprzez odsłonięcie równoległych warstw dwukubitowych, podczas gdy liczba bramek dwukubitowych pozostaje taka sama we wszystkich trzech kolejnościach.
Jednak wszystkie trzy kolejności mają nieporzeczność bliską 1, więc przemiatamy liczbę powtórzeń Trottera, aby wyraźniej rozdzielić kolejności.
W miarę wzrostu liczby powtórzeń nieporzeczność kolejności even-odd edge-grouped spada szybciej niż w pozostałych dwóch, osiągając 0,045 przy reps=8 w porównaniu do 0,075 dla naiwnej i parzyste-potem-nieparzyste kolejności.
Porównanie syntezy formuły produktowej
Następnie badamy różne zaawansowane ustawienia trotteryzacji, przy ustalonej kolejności hamiltonianu na parzysto-nieparzystą z grupowaniem krawędzi. Rozważamy Lie-Trottera pierwszego rzędu, Suzuki-Trottera drugiego rzędu i Suzuki-Trottera czwartego rzędu.
synthesis_comparison_rows = []

for num_trotter_steps in [1, 2, 3, 4, 5]:
    synthesis_cases = [
        ("LieTrotter", LieTrotter, {"reps": num_trotter_steps}),
        (
            "SuzukiTrotter(order=2)",
            SuzukiTrotter,
            {"order": 2, "reps": num_trotter_steps},
        ),
        (
            "SuzukiTrotter(order=4)",
            SuzukiTrotter,
            {"order": 4, "reps": num_trotter_steps},
        ),
    ]
    for label, synthesis, kwargs in synthesis_cases:
        circuit = build_numeric_evolution_circuit(
            hamiltonian_for_synthesis,
            synthesis,
            comparison_time,
            **kwargs,
        )
        decomposed_circuit = simple_transpilation(circuit)
        synthesis_comparison_rows.append(
            {
                "synthesis": label,
                "reps": kwargs["reps"],
                "infidelity": process_infidelity(
                    decomposed_circuit, exact_matrix
                ),
                **summarize_circuit(decomposed_circuit),
            }
        )

synthesis_comparison_df = pd.DataFrame(synthesis_comparison_rows)
display(synthesis_comparison_df.sort_values(["2q gates", "2q depth"]))

# For memory free
exact_matrix = None
synthesis  reps    infidelity  depth  size  2q gates  \
0               LieTrotter     1  9.984324e-01      6    33        33
1   SuzukiTrotter(order=2)     1  9.733399e-01      9    51        51
3               LieTrotter     2  6.538427e-01     12    66        66
4   SuzukiTrotter(order=2)     2  2.522533e-01     15    84        84
6               LieTrotter     3  3.197242e-01     18    99        99
7   SuzukiTrotter(order=2)     3  4.804050e-02     21   117       117
9               LieTrotter     4  1.815291e-01     24   132       132
10  SuzukiTrotter(order=2)     4  1.453103e-02     27   150       150
12              LieTrotter     5  1.161770e-01     30   165       165
2   SuzukiTrotter(order=4)     1  2.884402e-01     33   183       183
13  SuzukiTrotter(order=2)     5  5.803455e-03     33   183       183
5   SuzukiTrotter(order=4)     2  1.641162e-03     63   348       348
8   SuzukiTrotter(order=4)     3  2.907076e-05     93   513       513
11  SuzukiTrotter(order=4)     4  2.791061e-06    123   678       678
14  SuzukiTrotter(order=4)     5  4.736685e-07    153   843       843

    2q depth
0          6
1          9
3         12
4         15
6         18
7         21
9         24
10        27
12        30
2         33
13        33
5         63
8         93
11       123
14       153
Lie-Trotter daje najpłytszy obwód, ale ma największy błąd, podczas gdy Suzuki-Trotter czwartego rzędu jest dokładniejszy, ale zwiększa głębokość obwodu. W pozostałej części tutoriala wybieramy Suzuki-Trottera drugiego rzędu, ponieważ daje obwód o małej głębokości, jednocześnie znacznie zmniejszając błąd Trottera w stosunku do formuły pierwszego rzędu.
Usunięcie kontrolowanej bramki ewolucji w czasie
W rozszerzonym teście swap, kontrolowanie ewolucji w czasie za pomocą pojedynczego kubitu pomocniczego wymaga, aby kubit pomocniczy kontrolował wiele bramek w całym systemie. Może to wprowadzić znaczny narzut trasowania, a w najgorszym przypadku efektywnie wymagać łączności wszystko-z-jednym. Aby tego uniknąć, możliwa jest dalsza optymalizacja poprzez zastąpienie kontrolowanej bramki ewolucji w czasie wersją bezkontrolną, wykorzystującą symetrię hamiltonianu. Przyjrzyjmy się poniższemu obwodowi.
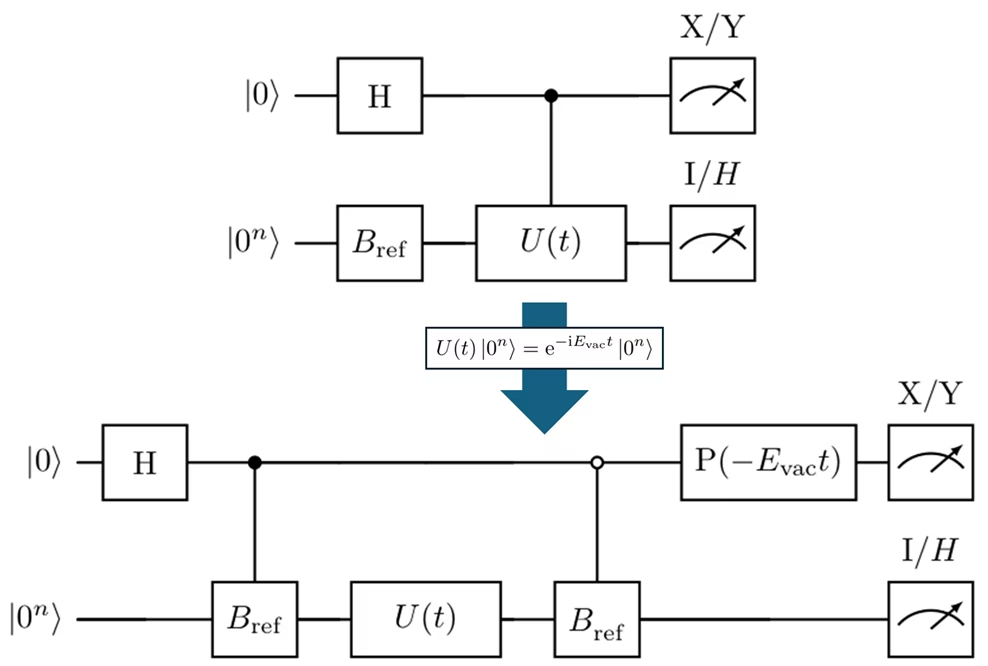
Tutaj przygotowuje stan referencyjny, .
Zamiast najpierw przygotować , a następnie zastosować jedynie na gałęzi , obwód bezpośrednio przygotowuje obie gałęzie jako
where
Obwód najpierw stosuje bramkę Hadamarda na kubicie pomocniczym i przygotowuje stan referencyjny jedynie na gałęzi :
Następnie niekontrolowany operator ewolucji w czasie jest stosowany do obu gałęzi:
Ponieważ hamiltonian zachowuje liczbę wzbudzeń, widzimy, że jest jego stanem własnym, a zatem operator ewolucji jedynie gromadzi fazę pod wpływem hamiltonianu:
Therefore,
Następnie jest stosowane jedynie na gałęzi .
W tym momencie obie gałęzie mają dodatkową fazę względną. Aby ją usunąć, stosujemy bramkę fazy kubitu pomocniczego
Przekształca to stan jako
Zatem, z dokładnością do nieistotnej globalnej fazy, w końcu przygotowaliśmy
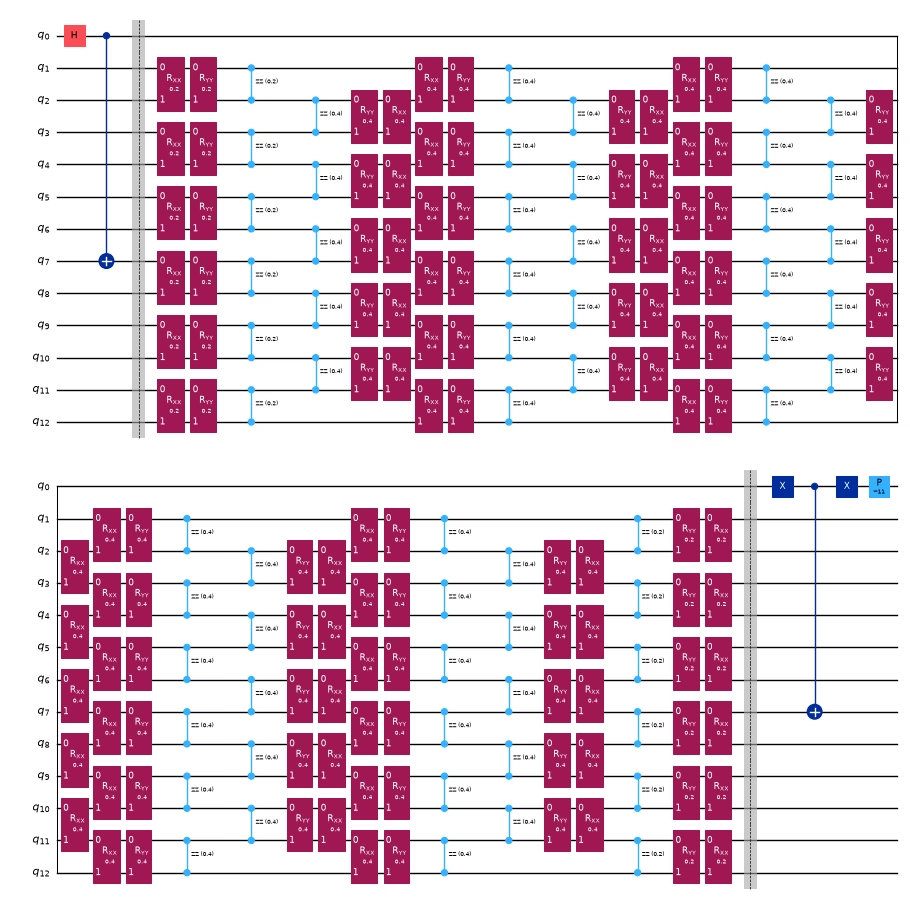
W kolejnym bloku kodu implementujemy ten bezkontrolny obwód.
controlled_extended_swap_test = extended_swap_test

# Reuse the ordering and synthesis rule selected by the comparison above.
evol_gate_optimized = PauliEvolutionGate(
    hamiltonian_for_synthesis,
    time=t,
    synthesis=SuzukiTrotter(order=2, reps=num_trotter_steps),
)

uncontrolled_evolution = QuantumCircuit(num_qubits, name="U_ST2(t)")
uncontrolled_evolution.append(evol_gate_optimized, range(num_qubits))

controlled_state_prep = QuantumCircuit(num_qubits + 1, name="C-Prep")
for q, bit in enumerate(reversed(ref_bitstring)):
    if bit == "1":
        controlled_state_prep.cx(ancilla, system_qubits[q])

vacuum_bitstring = "0" * num_qubits
vacuum_energy = basis_state_expectation_sparse(hamiltonian, "0" * num_qubits)

optimized_extended_swap_test = QuantumCircuit(num_qubits + 1)
optimized_extended_swap_test.h(ancilla)

# Prepare |psi_ref> only on the |1> branch.
optimized_extended_swap_test.compose(controlled_state_prep, inplace=True)
optimized_extended_swap_test.barrier()

# Apply the Trotterized time evolution without control.
optimized_extended_swap_test.compose(
    uncontrolled_evolution,
    qubits=system_qubits,
    inplace=True,
)
optimized_extended_swap_test.barrier()

# Map |0>|0...0> to |0>|psi_ref>, leaving the |1> branch unchanged.
optimized_extended_swap_test.x(ancilla)
optimized_extended_swap_test.compose(controlled_state_prep, inplace=True)
optimized_extended_swap_test.x(ancilla)

# Cancel the known vacuum phase so that the same X/Y observables can be used.
optimized_extended_swap_test.p(-vacuum_energy * t, ancilla)
optimized_extended_swap_test = simple_transpilation(
    optimized_extended_swap_test
)

print(f"Vacuum energy E_vac = {vacuum_energy:.1f}")
display(
    optimized_extended_swap_test.assign_parameters({t: 1.0}).draw(
        "mpl", scale=0.5, fold=26
    )
)
Vacuum energy E_vac = 11.0+0.0j
Transpilacja
Teraz transpilujemy kontrolowane i bezkontrolne obwody, aby stały się wykonywalne na sprzęcie. Porównajmy wynik transpilowanych obwodów.
pass_manager = generate_preset_pass_manager(
    backend=backend,
    optimization_level=3,
)

isa_controlled_extended_swap_test = pass_manager.run(
    controlled_extended_swap_test
)

pass_manager = generate_preset_pass_manager(
    backend=backend, optimization_level=3, routing_method="none"
)
isa_optimized_extended_swap_test = pass_manager.run(
    optimized_extended_swap_test
)

transpilation_result = [
    {
        "label": "abstract controlled U(t)",
        **summarize_circuit(isa_controlled_extended_swap_test),
    },
    {
        "label": "optimized non-controlled U(t)",
        **summarize_circuit(isa_optimized_extended_swap_test),
    },
]

display(pd.DataFrame(transpilation_result))

def filter_qubits_from_layout(layout):
    q_layout = Layout(
        {
            physical: virtual
            for physical, virtual in layout.get_physical_bits().items()
            if virtual._register.name == "q"
        }
    )
    return q_layout

print(
    filter_qubits_from_layout(
        isa_optimized_extended_swap_test.layout.initial_layout
    )
)

isa_observables = [
    op.apply_layout(isa_optimized_extended_swap_test.layout)
    for op in observables
]
label  depth   size  2q gates  2q depth
0       abstract controlled U(t)  15457  23786      4686      4580
1  optimized non-controlled U(t)    261   1716       307        57
Layout({
18: <Qubit register=(13, "q"), index=0>,
5: <Qubit register=(13, "q"), index=1>,
6: <Qubit register=(13, "q"), index=2>,
7: <Qubit register=(13, "q"), index=3>,
8: <Qubit register=(13, "q"), index=4>,
9: <Qubit register=(13, "q"), index=5>,
10: <Qubit register=(13, "q"), index=6>,
11: <Qubit register=(13, "q"), index=7>,
12: <Qubit register=(13, "q"), index=8>,
13: <Qubit register=(13, "q"), index=9>,
14: <Qubit register=(13, "q"), index=10>,
15: <Qubit register=(13, "q"), index=11>,
19: <Qubit register=(13, "q"), index=12>
})
Krok 3: Wykonanie przy użyciu prymitywów Qiskit
Kolejnym krokiem jest przesłanie tego samego sparametryzowanego obwodu dla kilku wartości . Dla każdego estymujemy cztery wartości oczekiwane: , , i . Te cztery liczby są następnie łączone w zespolone elementy pierwszego wiersza i .
Tutaj i można obliczyć klasycznie, ponieważ jest rzadki, więc pomijamy przypadek .
pub_list = []
d_values = list(range(1, krylov_dim))

# Exact local statevector estimator.
estimator = StatevectorEstimator()

# We use the circuit before the transpilation for the local simulator,
# but we will use the transpiled circuit for the real backend.
for d in d_values:
    parameter_values = [d * dt]

    for ob in observables:
        pub_list.append(
            (
                optimized_extended_swap_test,
                ob,
                parameter_values,
            )
        )

job = estimator.run(pub_list)

# Local PrimitiveJob does not provide Runtime-style job inputs,
# so preserve the inputs directly.
inputs = pub_list
result = job.result()

print(f"Number of Krylov basis states: r = {len(d_values)}")
print(f"Number of PUBs: {len(pub_list)}")
print(f"Each d uses observables: {observable_labels}")
Number of Krylov basis states: r = 9
Number of PUBs: 36
Each d uses observables: ['Re S_0d', 'Im S_0d', 'Re shifted H_0d', 'Im shifted H_0d']
Krok 4: Przetwarzanie końcowe i zwracanie wyniku w żądanym formacie klasycznym
Po oszacowaniu zrzutowanych macierzy regularyzujemy je i rozwiązujemy GEVP
Najmniejsza uogólniona wartość własna daje estymatę KQD energii stanu podstawowego.
h_shifted_row_est = np.zeros(krylov_dim, dtype=complex)
s_row_est = np.zeros(krylov_dim, dtype=complex)

h_shifted_row_est[0] = ref_energy - shift_tau
s_row_est[0] = 1.0

for idx, (pub_input, pub_result) in enumerate(zip(inputs, result)):
    d_index, obs_index = divmod(idx, len(observables))
    ev = np.asarray(pub_result.data.evs).reshape(-1)[0]
    std = np.asarray(pub_result.data.stds).reshape(-1)[0]

    if obs_index == 0:
        s_row_est[d_index + 1] = ev
    elif obs_index == 1:
        s_row_est[d_index + 1] += 1j * ev
    elif obs_index == 2:
        h_shifted_row_est[d_index + 1] = ev
    elif obs_index == 3:
        h_shifted_row_est[d_index + 1] += 1j * ev

# H_0d = shifted_H_0d + tau * S_0d.
h_row_est = h_shifted_row_est + shift_tau * s_row_est

h_matrix_est = la.toeplitz(h_row_est.conj(), h_row_est)
s_matrix_est = la.toeplitz(s_row_est.conj(), s_row_est)

s_eigvals = la.eigvalsh(0.5 * (s_matrix_est + s_matrix_est.conj().T))
positive_s_eigvals = s_eigvals[s_eigvals > 1e-12]
s_condition_number = (
    positive_s_eigvals[-1] / positive_s_eigvals[0]
    if len(positive_s_eigvals) > 0
    else np.inf
)

with np.printoptions(precision=3, suppress=True):
    print("Estimated first row of S:")
    print(s_row_est)
    print()
    print("Estimated first row of H:")
    print(h_row_est)
    print()
    print("Eigenvalues of the estimated overlap matrix S:")
    print(s_eigvals)
    print(f"Condition number above 1e-12: {s_condition_number:.3e}")
    print()
Estimated first row of S:
[ 1.   +0.j     0.758-0.596j  0.203-0.836j -0.291-0.636j -0.444-0.229j
 -0.276+0.053j -0.044+0.051j  0.006-0.121j -0.155-0.218j -0.345-0.101j]

Estimated first row of H:
[ 7.   +0.j     4.842-4.76j   0.044-6.185j -3.791-3.653j -4.137+0.39j
 -1.495+2.654j  1.331+1.777j  1.85 -0.763j -0.032-2.278j -2.222-1.372j]

Eigenvalues of the estimated overlap matrix S:
[-0.     0.     0.     0.     0.     0.     0.01   0.355  3.526  6.109]
Condition number above 1e-12: 1.904e+12
Teraz rozwiązujemy uogólniony problem wartości własnych, używając macierzy odtworzonych z estymacji obwodowych. W idealnym obliczeniu wektora stanu z dokładną ewolucją w czasie rzeczywistym powinno to odtworzyć dokładny zrzutowany wynik. W praktyce odchylenia mogą pochodzić z trotteryzacji, błędu próbkowania oraz niestabilności numerycznej macierzy przekrywania.
Obserwujemy, jak energia zbiega się w miarę zwiększania wymiaru podprzestrzeni Kryłowa.
exact_evals = diagonalize_single_1_subspace(hamiltonian)
exact_ground = min(exact_evals)
print("exact ground state energy:  ", exact_ground)

threshold = 1e-12
energy_convergence = []

for r in range(1, krylov_dim + 1):
    energy_est_kqd, coeffs_est, retained_est = solve_thresholded_gevp(
        h_matrix_est[:r, :r],
        s_matrix_est[:r, :r],
        threshold=threshold,
    )
    energy_convergence.append(energy_est_kqd)
    print(
        f"Krylov ground state energy (dim={r}, retained={retained_est}): ",
        energy_est_kqd,
    )
exact ground state energy:   3.136296694843727
Krylov ground state energy (dim=1, retained=1):  7.0
Krylov ground state energy (dim=2, retained=2):  4.184510657551266
Krylov ground state energy (dim=3, retained=3):  3.5539074630394136
Krylov ground state energy (dim=4, retained=4):  3.3366270761341044
Krylov ground state energy (dim=5, retained=5):  3.252017453225087
Krylov ground state energy (dim=6, retained=6):  3.2300275138879186
Krylov ground state energy (dim=7, retained=7):  3.2299154099085685
Krylov ground state energy (dim=8, retained=7):  3.2298063744216776
Krylov ground state energy (dim=9, retained=7):  3.2296778282872456
Krylov ground state energy (dim=10, retained=8):  3.223647515867734
def plot_energy_convergence(energy_convergence, exact_ground, krylov_dim):
    fig, ax = plt.subplots(figsize=(7, 4.5))

    ax.plot(
        range(1, krylov_dim + 1),
        energy_convergence,
        marker="o",
        label="KQD estimate",
    )

    ax.axhline(
        exact_ground,
        linestyle="--",
        label=f"Exact ground energy = {exact_ground:.6f}",
    )

    ax.set_xlabel("Krylov dimension")
    ax.set_ylabel("Ground-state energy")
    ax.grid(True, alpha=0.3)
    ax.legend()
    plt.tight_layout()
    plt.show()

plot_energy_convergence(energy_convergence, exact_ground, krylov_dim)

Przykład wielkoskalowego sprzętu
Poprzednia sekcja wykorzystywała model 12-kubitowy, dzięki czemu można było użyć symulacji wektora stanu jako diagnostyki. Teraz skalujemy ten sam przepływ pracy KQD do 30-kubitowego łańcucha Heisenberga i przygotowujemy zadanie do wykonania na sprzęcie IBM Quantum.
Kroki 1-4 skompresowane w jeden blok kodu
Tutaj łączymy teraz wszystkie te szczegóły w jeden przepływ pracy na większą skalę, który jest następnie uruchamiany na naszym prawdziwym sprzęcie kwantowym. W tej sekcji stosujemy realistyczne ustawienia łagodzenia błędów, aby poprawić wiarygodność wyników. Ponieważ elementy macierzy odpowiadające różnym wartościom mogą być oceniane równolegle, używamy trybu Batch do ich efektywnego wykonania.
# -------------------------Step 1-------------------------

# Map the classical problem to quantum circuits and observables.
# Problem and KQD parameters.
large_num_qubits = 30
large_krylov_dim = 7
large_num_trotter_steps = 3
large_dt = np.pi / (3 * (large_num_qubits - 1))
large_t = Parameter("t_large")

# Use a single excitation near the center of the chain.
large_excitation_qubit = large_num_qubits // 2
large_ref_label = ["0"] * large_num_qubits
large_ref_label[large_num_qubits - 1 - large_excitation_qubit] = "1"
large_ref_bitstring = "".join(large_ref_label)

# Use the ordering and product formula selected in the preceding section.
large_hamiltonian = make_heisenberg_hamiltonian_ordered(
    large_num_qubits,
    ordering="even-odd edge-grouped",
    coupling=1.0,
)
large_ref_energy = float(
    np.real(
        basis_state_expectation_sparse(large_hamiltonian, large_ref_bitstring)
    )
)
large_vacuum_energy = float(
    np.real(
        basis_state_expectation_sparse(
            large_hamiltonian, "0" * large_num_qubits
        )
    )
)

large_evolution_gate = PauliEvolutionGate(
    large_hamiltonian,
    time=large_t,
    synthesis=SuzukiTrotter(order=2, reps=large_num_trotter_steps),
)
large_uncontrolled_evolution = QuantumCircuit(
    large_num_qubits,
    name="U_ST2_large(t)",
)
large_uncontrolled_evolution.append(
    large_evolution_gate,
    range(large_num_qubits),
)

# Build the control-free extended-swap-test circuit.
large_ancilla = 0
large_system_qubits = list(range(1, large_num_qubits + 1))

large_controlled_state_prep = QuantumCircuit(
    large_num_qubits + 1,
    name="C-Prep-large",
)
large_controlled_state_prep.cx(
    large_ancilla,
    large_system_qubits[large_excitation_qubit],
)

large_extended_swap_test = QuantumCircuit(large_num_qubits + 1)
large_extended_swap_test.h(large_ancilla)
large_extended_swap_test.compose(large_controlled_state_prep, inplace=True)
large_extended_swap_test.compose(
    large_uncontrolled_evolution,
    qubits=large_system_qubits,
    inplace=True,
)
large_extended_swap_test.x(large_ancilla)
large_extended_swap_test.compose(
    large_controlled_state_prep.inverse(),
    inplace=True,
)
large_extended_swap_test.x(large_ancilla)
large_extended_swap_test.p(
    -large_vacuum_energy * large_t,
    large_ancilla,
)

# Reuse the Hamiltonian-shifting construction from the preceding section.
(
    large_obs_x_shifted_hamiltonian,
    large_obs_y_shifted_hamiltonian,
    large_shift_tau,
) = make_reduced_heisenberg_observables(large_ref_bitstring)

large_observables = [
    SparsePauliOp("I" * large_num_qubits + "X"),
    SparsePauliOp("I" * large_num_qubits + "Y"),
    large_obs_x_shifted_hamiltonian,
    large_obs_y_shifted_hamiltonian,
]
large_observable_labels = [
    "Re S_0d",
    "Im S_0d",
    "Re shifted H_0d",
    "Im shifted H_0d",
]

# -------------------------Step 2-------------------------

# Optimize the problem for quantum execution.
# Select a real backend and transpile the parameterized circuit to ISA form.
large_backend = service.backend("ibm_boston")
large_pass_manager = generate_preset_pass_manager(
    backend=large_backend, optimization_level=3, routing_method="none"
)
large_isa_circuit = large_pass_manager.run(large_extended_swap_test)
large_isa_observables = [
    observable.apply_layout(large_isa_circuit.layout)
    for observable in large_observables
]

large_two_qubit_gate_count = sum(
    instruction.operation.num_qubits == 2
    for instruction in large_isa_circuit.data
)

print(f"Backend: {large_backend.name}")
print(f"System qubits: {large_num_qubits}")
print(f"Total circuit qubits: {large_isa_circuit.num_qubits}")
print(f"Krylov dimension: {large_krylov_dim}")
print(f"Time step: {large_dt:.6f}")
print(f"Shift tau: {large_shift_tau}")
print(f"ISA circuit depth: {large_isa_circuit.depth()}")
print(f"ISA two-qubit gates: {large_two_qubit_gate_count}")
print(
    f"ISA two-qubit depth: {large_isa_circuit.depth(lambda x: x[0].num_qubits == 2)}"
)

# -------------------------Step 3-------------------------

# Execute on quantum hardware with Qiskit Runtime primitives.
# Submit one job per d, with all four observables in that job.
large_d_values = list(range(1, large_krylov_dim))
retrieve_batch_id = None
large_jobs = []

if retrieve_batch_id is None:
    large_estimator_options = {
        "default_shots": 8192,
        "dynamical_decoupling": {
            "enable": True,
            "sequence_type": "XpXm",
        },
        "resilience": {
            "measure_mitigation": True,
            "measure_noise_learning": {
                "num_randomizations": 32,
                "shots_per_randomization": 256,
            },
            "layer_noise_learning": {
                "max_layers_to_learn": 4,
                "layer_pair_depths": [0, 1, 2, 4, 16, 32],
                "num_randomizations": 32,
                "shots_per_randomization": 128,
            },
            "zne_mitigation": True,
            "zne": {
                "amplifier": "pea",
                "noise_factors": [1.0, 1.5, 2.0],
                "extrapolator": ("exponential", "linear"),
            },
        },
        "twirling": {
            "enable_gates": True,
            "enable_measure": True,
            "num_randomizations": 32,
            "shots_per_randomization": 256,
            "strategy": "active-accum",
        },
    }

    with Batch(backend=large_backend) as large_batch:
        large_batch_id = large_batch.session_id
        large_estimator = EstimatorV2(
            mode=large_batch,
            options=large_estimator_options,
        )
        # Krylov quantum diagonalization of lattice Hamiltonians -> TUT_KQDOLH.
        large_estimator.options.environment.job_tags = ["TUT_KQDOLH"]

        for d in large_d_values:
            parameter_values = [d * large_dt]
            pubs_for_d = [
                (large_isa_circuit, observable, parameter_values)
                for observable in large_isa_observables
            ]
            job = large_estimator.run(pubs_for_d)
            large_jobs.append(job)
            print(
                f"Submitted d={d}: job_id={job.job_id()}, "
                f"PUBs={len(pubs_for_d)}"
            )

    print(f"Batch ID: {large_batch_id}")
else:
    large_batch_id = retrieve_batch_id
    large_jobs = service.jobs(
        session_id=large_batch_id,
        limit=None,
        descending=False,
    )

large_job_ids_by_d = {
    d: job.job_id() for d, job in zip(large_d_values, large_jobs)
}
print(f"Job IDs by d: {large_job_ids_by_d}")

# -------------------------Step 4-------------------------

# Post-process the quantum results and solve the classical GEVP.
# Reconstruct the first rows of S and the shifted Hamiltonian matrix.
large_s_row_est = np.zeros(large_krylov_dim, dtype=complex)
large_h_shifted_row_est = np.zeros(large_krylov_dim, dtype=complex)
large_s_row_est[0] = 1.0
large_h_shifted_row_est[0] = large_ref_energy - large_shift_tau

for d, job in zip(large_d_values, large_jobs):
    job_result = job.result()

    if len(job_result) != len(large_observables):
        raise RuntimeError(
            f"Expected {len(large_observables)} PUB results for d={d}, "
            f"but received {len(job_result)}."
        )

    expectation_values = [
        np.asarray(pub_result.data.evs).reshape(-1)[0]
        for pub_result in job_result
    ]

    large_s_row_est[d] = expectation_values[0] + 1j * expectation_values[1]
    large_h_shifted_row_est[d] = (
        expectation_values[2] + 1j * expectation_values[3]
    )

# H_0d = shifted_H_0d + tau * S_0d.
large_h_row_est = large_h_shifted_row_est + large_shift_tau * large_s_row_est

large_s_matrix_est = la.toeplitz(
    large_s_row_est.conj(),
    large_s_row_est,
)
large_h_matrix_est = la.toeplitz(
    large_h_row_est.conj(),
    large_h_row_est,
)

large_exact_gnd = min(diagonalize_single_1_subspace(large_hamiltonian))

large_energy_convergence = []

with np.printoptions(precision=5, suppress=True):
    print("Estimated first row of S:")
    print(large_s_row_est)
    print("Estimated first row of H:")
    print(large_h_row_est)
    print("exact ground state energy:  ", large_exact_gnd)

    for r in range(1, large_krylov_dim + 1):
        energy_est_kqd, coeffs_est, retained_est = solve_thresholded_gevp(
            large_h_matrix_est[:r, :r],
            large_s_matrix_est[:r, :r],
            threshold=5e-2,
        )
        large_energy_convergence.append(energy_est_kqd)
        print(
            f"Krylov ground state energy (dim={r}, retained={retained_est}): ",
            energy_est_kqd,
        )

plot_energy_convergence(
    large_energy_convergence, large_exact_gnd, large_krylov_dim
)
Backend: ibm_boston
System qubits: 30
Total circuit qubits: 156
Krylov dimension: 7
Time step: 0.036110
Shift tau: 25.0
ISA circuit depth: 219
ISA two-qubit gates: 728
ISA two-qubit depth: 52
Job IDs by d: {1: 'd9fl4p4jeosc73fk4dg0', 2: 'd9fl4pineu4c739poecg', 3: 'd9fl4q2neu4c739poedg', 4: 'd9fl4qhhtsac739fjgn0', 5: 'd9fl4r4jeosc73fk4dhg', 6: 'd9fl4rkjeosc73fk4dj0'}
Estimated first row of S:
[ 1.     +0.j       0.42055-0.65466j -0.17883-0.73125j -0.64523-0.31601j
 -0.70781+0.55574j -0.02467+0.70525j  0.59301+0.55602j]
Estimated first row of H:
[ 25.      +0.j       10.3419 -16.5586j   -5.017  -18.03933j
 -16.44797 -6.98173j -17.17081+14.84502j   0.62722+17.81196j
  15.68886+12.74875j]
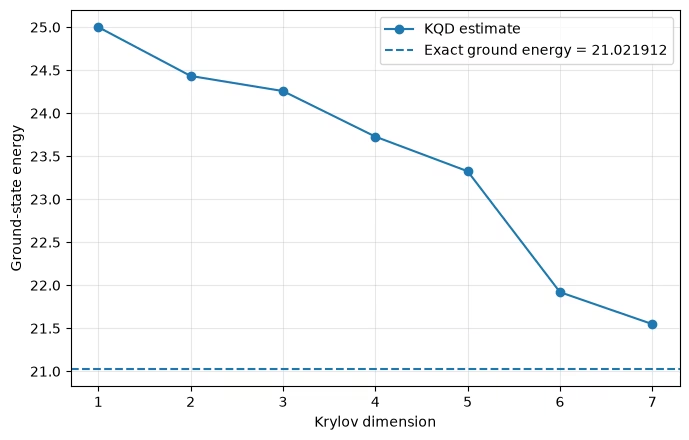
exact ground state energy:   21.021912418526902
Krylov ground state energy (dim=1, retained=1):  25.0
Krylov ground state energy (dim=2, retained=2):  24.432409110686205
Krylov ground state energy (dim=3, retained=3):  24.256856893278556
Krylov ground state energy (dim=4, retained=4):  23.727409826799715
Krylov ground state energy (dim=5, retained=4):  23.324720470780864
Krylov ground state energy (dim=6, retained=5):  21.91957579005085
Krylov ground state energy (dim=7, retained=5):  21.548331214122644
Dodatek: Perspektywa funkcji hamiltonianu (filtru spektralnego)
Główny przepływ pracy przedstawił KQD w sposób operacyjny: zbuduj bazę Kryłowa ze stanów ewoluujących w czasie rzeczywistym, oszacuj zrzutowane macierze i , i rozwiąż GEVP. Ten dodatek powraca do tego samego obliczenia z komplementarnej perspektywy, która wyjaśnia dlaczego KQD działa: perspektywa funkcji hamiltonianu, czyli filtru spektralnego [3], [5]. Wykorzystuje ponownie model 12-kubitowy, krok czasowy oraz rozwiązanie Kryłowa uzyskane już powyżej; nie jest wymagane żadne nowe wykonanie obwodu.
Stan referencyjny jako rozkład energii
Niech hamiltonian ma rozkład na wartości własne
ze stanami własnymi energii . Każdy stan referencyjny można rozwinąć w tej bazie własnej,
więc niesie ze sobą wagę spektralną przy każdej energii . Energia referencyjna to średnia tego rozkładu, .
Rozkład na wartości własne ogólnego -kubitowego hamiltonianu jest kosztowny wykładniczo, więc ten obraz stanowi jedynie diagnostykę, która nie jest częścią algorytmu. Tutaj jednak możemy obliczyć go tanio dla tego samego problemu : hamiltonian Heisenberga zachowuje całkowitą liczbę wzbudzeń, a stan referencyjny niesie pojedyncze wzbudzenie, więc cała jego zawartość spektralna mieści się w podprzestrzeni pojedynczego wzbudzenia, której wymiar rośnie tylko liniowo z . Dlatego ponownie wykorzystujemy dokładny blok pojedynczego wzbudzenia (już użyty powyżej jako punkt odniesienia) i odczytujemy rozkład referencyjny w tej podprzestrzeni.
# Exact single-excitation-subspace decomposition of the reference state.
# This reuses make_heisenberg_hamiltonian / _basis_state_transition_amplitude_sparse
# and the n=12 `hamiltonian` and `ref_bitstring` defined in the small-scale example.
single_excitation_states = [1 << k for k in range(num_qubits)]

h_single = np.array(
    [
        [
            _basis_state_transition_amplitude_sparse(hamiltonian, bra, ket)
            for ket in single_excitation_states
        ]
        for bra in single_excitation_states
    ]
)
h_single = 0.5 * (h_single + h_single.conj().T)

subspace_evals, subspace_evecs = la.eigh(h_single)
subspace_evals = np.real(subspace_evals)

# Reference-state coordinates inside the single-excitation subspace.
ref_position = single_excitation_states.index(int(ref_bitstring, 2))
ref_in_subspace = np.zeros(num_qubits, dtype=complex)
ref_in_subspace[ref_position] = 1.0

# Amplitudes and spectral weights of the reference in the energy eigenbasis.
ref_eigen_amplitudes = subspace_evecs.conj().T @ ref_in_subspace
ref_spectral_weights = np.abs(ref_eigen_amplitudes) ** 2

print(f"Single-excitation subspace dimension: {num_qubits}")
print(f"Subspace ground-state energy:         {subspace_evals[0]:.6f}")
print(
    f"Reference energy (sum p_m E_m):       {np.sum(ref_spectral_weights * subspace_evals):.6f}"
)
print(f"Reference weight on subspace ground:  {ref_spectral_weights[0]:.6f}")
Single-excitation subspace dimension: 12
Subspace ground-state energy:         3.136297
Reference energy (sum p_m E_m):       7.000000
Reference weight on subspace ground:  0.163827
KQD uczy się filtru, który przekształca ten rozkład
Funkcja hamiltonianu jest zdefiniowana poprzez rachunek spektralny,
innymi słowy, ważoną sumę projektorów własnych. Zastosowanie jej do stanu referencyjnego przekształca każdą amplitudę spektralną, :
Gdyby było ostro skupione przy najniższej energii ( i w pozostałych przypadkach), wówczas działałoby jako projektor stanu podstawowego, a znormalizowany wynik byłby (blisko) stanem podstawowym. Dlatego dobry dolnoprzepustowy filtr spektralny w energii jest dokładnie tym, czego potrzebujemy.
KQD nie ustala z góry. Zamiast tego rozwija filtr w bazie ewolucji w czasie rzeczywistym,
trygonometryczną funkcję energii, której współczynniki są dokładnie wektorem własnym GEVP rozwiązanym powyżej. Minimalizacja ilorazu Rayleigha jest zatem tym samym, co uczenie się filtru, który najlepiej tłumi wagę stanów wzbudzonych w stanie referencyjnym. Większy wymiar Kryłowa daje filtrowi więcej stopni swobody i ostrzejszy pik przy energii stanu podstawowego.
Poniższa funkcja pomocnicza oblicza ten wyuczony filtr na osi energii; następnie stosujemy go do rozkładu referencyjnego uzyskanego powyżej.
def trigonometric_krylov_filter(
    coeffs: np.ndarray,
    energies: np.ndarray,
    time_step: float,
) -> np.ndarray:
    """Evaluate the learned Krylov filter f(E) = sum_l c_l exp(-i l dt E)."""
    values = np.zeros_like(energies, dtype=complex)
    for ell, coeff in enumerate(coeffs):
        values += coeff * np.exp(-1j * ell * time_step * energies)
    return values

def filtered_spectral_weights(
    weights: np.ndarray,
    filter_values: np.ndarray,
) -> np.ndarray:
    """Reshape spectral weights by |f(E)|^2 and renormalize."""
    reshaped = weights * np.abs(filter_values) ** 2
    return reshaped / np.sum(reshaped)

# Recover the KQD coefficients from the already-estimated projected matrices.
# The shift only moves H by tau * S, so it does not change the GEVP eigenvector;
# we solve at the full Krylov dimension used in the small-scale example.
_, kqd_coeffs, _ = solve_thresholded_gevp(
    h_matrix_est,
    s_matrix_est,
    threshold=1e-12,
)

filter_on_spectrum = trigonometric_krylov_filter(
    kqd_coeffs, subspace_evals, dt
)
filtered_weights = filtered_spectral_weights(
    ref_spectral_weights, filter_on_spectrum
)

print(f"Ground-state overlap  (reference): {ref_spectral_weights[0]:.4f}")
print(f"Ground-state overlap  (filtered):  {filtered_weights[0]:.4f}")
print(
    f"Mean energy           (reference): {np.sum(ref_spectral_weights * subspace_evals):.6f}"
)
print(
    f"Mean energy           (filtered):  {np.sum(filtered_weights * subspace_evals):.6f}"
)
Ground-state overlap  (reference): 0.1638
Ground-state overlap  (filtered):  0.9638
Mean energy           (reference): 7.000000
Mean energy           (filtered):  3.164503
Wizualizacja filtru i jego elastyczności
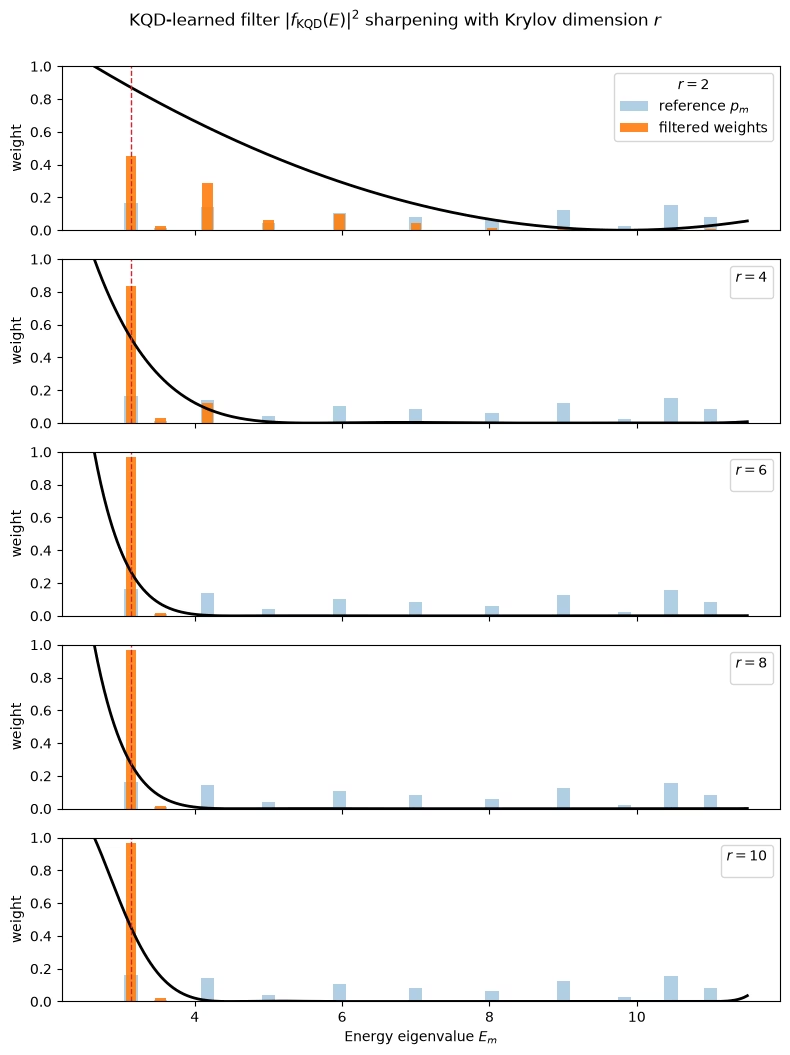
Najpierw pokazujemy wyuczony filtr przy pełnym wymiarze Kryłowa użytym powyżej, a następnie śledzimy, jak się on wyostrza w miarę wzrostu wymiaru .
Słupki pokazują referencyjne wagi spektralne (przed) i przefiltrowane wagi (po), wraz z wyuczoną intensywnością filtru na ciągłej osi energii. Filtr koncentruje wagę na najniższej energii podprzestrzeni pojedynczego wzbudzenia — tej samej energii, do której zbiegła estymata KQD w przykładzie o małej skali. Zauważ, że jest to stan podstawowy w obrębie sektora pojedynczego wzbudzenia, który jest odpowiednim celem dla tego zachowującego wzbudzenie stanu referencyjnego, a nie globalny stan podstawowy.
fig, ax = plt.subplots(figsize=(8, 4))

visible = (ref_spectral_weights > 1e-4) | (filtered_weights > 1e-4)
ax.bar(
    subspace_evals[visible],
    ref_spectral_weights[visible],
    width=0.18,
    alpha=0.45,
    label="reference $p_m$",
)
ax.bar(
    subspace_evals[visible],
    filtered_weights[visible],
    width=0.14,
    alpha=0.9,
    label=r"filtered $p_m\,|f_{\rm KQD}(E_m)|^2$",
)

energy_grid = np.linspace(
    subspace_evals.min() - 0.5, subspace_evals.max() + 0.5, 800
)
filter_intensity = (
    np.abs(trigonometric_krylov_filter(kqd_coeffs, energy_grid, dt)) ** 2
)
filter_intensity /= filter_intensity.max()
ax.plot(
    energy_grid,
    filter_intensity,
    color="k",
    linewidth=2,
    label=r"$|f_{\rm KQD}(E)|^2$ (normalized)",
)

ax.axvline(
    subspace_evals[0],
    color="C3",
    linestyle="--",
    linewidth=1,
    label="subspace ground energy",
)
ax.set_xlabel("Energy eigenvalue $E_m$")
ax.set_ylabel("Spectral weight")
ax.set_ylim(0, 1)
ax.legend(loc="upper right")
plt.tight_layout()
plt.show()

Zwiększanie wymiaru Kryłowa: elastyczność wyuczonej funkcji
Przypomnijmy, że wyuczony filtr jest wielomianem trygonometrycznym energii z współczynnikami,
Wymiar Kryłowa jest dokładnie liczbą wolnych współczynników, więc kontroluje on elastyczność funkcji. Mały może wytworzyć jedynie szeroki, łagodnie zmieniający się filtr, który przecieka wagę do nisko leżących stanów wzbudzonych; gdy rośnie, filtr może utworzyć węższy pik przy docelowej energii i bardziej agresywnie tłumić pozostałą wagę stanów wzbudzonych. Jest to spektralny odpowiednik zbieżności energii obserwowanej w przykładzie o małej skali: w miarę wzrostu przefiltrowany rozkład zapada się do stanu podstawowego podprzestrzeni, a estymowana energia maleje w jego kierunku.
Ponownie wykorzystujemy zrzutowane macierze już oszacowane powyżej i po prostu rozwiązujemy GEVP dla każdego wiodącego bloku , a następnie obliczamy i wykreślamy odpowiadający filtr.
# Sweep the Krylov dimension using the leading r x r blocks of the estimated matrices.
sweep_dims = [r for r in (2, 4, 6, 8, krylov_dim) if r <= krylov_dim]
sweep_dims = sorted(set(sweep_dims))

energy_grid = np.linspace(
    subspace_evals.min() - 0.5, subspace_evals.max() + 0.5, 800
)

sweep_cases = []
print(" r    retained    ground overlap    filtered energy")
print("--    --------    --------------    ---------------")
for r in sweep_dims:
    _, coeffs_r, retained_r = solve_thresholded_gevp(
        h_matrix_est[:r, :r],
        s_matrix_est[:r, :r],
        threshold=1e-12,
    )
    filter_on_spectrum_r = trigonometric_krylov_filter(
        coeffs_r, subspace_evals, dt
    )
    filtered_weights_r = filtered_spectral_weights(
        ref_spectral_weights, filter_on_spectrum_r
    )
    filtered_energy_r = float(np.sum(filtered_weights_r * subspace_evals))

    sweep_cases.append((r, coeffs_r, filtered_weights_r))
    print(
        f"{r:2d}    {retained_r:8d}    {filtered_weights_r[0]:14.4f}    {filtered_energy_r:15.6f}"
    )

print(f"\nSubspace ground-state energy (target): {subspace_evals[0]:.6f}")

# One panel per Krylov dimension: filtered spectrum (bars) + filter intensity (curve).
fig, axes = plt.subplots(
    len(sweep_cases),
    1,
    figsize=(8, 2.1 * len(sweep_cases)),
    sharex=True,
)
axes = np.atleast_1d(axes)

for idx, (ax, (r, coeffs_r, filtered_weights_r)) in enumerate(
    zip(axes, sweep_cases)
):
    visible = (ref_spectral_weights > 1e-4) | (filtered_weights_r > 1e-4)
    ax.bar(
        subspace_evals[visible],
        ref_spectral_weights[visible],
        width=0.18,
        alpha=0.35,
        color="C0",
        label="reference $p_m$" if idx == 0 else None,
    )
    ax.bar(
        subspace_evals[visible],
        filtered_weights_r[visible],
        width=0.14,
        alpha=0.9,
        color="C1",
        label="filtered weights" if idx == 0 else None,
    )

    filter_intensity_r = (
        np.abs(trigonometric_krylov_filter(coeffs_r, energy_grid, dt)) ** 2
    )
    filter_intensity_r /= filter_intensity_r.max()
    ax.plot(energy_grid, filter_intensity_r, color="k", linewidth=2)

    ax.axvline(subspace_evals[0], color="C3", linestyle="--", linewidth=1)
    ax.set_ylim(0, 1)
    ax.set_ylabel("weight")
    ax.legend(loc="upper right", title=f"$r={r}$")

axes[-1].set_xlabel("Energy eigenvalue $E_m$")
fig.suptitle(
    r"KQD-learned filter $|f_{\rm KQD}(E)|^2$ sharpening with Krylov dimension $r$",
    y=1.0,
)
fig.tight_layout()
plt.show()
r    retained    ground overlap    filtered energy
--    --------    --------------    ---------------
 2           2            0.4549           4.184510
 4           4            0.8373           3.310168
 6           6            0.9706           3.158100
 8           7            0.9701           3.158725
10           8            0.9638           3.164503

Subspace ground-state energy (target): 3.136297
Kolejne kroki
Jeśli ta praca Cię zainteresowała, mogą Cię zainteresować następujące materiały:
Literatura
[1] E. N. Epperly, L. Lin, and Y. Nakatsukasa, A theory of quantum subspace diagonalization, SIAM Journal on Matrix Analysis and Applications 43, 1263-1290 (2022).
[2] N. Yoshioka, M. Amico, W. Kirby, et al., Diagonalization of large many-body Hamiltonians on a quantum processor, arXiv:2407.14431 (2024).
[3] R. M. Parrish i P. L. McMahon, Quantum filter diagonalization: quantum eigendecomposition without full quantum phase estimation, Physical Review Letters 122, 230401 (2019).
[4] G. Lee, S. Choi, J. Huh i A. F. Izmaylov, Efficient strategies for reducing sampling error in quantum Krylov subspace diagonalization, Digital Discovery 4, 954-969 (2025).
[5] G. Lee, M. Kang, J. Hong, S. Fomichev i J. Huh, Filtered Quantum Phase Estimation, arXiv:2510.04294 (2025).