Kwantowy algorytm przybliżonej optymalizacji
Szacowane zużycie zasobów: 22 minuty na procesorze Heron r3 (UWAGA: To jest tylko szacunek. Twój czas wykonania może się różnić.)
Efekty uczenia się
-
Jak odwzorować klasyczny problem optymalizacji kombinatorycznej (max-cut) na kwantowy Hamiltonian
-
Jak zaimplementować i uruchomić Kwantowy Algorytm Przybliżonej Optymalizacji (QAOA) przy użyciu sesji IBM Quantum Compute Service
-
Jak przeskalować przepływ pracy QAOA z małego przykładu na symulatorze do wykonania w skali użytkowej na sprzęcie
Wymagania wstępne
-
QAOA w szczegółach — kompleksowe omówienie algorytmu QAOA i jego stosowania w skali użytkowej
Tło
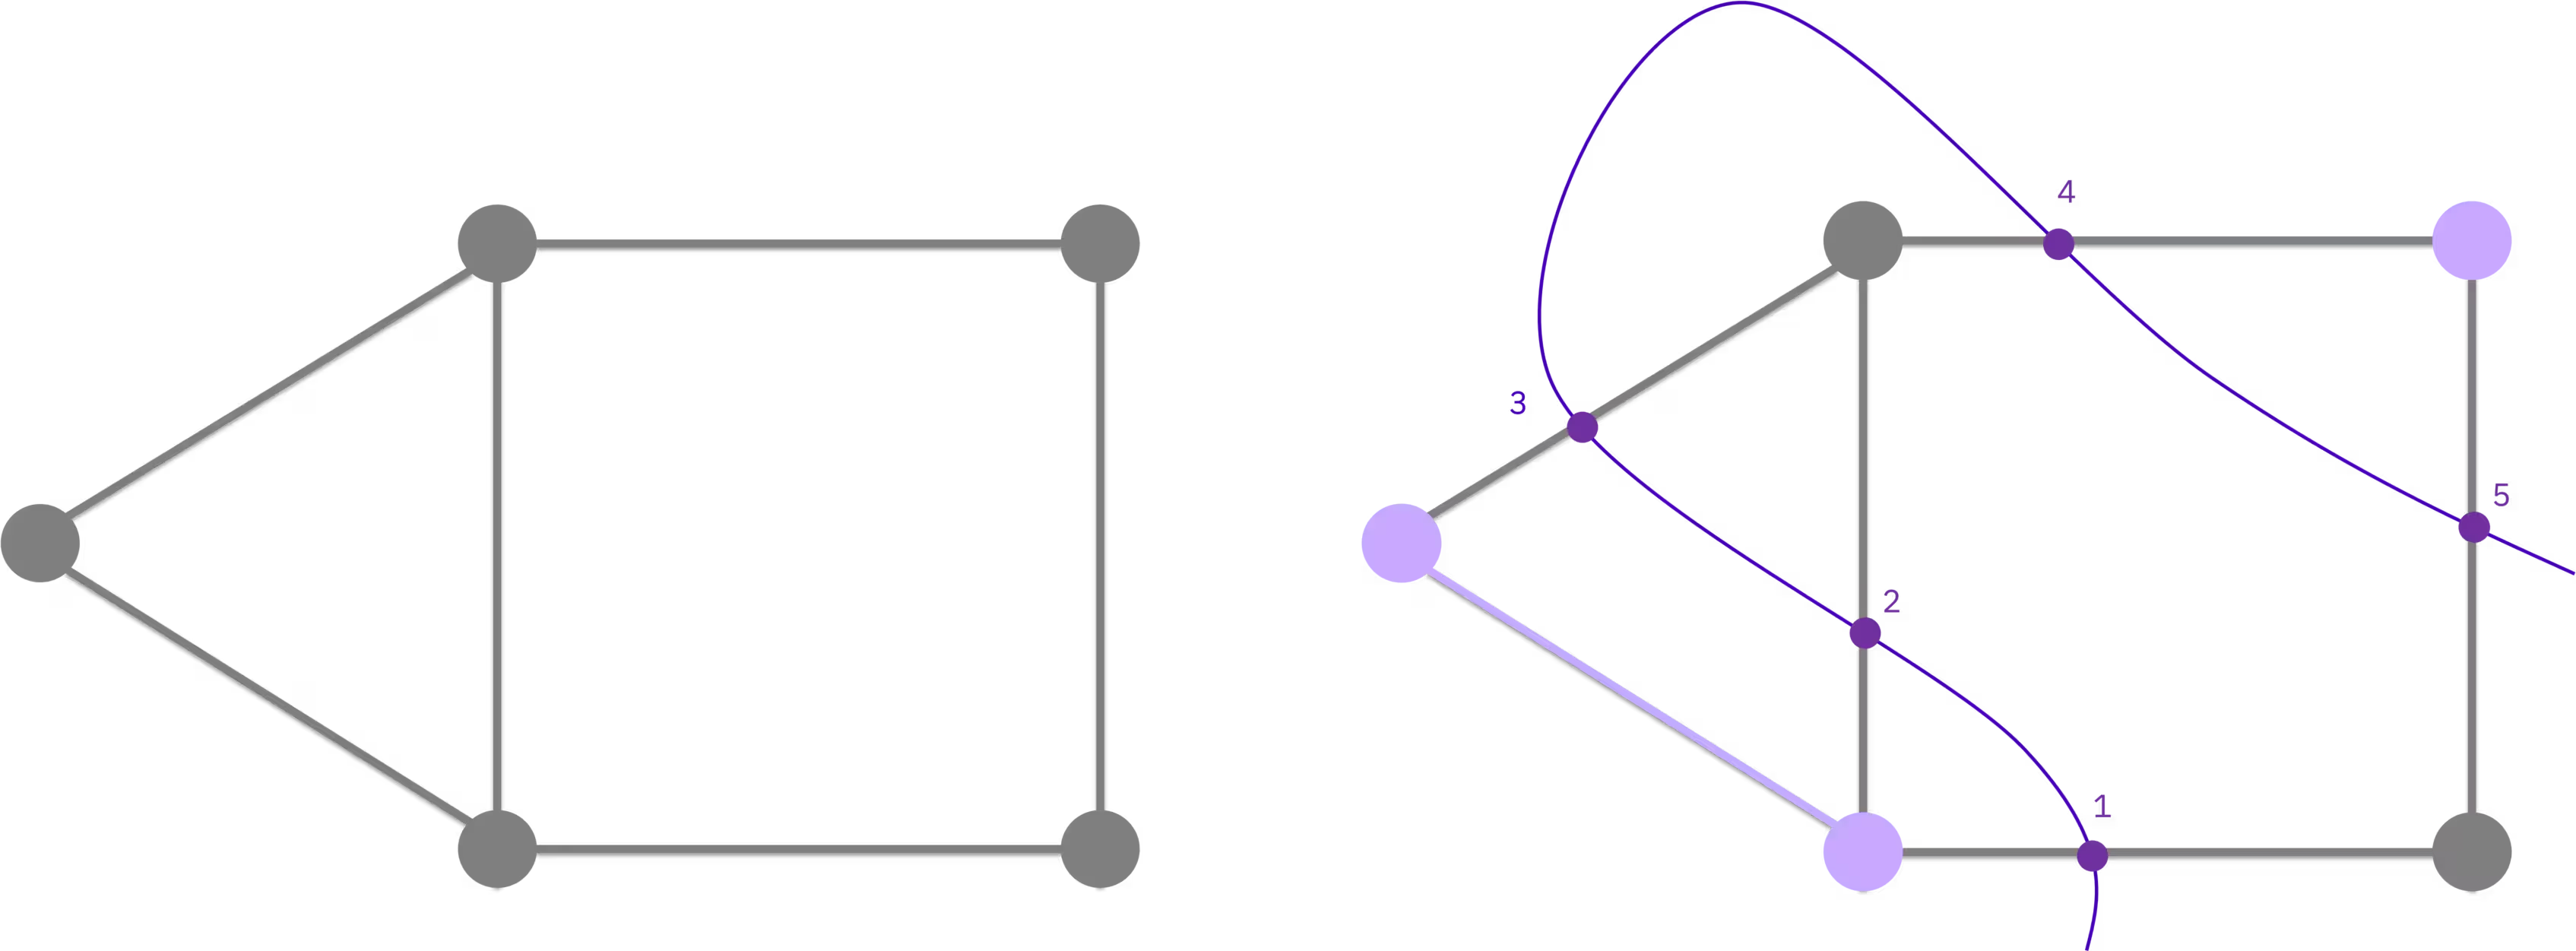
Kwantowy Algorytm Przybliżonej Optymalizacji (QAOA) to hybrydowa kwantowo-klasyczna metoda iteracyjna służąca do rozwiązywania problemów optymalizacji kombinatorycznej. W tym samouczku użyjesz QAOA do rozwiązania problemu maksymalnego cięcia (max-cut) — problemu optymalizacyjnego NP-trudnego, mającego zastosowania w klasteryzacji, nauce o sieciach i fizyce statystycznej. Mając graf węzłów połączonych krawędziami, celem jest podzielenie węzłów na dwa zbiory tak, aby liczba krawędzi przecinających podział była maksymalna.
Optymalizacja kombinatoryczna pojawia się również w wyzwaniach związanych ze zrównoważonym rozwojem, takich jak planowanie tras dostaw w celu zmniejszenia zużycia paliwa czy alokacja zasobów w celu ograniczenia marnotrawstwa materiałów. Przykład max-cut wprowadza proces wyrażania funkcji celu jako Hamiltonianu kosztu i przeszukiwania potencjalnych rozwiązań za pomocą QAOA. Zastosowanie tego podejścia do problemu zrównoważonego rozwoju wymaga celu i ograniczeń, które odzwierciedlają zamierzone zastosowanie.
Od klasycznej optymalizacji do obwodów kwantowych
Max-cut można wyrazić jako klasyczny binarny problem optymalizacyjny. Każdemu węzłowi przypisuje się zmienną binarną wskazującą, do którego zbioru należy. Celem jest maksymalizacja liczby krawędzi, których końce znajdują się w różnych zbiorach:
Jest to równoważnie problem Kwadratowej Nieograniczonej Optymalizacji Binarnej (QUBO) postaci . Poprzez standardowe podstawienie zmiennych () QUBO można przepisać jako Hamiltonian kosztu, którego stan podstawowy koduje optymalne rozwiązanie. Ogólnie ten Hamiltonian ma zarówno wyrazy kwadratowe, jak i liniowe:
W tym samouczku nie wykonujesz tego podstawienia ręcznie. Dodatek Qiskit Optimization Mapper (qiskit-addon-opt-mapper) udostępnia klasę aplikacji Maxcut, która modeluje problem bezpośrednio na podstawie grafu, konwerter zamieniający model na QUBO oraz translator odwzorowujący QUBO na . Dla rozważanego tu nieważonego problemu max-cut współczynniki liniowe znikają (), a każda krawędź wnosi składnik wraz ze stałym przesunięciem, które wiąże z wartością cięcia. Ten sam potok obsługuje grafy ważone i inne problemy wyrażalne w postaci QUBO bez zmiany reszty przepływu pracy.
Jak działa QAOA
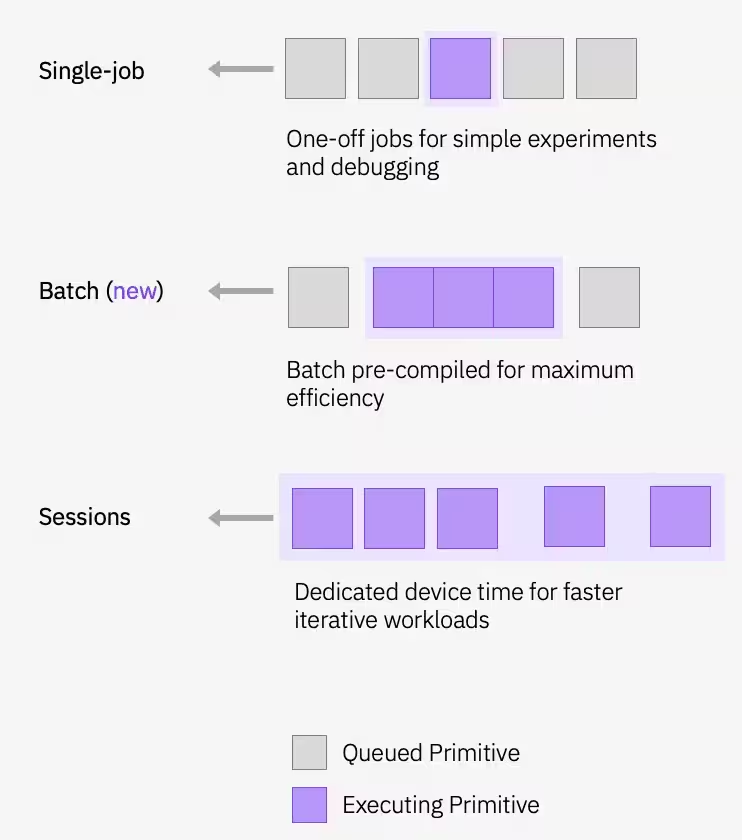
QAOA przygotowuje rozwiązania kandydujące, stosując naprzemienne warstwy dwóch operatorów do początkowego stanu superpozycji : operatora kosztu oraz operatora mieszającego . Kąty i są optymalizowane w klasycznej pętli sprzężenia zwrotnego; komputer kwantowy oblicza funkcję kosztu, a klasyczny optymalizator aktualizuje parametry aż do zbieżności. Ta iteracyjna pętla działa w ramach sesji Quantum Compute, która utrzymuje urządzenie kwantowe zarezerwowane przez kolejne iteracje, zapewniając niższą latencję.

Aby zapoznać się z głębszym omówieniem teorii QAOA, w tym pełnym wyprowadzeniem od QUBO do Hamiltonianu, zobacz moduł kursu o QAOA.
W tym samouczku najpierw rozwiążesz problem max-cut na małym grafie pięciowęzłowym, a następnie przeskalujesz ten sam przepływ pracy do problemu w skali użytkowej ze 100 węzłami na rzeczywistym sprzęcie. Uwaga dotycząca dostępu w ramach planu: Ten samouczek wykorzystuje sesje Quantum Compute, które są dostępne tylko w Planie Premium. Jeśli korzystasz z Planu Otwartego, nie możesz uruchomić tego samouczka w postaci, w jakiej został napisany; zamiast tego musisz zamienić Session na job mode (tzn. przesyłać każdą iterację jako niezależne zadanie, zamiast opakowywać pętlę optymalizacyjną w with Session(...)). Przepływ pracy nadal działa, ale każda iteracja podlega pełnej latencji kolejki, zamiast ponownie wykorzystywać zarezerwowane urządzenie. Więcej informacji znajdziesz w Przeglądzie dostępnych planów.
Wymagania
Zanim rozpoczniesz ten samouczek, upewnij się, że masz zainstalowane następujące elementy:
-
Qiskit SDK w wersji 2.0 lub nowszej, z obsługą wizualizacji
-
Qiskit Runtime w wersji 0.22 lub nowszej (
pip install qiskit-ibm-runtime) -
Dodatek Qiskit Optimization Mapper (
pip install qiskit-addon-opt-mapper)
Ponadto będziesz potrzebować dostępu do instancji na IBM Quantum® Platform.
Konfiguracja
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_addon_opt_mapper": "qiskit-addon-opt-mapper", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "rustworkx": "rustworkx", "scipy": "scipy"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import matplotlib.pyplot as plt
import rustworkx as rx
from rustworkx.visualization import mpl_draw as draw_graph
import numpy as np
from scipy.optimize import minimize
from collections import defaultdict

from qiskit.quantum_info import SparsePauliOp
from qiskit.circuit.library import QAOAAnsatz
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import Session, EstimatorV2 as Estimator
from qiskit_ibm_runtime import SamplerV2 as Sampler

from qiskit_addon_opt_mapper.applications import Maxcut
from qiskit_addon_opt_mapper.converters import OptimizationProblemToQubo
from qiskit_addon_opt_mapper.translators import to_ising
Przykład w małej skali
Ta sekcja przeprowadza przez każdy krok przepływu pracy QAOA na małej instancji max-cut z pięcioma węzłami. Pomimo etykiety „mała skala”, ten przykład nadal działa na rzeczywistym sprzęcie IBM Quantum — kod wybiera Backend ze 127 lub większą liczbą qubit i tam wykonuje Circuit. Zainicjuj swój problem, tworząc graf z węzłami.
n_small = 5

graph = rx.PyGraph()
graph.add_nodes_from(np.arange(0, n_small, 1))
edge_list = [
    (0, 1, 1.0),
    (0, 2, 1.0),
    (0, 4, 1.0),
    (1, 2, 1.0),
    (2, 3, 1.0),
    (3, 4, 1.0),
]
graph.add_edges_from(edge_list)
draw_graph(graph, node_size=600, with_labels=True)

Krok 1: Odwzorowanie wejść klasycznych na problem kwantowy
Odwzoruj klasyczny graf na kwantowe Circuity i operatory. Jak opisano w sekcji Tło, max-cut jest problemem QUBO, którego Hamiltonian kosztu ma stan podstawowy kodujący optymalne cięcie, a QAOA używa sparametryzowanego obwodu ansatz do przygotowywania kandydujących stanów podstawowych . Użyj dodatku Optimization Mapper, aby przejść od grafu do w trzech krokach: zamodeluj problem, przekonwertuj go na QUBO i przetłumacz QUBO na hamiltonian Isinga.
Modelowanie problemu
Klasa aplikacji Maxcut przyjmuje graf rustworkx bezpośrednio i zwraca OptimizationProblem, którego funkcją celu jest wartość cięcia do zmaksymalizowania. Każda krawędź wnosi do funkcji celu , dokładnie tak jak w sekcji Tło.
maxcut = Maxcut(graph)
maxcut_problem = maxcut.to_optimization_problem()
print(maxcut_problem.prettyprint())
Problem name: Max-cut

Maximize
  -2*x_0*x_1 - 2*x_0*x_2 - 2*x_0*x_4 - 2*x_1*x_2 - 2*x_2*x_3 - 2*x_3*x_4 + 3*x_0
  + 2*x_1 + 3*x_2 + 2*x_3 + 2*x_4

Subject to
  No constraints

  Binary variables (5)
    x_0 x_1 x_2 x_3 x_4
Zbuduj Hamiltonian kosztu
Przekonwertuj problem na QUBO za pomocą OptimizationProblemToQubo, a następnie przetłumacz QUBO na hamiltonian Isinga za pomocą to_ising. Konwerter zamienia maksymalizację na minimalizację zanegowanej wartości cięcia, a translator stosuje podstawienie . Zwraca jako SparsePauliOp wraz ze skalarnym offset, takim że . Ponieważ QUBO minimalizuje zanegowaną wartość cięcia, wartość cięcia dowolnego bitstringu wynosi .
qubo = OptimizationProblemToQubo().convert(maxcut_problem)
cost_hamiltonian, offset = to_ising(qubo)
print("Cost Function Hamiltonian:", cost_hamiltonian)
print("Offset:", offset)
Cost Function Hamiltonian: SparsePauliOp(['IIIZZ', 'IIZIZ', 'ZIIIZ', 'IIZZI', 'IZZII', 'ZZIII'],
              coeffs=[0.5+0.j, 0.5+0.j, 0.5+0.j, 0.5+0.j, 0.5+0.j, 0.5+0.j])
Offset: -3.0
Zbuduj obwód ansatz QAOA
Użyj QAOAAnsatz, aby skonstruować sparametryzowany Circuit QAOA z Hamiltonianu kosztu. Tutaj używamy reps=2 (dwie warstwy QAOA, cztery parametry: ).
circuit = QAOAAnsatz(cost_operator=cost_hamiltonian, reps=2)
circuit.measure_all()

circuit.draw("mpl")

circuit.parameters
ParameterView([ParameterVectorElement(β[0]), ParameterVectorElement(β[1]), ParameterVectorElement(γ[0]), ParameterVectorElement(γ[1])])
Krok 2: Optymalizacja problemu pod kątem wykonania na sprzęcie kwantowym
Dokonaj transpilacji abstrakcyjnego Circuit na instrukcje natywne dla sprzętu. Ten krok obsługuje mapowanie qubit, dekompozycję bramek, trasowanie i tłumienie błędów. Więcej informacji znajdziesz w dokumentacji dotyczącej transpilacji.
service = QiskitRuntimeService()
backend = service.least_busy(
    operational=True, simulator=False, min_num_qubits=127
)
print(backend)

# Create pass manager for transpilation. Level 3 is the most aggressive
# preset: slower to transpile, but produces shorter circuits that are
# more robust to hardware noise.
pm = generate_preset_pass_manager(optimization_level=3, backend=backend)

candidate_circuit = pm.run(circuit)
candidate_circuit.draw("mpl", fold=False, idle_wires=False)
<IBMBackend('ibm_pittsburgh')>

Krok 3: Wykonanie z użyciem prymitywów Qiskit
Pętla optymalizacyjna QAOA działa wewnątrz sesji Quantum Compute, aby utrzymać urządzenie zarezerwowane przez kolejne iteracje. Estimator oblicza na każdym kroku, a klasyczny optymalizator (COBYLA) aktualizuje parametry aż do zbieżności.
 Zdefiniuj parametry początkowe i uruchom pętlę optymalizacyjną:
# QAOA doesn't prescribe principled default angles — any bounded choice
# works as a warm start for problems this small. beta and gamma are
# periodic (beta in [0, pi] and gamma in [0, 2*pi] modulo the underlying
# Pauli-rotation periods), and pi/2 and pi are just midpoints of those
# ranges. For harder problems you would typically warm start from known
# good angles or transfer parameters from smaller instances.
initial_gamma = np.pi
initial_beta = np.pi / 2
init_params = [initial_beta, initial_beta, initial_gamma, initial_gamma]
def cost_func_estimator(params, ansatz, hamiltonian, estimator):
    # transform the observable defined on virtual qubits to
    # an observable defined on all physical qubits
    isa_hamiltonian = hamiltonian.apply_layout(ansatz.layout)

    pub = (ansatz, isa_hamiltonian, params)
    job = estimator.run([pub])

    results = job.result()[0]
    cost = results.data.evs

    objective_func_vals.append(cost)

    return cost
objective_func_vals = []  # Global variable
with Session(backend=backend) as session:
    # If using qiskit-ibm-runtime<0.24.0, change `mode=` to `session=`
    estimator = Estimator(mode=session)
    estimator.options.default_shots = 1000

    # Set simple error suppression/mitigation options
    estimator.options.dynamical_decoupling.enable = True
    estimator.options.dynamical_decoupling.sequence_type = "XY4"
    estimator.options.twirling.enable_gates = True
    estimator.options.twirling.num_randomizations = "auto"
    estimator.options.environment.job_tags = ["TUT_QAOA"]

    result = minimize(
        cost_func_estimator,
        init_params,
        args=(candidate_circuit, cost_hamiltonian, estimator),
        method="COBYLA",
        tol=1e-2,
    )
    print(result)
message: Return from COBYLA because the trust region radius reaches its lower bound.
 success: True
  status: 0
     fun: -1.0164225323839062
       x: [ 1.404e+00  1.174e+00  4.036e+00  2.969e+00]
    nfev: 30
   maxcv: 0.0
Optymalizator zdołał zmniejszyć koszt i znaleźć lepsze parametry dla Circuit.
Gładko opadająca krzywa, która osiąga plateau, jest cechą charakterystyczną zbieżności. Zaszumiona, niemonotoniczna krzywa zwykle wskazuje, że coś wcześniej w przepływie pracy wymaga uwagi; częstymi przyczynami są zbyt mała liczba shots na ocenę (wysoka wariancja estymatora), słabe parametry początkowe lub Circuit, którego głębokość jest zdominowana przez szum sprzętowy. COBYLA jest metodą bez pochodnych i dość odporną na umiarkowany szum, ale gdy szum przytłacza rzeczywiste poprawy kosztu na każdym kroku, jej model aproksymacji liniowej nie potrafi już odróżnić prawdziwego spadku od losowego drżenia i optymalizator błądzi.
plt.figure(figsize=(12, 6))
plt.plot(objective_func_vals)
plt.xlabel("Iteration")
plt.ylabel("Cost")
plt.show()

Przypisz zoptymalizowane parametry i próbkuj końcowy rozkład przy użyciu prymitywu Sampler.
optimized_circuit = candidate_circuit.assign_parameters(result.x)
optimized_circuit.draw("mpl", fold=False, idle_wires=False)

# If using qiskit-ibm-runtime<0.24.0, change `mode=` to `backend=`
sampler = Sampler(mode=backend)
sampler.options.default_shots = 10000

# Set simple error suppression/mitigation options
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = "XY4"
sampler.options.twirling.enable_gates = True
sampler.options.twirling.num_randomizations = "auto"

sampler.options.environment.job_tags = ["TUT_QAOA"]

pub = (optimized_circuit,)
job = sampler.run([pub], shots=int(1e4))
counts_int = job.result()[0].data.meas.get_int_counts()
counts_bin = job.result()[0].data.meas.get_counts()
shots = sum(counts_int.values())
final_distribution_int = {key: val / shots for key, val in counts_int.items()}
final_distribution_bin = {key: val / shots for key, val in counts_bin.items()}
print(final_distribution_int)
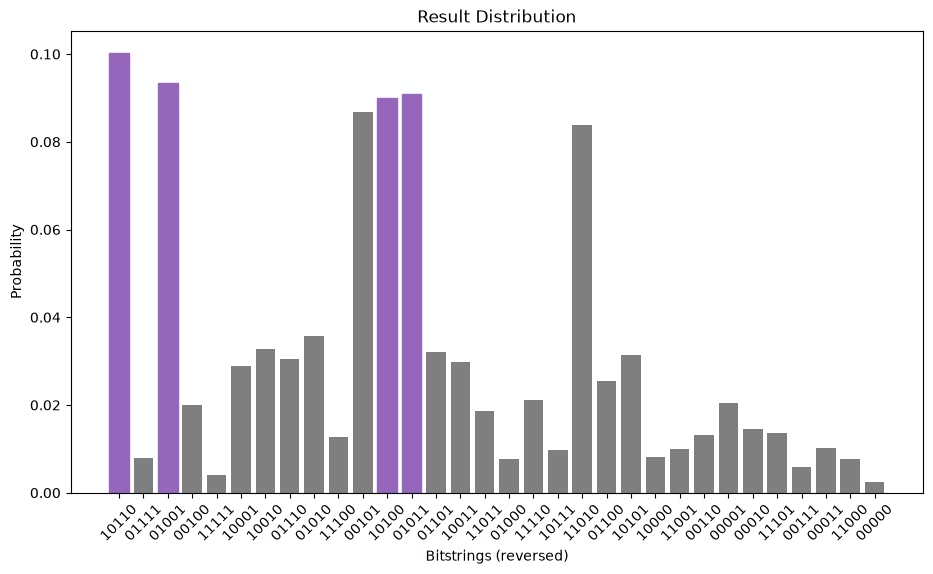
{22: 0.1003, 15: 0.008, 9: 0.0934, 4: 0.02, 31: 0.004, 17: 0.0288, 18: 0.0327, 14: 0.0305, 10: 0.0358, 28: 0.0128, 5: 0.0868, 20: 0.09, 11: 0.0908, 13: 0.0321, 19: 0.0298, 27: 0.0186, 8: 0.0077, 30: 0.0211, 23: 0.0098, 26: 0.0839, 12: 0.0254, 21: 0.0315, 16: 0.0082, 25: 0.01, 6: 0.0131, 1: 0.0205, 2: 0.0145, 29: 0.0137, 7: 0.0059, 3: 0.0101, 24: 0.0078, 0: 0.0024}
Krok 4: Post-przetwarzanie i zwrócenie wyniku w pożądanym formacie klasycznym
Wyodrębnij najbardziej prawdopodobny bitstring z próbkowanego rozkładu. Reprezentuje on najlepsze cięcie znalezione przez QAOA. Metoda interpret klasy Maxcut dekoduje bitstring na dwa zbiory węzłów podziału.
# auxiliary functions to sample most likely bitstring
def to_bitstring(integer, num_bits):
    result = np.binary_repr(integer, width=num_bits)
    return [int(digit) for digit in result]

keys = list(final_distribution_int.keys())
values = list(final_distribution_int.values())
most_likely = keys[np.argmax(np.abs(values))]
most_likely_bitstring = to_bitstring(most_likely, len(graph))
most_likely_bitstring.reverse()

print("Result bitstring:", most_likely_bitstring)

partition = maxcut.interpret(np.array(most_likely_bitstring))
print("Partition:", partition)
Result bitstring: [0, 1, 1, 0, 1]
Partition: [[0, 3], [1, 2, 4]]
plt.rcParams.update({"font.size": 10})
final_bits = final_distribution_bin
values = np.abs(list(final_bits.values()))
top_4_values = sorted(values, reverse=True)[:4]
positions = []
for value in top_4_values:
    positions.append(np.where(values == value)[0])
fig = plt.figure(figsize=(11, 6))
ax = fig.add_subplot(1, 1, 1)
plt.xticks(rotation=45)
plt.title("Result Distribution")
plt.xlabel("Bitstrings (reversed)")
plt.ylabel("Probability")
ax.bar(list(final_bits.keys()), list(final_bits.values()), color="tab:grey")
for p in positions:
    ax.get_children()[int(p[0])].set_color("tab:purple")
plt.show()
Wizualizacja najlepszego cięcia
Na podstawie optymalnego bitstring możesz następnie zwizualizować to cięcie na oryginalnym grafie.
# auxiliary function to plot graphs
def plot_result(G, x):
    colors = ["tab:grey" if i == 0 else "tab:purple" for i in x]
    pos, _default_axes = rx.spring_layout(G), plt.axes(frameon=True)
    rx.visualization.mpl_draw(
        G, node_color=colors, node_size=100, alpha=0.8, pos=pos
    )

plot_result(graph, most_likely_bitstring)

Teraz oblicz wartość cięcia. Funkcją celu OptimizationProblem jest sama wartość cięcia, więc oblicz ją bezpośrednio na bitstringu. Możesz też porównać ją z wartością cięcia wynikającą z końcowego kosztu optymalizatora, , która jest średnią z całego próbkowanego rozkładu, a nie wartością pojedynczego bitstringu.
cut_value = maxcut_problem.objective.evaluate(np.array(most_likely_bitstring))
print("The value of the cut is:", cut_value)
print("Cut value implied by the optimized cost:", -(result.fun + offset))
The value of the cut is: 5.0
Cut value implied by the optimized cost: 4.016422532383906
Dla tak małego grafu prawdziwe optimum łatwo znaleźć metodą brute-force, więc możesz dwukrotnie sprawdzić wyniki, porównując rezultat QAOA z dokładną odpowiedzią.
# Classical baseline: enumerate all 2**n_small bitstrings and take the best cut.
def brute_force_max_cut(problem) -> tuple[int, list[int]]:
    n = problem.get_num_vars()
    best_cut = -1
    best_x: list[int] = []
    for i in range(2**n):
        x = np.array([(i >> k) & 1 for k in range(n)])
        cut = problem.objective.evaluate(x)
        if cut > best_cut:
            best_cut = int(cut)
            best_x = x.tolist()
    return best_cut, best_x

classical_best, classical_x = brute_force_max_cut(maxcut_problem)
print(f"Classical optimum (brute force): {classical_best}")
print(f"QAOA cut value:                  {cut_value}")
Classical optimum (brute force): 5
QAOA cut value:                  5.0
Przykład sprzętowy w dużej skali
Masz dostęp do wielu urządzeń z ponad 100 qubit na IBM Quantum Platform. Wybierz jedno z nich, na którym rozwiążesz problem max-cut na ważonym grafie ze 100 węzłami. Jest to problem w „skali użytkowej”. Przepływ pracy przebiega według tych samych kroków co powyżej, zastosowanych do znacznie większego grafu.
Pełny przepływ pracy w skali użytkowej
Wszystkie cztery kroki są przedstawione poniżej, zastosowane do grafu ze 100 węzłami. Struktura jest taka sama jak w przejściu w małej skali: odwzoruj, dokonaj transpilacji, wykonaj, post-przetwórz — ale z większym problemem i dla przejrzystości podzielonym na cztery komórki poniżej.
# Precomputed parity lookup table: _PARITY[b] = +1 if popcount(b) is even, else -1.
# We use this to vectorize expectation-value evaluation across all Pauli terms.
_PARITY = np.array(
    [-1 if bin(i).count("1") % 2 else 1 for i in range(256)],
    dtype=np.complex128,
)

def evaluate_sparse_pauli(state: int, observable: SparsePauliOp) -> complex:
    """Expectation value of a SparsePauliOp on a single computational-basis state.

    For a Z-only observable (which QAOA cost Hamiltonians are, after the
    QUBO-to-Hamiltonian mapping), the eigenvalue of each Pauli term on a
    computational-basis state is simply (-1)**popcount(z_mask AND state),
    i.e., the parity of the bitwise-AND of the term's Z-support and the
    measured bitstring.

    This routine packs the Z-support of every Pauli term into bytes, ANDs
    them against the measured state in a single vectorized op, and looks up
    the parity in _PARITY. For a 100-qubit / ~hundreds-of-terms Hamiltonian
    over 10_000 samples, this is dramatically faster than calling
    SparsePauliOp.expectation_value per sample.
    """
    packed_uint8 = np.packbits(observable.paulis.z, axis=1, bitorder="little")
    state_bytes = np.frombuffer(
        state.to_bytes(packed_uint8.shape[1], "little"), dtype=np.uint8
    )
    reduced = np.bitwise_xor.reduce(packed_uint8 & state_bytes, axis=1)
    return np.sum(observable.coeffs * _PARITY[reduced])

def best_solution(samples, hamiltonian):
    """Return the sampled bitstring (as int) with the lowest Hamiltonian cost."""
    min_cost = float("inf")
    min_sol = None
    for bit_str in samples.keys():
        candidate_sol = int(bit_str)
        fval = evaluate_sparse_pauli(candidate_sol, hamiltonian).real
        if fval <= min_cost:
            min_cost = fval
            min_sol = candidate_sol
    return min_sol

def _plot_cdf(objective_values: dict, ax, color):
    x_vals = sorted(objective_values.keys(), reverse=True)
    y_vals = np.cumsum([objective_values[x] for x in x_vals])
    ax.plot(x_vals, y_vals, color=color)

def plot_cdf(dist, ax, title):
    _plot_cdf(dist, ax, "C1")
    ax.vlines(min(list(dist.keys())), 0, 1, "C1", linestyle="--")
    ax.set_title(title)
    ax.set_xlabel("Objective function value")
    ax.set_ylabel("Cumulative distribution function")
    ax.grid(alpha=0.3)

def samples_to_objective_values(samples, hamiltonian):
    """Convert the samples to values of the objective function."""
    objective_values = defaultdict(float)
    for bit_str, prob in samples.items():
        candidate_sol = int(bit_str)
        fval = evaluate_sparse_pauli(candidate_sol, hamiltonian).real
        objective_values[fval] += prob
    return objective_values
Krok 1: Zbuduj graf na podstawie mapy sprzężeń backendu, następnie odwzoruj go na Hamiltonian kosztu za pomocą dodatku Optimization Mapper i zbuduj ansatz.
# Step 1: build the 100-node graph, cost Hamiltonian, and QAOA ansatz.
n_large = 100
graph_100 = rx.PyGraph()
graph_100.add_nodes_from(np.arange(0, n_large, 1))
elist = set()
for u, v in backend.coupling_map:
    # The coupling map lists both directions of each coupler, so sort
    # the endpoints to avoid adding the same edge twice.
    if u < n_large and v < n_large:
        elist.add((min(u, v), max(u, v), 1.0))
graph_100.add_edges_from(sorted(elist))

maxcut_100 = Maxcut(graph_100)
maxcut_problem_100 = maxcut_100.to_optimization_problem()
qubo_100 = OptimizationProblemToQubo().convert(maxcut_problem_100)
cost_hamiltonian_100, offset_100 = to_ising(qubo_100)

circuit_100 = QAOAAnsatz(cost_operator=cost_hamiltonian_100, reps=1)
circuit_100.measure_all()
Krok 2: Dokonaj transpilacji dla wybranego Backend sprzętowego.
# Step 2: transpile for hardware.
pm = generate_preset_pass_manager(optimization_level=3, backend=backend)
candidate_circuit_100 = pm.run(circuit_100)
Krok 3: Uruchom pętlę optymalizacyjną QAOA wewnątrz sesji, a następnie próbkuj.
# Step 3: run the QAOA optimization loop on the device, then sample the
# final distribution with the optimized parameters.
initial_gamma = np.pi
initial_beta = np.pi / 2
init_params = [initial_beta, initial_gamma]

objective_func_vals = []  # Global variable
with Session(backend=backend) as session:
    estimator = Estimator(mode=session)
    estimator.options.default_shots = 1000

    # Set simple error suppression/mitigation options
    estimator.options.dynamical_decoupling.enable = True
    estimator.options.dynamical_decoupling.sequence_type = "XY4"
    estimator.options.twirling.enable_gates = True
    estimator.options.twirling.num_randomizations = "auto"
    estimator.options.environment.job_tags = ["TUT_QAOA"]

    result = minimize(
        cost_func_estimator,
        init_params,
        args=(candidate_circuit_100, cost_hamiltonian_100, estimator),
        method="COBYLA",
    )
    print(result)

# Assign optimal parameters and sample the final distribution.
optimized_circuit_100 = candidate_circuit_100.assign_parameters(result.x)

sampler = Sampler(mode=backend)
sampler.options.default_shots = 10000

# Set simple error suppression/mitigation options
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = "XY4"
sampler.options.twirling.enable_gates = True
sampler.options.twirling.num_randomizations = "auto"

# Add a unique tag to the job execution
sampler.options.environment.job_tags = ["TUT_QAOA"]

pub = (optimized_circuit_100,)
job = sampler.run([pub], shots=int(1e4))

counts_int = job.result()[0].data.meas.get_int_counts()
shots = sum(counts_int.values())
final_distribution_100_int = {
    key: val / shots for key, val in counts_int.items()
}
message: Return from COBYLA because the trust region radius reaches its lower bound.
 success: True
  status: 0
     fun: -4.214640355142735
       x: [ 2.586e+00  4.161e+00]
    nfev: 26
   maxcv: 0.0
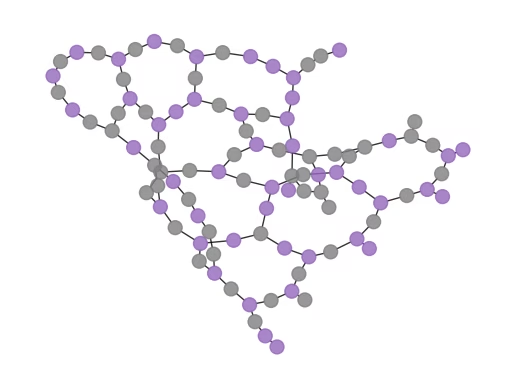
Krok 4: Post-przetwórz próbkowany rozkład, aby wyodrębnić najlepsze cięcie.
# Step 4: find the best-cost sample and evaluate its cut value.
best_sol_100 = best_solution(final_distribution_100_int, cost_hamiltonian_100)
best_sol_bitstring_100 = to_bitstring(int(best_sol_100), len(graph_100))
best_sol_bitstring_100.reverse()

print("Result bitstring:", best_sol_bitstring_100)

cut_value_100 = maxcut_problem_100.objective.evaluate(
    np.array(best_sol_bitstring_100)
)
print("The value of the cut is:", cut_value_100)
Result bitstring: [1, 0, 0, 1, 1, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 1, 0, 0, 0, 1, 0, 1, 1, 0, 1, 0, 1, 1, 1, 0, 1, 0, 0, 0, 1, 0, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 1, 0, 0, 0, 1, 0, 0, 1, 0, 0, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 0, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 1, 1, 0, 1]
The value of the cut is: 78.0
Sprawdź, czy koszt minimalizowany w pętli optymalizacyjnej osiągnął zbieżność, i zwizualizuj wyniki.
# Plot convergence
plt.figure(figsize=(12, 6))
plt.plot(objective_func_vals)
plt.xlabel("Iteration")
plt.ylabel("Cost")
plt.show()

# Visualize the cut
plot_result(graph_100, best_sol_bitstring_100)

# Plot cumulative distribution function
result_dist = samples_to_objective_values(
    final_distribution_100_int, cost_hamiltonian_100
)
fig, ax = plt.subplots(1, 1, figsize=(8, 6))
plot_cdf(result_dist, ax, backend.name)


Następne kroki
Jeśli ta praca wydała Ci się interesująca, możesz zainteresować się następującymi materiałami:
- Zaawansowane techniki dla QAOA — bada zaawansowane strategie poprawy wydajności QAOA
- Wyzwanie optymalizacji wielokryterialnej — sprawdź swoje umiejętności w tym społecznościowym wyzwaniu dotyczącym wielokryterialnej optymalizacji kwantowej
- Dokumentacja transpilacji do precyzyjnego dostrajania optymalizacji Circuit
- Tłumienie i mitygacja błędów do poprawy wyników sprzętowych