Nowoczesne przepływy pracy
Ten kurs omówił szeroki wachlarz metod radzenia sobie z szumem i błędami kwantowymi. Celowo unikaliśmy niektórych rozwiązań typu czarna skrzynka, aby zobaczyć, jak te metody działają. Teraz jesteśmy gotowi, by używać tych metod w ich najnowocześniejszej postaci. Konkretnie przyjrzymy się wysoce zoptymalizowanym narzędziom do obsługi błędów, które ukrywają przed nami część złożoności. Poznamy też Samplomatic oraz addony, takie jak shaded lightcones (SLC), które dają nam bardzo precyzyjną kontrolę nad pewnymi procesami mitygacji.
W tym filmie dr Chris Porter przedstawia przegląd tych nowoczesnych narzędzi. Planujemy dodać przykładowe przepływy pracy do tej lekcji w późniejszym terminie. Jednak ta lekcja zawiera już wszystkie informacje potrzebne do korzystania z tych narzędzi i zdania egzaminu na odznakę.
Przegląd
Wczesne prymitywy IBM Quantum, takie jak Estimator i Sampler, udostępniały mitygację błędów za pomocą niewielkiej liczby gotowych poziomów. Późniejsze wydania zapewniły bardziej bezpośrednią kontrolę nad poszczególnymi technikami, w tym wybór strategii ekstrapolacji do zerowego szumu, konfiguracji twirlingu Pauliego i parametrów randomizacji. Jednak te ustawienia pozostawały w dużej mierze globalne i były stosowane jednolicie w całym obwodzie.
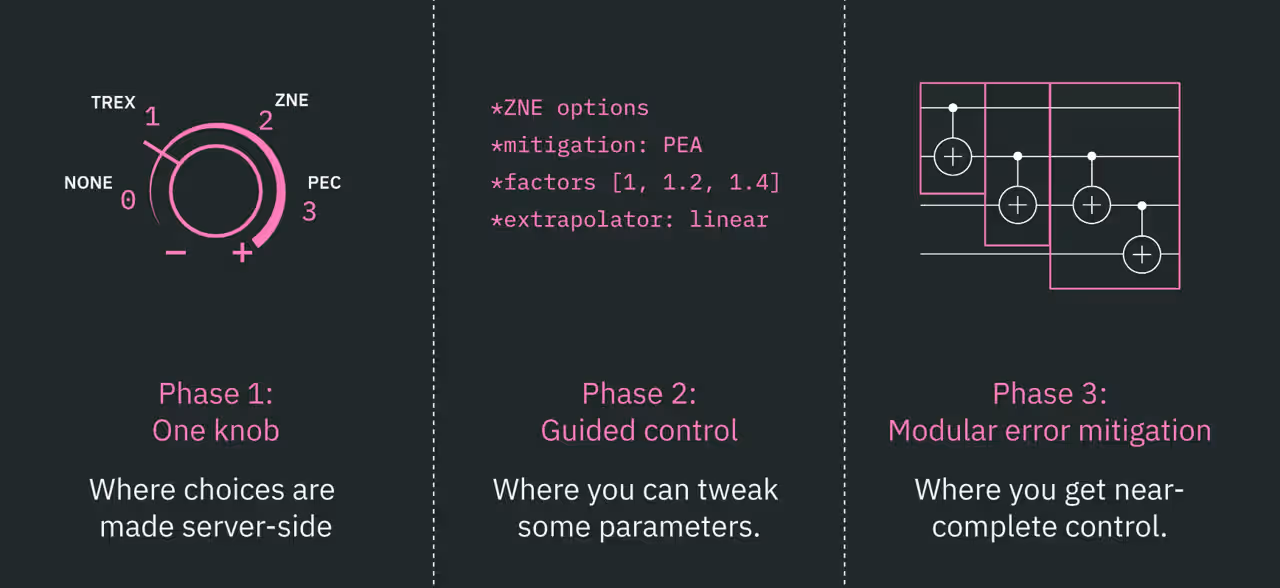
W miarę jak obciążenia kwantowe stają się coraz bardziej wyrafinowane, programiści coraz częściej potrzebują możliwości dostosowywania strategii wykonania i mitygacji do określonych obszarów obwodu. Poniższy diagram przedstawia kilka kluczowych narzędzi omawianych w tej lekcji i pokazuje, gdzie mieszczą się w typowym przepływie pracy.
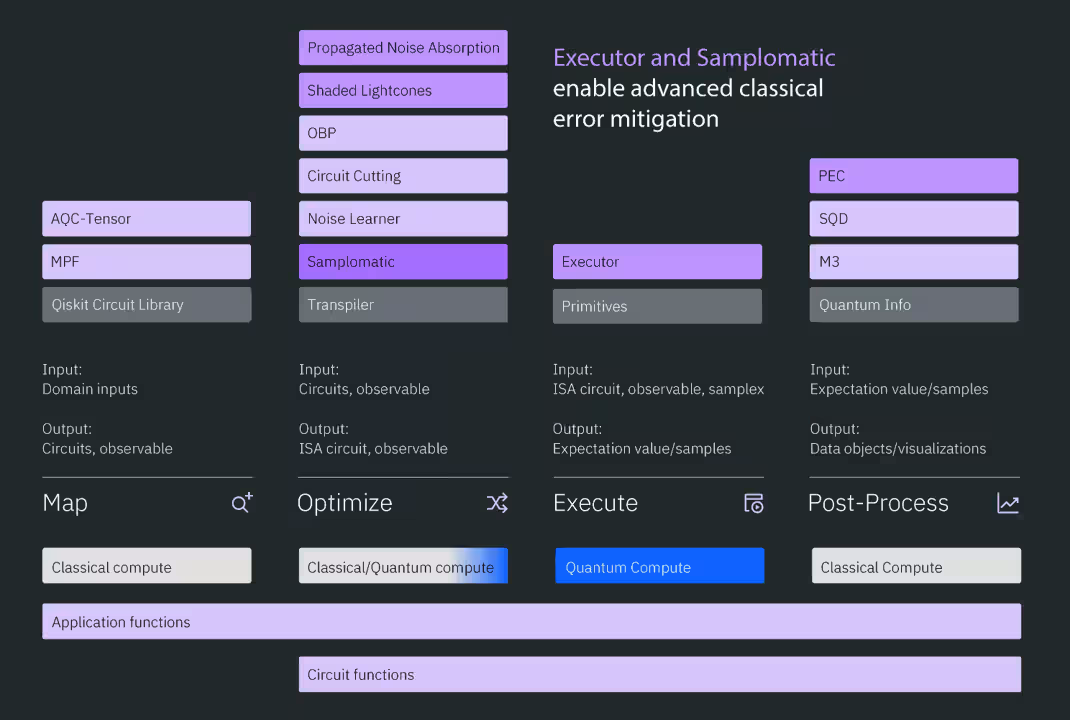
Model kierowanego wykonania odpowiada na potrzebę modularnej kontroli nad wykonaniem i integruje wiele z tych narzędzi.
Model kierowanego wykonania
Zamiast podejmować niejawne decyzje dotyczące wykonania, model kierowanego wykonania podąża za dyrektywami podanymi przez użytkownika. Takie podejście zwiększa przejrzystość i ułatwia inspekcję oraz debugowanie złożonych przepływów pracy. Do kluczowych cech tego modelu należą:
-
Konfiguracja dla każdej warstwy za pomocą oznaczonych obszarów obwodu
-
Identyfikacja unikalnych i powtarzających się warstw na potrzeby wydajnego uczenia szumu
-
Przepływy pracy z wykonaniem wsadowym
-
Ustrukturyzowane przetwarzanie końcowe
-
Ścisła integracja z addonami, takimi jak shaded lightcones
Model opiera się na dwóch kluczowych komponentach:
-
Samplomatic, który definiuje przepisy wykonania
-
Executor, który realizuje te przepisy i zwraca próbki
Większość przepływów pracy używających Executor można również zaimplementować za pomocą Sampler, ponieważ oba ostatecznie dostarczają próbki. Kluczową zaletą Executor jest wydajność. Zadania takie jak generowanie konfiguracji twirlingu są często znacznie szybsze w środowisku near-time po stronie serwera niż po stronie klienta. Estimator i Sampler pozostają wspierane i mogą nadal być najwygodniejszym wyborem dla wielu obciążeń.
Przed wykonaniem musisz jednak skonstruować i przygotować obwód. Qiskit udostępnia kilka addonów, które pomagają w generowaniu, symulacji i optymalizacji obwodów. Aby dowiedzieć się więcej o dowolnym z poniższych narzędzi, skorzystaj z odnośników.
Budowanie obwodów kwantowych
W przypadku niektórych zastosowań lub nowych podejść użytkownicy muszą sami ustalić, jak odwzorować swój problem na obwód kwantowy. W wielu dziedzinach addony Qiskit mogą jednak zautomatyzować ważne części tego procesu.
Optimization mapper
Optimization mapper pomaga wyrażać klasyczne problemy optymalizacyjne w postaciach odpowiednich dla algorytmów kwantowych. Kluczowe funkcje obejmują:
-
Konstruowanie funkcji celu i ograniczeń
-
Konwertowanie problemów na sformułowania QUBO
-
Generowanie reprezentacji hamiltonianowych lub operatorowych
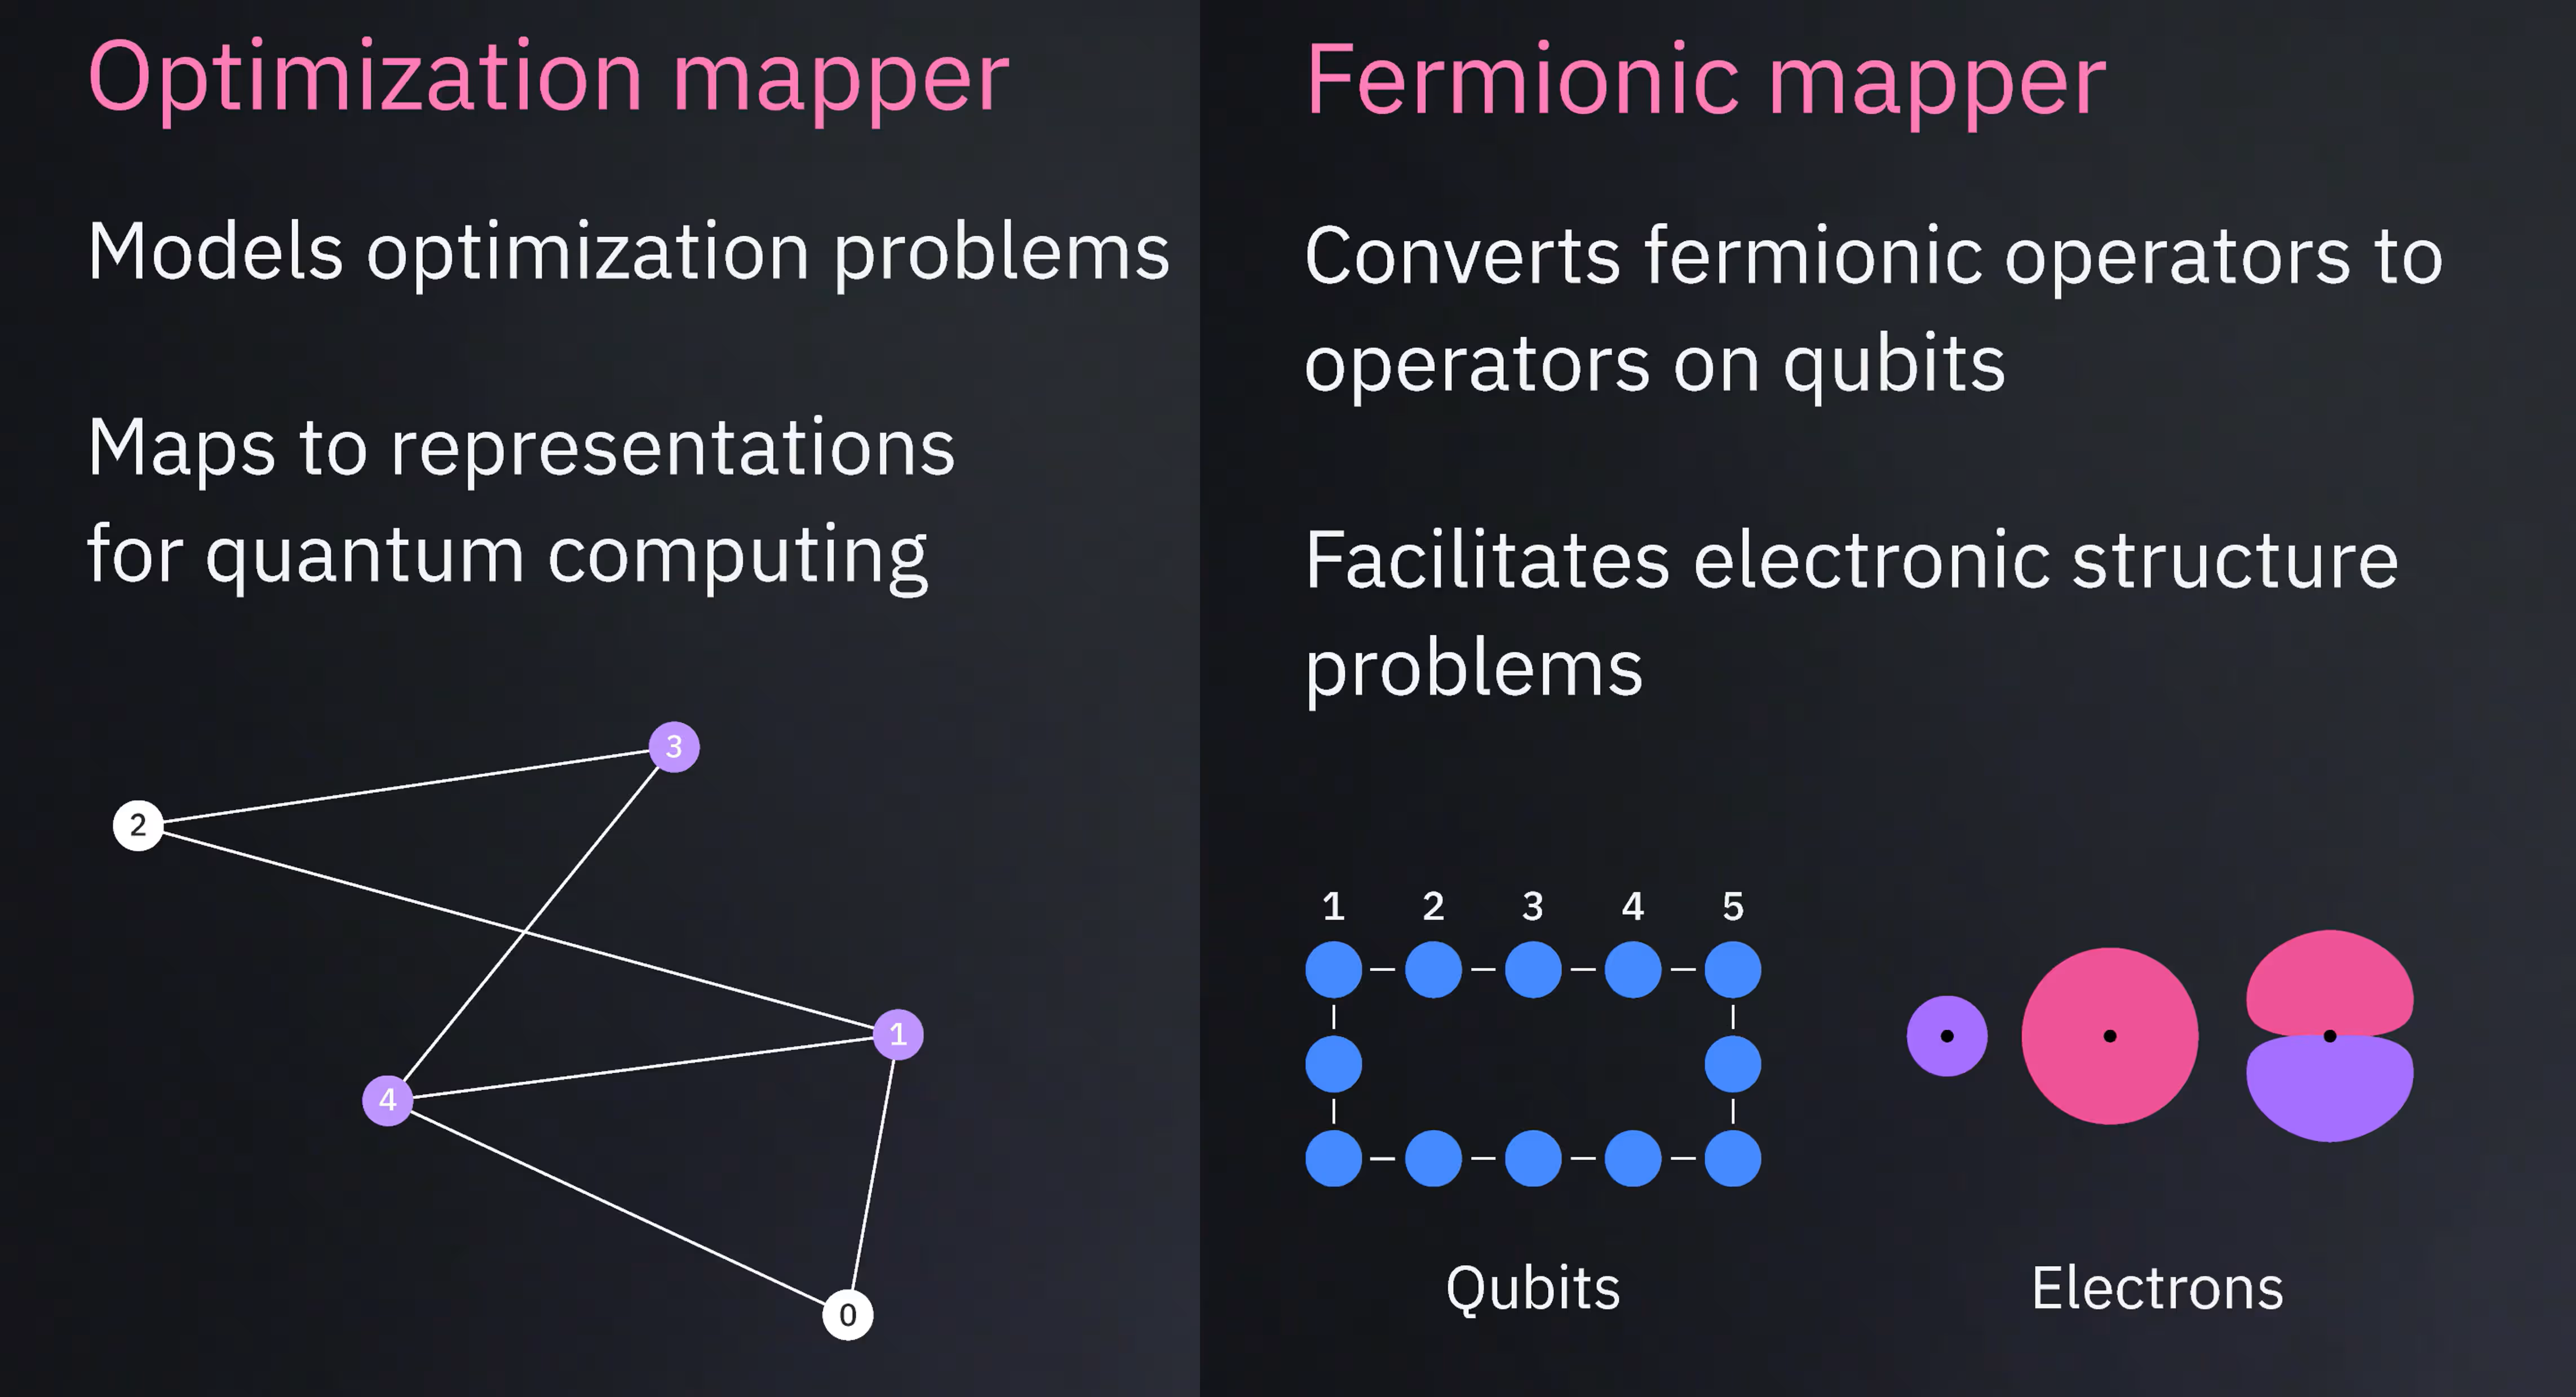
Fermionic mapper
Fermionic mapper konwertuje operatory fermionowe na operatory kubitowe odpowiednie dla sprzętu kwantowego. Obsługuje odwzorowania takie jak Jordana-Wignera, które przekształca operatory na nierozróżnialnych fermionach w operatory Pauliego na rozróżnialnych kubitach, zachowując statystykę fermionową. Ten addon jest przydatny w zastosowaniach z chemii kwantowej i nauki o materiałach.
Poprzednie dwa addony skupiają się na początkowym odwzorowaniu struktury problemu na obwód kwantowy. Równie ważne jest jednak wydajne odwzorowanie ewolucji czasowej procesu na obwód kwantowy oraz optymalizacja obwodu przez zmniejszenie jego głębokości. Kolejne addony zajmują się tymi zadaniami.
Multi-product formulas (MPF)
Multi-product formulas poprawiają dokładność kwantowych symulacji ewolucji czasowej, łącząc wiele przybliżeń. Konkretnie tworzysz obwody o różnej liczbie kroków Trottera, aby móc użyć ważonej kombinacji wyników tych obwodów. Dla danej docelowej dokładności MPF może często używać płytszych obwodów niż standardowe metody Trottera. Kosztem jest to, że musisz uruchomić wiele obwodów i połączyć ich wyniki klasycznie.
AQC-Tensor
AQC-Tensor wykonuje przybliżoną kompilację kwantową z użyciem metod sieci tensorowych. Typowy przypadek użycia polega na zastąpieniu części głębokiego obwodu płytszym przybliżeniem wariacyjnym. Powstały obwód może osiągnąć podobną dokładność przy znacznie mniejszej głębokości.

Transpilacja
Transpilacji używałeś już wiele razy w tym kursie. Wiesz, że po skonstruowaniu abstrakcyjnego obwodu trzeba go przygotować do wykonania na sprzęcie. Nie przyglądaliśmy się jednak jeszcze szczegółowo poszczególnym etapom transpilacji.
Kluczowe etapy transpilacji to:
-
Layout: odwzorowanie logicznych kubitów na kubity fizyczne
-
Translation: przepisanie operacji z użyciem natywnego zestawu bramek Backendu
-
Routing: wstawianie i optymalizacja operacji SWAP wymaganych przez łączność sprzętu
Te procesy są ze sobą powiązane. Na przykład layout powinien minimalizować głębokość nawet po uwzględnieniu routingu. Layout powinien też unikać kubitów i połączeń najbardziej podatnych na błędy. Te etapy są często zautomatyzowane, ale zaawansowani użytkownicy mogą w razie potrzeby określić własne layouty lub inne ograniczenia.

Aby dowiedzieć się więcej o transpilacji, zobacz przewodnik Wprowadzenie do transpilacji.
Sprawdź swoje zrozumienie
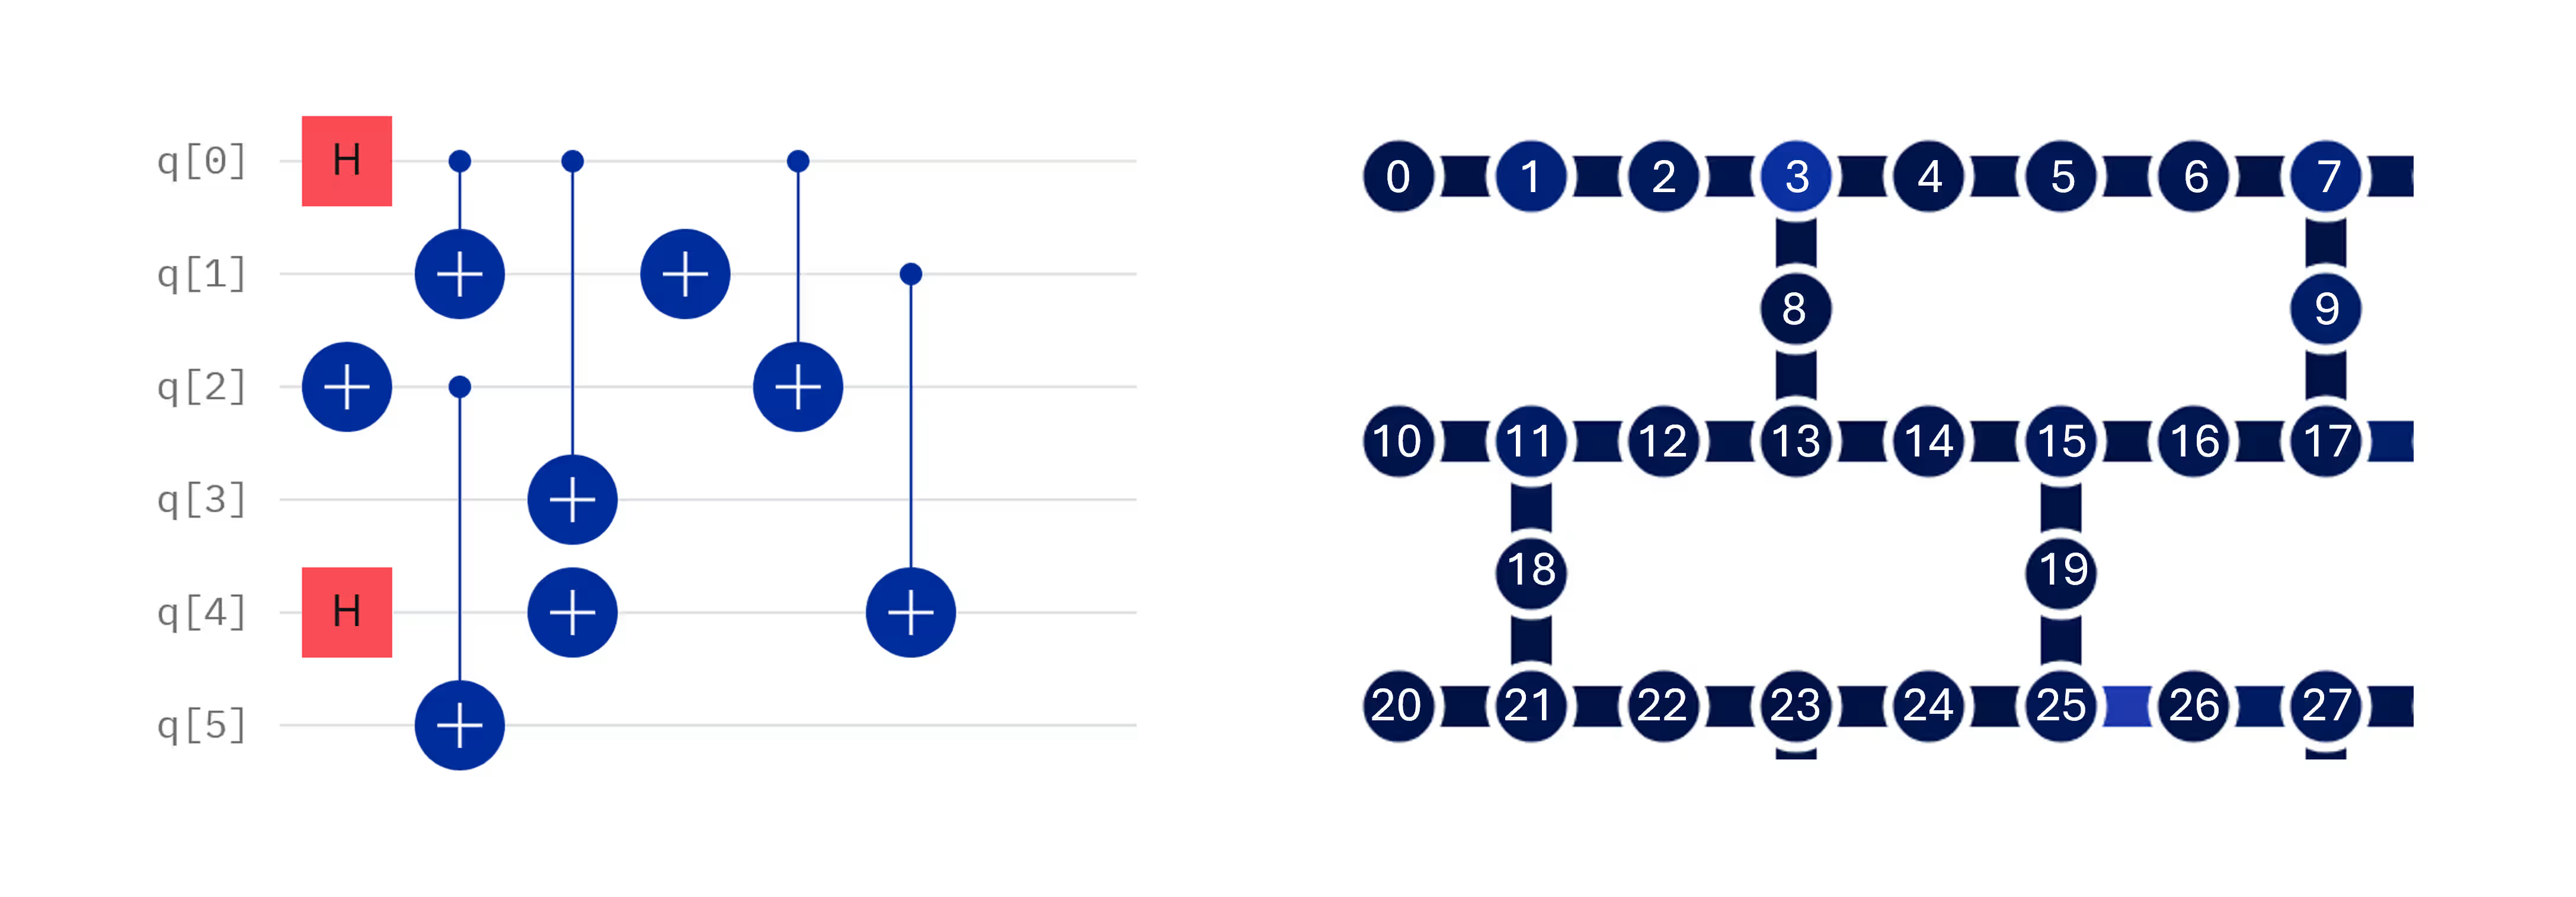
Spójrz na poniższy obwód kwantowy i załóż, że musisz uruchomić go na komputerze kwantowym o układzie heavy-hex, którego część jest pokazana. (a) Zaproponuj odwzorowanie numerów kubitów w abstrakcyjnym obwodzie na numery kubitów w fizycznym komputerze kwantowym, które minimalizuje liczbę wymaganych bramek SWAP. (b) Czy Twój wybór jest jedyny, czy mogą istnieć inne równie dobre wybory? (c) Nawet jeśli Twój wybór jest jedynym optymalnym layoutem pod względem redukcji bramek SWAP, z jakich powodów transpiler mógłby wybrać inne odwzorowanie?
Odpowiedź
(a) Poprawnych odpowiedzi może być wiele, ale zauważ, że tylko abstrakcyjny kubit 0 ma bramki splątujące (dwukubitowe) z trzema sąsiadami. Wszystkie pozostałe uczestniczą w operacjach dwukubitowych tylko z dwoma sąsiadami. Ten obwód można odwzorować na topologię heavy-hex bez żadnych bramek SWAP. Akceptowalny jest każdy layout, który to osiąga. Używając do oznaczenia abstrakcyjnego kubitu zero, a dla transpilowanego kubitu zero, jeden z takich layoutów to:
(b) Ten layout nie jest jedyny. Wiele innych layoutów w ogóle unika bramek SWAP. Inny przykład to:
(c) Czasami konkretny kubit jest bardziej podatny na błędy niż większość innych w układzie. Również niektóre połączenia między kubitami są bardziej podatne na błędy niż inne. Transpiler próbuje znaleźć layout, który unika zbędnych bramek SWAP, ale także wykorzystuje kubity i połączenia o najwyższej wierności dostępne na wybranym komputerze kwantowym.
Zmniejszanie wpływu szumu i błędów
Kilka addonów Qiskit koncentruje się konkretnie na zmniejszaniu wpływu szumu i niedoskonałości sprzętu.
Propagacja wsteczna operatora i transformacje obwodu uwzględniające szum
Omawialiśmy już propagację operatora w kontekście koherentnych kontroli Pauliego w korekcji błędów. Propagacja operatora jest jednak przydatna szerzej. Istnieją dwa główne sposoby wykorzystania propagacji operatora przez obwód kwantowy: (1) wchłonięcie ostatnich kilku warstw obwodu kwantowego do mierzonych obserwabli oraz (2) uwzględnienie prawdopodobnych skutków błędów w obwodzie i skompensowanie ich przez pomiar innej obserwabli. Następne dwa narzędzia wykorzystują te podejścia.
Propagacja wsteczna operatora
Propagacja wsteczna operatora zmniejsza głębokość obwodu, wchłaniając bramki z końca obwodu do mierzonej obserwabli. Rozważ na przykład poniższy obwód.

Ten obwód zawiera warstwy rotacji i splątywania, które wyglądają na nietrywialne, a po nich drabinkę bramek CNOT i pomiar Z na kubicie 5. Ten obwód ma dwukubitową głębokość równą 7. Ta głębokość dotyczy stanu przed transpilacją. W praktyce propagację wsteczną zwykle stosuje się po transpilacji, ale ten przykład służy wyłącznie celom dydaktycznym. Pamiętaj, że istnieją reguły propagacji obserwabli przez bramkę. W szczególności, gdy bramka CNOT ma cel i kontrolę , obserwabla na staje się po propagacji wstecz przez bramkę CNOT: . W tym przykładowym obwodzie, jeśli propagujesz obserwablę wstecz przez całą drabinkę bramek CNOT, otrzymujesz obserwablę , czyli w standardowej notacji Qiskit po prostu . Jeśli zmierzymy tę obserwablę zamiast samego , możemy usunąć całą drabinkę bramek CNOT, co zmniejsza dwukubitową głębokość z 7 do 2. Ta obserwabla nadal wymaga pomiaru tylko w jednej bazie na każdym kubicie, więc nie zwiększa wymaganej liczby shotów. Nie zawsze tak jest. Ogólnie bardziej skomplikowane obserwable wymagają więcej shotów, a czasem więcej pomiarów w różnych bazach.
Ogólna strategia propagacji wstecznej operatora obejmuje następujące kroki:
-
Skrócenie wykonywanego obwodu
-
Zastąpienie oryginalnej obserwabli rozszerzoną obserwablą
-
Wymiana głębokości obwodu na zwiększone wymagania dotyczące próbkowania
Poprzedni obwód jest oczywistym przykładem, w którym propagacja wsteczna jest korzystna. Ogólnie jednak nie jest łatwo zidentyfikować obwody, które najbardziej na niej korzystają. Aby zdecydować, kiedy użyć propagacji wstecznej, sprawdź, ile głębokości możesz usunąć z obwodu, i zestaw tę redukcję ze zwiększonymi wymaganiami dotyczącymi próbkowania.
Propagated noise absorption (PNA)
Propagated noise absorption jest strukturalnie podobna do propagacji wstecznej operatora. Jednak zamiast propagować operator wstecz przez idealne bramki w obwodzie, PNA uwzględnia wyuczony model szumu i propaguje skutki szumu bezpośrednio do obserwabli. PNA wykonuje następujące czynności:
-
Uczy się zachowania szumu ze sprzętu
-
Propaguje model szumu przez obwód
-
Tworzy zmodyfikowaną obserwablę, która kompensuje szum bramek
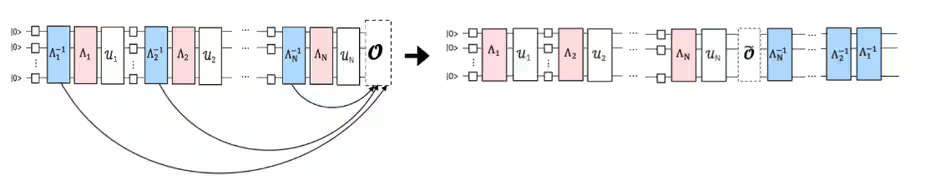
Gdy zmodyfikowana obserwabla jest mierzona na zaszumionym sprzęcie, uzyskane wartości oczekiwane lepiej przybliżają idealny wynik bez szumu. PNA ma dwa rodzaje narzutu. Po pierwsze, musisz nauczyć się modelu szumu, co wymaga uruchomienia dodatkowych obwodów. Po drugie, PNA może tworzyć bardziej skomplikowane obserwable, co może zwiększyć wymagania dotyczące próbkowania.
Circuit cutting
Circuit cutting dzieli duży obwód na mniejsze podobwody, które mogą działać niezależnie. Następnie wykonujesz wystarczającą liczbę pomiarów, aby połączyć wyniki. Circuit cutting robi następujące rzeczy:
-
Zmniejsza wymagania sprzętowe
-
Umożliwia obliczenia większe niż dostępna liczba kubitów (szersze obwody)
-
Pomaga w przypadku ograniczeń głębokości i łączności (głębsze obwody)
-
Odtwarza oryginalny wynik poprzez klasyczne przetwarzanie końcowe

Samplomatic
Wiele technik z poprzednich sekcji uzupełnia inne metody tłumienia i mitygacji omawiane w całym kursie, w tym:
-
Dynamical decoupling
-
Twirling Pauliego
-
M3
-
TREX
-
Ekstrapolacja do zerowego szumu (ZNE)
-
Probabilistyczne znoszenie błędów (PEC)
W wielu przepływach pracy możesz stosować różne techniki do różnych obszarów tego samego obwodu. Jak widzieliśmy, wiele z tych technik wiąże się również z narzutem kwantowym. Dlatego czasami potrzebujemy precyzyjnej, szczegółowej kontroli nad uczeniem szumu, próbkowaniem i stosowaniem sekwencji twirlingu. To niektóre z motywacji stojących za Samplomatic.
Samplomatic to biblioteka open source, która umożliwia dostosowane przepływy pracy próbkowania, randomizacji i mitygacji błędów.
Jej pierwszym zadaniem jest analiza obwodu i podzielenie go na oznaczone obszary, czyli boksy. Te boksy służą dwóm celom:
-
Wizualnie dzielą obwód.
-
Tworzą indeksowane obszary, które można konfigurować niezależnie.
Użytkownicy mogą dołączać adnotacje opisujące, jak każdy boks ma być traktowany podczas wykonania. Przykłady obejmują:
-
Zastosowanie twirlingu Pauliego do wszystkich boksów
-
Zastosowanie twirlingu tylko do wybranych boksów
-
Użycie różnych grup twirlingu w różnych obszarach
-
Wstrzykiwanie nauczonego szumu do wybranych warstw
-
Dostosowywanie strategii mitygacji na bardzo szczegółowym poziomie
Samplomatic identyfikuje również powtarzające się obszary w ramkach (boxed). Ponieważ identyczne warstwy zwykle wykazują podobne właściwości szumu, uczenie szumu wystarczy wykonać tylko raz dla każdej unikalnej warstwy.
Wyniki Samplomatic
Samplomatic tworzy dwa główne obiekty:
-
Obwód szablonowy
-
Samplex
Obwód szablonowy to obwód ujęty w ramki, poddany transpilacji i sparametryzowany, gotowy do wykonania. Samplex zawiera wszystkie informacje potrzebne do generowania i przetwarzania wariantów obwodu. Zawartość samplexa obejmuje:
-
Wartości parametrów dla obwodów sparametryzowanych
-
Wybory randomizacji
-
Rozkłady próbkowania
-
Informacje do przetwarzania końcowego
-
Dodatkowe metadane wykonania
Formalnie samplex to rozkład prawdopodobieństwa nad parametrami obwodu szablonowego wraz z informacjami pomocniczymi potrzebnymi do wykonania i przetwarzania końcowego. Ważną praktyczną zaletą jest to, że zarówno obwód szablonowy, jak i samplex są tworzone lokalnie po stronie klienta. Dzięki temu możesz je sprawdzać, walidować i debugować, zanim użyjesz jakichkolwiek zasobów sprzętowych.
Samplomatic ma wiele zalet, w tym precyzyjną kontrolę nad adaptacyjnym przydziałem prób (shots) i randomizacją. Ma też zalety logistyczne, takie jak ustrukturyzowane przepływy przetwarzania końcowego. Jedną z najważniejszych korzyści jest ponowne wykorzystanie nauczonych informacji o szumie w identycznych warstwach, co może zaoszczędzić znaczną ilość czasu obliczeń kwantowych podczas uczenia szumu.
Cieniowane stożki świetlne
Zanim zdecydujesz, gdzie zastosować kosztowne techniki mitygacji, warto zidentyfikować obszary obwodu, które mają największe znaczenie dla mierzonej obserwabli. Ta potrzeba stoi za dodatkiem shaded lightcones. Idea stożka świetlnego pochodzi z teorii względności, w której związki przyczynowe są ograniczone skończoną prędkością przekazywania informacji.
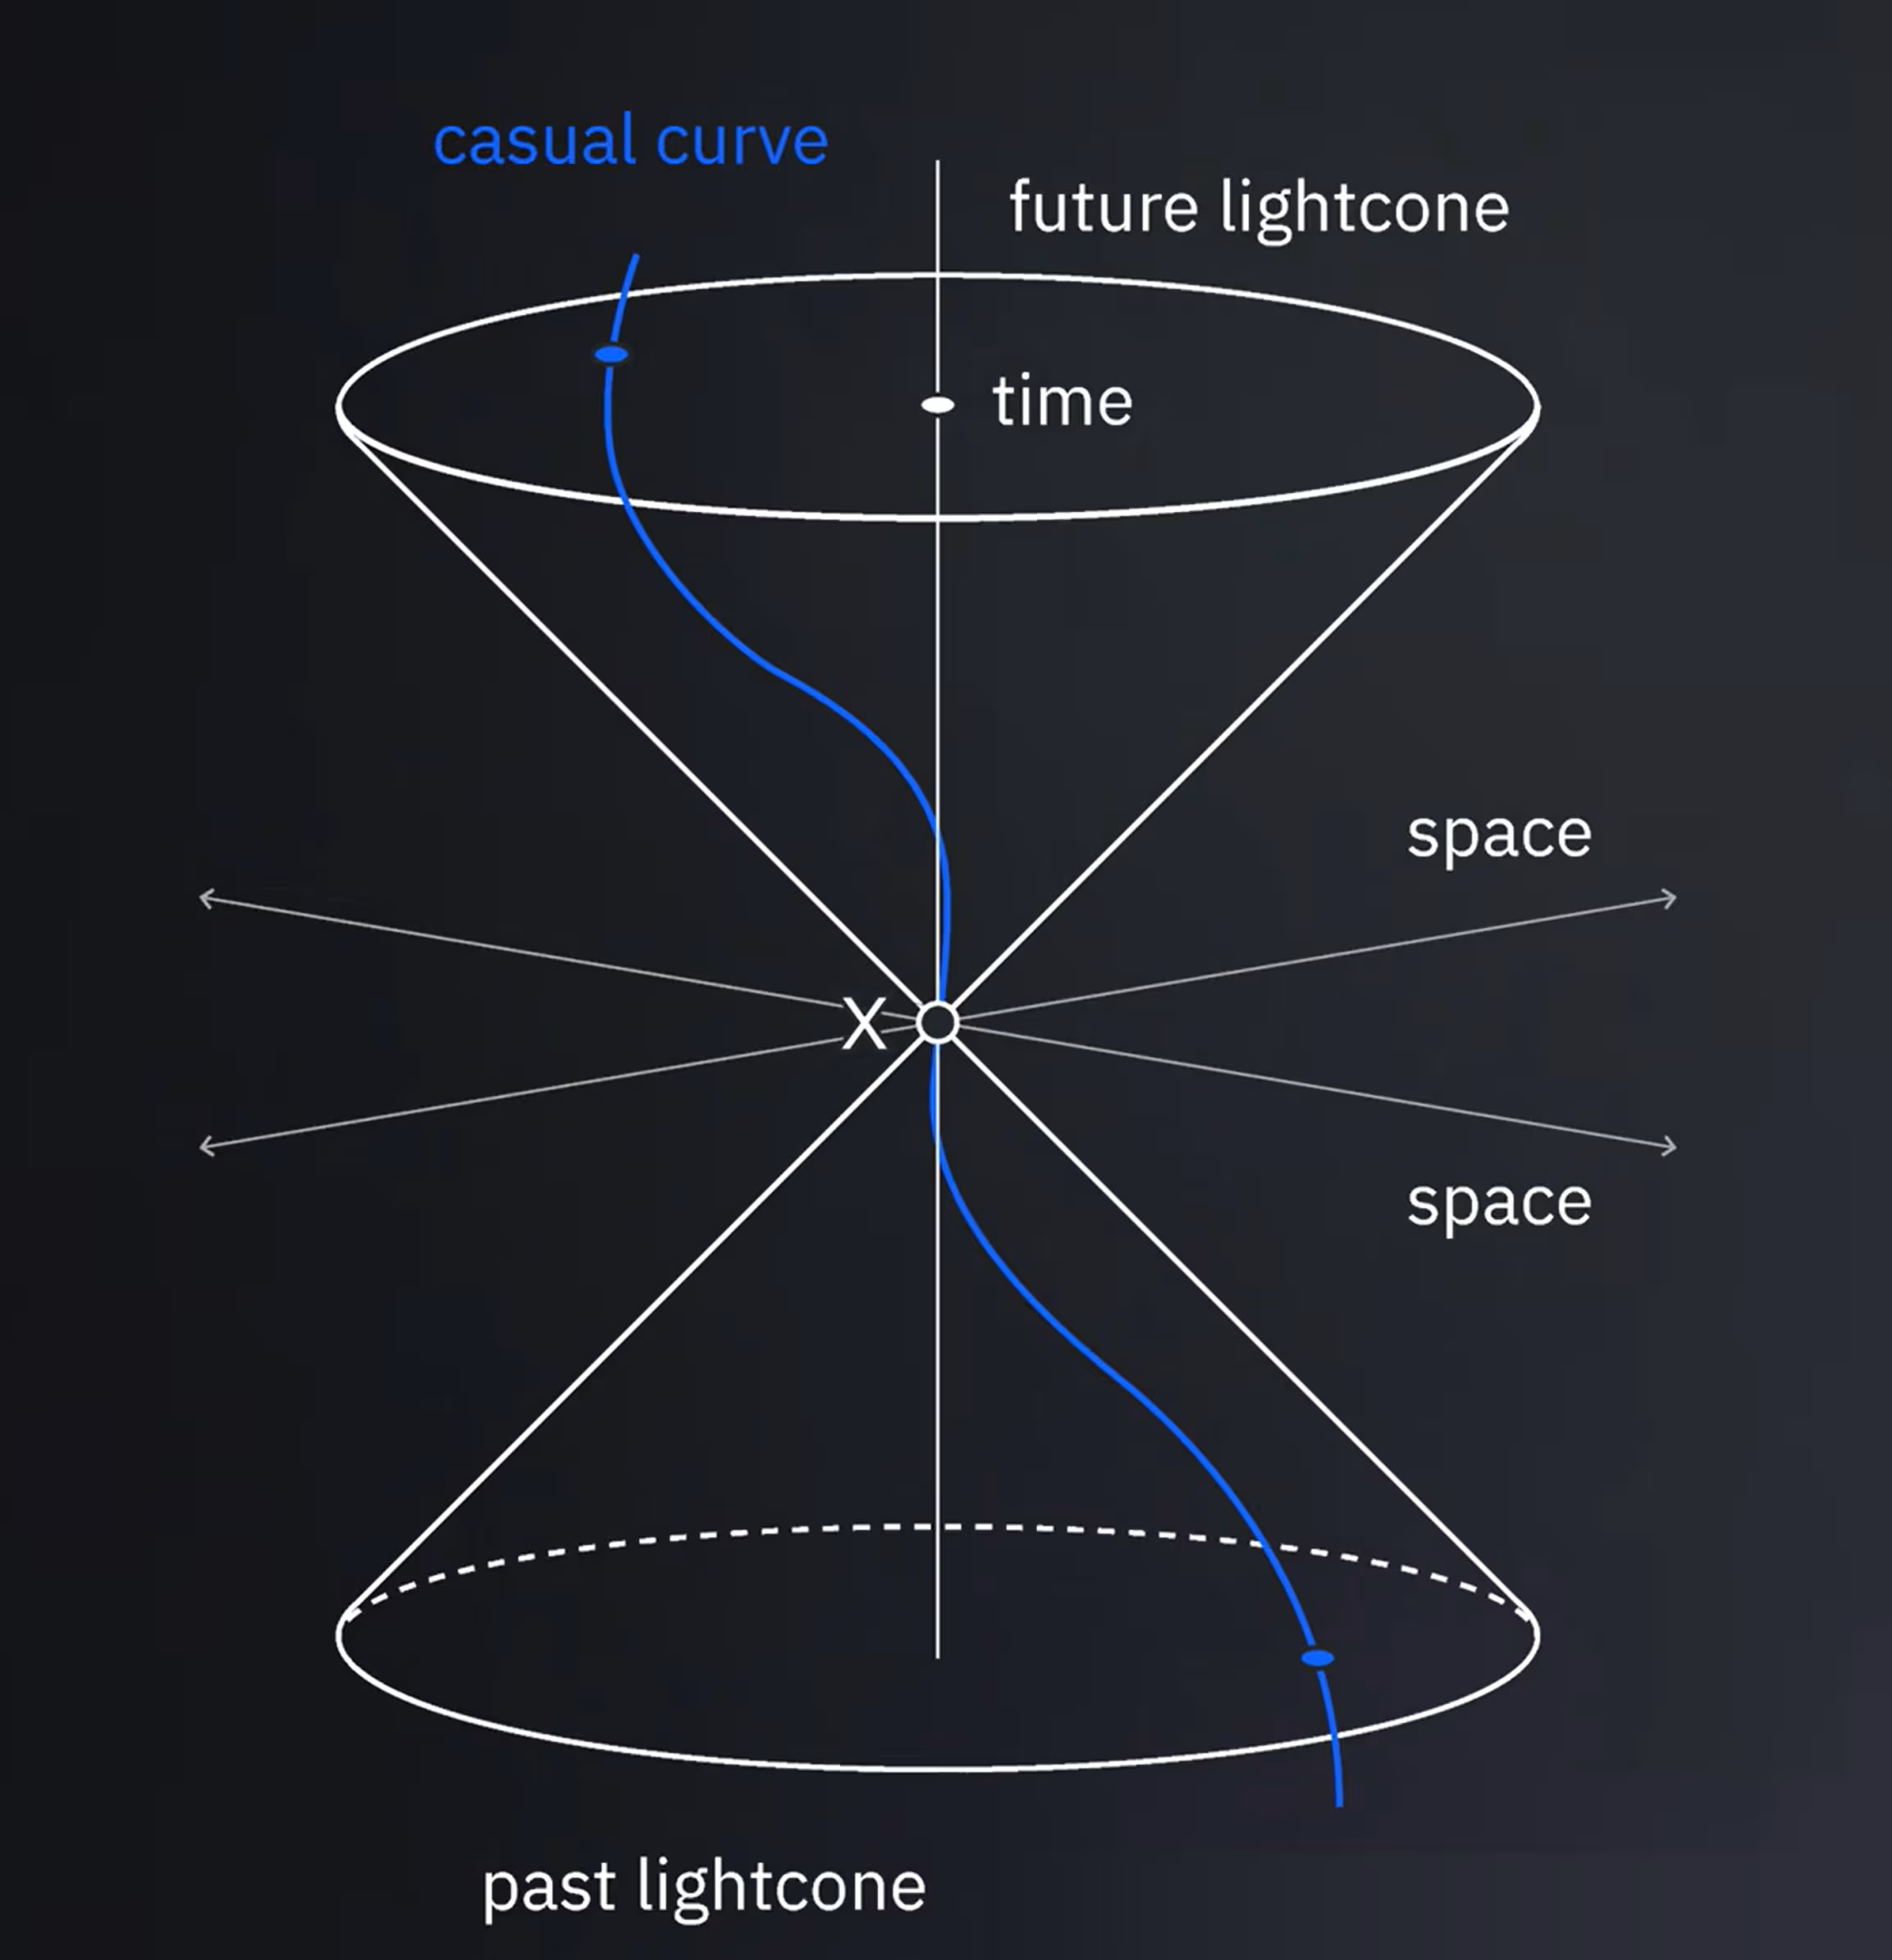
Podobna koncepcja dotyczy obwodów kwantowych.
Rozważ duży obwód, w którym interesuje nas tylko obserwabla o niskiej wadze. Obserwabla o niskiej wadze działa nietrywialnie tylko na kilku kubitach. Obserwable o niskiej wadze są interesujące z wielu powodów. Mogą na przykład reprezentować:
-
Pojedyncze składniki większego hamiltonianu
-
Zlokalizowany obszar oddziaływania
-
Informacje zebrane na niewielkim zbiorze kubitów pomocniczych (ancilla)
-
Inne obserwable obejmujące tylko kilka kubitów
Nie każdy błąd w obwodzie może wpłynąć na wynik pomiaru. Dotyczy to zwłaszcza błędów Pauliego lub każdego błędu, który można zamodelować jako zbiór operacji Pauliego. Przyjrzyj się na przykład poniższemu obwodowi:
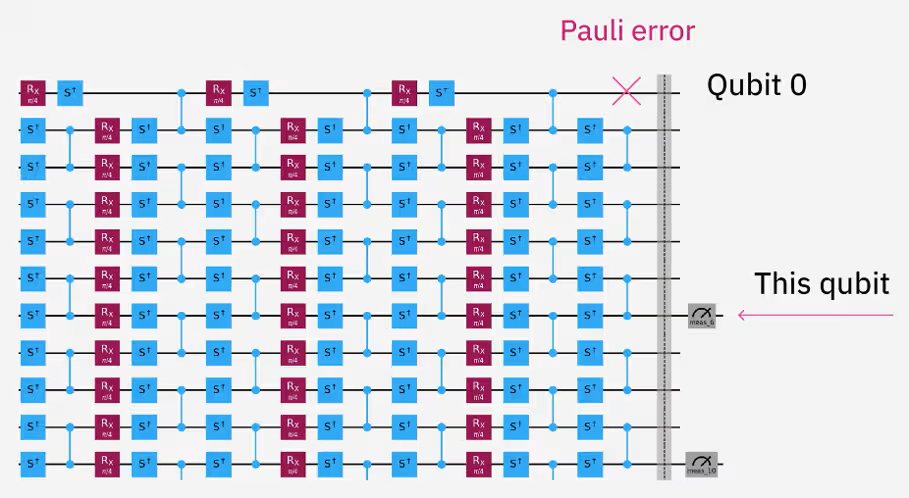
Błąd Pauliego na kubicie 0 w ostatniej warstwie nie może wpłynąć na pomiar na kubicie 6, ponieważ nie ma łączącej bramki, która mogłaby przenieść błąd z kubitu 0 na kubit 6. Zauważ, że ten argument nie dotyczy pewnych błędów nieunitarnych. Na przykład przejście typu T1 do stanu podstawowego na kubicie 0 zapada kubit 0 do stanu bazy obliczeniowej. Jeśli kubity 0 i 6 były wcześniej splątane (jak w tym obwodzie), błąd nieunitarny na kubicie 0 może wpłynąć na kubit 6. Dalsza dyskusja dotyczy błędów, które można przedstawić jako operacje Pauliego lub jako probabilistyczne mieszaniny operacji Pauliego.
W ostatniej warstwie bezpośrednio na pomiar na kubicie 6 może wpłynąć tylko błąd Pauliego na kubicie 5 lub kubicie 6.
W poprzedzającej warstwie splatającej kubity 5 i 6 są splątane odpowiednio z kubitami 4 i 7. Dlatego w tej warstwie splatającej lub tuż przed nią błąd Pauliego na dowolnym z tych czterech kubitów może wpłynąć na późniejszy pomiar. Możesz kontynuować śledzenie wstecz przez obwód, aby znaleźć podzbiór bramek i kubitów powiązanych przyczynowo z pomiarem. Ten zbiór przyczynowy tworzy obszar w kształcie stożka w przestrzeni (kubity) i czasie (warstwy), od czego pochodzi termin stożek świetlny. Dokładny kształt tego obszaru różni się w zależności od obwodu. Ponieważ ta analiza zależy od łączności sprzętu i rozmieszczenia bramek, jest najbardziej użyteczna po transpilacji, routingu i optymalizacji układu.
Poza łącznością przyczynową
Cieniowane stożki świetlne rozszerzają tę ideę, uwzględniając także to, jakie typy błędów mają znaczenie.
Zwróć na przykład uwagę na następujące kwestie:
-
Błąd Z tuż przed pomiarem w bazie Z nie ma wpływu na wynik pomiaru.
-
Błąd X tuż przed pomiarem w bazie Z może radykalnie zmienić wynik.
Niektóre typy błędów wymagają zatem większego wysiłku mitygacji niż inne. To rozróżnienie może znacznie zmniejszyć narzut technik takich jak PEC. W praktyce dodatek generuje osobne analizy czułości dla każdego z następujących typów błędów:
-
X errors
-
Z errors
-
Błędy Y (lub XZ z dokładnością do fazy)
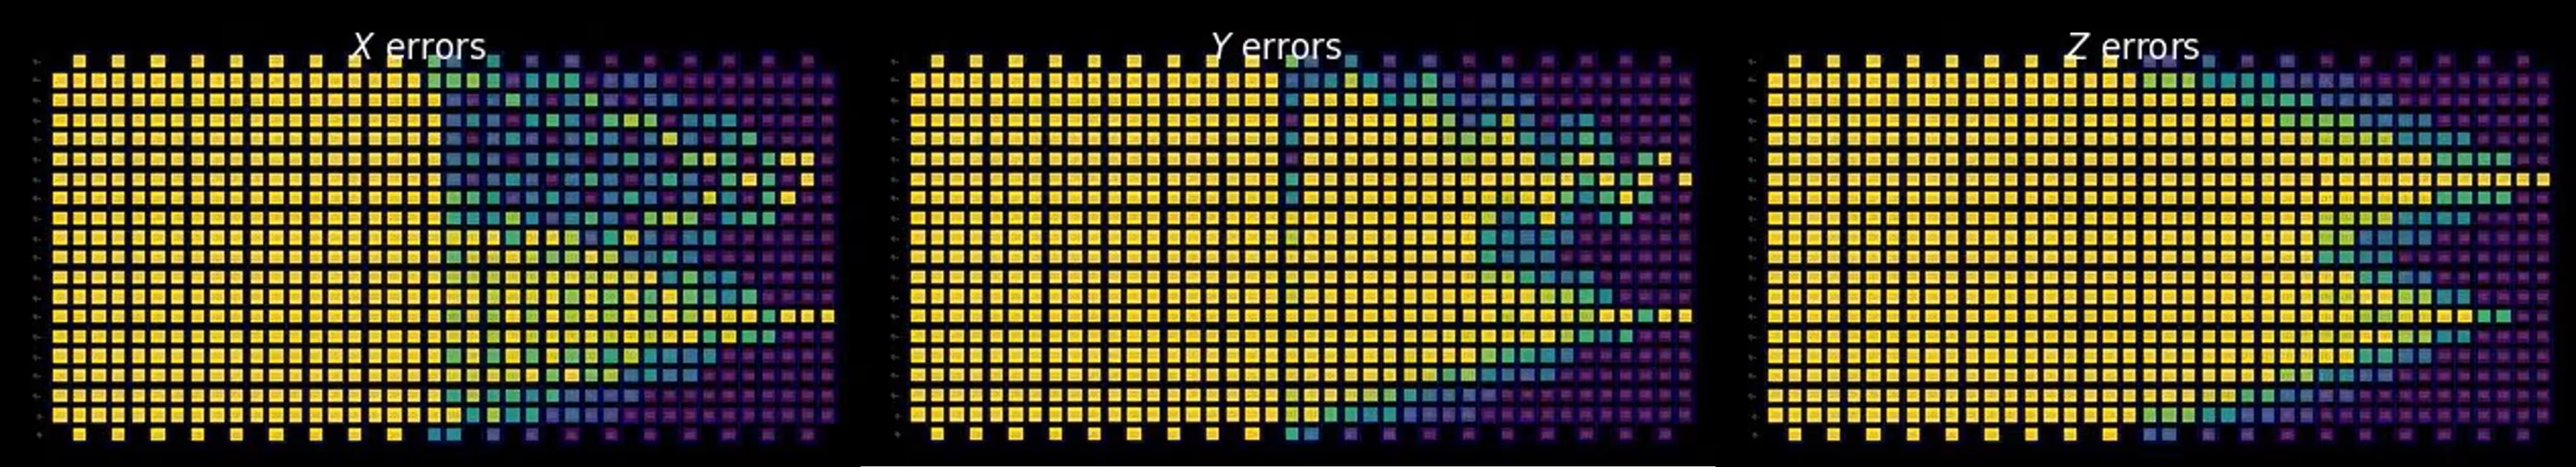
Ta czułość na błędy zazwyczaj wygląda inaczej dla każdego typu błędu, ponieważ różne powiązane przyczynowo błędy w różny sposób wpływają na pomiar. Zauważ też, że czułość zmienia się w trakcie obwodu. Błąd X tuż przed pomiarem może być bardzo szkodliwy, podczas gdy błąd występujący wiele warstw wcześniej może mieć mniejszy wpływ po propagacji przez silnie splątany stan.
Cieniowane stożki świetlne określają ilościowo tę różnicę, przypisując wartość czułości potencjalnym błędom w całym obwodzie.
Uzyskane mapy wskazują:
-
Gdzie błędy mają znaczenie
-
Które typy błędów mają znaczenie
-
Jak silnie wpływają na końcową obserwablę
Cieniowane stożki świetlne same nie mitygują błędów, ale mogą pomóc skoncentrować wysiłek mitygacji tam, gdzie przynosi największą korzyść.
Uczenie i wstrzykiwanie szumu
Po skonstruowaniu, zoptymalizowaniu i opatrzeniu obwodu adnotacjami pozostają dwa uzupełniające się zadania: uczenie szumu oraz używanie modelu szumu (na przykład do wstrzykiwania szumu lub propagowania jego skutków).
NoiseLearnerV3
NoiseLearnerV3 to obecne narzędzie do uczenia szumu. Poprzedni interfejs NoiseLearner przyjmował całe obwody i tworzył modele szumu Pauli-Lindblad. NoiseLearnerV3 działa natomiast bezpośrednio na instrukcjach obwodu ujętych w ramki. W skrócie NoiseLearnerV3 robi następujące rzeczy:
-
Przyjmuje kolekcje oznaczonych warstw obwodu
-
Ponownie wykorzystuje informacje z powtarzających się warstw
-
Obsługuje uczenie szumu pomiaru
-
Obsługuje przetwarzanie końcowe nauczonych modeli
-
Umożliwia przepływy wstrzykiwania i skalowania szumu
Ten projekt jest ściśle zgodny z warstwowo zorientowanym przepływem pracy Samplomatic. W szczególności NoiseLearnerV3 stosuje dla każdego zestawu instrukcji następujące metody:
-
Uczenie Pauli-Lindblad dla operacji bramek
-
Uczenie oparte na TREX dla pomiarów
Nauczony model szumu możesz następnie wykorzystać w wielu omówionych już metodach. Przypomnij sobie na przykład, że ekstrapolacja do zerowego szumu (ZNE) z foldingiem bramek może prowadzić do niewykonalnie głębokich obwodów. Alternatywną metodą skalowania szumu w tym przypadku było próbkowanie ze znanego modelu szumu, co skutecznie zwiększa poziom szumu, nawet o czynniki niecałkowite. Ta metoda, probabilistyczna amplifikacja błędów (PEA), jest dobrym przykładem tego, jak można użyć modelu szumu do mitygacji błędów. Dobry model szumu jest też wymagany dla probabilistycznego znoszenia błędów (PEC) i absorpcji propagowanego szumu (PNA).
Krótko mówiąc, dzięki wysokiej jakości modelowi szumu szum staje się programowalnym zasobem, a nie tylko źródłem błędów.
Cieniowane stożki świetlne a NoiseLearnerV3
NoiseLearnerV3 i SLC są blisko powiązane, ale przyjmują różne dane wejściowe i odpowiadają na różne pytania. SLC określa, gdzie skupić wysiłek mitygacji. NoiseLearnerV3 charakteryzuje rzeczywisty szum obecny w tych obszarach. Te procesy wiążą się też z różnymi rodzajami narzutu. Poniższa tabela podsumowuje te różnice.
| Cieniowane stożki świetlne | NoiseLearnerV3 | |
|---|---|---|
| Cel | Wskazuje, gdzie mitygacja ma znaczenie | Uczy się, jak zachowują się błędy |
| Narzut | Głównie narzut klasyczny | Wymaga wykonań na sprzęcie |
| Wynik | Tworzy mapy czułości | Tworzy opisy kanałów szumu |
| Dane wejściowe | Wykorzystuje strukturę obwodu i propagację operatorów | Wykorzystuje strukturę obwodu i eksperymentalne dane ze sprzętu |
Executor i wykonanie w środowisku uruchomieniowym
Executor wykonuje końcowy etap wykonania. Może działać na jednym z następujących danych wejściowych:
-
Obwód szablonowy i samplex wygenerowane przez Samplomatic
-
Konwencjonalny obwód kwantowy bez Samplomatic
Dzięki tej elastyczności możesz przyjąć tyle składników przepływu kierowanego wykonania, ile potrzebujesz.
Executor ściśle współpracuje z Samplomatic, który zarządza wyborami randomizacji, przydziałem prób, wyborami wstrzykiwania szumu i powiązanymi metadanymi wykonania, jak opisano wcześniej.
Praktyczne przykłady modelu kierowanego wykonania znajdziesz w przewodniku Directed execution model oraz w tutorialach i dokumentacji dodatków Qiskit na IBM Quantum® Platform.
Podsumowanie
Nowoczesne przepływy pracy kwantowej coraz częściej opierają się na zestawie uzupełniających się narzędzi, a nie na pojedynczym prymitywie wykonania.
Te narzędzia wspierają każdy etap przepływu pracy:
-
Mapowanie problemu
-
Konstrukcja obwodu
-
Transpilacja i optymalizacja
-
Tłumienie błędów
-
Mitygacja błędów
-
Uczenie szumu
-
Ustrukturyzowane wykonanie
-
Przetwarzanie końcowe
Razem narzędzia takie jak Samplomatic, Executor, NoiseLearnerV3, cieniowane stożki świetlne, absorpcja propagowanego szumu, cięcie obwodów i AQC-Tensor zapewniają znacznie większą kontrolę niż wcześniejsze modele wykonania.
Dziedzina wciąż szybko się rozwija. W miarę jak procesory kwantowe stają się większe i lepiej połączone, techniki te prawdopodobnie odegrają coraz ważniejszą rolę w osiąganiu użytecznej przewagi kwantowej, a z czasem w płynnej integracji z przepływami obliczeń kwantowych odpornych na błędy.