Tłumienie i kształtowanie błędów
Tłumienie błędów może odnosić się do dowolnej techniki, która przewiduje i stara się unikać określonych rodzajów szumu i błędów. Najłatwiej wyjaśnić to na konkretnych przykładach, ale należy pamiętać, że metody te nie ograniczają się do przykładów przedstawionych tutaj, a nowe metody są nieustannie odkrywane. Czasami nie da się stłumić błędów, ale można wpłynąć na sposób ich kumulacji. Jeśli uda nam się sprawić, by błędy kumulowały się wolniej, możemy opisać to jako tłumienie ogólnego błędu, ale dokładniej jest to postrzegać jako kształtowanie szumu. W tej lekcji omawiamy klasyczne przykłady tłumienia błędów (dynamiczne rozsprzęganie) oraz kształtowania/formowania szumu (Pauli twirling).
Film towarzyszący tej lekcji zostanie opublikowany w ciągu najbliższych kilku dni i zostanie tutaj osadzony.
Dynamiczne rozsprzęganie
Zacznijmy od bardzo prostego stanu na pojedynczym kubicie i wprowadźmy prosty model szumu. Nie wystarczy to do pełnego wyjaśnienia dynamicznego rozsprzęgania, ale daje nam jasny przykład. Załóżmy, że mamy kubit przygotowany w stanie superpozycji za pomocą bramki Hadamarda:
Ten stan jest zwizualizowany na sferze Blocha, jak pokazano poniżej po lewej stronie. W idealnym przypadku bez szumu ten kubit pozostałby w tym stanie aż do wykonania następnej operacji. Jednak z poprzedniej lekcji wiemy, że nie tak wygląda rzeczywistość. Szum powoduje degradację informacji kwantowej.
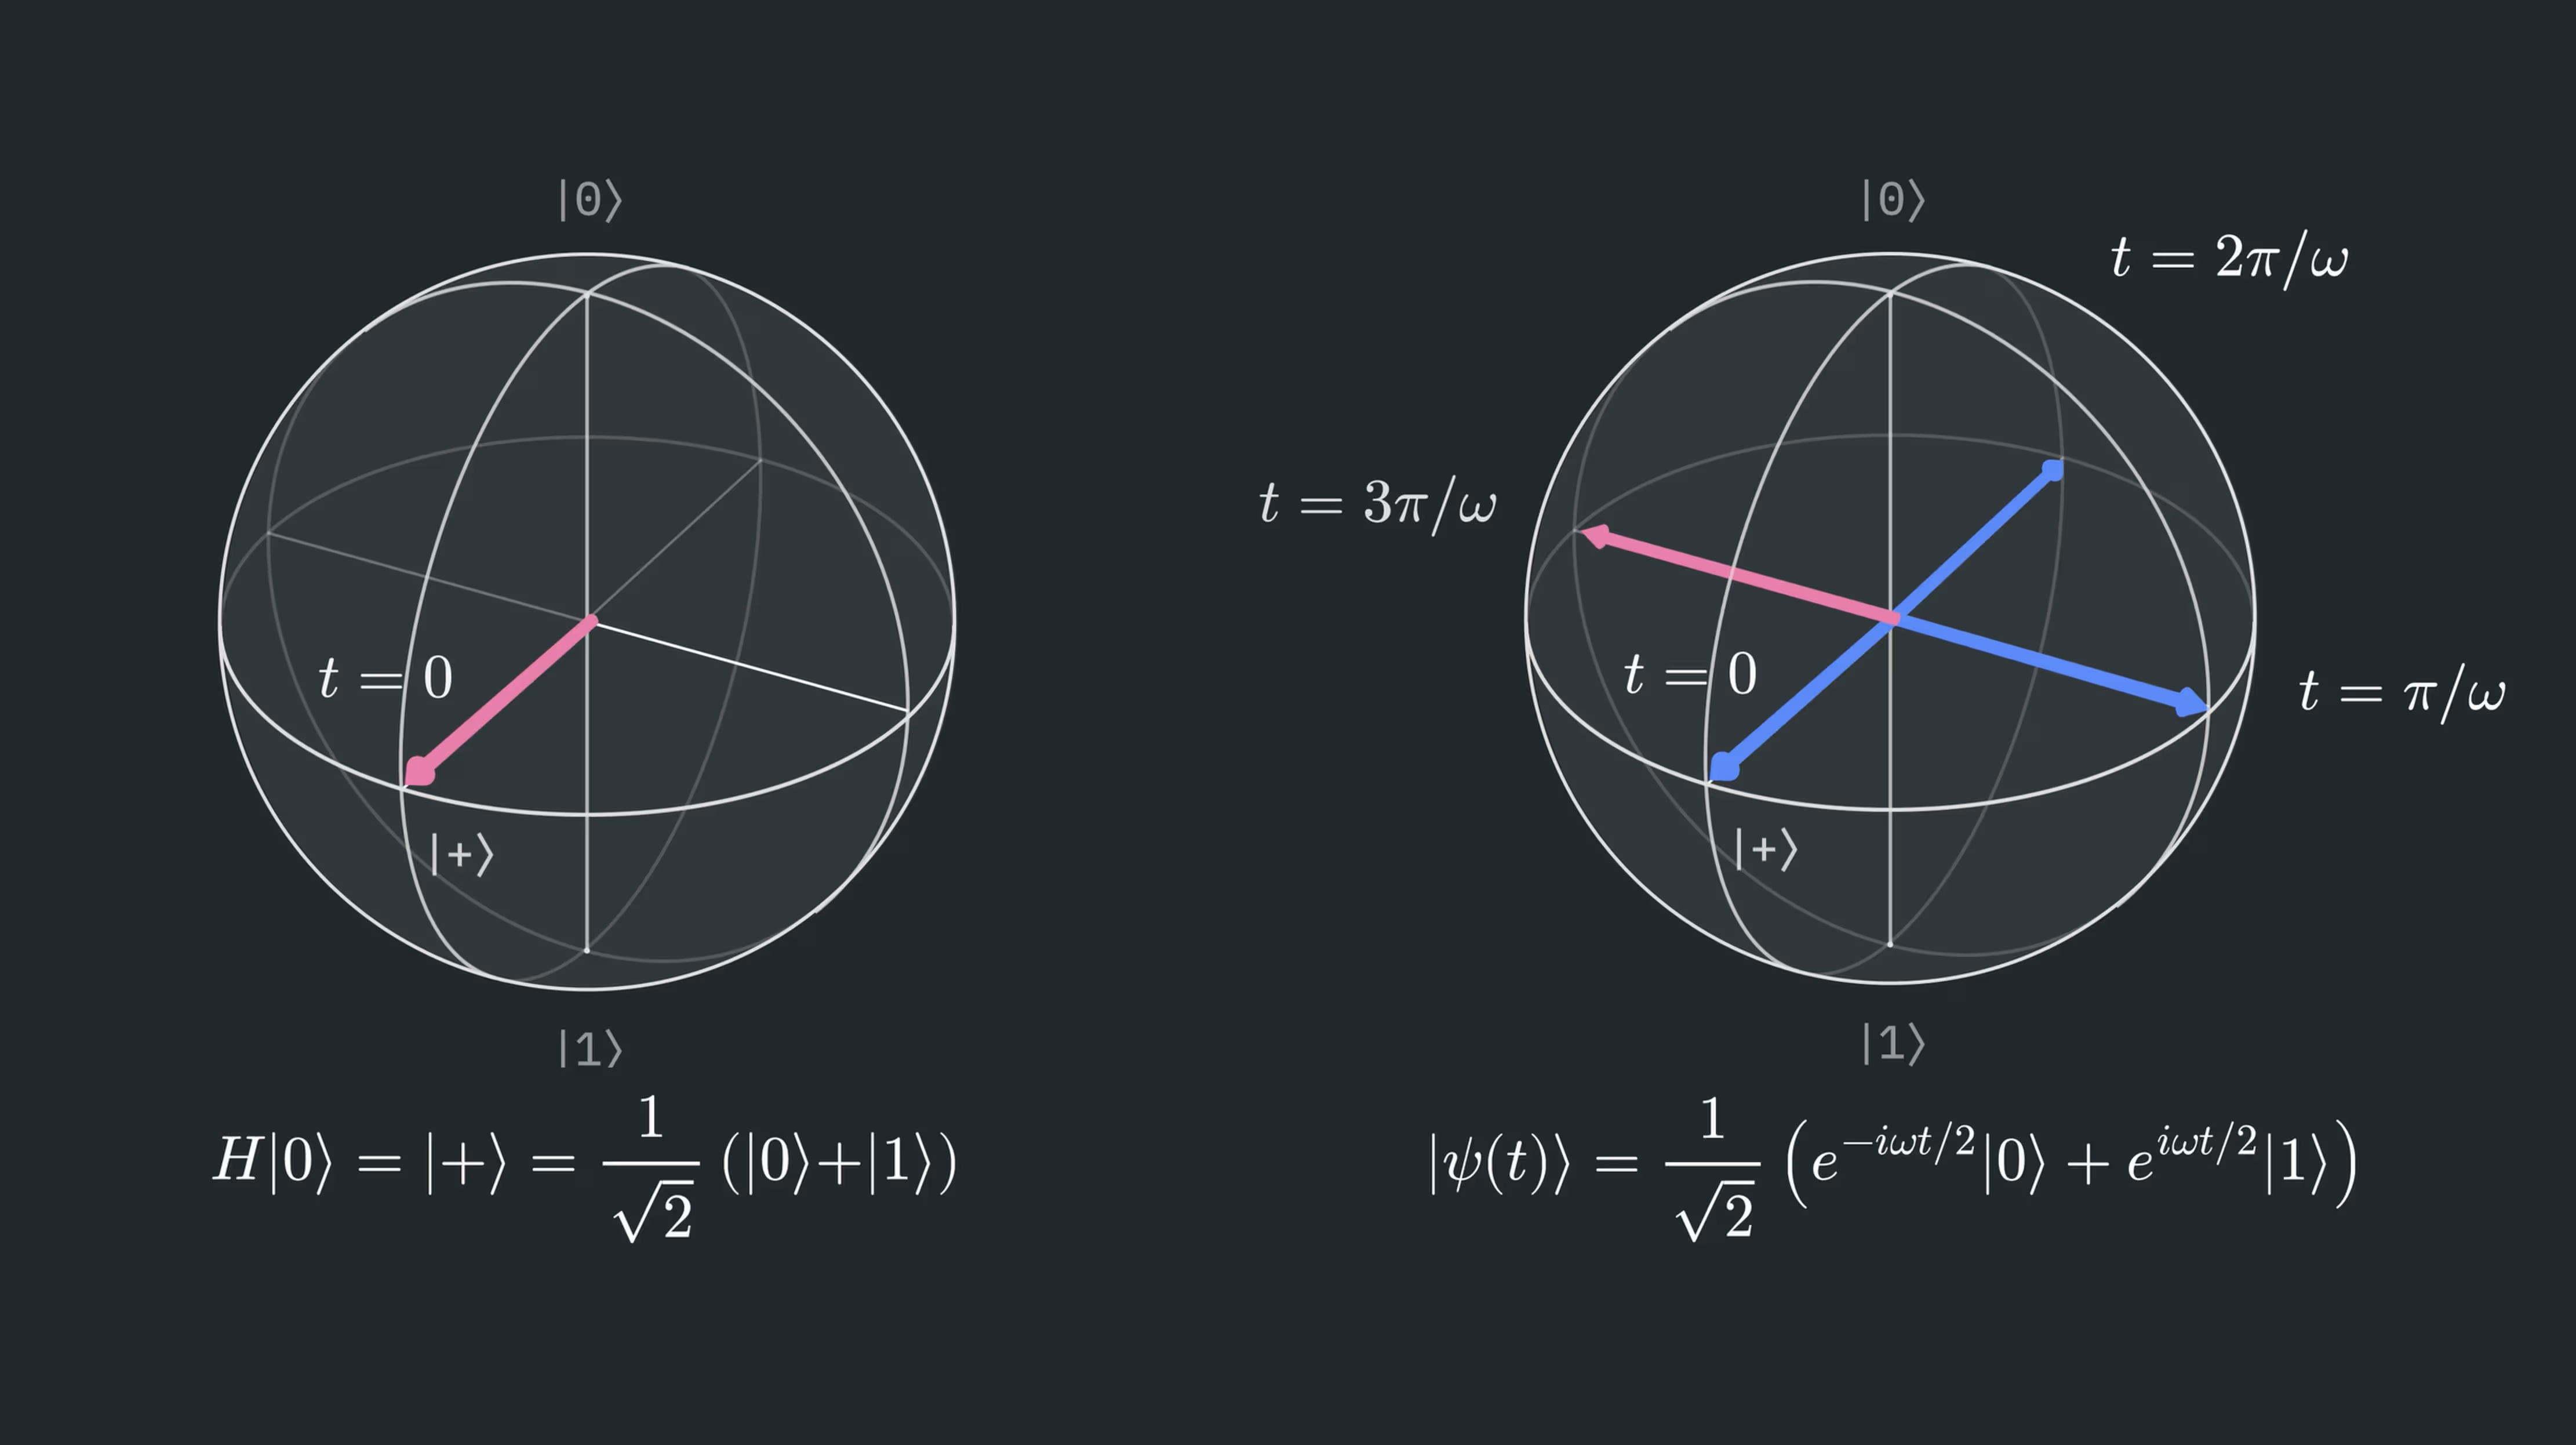
Szum lub sprzężenie ze środowiskiem może powodować zmianę fazy względnej między stanami bazowymi. Oznacza to, że prawdopodobieństwa i nie zmieniają się, ponieważ wartości bezwzględne ich współczynników pozostają takie same. Zmieniają się natomiast fazy amplitud, co zmienia ich część rzeczywistą i urojoną. Aby uczynić tę dyskusję bardziej konkretną, rozważmy jeden rodzaj oddziaływania, które może to powodować: sprzężenie z polem magnetycznym skierowanym wzdłuż osi Z: .
Rozważmy, co dzieje się ze stanem wraz z upływem czasu:
Skorzystaliśmy tutaj z faktu, że pole magnetyczne skierowane wzdłuż osi Z powoduje precesję wokół osi Z z częstotliwością , która zależy od efektywnego momentu magnetycznego i natężenia pola magnetycznego. Szczegóły są mniej ważne niż fakt, że to oddziaływanie powoduje ewolucję wokół osi Z, co skutkuje przeciwną akumulacją fazy dla dwóch bazowych stanów obliczeniowych. Stosując ten operator do każdego składnika w , otrzymujemy:
Ta zależna od czasu faza odpowiada precesji wokół osi Z w obrazie sfery Blocha. Pokazano to w prawej połowie powyższego rysunku.
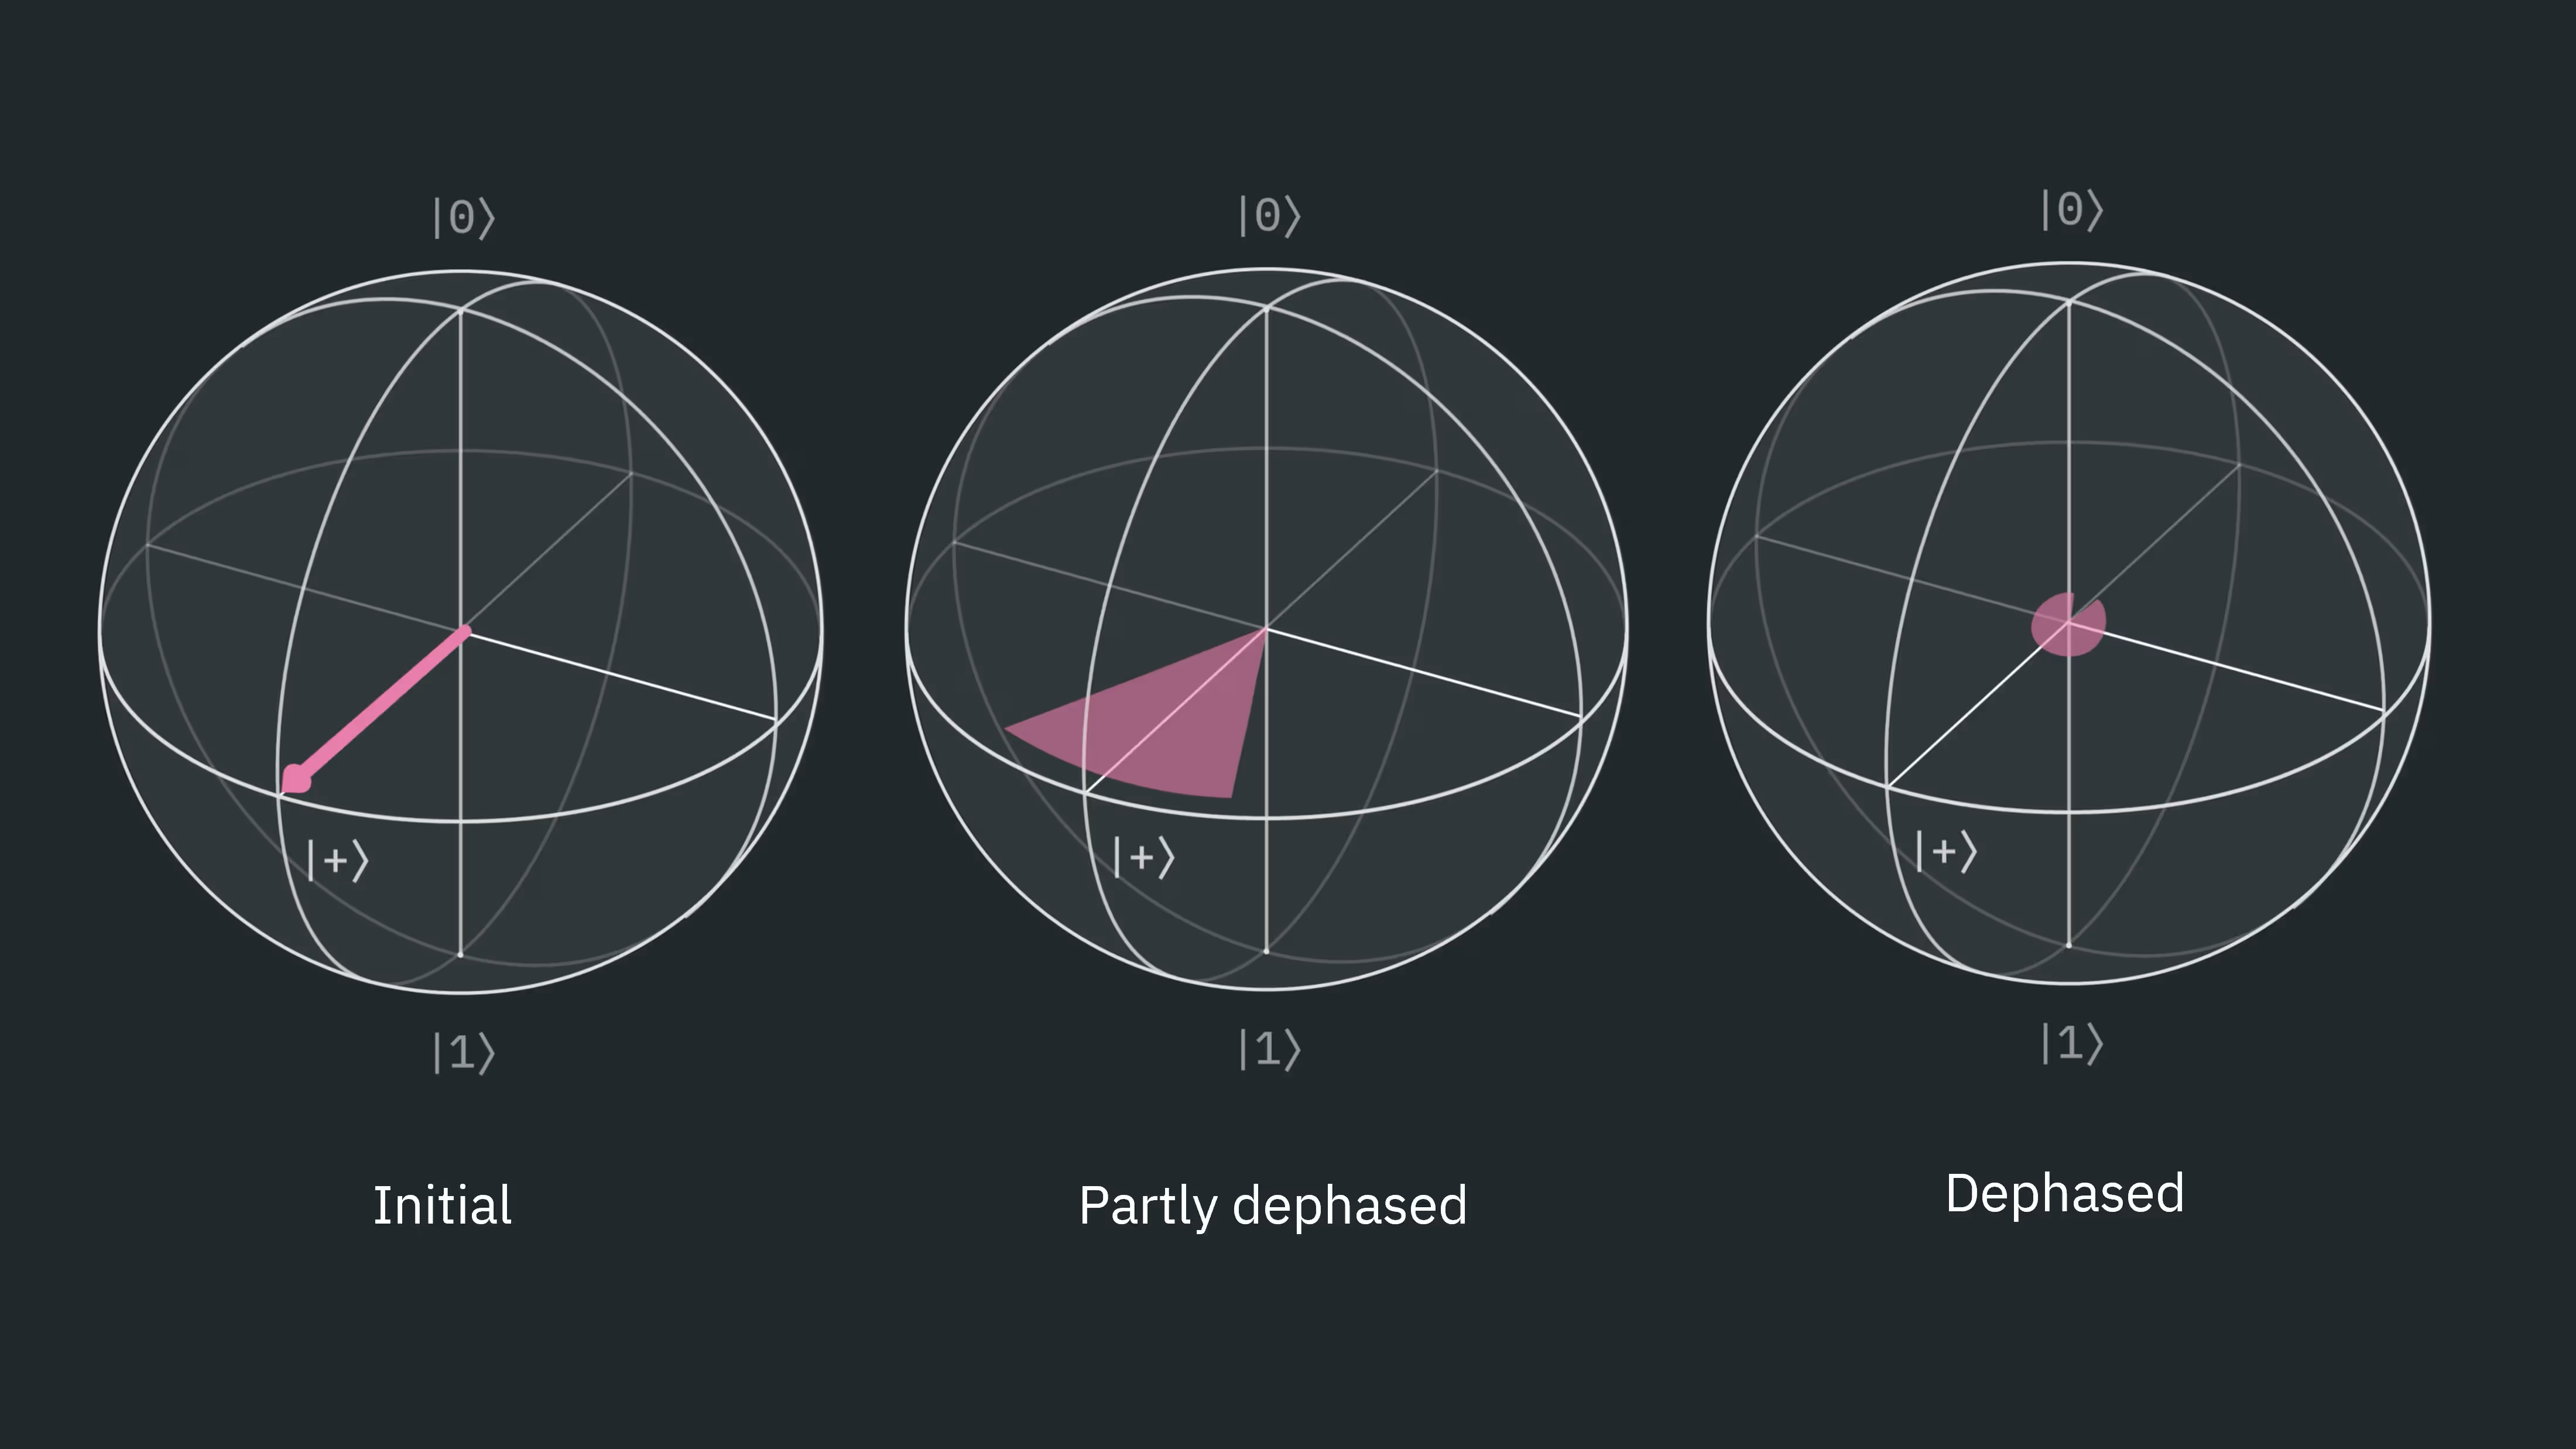
Gdybyśmy wiedzieli, że to oddziaływanie zachodzi w kontrolowany sposób, moglibyśmy je przewidzieć. Aby zamodelować ten rodzaj szumu, rozważamy zamiast tego rozkład możliwych natężeń pola magnetycznego, z których każde występuje z pewnym klasycznym prawdopodobieństwem (inne źródła szumu wymagałyby innego modelowania). Musimy rozważyć, co się dzieje, gdy istnieje niezerowe klasyczne prawdopodobieństwo, że stan w ogóle się nie obrócił, a także pewne prawdopodobieństwo, że obrócił się o niewielką wartość, a nawet o dużą wartość. Ten rozkład możliwych obrotów jest przyczyną rozmycia stanu na obrazie sfery Blocha poniżej. Jeśli tego rodzaju szumu defazującego jest więcej, faza będzie mniej dobrze określona. W granicy silnej defazacji kubit staje się całkowicie zdefazowany, co odpowiada utracie koherencji kwantowej przechowywanej w stanie.
Oczywiście w eksperymencie nie mamy pojęcia, jakie losowe sprzężenie wystąpi. Co możemy z tym zrobić?
Załóżmy, że sprzężenie ze środowiskiem pozostaje w przybliżeniu stałe w przedziale czasu . Rozważmy, co by się stało, gdybyśmy zastosowali następującą procedurę:
-
Pozwól, aby faza zmieniała się przez czas
-
Zastosuj bramkę X do kubitu
-
Pozwól, aby to samo sprzężenie ze środowiskiem trwało przez kolejny czas
-
Zastosuj drugą bramkę X
Po początkowej ewolucji czasowej mielibyśmy dokładnie powyższy stan. Stosując pierwszą bramkę X, otrzymujemy:
Teraz, gdy upłynie drugi przedział , zachodzi to samo oddziaływanie. Ale teraz amplitudy są powiązane z przeciwnymi stanami własnymi Z, co oznacza, że znak obrotu wokół osi Z uległ zmianie. Po pozwoleniu układowi na ewolucję przez kolejny czas otrzymujemy stan:
Podstawiając , otrzymujemy:
Zastosowanie ostatniej bramki X nic w tym przypadku nie zmienia, ale ogólnie jest konieczne:
Odzyskaliśmy oryginalny stan kwantowy, wraz z jego fazą względną. Ten proces jest szczególnie prostym przykładem dynamicznego rozsprzęgania.
Mówiąc ogólniej, dynamiczne rozsprzęganie (DD) polega na wstawianiu pewnych bramek jednokubitowych, aby zredukować wpływ oddziaływań z układami spoza kubitu (rozsprzęgając go od otoczenia). Całkowite przywrócenie wszystkich możliwych historii fazy do stanu początkowego, jak pokazano powyżej, jest nieco wyidealizowane, ale nadal jest to możliwy scenariusz. Omówmy, kiedy DD jest przydatne i jakie istnieją zastrzeżenia.
Sprawdź swoje zrozumienie
W powyższym tekście przeanalizowaliśmy krok po kroku efekt sekwencji DD XX na stanie początkowym . Sprawdź, czy te same powyższe kroki również przywracają stan do jego stanu początkowego przy tych samych założeniach o wolno zmieniającym się polu magnetycznym wzdłuż osi z.
Odpowiedź
Po początkowej ewolucji czasowej mielibyśmy dokładnie powyższy stan. Stosując pierwszą bramkę X, otrzymujemy:
Teraz, gdy upłynie drugi przedział , zachodzi to samo oddziaływanie. Ale teraz amplitudy są powiązane z przeciwnymi stanami własnymi Z, co oznacza, że znak obrotu wokół osi Z uległ zmianie. Po pozwoleniu układowi na ewolucję przez kolejny czas otrzymujemy stan:
Podstawiając , otrzymujemy
Stosując ostatnią bramkę X, otrzymujemy:
Kiedy stosować DD
Pierwszym i najbardziej oczywistym zastrzeżeniem jest to, że w naszym opisie założyliśmy czysto defazujący kanał. Rzeczywiste oddziaływania zwykle powodują mieszankę defazacji i innych mechanizmów błędów. W powyższym opisie zdecydowaliśmy się zastosować konkretnie bramki X. Jest to nazywane sekwencją XX w dynamicznym rozsprzęganiu. Ta konkretna sekwencja jest odpowiednia dla błędów czysto defazujących. Istnieją jednak inne sekwencje, które mogą mieć szersze zastosowanie, jak XY4 (pokazana na poniższym diagramie obwodu) i bardziej złożona XY8.

Kolejnym zastrzeżeniem jest to, że dynamiczne rozsprzęganie dodaje bramki jednokubitowe, które mogą wprowadzać błędy jednokubitowe wynikające z niedoskonałości bramek lub nawet przesłuchów (crosstalk). Te współczynniki błędów jednokubitowych są zazwyczaj znacznie niższe niż błędy bramek wielokubitowych, więc zwykle nie stanowi to poważnego problemu, ale warto o tym pamiętać, jeśli wiele kubitów wielokrotnie wykorzystuje DD w całym obwodzie.
DD jest przydatne, gdy zewnętrzne sprzężenie ma czas, aby wpłynąć na stan kubitu. Ponieważ kubity są starannie dobrze izolowane, a zewnętrzne sprzężenia powinny być słabe, ten rodzaj szumu jest najbardziej zauważalny, gdy kubit pozostaje bezczynny przez długi czas. Przy krótkich czasach bezczynności efektem DD może być dodanie błędów bramek jednokubitowych przy jednoczesnym stłumieniu bardzo niewielkiej ilości szumu; wierność (fidelity) obwodu może faktycznie zostać obniżona.
Kluczowy wniosek: Stosuj dynamiczne rozsprzęganie, gdy kubity pozostają bezczynne przez wystarczająco długi czas, i zwracaj uwagę na rodzaj stosowanej sekwencji DD.
Dynamiczne rozsprzęganie z użyciem Qiskit
Zbadajmy zastosowanie DD, analizując przypadek kilku kubitów przygotowanych w stanie , które następnie pozostają bezczynne przez długi czas. W przypadku braku błędów, przygotowanie wielokubitowego stanu , a następnie zastosowanie bramki Hadamarda przed pomiarem (czyli pomiar w bazie X) powinno zawsze dawać wynik 0. Przy obecności szumu wynik pomiaru będzie równy 0 tylko przez część czasu, a nie ze 100% prawdopodobieństwem. Obliczamy średnią wartość oczekiwaną X dla wielu kubitów. Innymi słowy, interesuje nas następująca wielkość:
gdzie z operatorem X na -tej pozycji licząc od prawej, a jest stanem całego układu.
Ten obwód zawiera celowe opóźnienia, co jest nieco sztuczne dla testu porównawczego. Jednak bardzo często rzeczywiste obwody zawierają kubity, które pozostają bezczynne przez część wykonania. Można to traktować jako uproszczony model bardziej złożonego obwodu, w którym niektóre kubity pozostają bezczynne przez część obliczeń. Ten rodzaj testowania oparty na ewolucji stanów jest często nazywany testem Ramseya (Ramsey benchmarking).
Zaczynamy od załadowania niezbędnych pakietów i skonfigurowania usługi.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-aer qiskit-ibm-runtime
# Load key packages

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit
import numpy as np

# --------- Configuration ----------

service = QiskitRuntimeService()  # assumes credentials are saved
backend = service.backend("ibm_fez")  # adjust if needed
Teraz zdefiniujemy kilka funkcji pomocniczych. Najpierw chcemy zająć się kwestią długich czasów bezczynności. Co dokładnie oznacza „długi” w tym kontekście? Moglibyśmy po prostu podać czas bezczynności w mikrosekundach. Jednak przydatne jest wiedzieć, ile bramek dwukubitowych mogłoby zostać wykonanych w tym samym przedziale czasu. Dzięki temu czasy bezczynności bardziej bezpośrednio wskazują głębokość obwodu, która mogłaby zostać wykonana w tym samym okresie. Pierwsza funkcja pomocnicza pobiera bramkę dwukubitową natywną dla backendu i określa czas trwania tej bramki.
Druga funkcja po prostu tworzy obwód Ramseya (z kubitami w stanie ), wprowadza opóźnienie, obraca za pomocą bramki H, a następnie dokonuje pomiaru. Przypomnijmy, że bramka Hadamarda (H) przekształca w , więc zmierzenie w bazie Z po bramce Hadamarda odpowiada temu, że kubit znajdował się w stanie bezpośrednio przed bramką Hadamarda.
Nasza ostatnia funkcja przekształca surowe liczby wyników pomiarów 0 i 1 w wartość oczekiwaną X.
from typing import Tuple
from qiskit.providers import Backend
from numpy.typing import NDArray

# --------- Utilities ----------
def detect_twoq_gate_and_duration(
    backend: Backend, pair: tuple[int, int] = (0, 1)
) -> Tuple[str, float]:
    props = backend.properties()
    candidates = ["cx", "ecr", "cz"]
    for name in candidates:
        try:
            dur = props.gate_length(name, list(pair))
            if dur is not None:
                return name, dur
        except Exception:
            pass
    raise RuntimeError(
        "Could not find a two-qubit gate duration among cx/ecr/cz on this backend."
    )

def make_multiqubit_ramsey_circuit(n: int, delay_dt_ticks: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q)
    qc.barrier()

    for i in range(n):
        qc.delay(delay_dt_ticks, q[i], unit="dt")
    qc.barrier()

    qc.h(q)
    qc.measure(q, c)
    return qc

def counts_to_x_expectations(counts: dict[str, int], n: int) -> NDArray[np.float64]:
    total = sum(counts.values())
    if total == 0:
        return np.zeros(n)

    p0 = np.zeros(n, dtype=float)
    for bitstring, cnt in counts.items():
        bits_rev = bitstring[::-1]
        for i in range(n):
            if bits_rev[i] == "0":
                p0[i] += cnt
    p0 /= total
    return 2.0 * p0 - 1.0
Teraz określamy szczegóły naszego testu, w tym liczbę kubitów i sekwencję bramek do zastosowania w DD (w tym przypadku XX). Zwróć szczególną uwagę, że ustawiamy poziom optymalizacji na zero. W praktyce często wybierano by wyższy poziom optymalizacji; tutaj używamy poziomu 0, aby upewnić się, że efekty błędów, na które ukierunkowane jest DD, pozostają widoczne. Na koniec wyznaczamy charakterystyczny czas dla bramek dwukubitowych na tym backendzie i wypisujemy kilka istotnych czasów.
n_qubits = 10  # number of qubits to test in parallel
shots = 4096
opt_level = 0  # we want to ignore optimization for now
num_steps = 6  # number of delay points
gates_per_step = 20  # "equivalent 2q gates" per step
dd_sequence = "XX"  # "XX" for your request; you might try "XY4" too

# --------- Derive timing: dt and 2q gate time ----------
dt = backend.dt  # seconds per dt
twoq_name, t2q = detect_twoq_gate_and_duration(backend, (0, 1))  # seconds
delay_unit_dt = int(round(t2q / dt))  # dt ticks equivalent to one 2q gate

print(f"Backend: {backend.name}")
print(f"dt = {dt*1e9:.3f} ns per tick")
print(f"Using 2q gate '{twoq_name}' with duration ~ {t2q*1e9:.1f} ns")
print(f"One 2q gate ≈ {delay_unit_dt} dt ticks")
Backend: ibm_fez
dt = 4.000 ns per tick
Using 2q gate 'cz' with duration ~ 68.0 ns
One 2q gate ≈ 17 dt ticks
Teraz konstruujemy nasze obwody i transpilujemy je dla wybranego backendu.
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

equiv_gates_list = [
    j * gates_per_step for j in range(num_steps)
]  # e.g., 0, 100, 200, ...
delay_dt_list = [int(round(delay_unit_dt * m)) for m in equiv_gates_list]
delay_us_list = [(dt * d) * 1e6 for d in delay_dt_list]  # for printing/plotting

circuits = []
for delay_dt in delay_dt_list:
    qc = make_multiqubit_ramsey_circuit(n_qubits, delay_dt)
    qc_isa = pm.run(qc)  # ISA-level scheduling/placement; DD is handled at runtime
    circuits.append(qc_isa)

print("Delay sweep (approx microseconds):", [f"{t:.2f}" for t in delay_us_list])
Delay sweep (approx microseconds): ['0.00', '1.36', '2.72', '4.08', '5.44', '6.80']
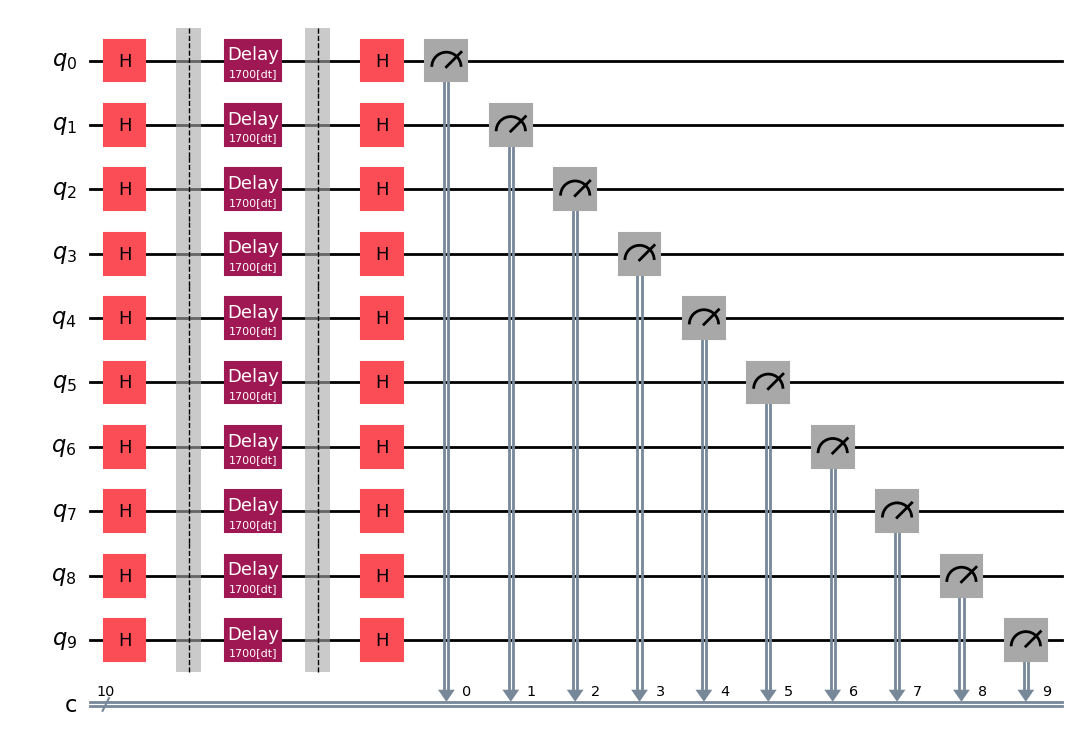
Powinniśmy zwizualizować przynajmniej jeden obwód, aby upewnić się, że zakodowaliśmy obwód z pożądanymi stanami i opóźnieniami. Łatwiej może być zwizualizować obwód przed transpilacją qc, albo można sprawdzić przetranspilowany qc_isa.
qc.draw("mpl")
Wykonanie
Jesteśmy wreszcie gotowi do wykonania na sprzęcie. Używamy Sampler, aby uzyskać wiele pomiarów każdego kubitu, i użyjemy go dwukrotnie: raz z jawnie wyłączonym DD, a raz z włączonym DD przy użyciu sekwencji bramek XX.
# --------- Run: NO DD ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = False

job = sampler.run(circuits)
res_nodd = job.result()
job_id = job.job_id()  # job id for dd off/false
print("job number for no dd is ", job_id)

# --------- Run: WITH DD (XX) ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = (
    dd_sequence  # "XX" first; you can try "XY4" too
)
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_dd = job.result()
job_id = job.job_id()  # job id for dd on/XX
print("job number for dd using XX is ", job_id)
Możemy wyodrębnić liczby zliczeń z poszczególnych obwodów.
# --------- Extract counts per circuit ----------

from typing import Iterable, Any

def extract_counts_list(res: Iterable[Any]) -> list[dict[str, int]]:
    counts_list: list[dict[str, int]] = []

    for r in res:  # each r corresponds to one circuit
        counts: dict[str, int] = r.data.c.get_counts()
        counts_list.append(counts)

    return counts_list

counts_list_nodd = extract_counts_list(res_nodd)
counts_list_dd = extract_counts_list(res_dd)
Przetwarzanie końcowe
Mamy teraz liczby zliczeń z pomiaru, ale chcemy przekształcić je w wartość oczekiwaną X, a następnie uśrednić te wartości oczekiwane dla wszystkich użytych kubitów, aby dowiedzieć się więcej o zachowaniu informacji fazowej. W tym celu używamy naszej wcześniej zdefiniowanej funkcji counts_to_x_expectations.
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.

xexp_nodd = []
xexp_dd = []
contrast_nodd = []
contrast_dd = []

for counts in counts_list_nodd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_nodd.append(x_vec)
    contrast_nodd.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

for counts in counts_list_dd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_dd.append(x_vec)
    contrast_dd.append(float(np.mean(np.abs(x_vec))))

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1 in zip(equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD  :", np.round(np.abs(xexp_dd[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.954,  DD(XX)= 0.961
Delay ~   20 * cz  (~   1.36 µs):  NoDD= 0.827,  DD(XX)= 0.927
Delay ~   40 * cz  (~   2.72 µs):  NoDD= 0.793,  DD(XX)= 0.900
Delay ~   60 * cz  (~   4.08 µs):  NoDD= 0.729,  DD(XX)= 0.876
Delay ~   80 * cz  (~   5.44 µs):  NoDD= 0.661,  DD(XX)= 0.854
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.586,  DD(XX)= 0.826

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.05  0.744 0.712 0.867 0.844 0.234 0.473 0.755 0.59  0.587]
DD  : [0.583 0.89  0.921 0.88  0.908 0.832 0.893 0.773 0.807 0.773]
Na koniec przedstawmy nasze wyniki na wykresie.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With DD", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
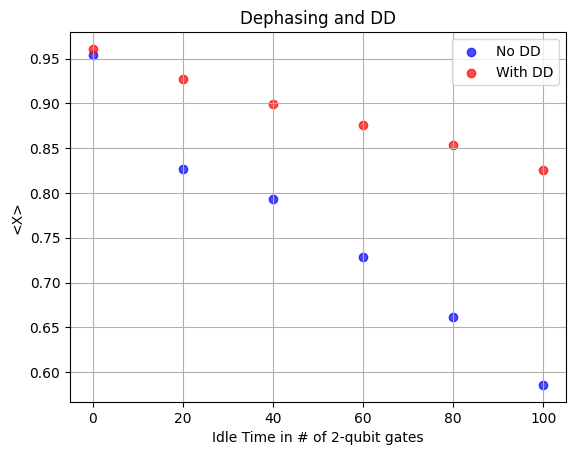
Jak widać, przy braku jawnego opóźnienia wartości oczekiwane są rzeczywiście bliskie 1, czego byśmy oczekiwali, gdyby cała informacja fazowa była zachowana. Gdyby cała informacja fazowa została utracona, nie byłoby żadnej preferencji, by końcowy obrót dawał zamiast , a średnia wartość oczekiwana zbliżałaby się do zera. W danych widzimy, że wraz ze wzrostem czasów opóźnienia średnia wartość oczekiwana X maleje, zbliżając się do zera. Zauważ, że DD było tutaj bardzo skuteczne; wartości oczekiwane z DD są zazwyczaj o ponad 20% lepsze (bliższe 1) niż wartości bez DD. Zauważ jednak również, że pierwszy opóźniony punkt danych odpowiada opóźnieniu w przybliżeniu równoważnemu 100 operacjom bramek dwukubitowych. To potwierdza fakt, że DD jest najbardziej przydatne, gdy kubity pozostają bezczynne przez stosunkowo długie okresy.
Sprawdź swoje zrozumienie
Jeśli zastosujemy DD z użyciem XY4 do tego samego obwodu co wcześniej, czy spodziewasz się wyników znacznie lepszych, znacznie gorszych, czy podobnych do DD z użyciem XX? Wyjaśnij.
Odpowiedź
Podobnie, być może nieco gorzej. Obwód, którego użyliśmy, miał stany obrócone do płaszczyzny XY. Taki stan przechowuje informację głównie w swojej fazie, przez co jest szczególnie wrażliwy na błędy defazujące, a nie na relaksację T1. XY4 może pomóc przy szerszej gamie błędów, ale XX jest już zoptymalizowane pod kątem obwodu, którego używamy. XY4 może być równie dobre, ale nie wniosłoby nic istotnego, albo fakt, że XY4 zawiera więcej bramek, może pozwolić dodatkowym błędom bramek nieco pogorszyć wyniki.
Ostatni wynik wykorzystywał najprostszą sekwencję bramek DD XX. Zobaczmy, jak zaimplementować bardziej złożoną sekwencję, XY4. Sampler definiujemy w następnej sekcji.
# --------- Run: WITH DD (XY4) ----------
dd_sequence = "XY4"

sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = dd_sequence
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_xy4 = job.result()
job_id = job.job_id()  # job id for dd on/XY4
print("job number for dd using Xy4 is ", job_id)
job number for dd using Xy4 is d6k6ti860irc7395d3hg
# --------- Extract counts per circuit ----------

counts_list_xy4 = extract_counts_list(res_xy4)
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.
xexp_xy4 = []
contrast_xy4 = []

for counts in counts_list_xy4:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_xy4.append(x_vec)
    contrast_xy4.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1, c2 in zip(
    equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd, contrast_xy4
):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD XX :", np.round(np.abs(xexp_dd[-1]), 3))
print("DD XY4 :", np.round(np.abs(xexp_xy4[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.968,  DD(XY4)= 0.968
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.612,  DD(XY4)= 0.839
Delay ~  200 * cz  (~  13.60 µs):  NoDD= 0.462,  DD(XY4)= 0.705
Delay ~  300 * cz  (~  20.40 µs):  NoDD= 0.339,  DD(XY4)= 0.580
Delay ~  400 * cz  (~  27.20 µs):  NoDD= 0.225,  DD(XY4)= 0.481
Delay ~  500 * cz  (~  34.00 µs):  NoDD= 0.204,  DD(XY4)= 0.393

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.002 0.208 0.447 0.034 0.286 0.306 0.322 0.044 0.163 0.232]
DD XX : [0.433 0.669 0.526 0.516 0.572 0.284 0.303 0.055 0.365 0.208]
DD XY4 : [0.38  0.662 0.521 0.538 0.621 0.252 0.353 0.038 0.239 0.073]
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD using XX sequence
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With XX", alpha=0.7
)

## Add values with DD using XY4 sequence
ax.scatter(
    equiv_gates_list,
    contrast_xy4,
    c="black",
    linestyle="-",
    label="With XY4",
    alpha=0.7,
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>_av")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
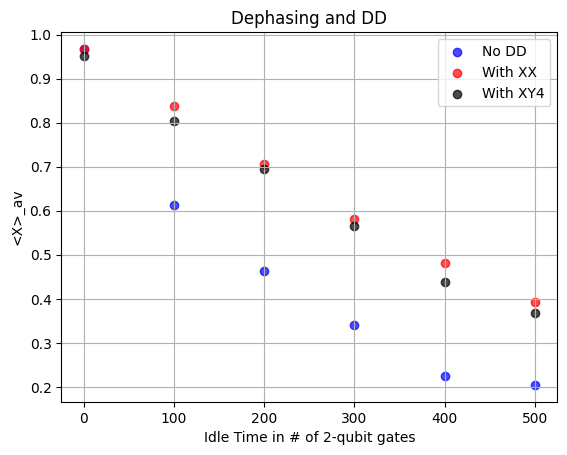
Widzimy tutaj, że XY4 nie różni się znacząco od XX. Może być odrobinę gorsza ze względu na dodatkowe bramki w sekwencji XY4, ale co ważniejsze, wyjaśniliśmy już, dlaczego XX miałaby pożądany efekt w zachowaniu fazy specyficznie dla stanu takiego jak . Nie ma powodu sądzić, że dla takiego stanu początkowego inna sekwencja poprawiłaby wyniki.
Sprawdź swoje zrozumienie
Zweryfikuj, że sekwencja XY4 pozostawia stan niezmieniony z dokładnością do globalnej fazy.
Odpowiedź
Pauli twirling
Na początek warto zauważyć, że Pauli twirling jest często stosowany nie jako technika tłumienia błędów, lecz jako technika kształtowania błędów: sprawia, że szum/błędy zachowują się inaczej, czasem bardziej przewidywalnie, co umożliwia stosowanie innych metod. Choć Pauli twirling nie zapobiega błędom, może zapobiegać ich koherentnej akumulacji.
W obwodzie kwantowym sumuje się wiele różnych źródeł błędów. Błędy mogą się sumować na różne sposoby, w szczególności koherentnie i niekoherentnie. Koherentna akumulacja błędów oznacza, że szum lub niedoskonałe implementacje mają tendencję do popychania błędów w tym samym kierunku na wielu warstwach i bramkach. Przykładem byłaby koherentna nadmierna rotacja przy stosowaniu bramki rotacji.
Rozważmy idealną bramkę rotacji, taką jak , która obraca wokół osi X dokładnie o . Oczywiście implementacja bramki nie jest doskonała, a rzeczywista rotacja może wynosić dla danej implementacji, i może się nawet zdarzyć, że ma zawsze ten sam znak i podobną wielkość przy wielu zastosowaniach . W związku z tym wielokrotne stosowanie bramek rotacji może prowadzić do koherentnej akumulacji tych licznych nadmiernych rotacji (lub niedostatecznych rotacji), .
Niekoherentna akumulacja błędów jest dokładnym przeciwieństwem: błędy w losowych kierunkach z losowymi znakami, tak że błędy w różnych warstwach nie zawsze interferują addytywnie, lecz czasem znoszą się lub sumują w kwadraturze. Wyraźnie niekoherentne błędy kumulują się wolniej pod względem ogólnego wpływu na stan kubitu. Uproszczony diagram tego zjawiska pokazano na rysunku poniżej. Jest to uproszczenie. Rzeczywiste błędy kwantowe nie są ograniczone do dwuwymiarowej przestrzeni kartezjańskiej; nie wszystkie wkłady błędów będą miały taką samą wielkość, a sprawa jest bardziej złożona. Jednak intuicja płynąca z takiego obrazu jest przydatna: błędy koherentne mają tendencję do kumulowania się szybciej niż niekoherentne.
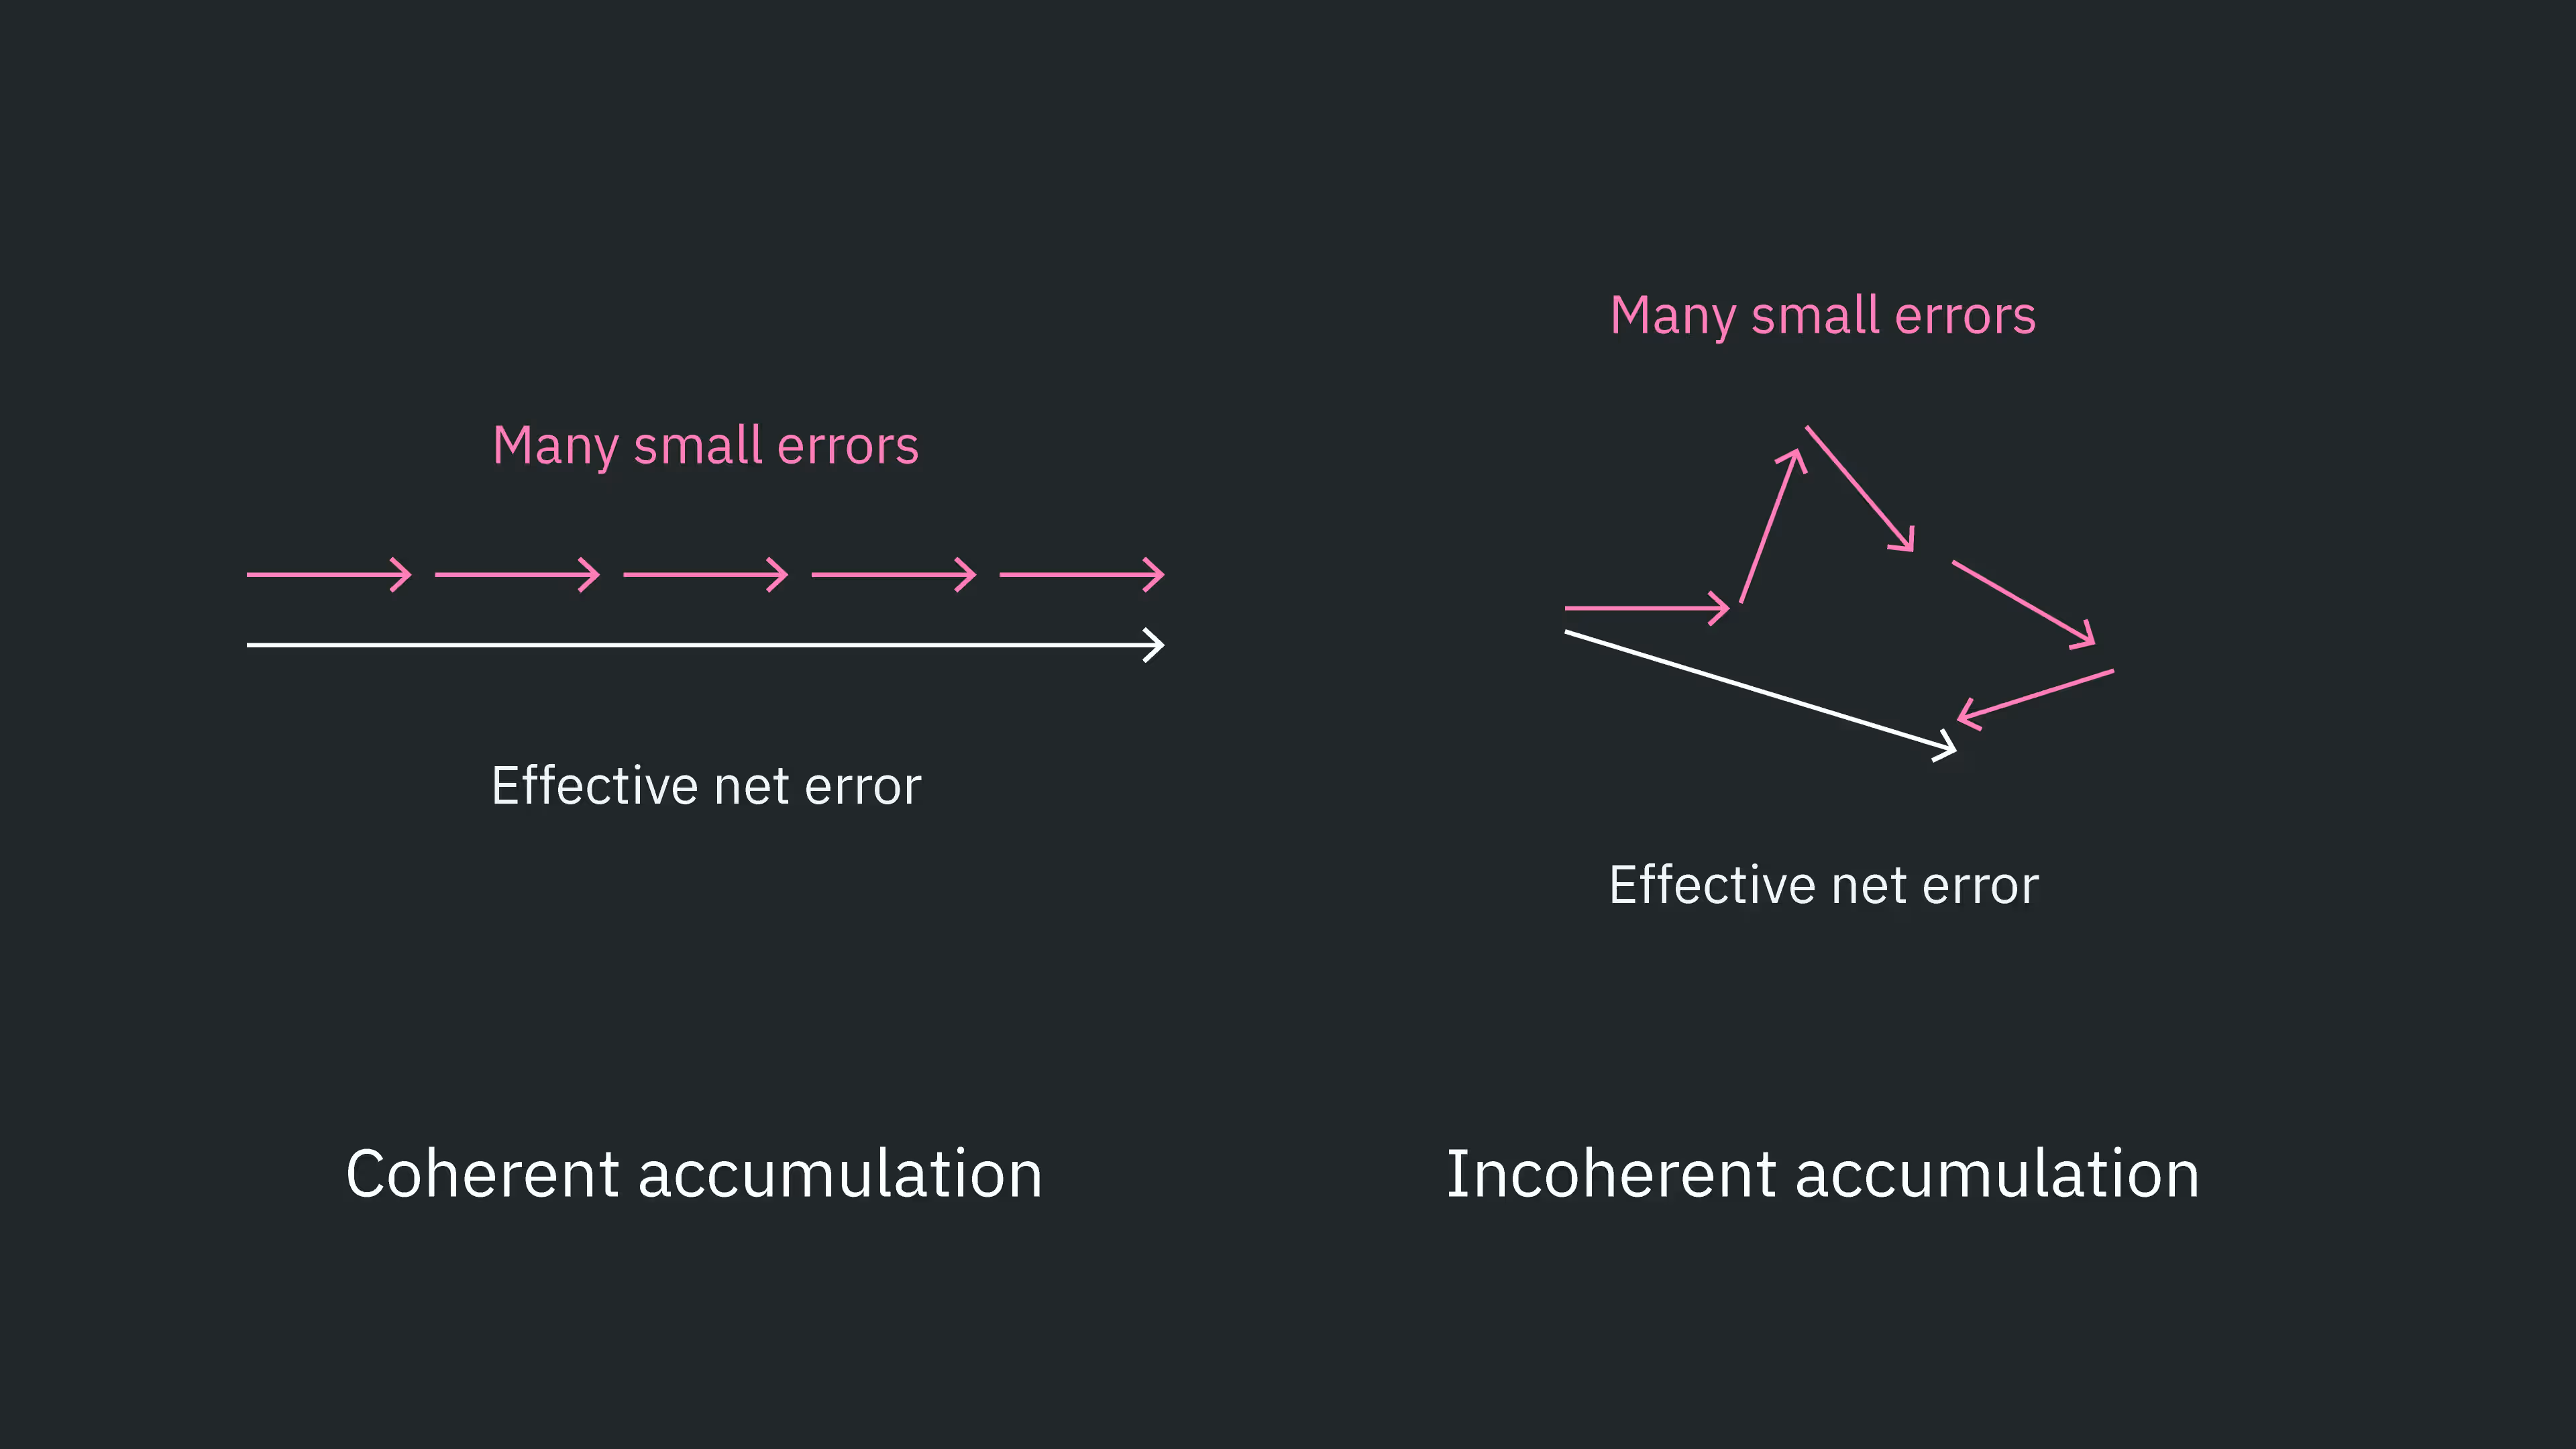
Często można uzyskać wyniki o wyższej wierności (fidelity), przekształcając koherentną akumulację błędów w akumulację niekoherentną. Głównym sposobem osiągnięcia tego jest technika zwana Pauli twirling.
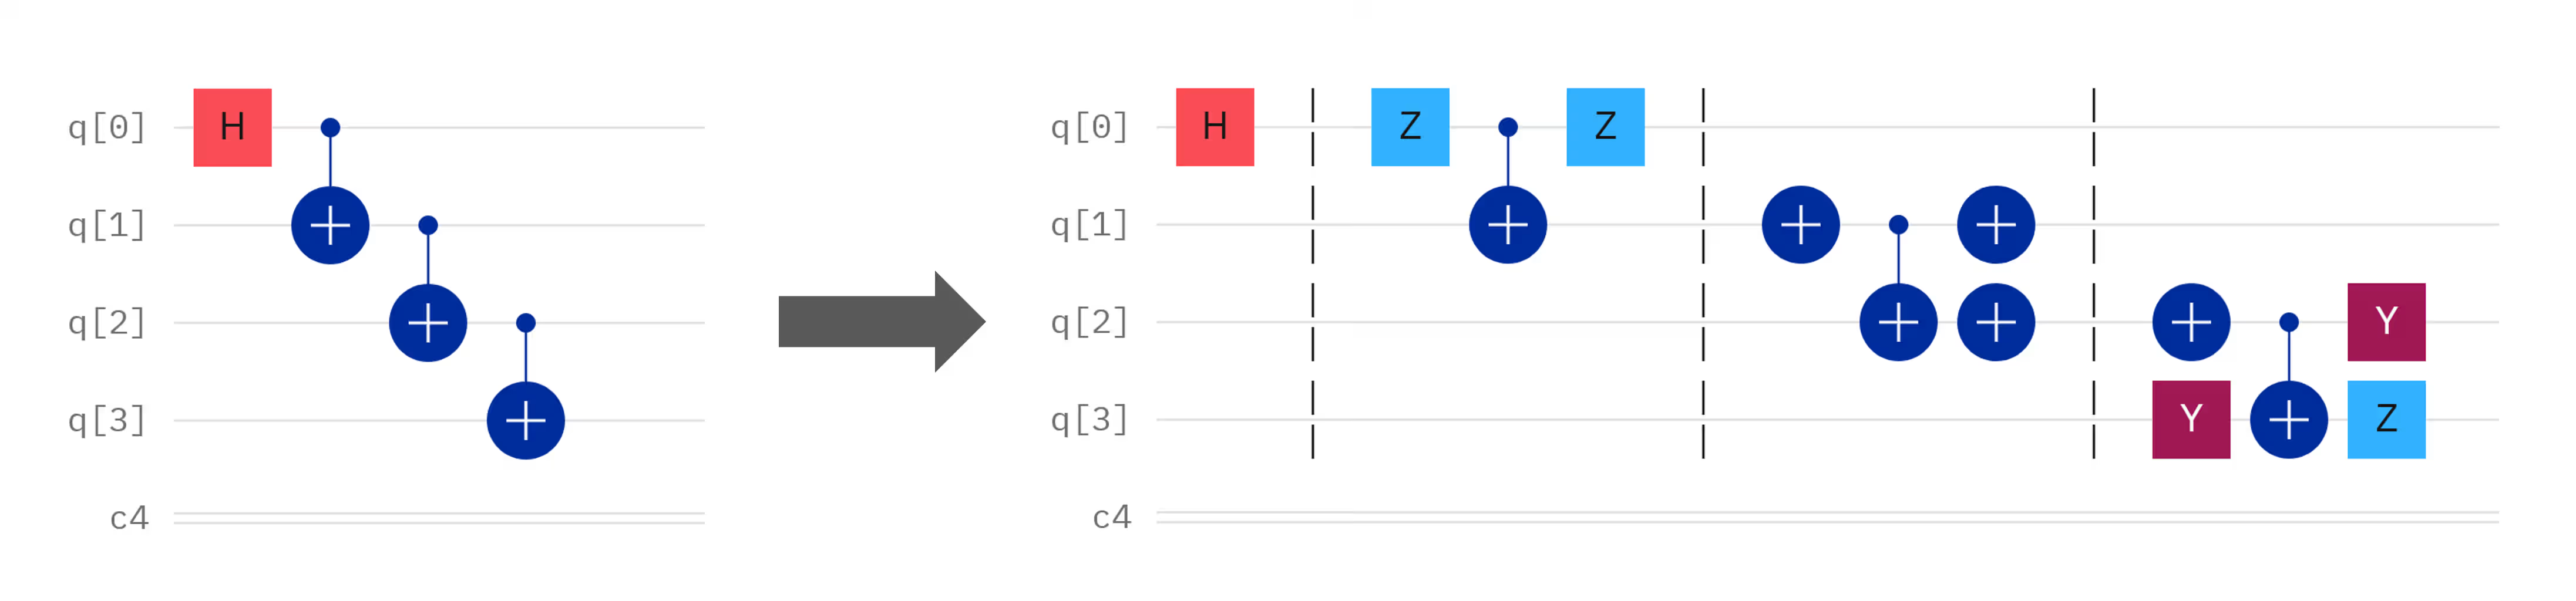
Pauli twirling odnosi się do dodawania kombinacji bramek Pauliego przed i po pożądanej operacji bramki w taki sposób, że . Tutaj i nie są pojedynczymi bramkami Pauliego, lecz zbiorami operatorów Pauliego, często działającymi na wielu kubitach. Czasami można spotkać stwierdzenie, że działanie dodatkowych bramek Pauliego jest „równoważne tożsamości”. Jest to jednak nieprecyzyjne i potencjalnie mylące. Bramki Pauliego są rozdzielone przez , a celem jest, aby logiczne działanie wszystkich bramek pozostało równe . Czasami nazywa się „ładunkiem” (payload), aby odróżnić tę zamierzoną operację od bramek dodanych w celu tłumienia. Poniżej pokazano kilka przykładów Pauli twirling wokół bramki CNOT.

Przeanalizujmy tylko jeden przykład, aby zweryfikować, że twirling pozostawia logiczny efekt ładunku niezmienionym. Bez utraty ogólności, niech dwukubitowe stany obejmujące i będą:
Jak zawsze używamy konwencji porządkowania kubitów . Zastosowanie bramki CX z jako celem daje
Rozważmy teraz trzeci pokazany obwód, wykorzystujący bramki X do Pauli twirling. Moglibyśmy po prostu przemnożyć macierze i zweryfikować, że dają one macierz CNOT. Alternatywnie możemy śledzić działanie na dowolnym stanie kwantowym przechodzącym przez obwód, jak robimy to poniżej. Stany w różnych punktach obwodu zostały oznaczone od a do d.

Jest to dokładnie , który otrzymaliśmy wcześniej bez twirlingu. Rzeczywiście, ta stwirlowana sekwencja bramek pozostawia logiczne działanie ładunku niezmienionym. Jeśli jednak różne prawidłowe sekwencje twirlingu są wybierane losowo dla poszczególnych warstw, koherentna akumulacja błędów może zostać przekształcona w efektywnie stochastyczną (niekoherentną) akumulację błędów. Dla jasności, nie wybiera się jednego wzorca twirlingu i nie stosuje się go w całym obwodzie. Zamiast tego dla różnych warstw wybierane są różne prawidłowe sekwencje twirlingu. Przykład z wieloma warstwami splątującymi mógłby wyglądać następująco.
Sprawdź swoje zrozumienie
Zweryfikuj, że Pauli twirling na czwartym panelu powyższego rysunku również pozostawia logiczny efekt CNOT niezmienionym.
Odpowiedź
Podążamy za powyższym przykładem i pokazujemy, że działanie na dowolnym dwukubitowym stanie jest równoważne operacji CNOT. Będziemy odnosić się do oznaczonych punktów na tym diagramie.

Jest to równoważne działaniu CNOT z kubitem 0 jako kubitem kontrolnym i kubitem 1 jako celem.
Czy potrafisz wymyślić sekwencję Pauli twirling dla bramki CNOT, która nie została pokazana powyżej?
Odpowiedź
Tak, istnieje wiele innych. Jednym z przykładów jest przed CNOT oraz i po CNOT.
Kiedy stosować Pauli twirling
Jak przedstawiono tutaj, Pauli twirling jest stosowany wyłącznie do bramek wielokubitowych. Zastosowanie podobnego protokołu do bramek jednokubitowych wymagałoby innej logiki i zazwyczaj nie jest przydatne w praktyce. Sam Pauli twirling wykorzystuje kilka bramek jednokubitowych (bramki Pauliego). Dodatkowe bramki Pauliego prawdopodobnie wprowadziłyby więcej błędów niż zyskano by dzięki randomizacji jakiejkolwiek koherentnej akumulacji błędów. Współczynniki błędów związane z bramkami dwukubitowymi są znacznie większe niż te związane z bramkami jednokubitowymi. Ponadto niektóre bramki jednokubitowe są nie-Cliffordowskie, których nie można w pełni poddać twirlingowi. Dlatego Qiskit zawiera opcje Pauli twirling, które automatycznie stosują twirling wokół bramek dwukubitowych, a nie wokół bramek jednokubitowych.
Było to zawarte w sposób dorozumiany na powyższym rysunku: Pauli twirling zaimplementowano wokół bramek CX, ale nie wokół bramki Hadamarda.
Zobaczmy dwa przykłady Pauli twirling w działaniu.
Pauli twirling w celu tłumienia koherentnej akumulacji
Aby zaobserwować, jak Pauli twirling może przekształcić koherentną akumulację błędów w wolniejszą akumulację niekoherentną, potrzebujemy obwodu i obserwabli, które działają jako test obciążeniowy błędów koherentnych. Jedynym celem jest uwidocznienie koherentnie kumulujących się błędów dwukubitowych, a następnie pokazanie, jak Pauli twirling przekształca tę koherentną kumulację w stochastyczny zanik.
Bramki CNOT (lub CZ) są częstym źródłem błędów koherentnych. Najprostszym eksperymentem, jaki możemy w tym przypadku przeprowadzić, jest zainicjowanie stanu (powiedzmy ), zastosowanie warstw sparowanych bramek CNOT (wykorzystując fakt, że dwie bramki CNOT dają tożsamość) i sprawdzenie, jak błędy kumulują się wraz ze wzrostem liczby warstw, zarówno z Pauli twirling, jak i bez niego.
Interesująca nas obserwabla to na pojedynczym kubicie, którą przedstawiamy na wykresie jako funkcję liczby powtórzeń par CNOT.
# --- Imports ---

import numpy as np
from qiskit import QuantumCircuit
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
# Build the circuit with CX/CX identity per layer

def identity_cx_pairs(layers: int) -> QuantumCircuit:
    q = QuantumRegister(2, "q")
    c = ClassicalRegister(1, "c")  # we only measure q0
    qc = QuantumCircuit(q, c, name=f"N={layers}")

    # |+> on q0
    qc.h(q[0])

    for _ in range(layers):
        qc.barrier()
        qc.cx(q[0], q[1])
        qc.cx(q[0], q[1])

    # Measure in X basis: H then measure q0

    qc.h(q[0])
    qc.measure(q[0], c[0])

    return qc
Ponieważ przed pomiarami obróciliśmy naszą bazę, pomiar odpowiada temu, że stan znajdował się w tuż przed ostatnią bramką Hadamarda, i podobnie dla i . Dlatego naszą wartość oczekiwaną można po prostu obliczyć jako liczbę zliczeń minus liczbę zliczeń .
# Compute <X> from SamplerV2 counts

def x_expect_from_counts(counts: dict[str, int]) -> float:
    shots = sum(counts.values())
    p0 = counts.get("0", 0) / shots
    p1 = counts.get("1", 0) / shots
    return p0 - p1  # <X> = P(0) - P(1) after H,measure
Wybieramy rozsądną liczbę warstw CNOT, w których pozwalamy błędom się kumulować, budujemy nasze obwody, a następnie je transpilujemy.
# Choose the number of layers for the experiment
N_layers_list = [0, 1, 2, 3, 4, 5]

circuits = [identity_cx_pairs(n) for n in N_layers_list]

# Transpile to backend ISA so that primitives run native instructions
pm = generate_preset_pass_manager(backend=backend, optimization_level=0)
isa_circuits = [pm.run(c) for c in circuits]
Pamiętaj, że każda warstwa składa się z więcej niż jednej bramki dwukubitowej. Monitoruj przetranspilowaną głębokość dwukubitową za pomocą poniższej funkcji.
# We can check the 2-qubit depths of any of our circuits like this:
print(
    "two-qubit depth",
    isa_circuits[5].decompose().depth(lambda instr: len(instr.qubits) > 1),
)
two-qubit depth 15
# Configure two Samplers: (A) no twirling, (B) gate twirling
#    - No DD, no measurement twirling in both (to isolate gate twirling)
# ------------------------------
shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
Teraz uruchamiamy zadania.
# Run both jobs; extract counts; compute <X>

# Helper to run a sampler and compute <X> per circuit
def run_and_x_expect(sampler: Sampler, circ_list: list[QuantumCircuit]) -> list[float]:
    job = sampler.run(
        circ_list
    )  # shots taken from options.default_shots unless overridden
    result = job.result()
    # For SamplerV2, use join_data().get_counts() to combine registers if needed
    exp_vals = []
    for pub in result:
        counts = pub.join_data().get_counts()
        exp_vals.append(x_expect_from_counts(counts))
    return exp_vals

x_no_twirl = run_and_x_expect(sampler_no_twirl, isa_circuits)
x_twirl = run_and_x_expect(sampler_twirl, isa_circuits)

# ------------------------------
# 6) Print a small table
# ------------------------------
print("\nN_layers   <X> (no twirl)   <X> (gate twirl)")
for n, a, b in zip(N_layers_list, x_no_twirl, x_twirl):
    print(f"{n:7d}   {a:14.6f}   {b:14.6f}")
N_layers   <X> (no twirl)   <X> (gate twirl)
      0         0.984375         0.987549
      1         0.934326         0.936523
      2         0.844238         0.892822
      3         0.712158         0.879395
      4         0.592529         0.844971
      5         0.449463         0.785156
Na koniec wizualizujemy te wyniki.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using XX
ax.scatter(
    N_layers_list, x_no_twirl, c="blue", linestyle="-", label="No twirl", alpha=0.7
)

## Add values with XY4
ax.scatter(N_layers_list, x_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7)

# Add labels and plot
ax.set_xlabel("CX layers")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Pauli twirling")
ax.grid(True)

plt.show()
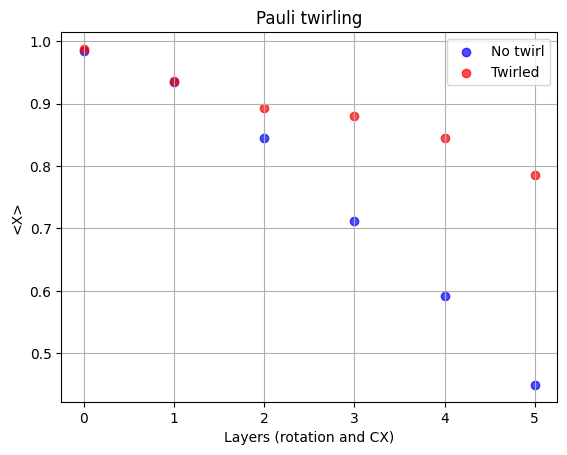
Wyraźnie widzimy, że obwód poddany twirlingowi daje wartość oczekiwaną bliższą idealnej . Ten przykład spełnił swoje zadanie, ale przejdźmy do czegoś bardziej użytecznego: twirlingu w wytwarzaniu silnie splątanych stanów.
Pauli twirling w przygotowaniu stanu GHZ
Poprzedni przykład pokazał przekonujący argument za stosowaniem Pauli twirling w niszczeniu koherentnej akumulacji błędów związanych z bramkami CNOT. Wytwarzanie stanu GHZ wykorzystuje wiele bramek CNOT do produkcji silnie splątanych stanów przydatnych w wielu zastosowaniach obliczeń kwantowych. Zbadajmy, jak Pauli twirling pomaga w tym kontekście, wykorzystując stany GHZ o rosnącym rozmiarze.
# Imports if not already loaded in previous cells
# from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
# from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit

# Define a GHZ circuit building function, so that we can build GHZ states of increasing size.

def ghz_circuit(n: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q[0])
    for i in range(n - 1):
        qc.cx(q[i], q[i + 1])

    qc.barrier()

    qc.measure(q, c)
    return qc

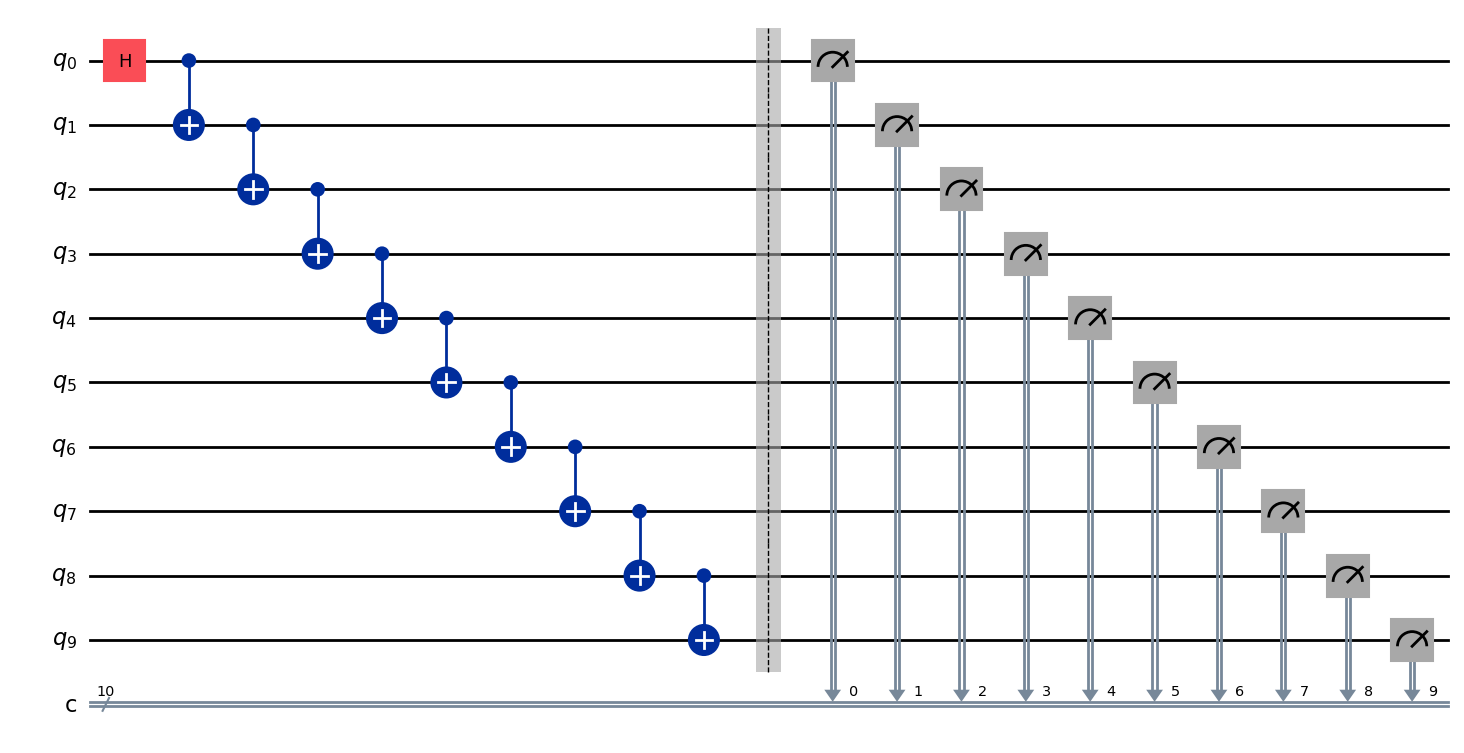
# Build a test state with 10 qubits to remind ourselves of GHZ structure.

num_qubits = 10

qc_ghz = ghz_circuit(num_qubits)
qc_isa = pm.run(qc_ghz)
qc_ghz.draw("mpl")
Teraz budujemy nasze obwody i je transpilujemy. W tym przypadku nie mamy żadnych sztucznie powtórzonych bramek, które redukują się do tożsamości. Możemy więc pozwolić menedżerowi przebiegów (pass manager) na wykonanie dla nas nieco większej optymalizacji. Ustawimy go na poziom trzeci.
# Set up a pass manager

opt_level = 3
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

# Build GHZ circuits of increasing size.

nmin = 5
nmax = 15
circuits = []
for n in range(nmin, nmax):
    qc = ghz_circuit(n)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
Widzimy, że optymalizator przypisał nasz abstrakcyjny obwód do kubitów 123, 124, 136, 142 i 143.
circuits[0].draw("mpl")
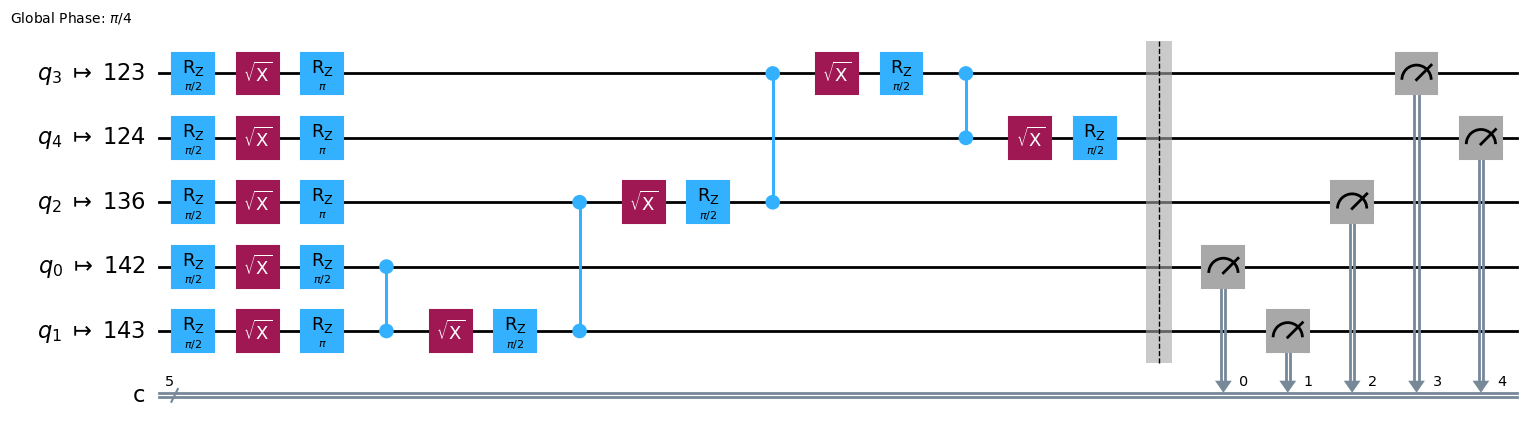
Aby zrozumieć dlaczego, spójrzmy na mapę układu naszego backendu (na tym obrazie ibm_fez, ale podobne analizy można wykonać na dowolnym backendzie).
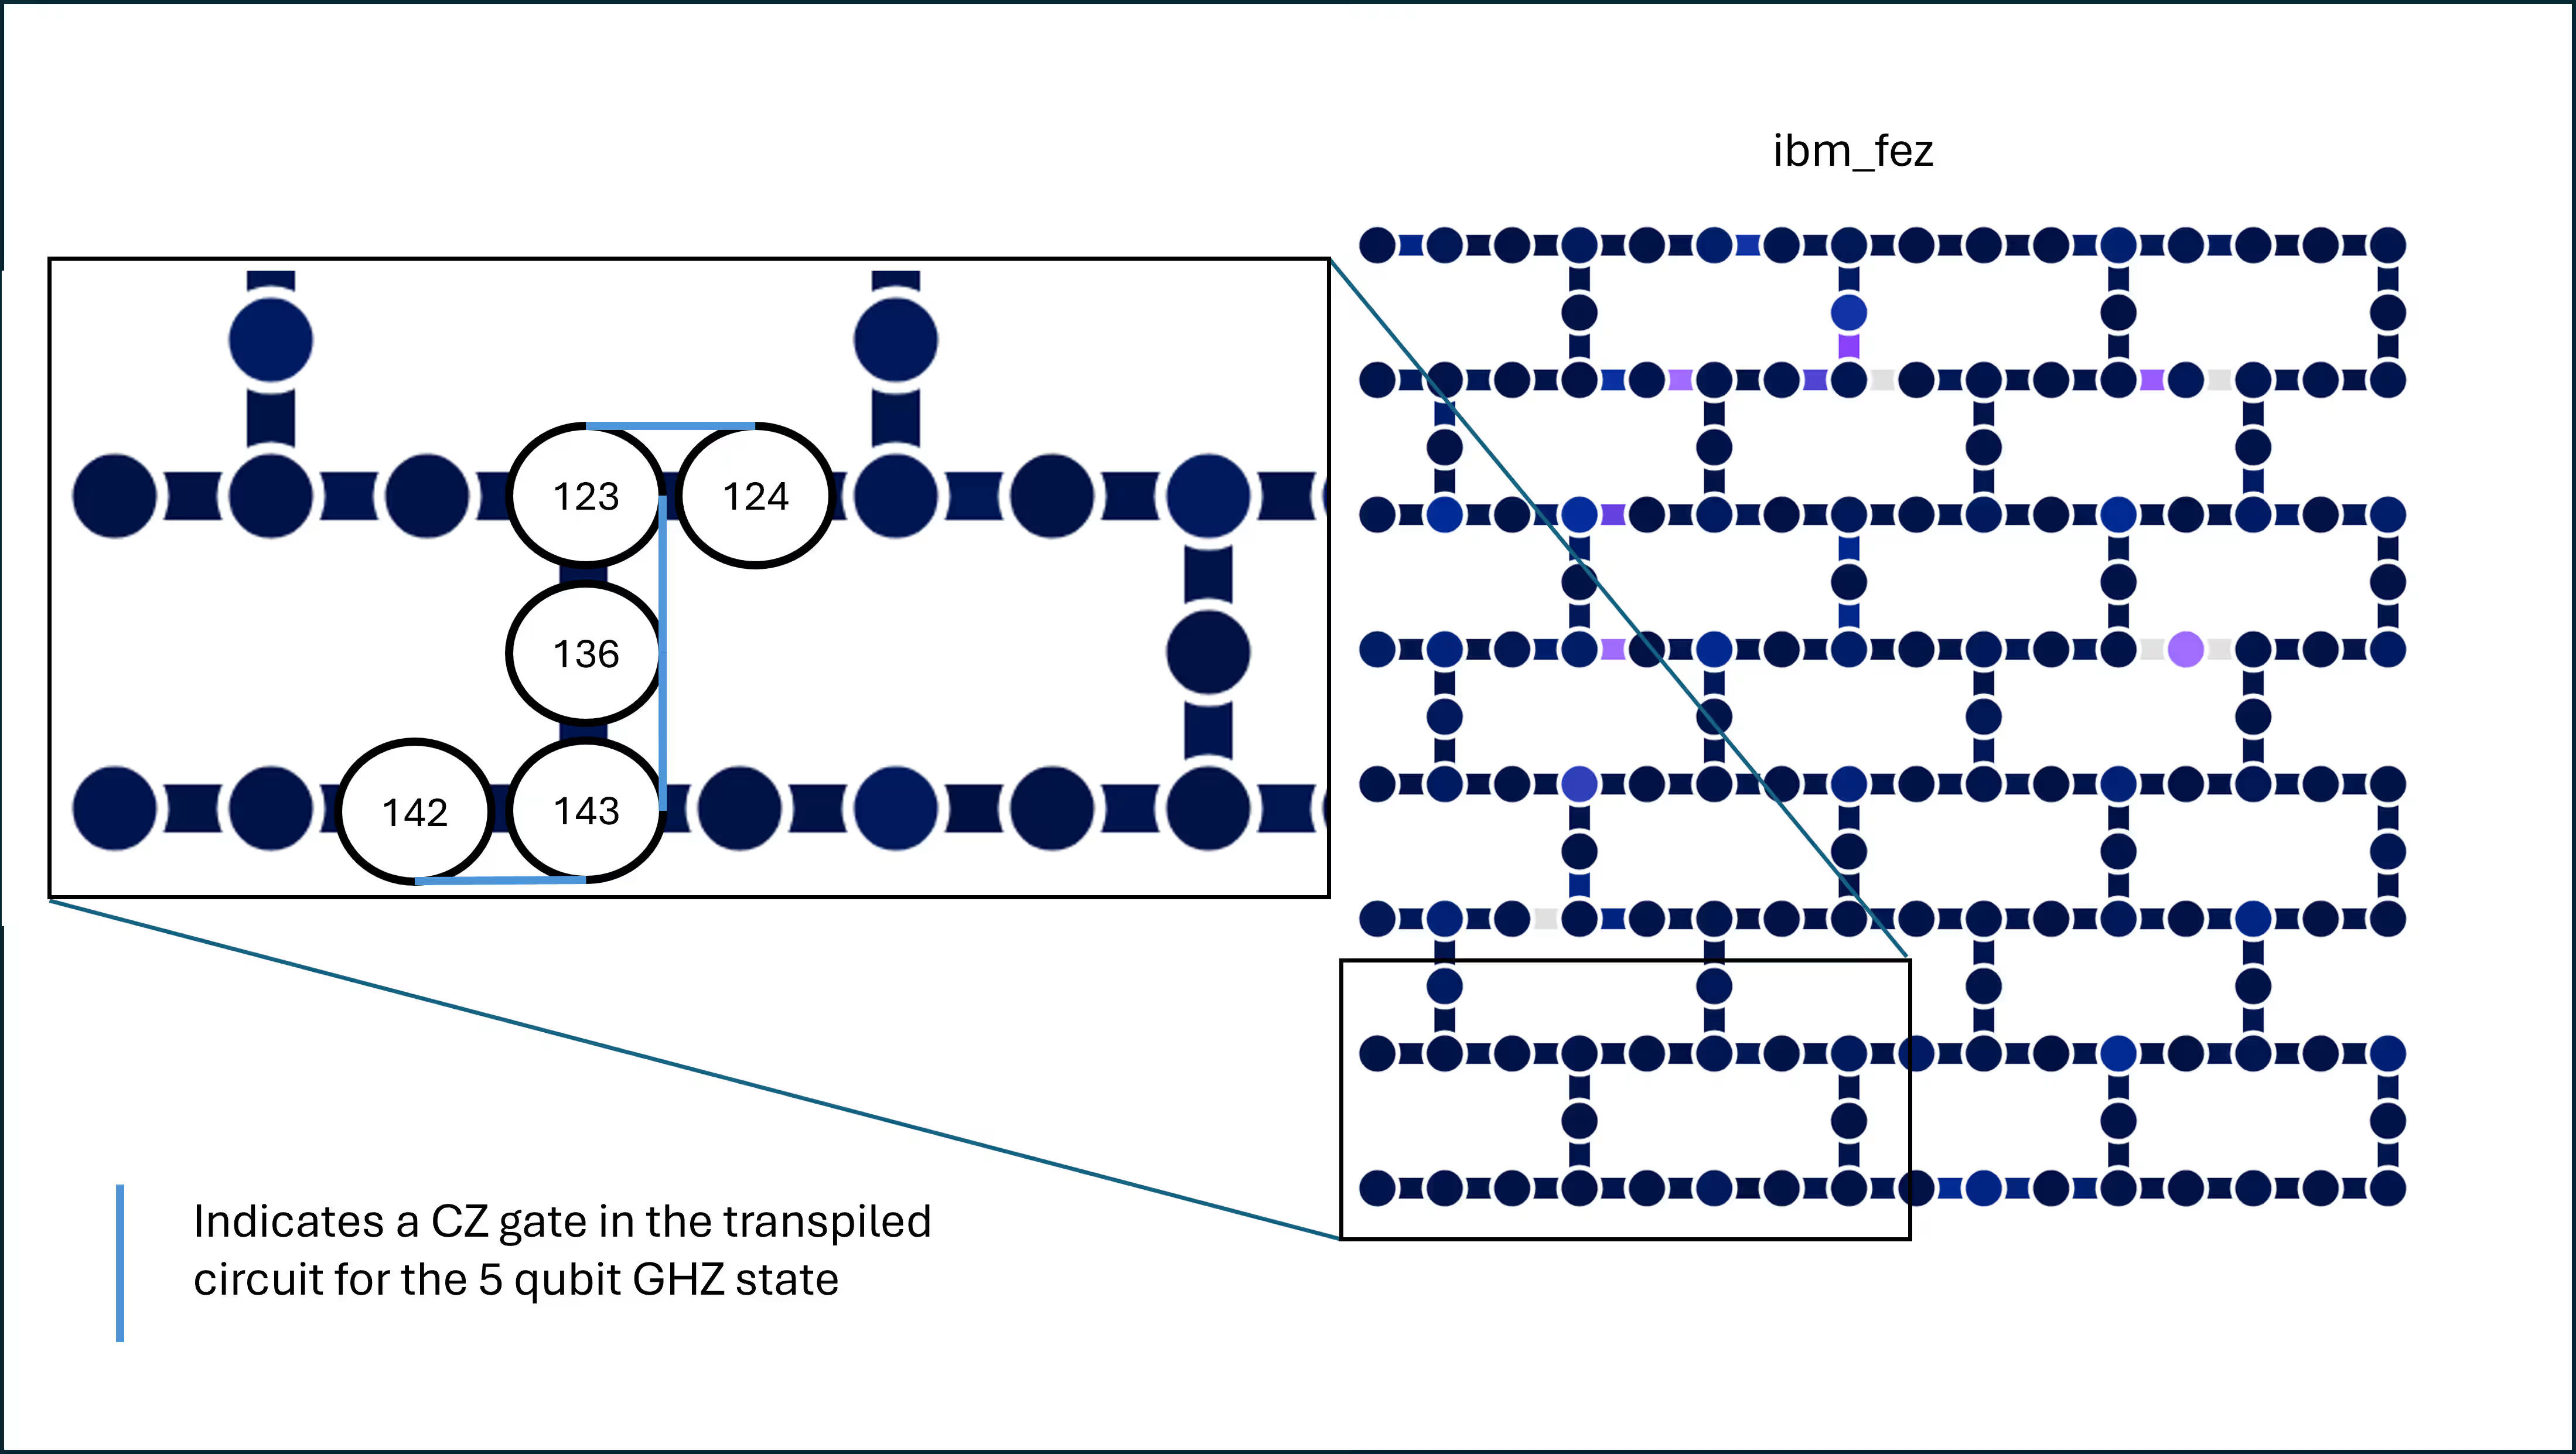
Widzimy, że kubity zostały wybrane w łańcuch, aby zminimalizować bramki swap, a tym samym głębokość obwodu. Ponadto każda bramka CZ zaimplementowana w obwodzie łączy sąsiadujące kubity. Wreszcie wszystkie pięć kubitów ma stosunkowo niskie współczynniki błędów, w tym współczynniki błędów przypisania odczytu. Te współczynniki błędów można sprawdzić dla dowolnego backendu na stronie Zasoby obliczeniowe. Znalezienie takiego układu nie jest trudne dla prostego łańcucha liniowego, ale w miarę jak problemy stają się bardziej złożone, optymalizacja układu obwodu staje się trudniejsza i bardziej wartościowa.
Teraz konfigurujemy naszą prymitywę Sampler. Wyłączamy inne narzędzia tłumienia/mitygacji, aby skupić się na Pauli twirling.
# Configure two Samplers: (A) no twirling, (B) gate twirling
# No DD, no measurement twirling in both (to isolate gate twirling)

shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
Na koniec uruchamiamy nasze zadania. Opcjonalnie możesz wypisać numery identyfikatorów zadań do późniejszego pobrania.
job = sampler_twirl.run(circuits)
res_ghz_twirl = job.result()
job_id = job.job_id()  # job id for twirling on/true
print("job number for twirling the ghz prep is ", job_id)

job = sampler_no_twirl.run(circuits)
res_ghz_no_twirl = job.result()
job_id = job.job_id()  # job id for twirling off/false
print("job number for NO twirling the ghz prep is ", job_id)
job number for twirling the ghz prep is  d7h967bjne2c7393s0b0
job number for NO twirling the ghz prep is  d7h96f7b91ec73aufing
Wyodrębniamy liczby zliczeń dla każdego zmierzonego bazowego stanu obliczeniowego dla wszystkich obwodów, zarówno z twirlingiem, jak i bez niego.
# --------- Extract counts per circuit ----------
def extract_counts_list(res):
    counts_list = []
    for r in res:  # each r corresponds to one circuit
        # r.data.<classical_register_name>.get_counts()
        counts = r.data.c.get_counts()
        counts_list.append(counts)
    return counts_list

counts_list_ghz_twirl = extract_counts_list(res_ghz_twirl)
counts_list_ghz_no_twirl = extract_counts_list(res_ghz_no_twirl)
print(counts_list_ghz_twirl[0])
print(counts_list_ghz_twirl[4])
{'11111': 3440, '11101': 87, '00000': 3434, '10111': 87, '00001': 168, '10011': 4, '11000': 102, '00011': 39, '01111': 93, '00111': 111, '01000': 90, '11110': 235, '00110': 6, '00010': 75, '11011': 30, '11100': 42, '10000': 82, '00101': 7, '10001': 2, '11001': 6, '11010': 5, '01010': 3, '01110': 7, '00100': 14, '10101': 1, '10110': 8, '01001': 6, '10100': 1, '01101': 4, '01011': 1, '10010': 2}
{'111111111': 2683, '000000000': 2976, '111000000': 53, '110000000': 74, '111111100': 47, '111011111': 76, '111111110': 195, '111111000': 67, '000000010': 66, '011111110': 10, '011110001': 1, '101110111': 7, '101011111': 9, '111110111': 87, '111100000': 96, '111011000': 2, '010000000': 60, '111111010': 3, '100000000': 110, '111111011': 32, '000000111': 51, '000100000': 84, '000011111': 82, '000000001': 176, '100000010': 6, '111100001': 3, '000000011': 36, '101111111': 98, '100000011': 2, '001111111': 75, '000001000': 60, '000011101': 4, '110111111': 38, '111111101': 72, '111100100': 3, '000100010': 1, '001011101': 1, '000000110': 8, '110000011': 1, '000111111': 48, '000000100': 23, '000001111': 65, '010000101': 2, '000100001': 8, '111110000': 51, '010001111': 1, '111000111': 2, '111000001': 2, '000111100': 1, '011111111': 116, '111110001': 1, '000011110': 10, '000010000': 23, '000101111': 3, '000101110': 1, '011110111': 4, '010000111': 7, '111101111': 36, '001000000': 40, '010100000': 3, '101111110': 8, '110111000': 5, '000000101': 8, '010000010': 4, '000110001': 2, '110111110': 4, '111100010': 2, '111010111': 2, '000001110': 5, '111110101': 3, '001110000': 4, '101100000': 5, '001111110': 8, '100000001': 5, '111011110': 3, '111110100': 5, '110001011': 1, '001110111': 4, '000010110': 2, '111001111': 2, '000011000': 5, '010111110': 1, '000101000': 4, '101000000': 4, '100111111': 4, '111110011': 2, '000101100': 1, '101111100': 2, '111011100': 1, '001111011': 3, '011111011': 3, '110100000': 5, '000001011': 3, '111110110': 5, '111111001': 5, '000001001': 8, '010000001': 5, '011111101': 2, '001010111': 1, '011101110': 1, '110110110': 1, '001111100': 3, '100001000': 3, '001000011': 1, '001011111': 6, '110000010': 2, '110010000': 1, '010011111': 2, '111101101': 3, '101110000': 1, '111100111': 6, '010111111': 5, '110110000': 2, '011011111': 2, '110011111': 1, '110000111': 6, '001000001': 2, '001100000': 3, '101101111': 1, '000111110': 5, '111011101': 2, '100100000': 2, '101111101': 3, '001001111': 1, '001010000': 2, '111001000': 1, '011110000': 2, '011101111': 3, '000001100': 1, '110101000': 1, '011000000': 4, '111101000': 3, '110000001': 4, '000010111': 4, '011111100': 1, '111000010': 1, '101011000': 1, '101111000': 2, '001101111': 1, '010001100': 1, '000100011': 1, '111110010': 1, '111101110': 1, '100001111': 1, '100011011': 1, '010110111': 1, '001110110': 2, '100000100': 1, '001000110': 1, '100011111': 2, '010010001': 1, '111010110': 1, '011110110': 1, '000111000': 2, '000100111': 1, '011010000': 1, '001111000': 2, '100010000': 1, '011111000': 2, '110111100': 2, '110110111': 1, '110001000': 1, '000110111': 1, '000101011': 1, '000110000': 1, '011100000': 3, '001000010': 1, '001001000': 1, '001000111': 1, '001111101': 3, '111101011': 1, '111010000': 1, '100000101': 1, '000010010': 1, '001011110': 1, '000011011': 1, '111101100': 1}
Wiemy, że idealny rozkład stanu GHZ to taki, w którym połowa strzałów zwraca , a druga połowa zwraca . Zbuduj to do porównania.
ideal_dist = []
for n in range(nmin, nmax):
    ideal_dist.append({"0" * n: int(shots / 2), "1" * n: int(shots / 2)})
Teraz używamy wierności Hellingera (Hellinger fidelity) jako miary jakości naszego stanu końcowego.
from qiskit.quantum_info import hellinger_fidelity

num_qubits = []
fidelities_twirl = []
fidelities_no_twirl = []
for n in range(len(ideal_dist)):
    num_qubits.append(nmin + n)
    fidelities_twirl.append(hellinger_fidelity(counts_list_ghz_twirl[n], ideal_dist[n]))
    fidelities_no_twirl.append(
        hellinger_fidelity(counts_list_ghz_no_twirl[n], ideal_dist[n])
    )
Na koniec przedstawiamy nasze wyniki na wykresie.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using no twirling
ax.scatter(
    num_qubits,
    fidelities_no_twirl,
    c="blue",
    linestyle="-",
    label="No twirl",
    alpha=0.7,
)

## Add values with twirling
ax.scatter(
    num_qubits, fidelities_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Qubits in GHZ state")
ax.set_ylabel("Hellinger fidelity")
ax.legend()
ax.set_title("Pauli twirling in GHZ states")
ax.grid(True)

plt.show()
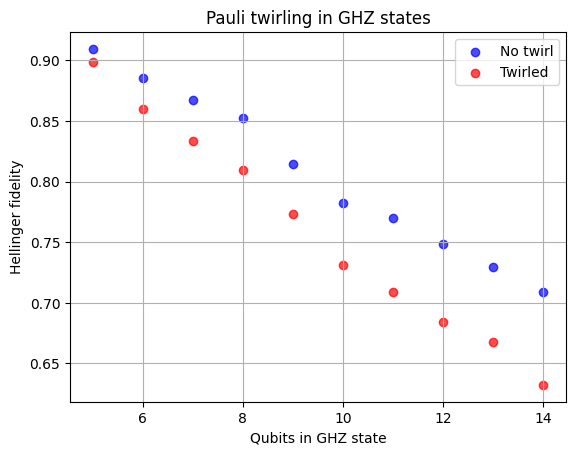
Wyniki z użyciem Pauli twirling nie są lepsze (a nawet nieco gorsze) niż bez twirlingu. Co się stało?
Wydarzyły się dwie rzeczy. Po pierwsze, Pauli twirling nie zmniejsza całkowitej ilości szumu — raczej przekształca koherentne, systematyczne błędy w stochastyczne błędy typu Pauliego, dzięki czemu wzrost błędów staje się przewidywalny i możliwy do zamodelowania. Nigdy nie było obietnicy redukcji błędów, poza szczególnymi przypadkami.
Po drugie, w obwodach GHZ niektóre błędy koherentne mogą częściowo się znosić lub działać jak łagodne przesunięcia fazowe ze względu na symetrię konstrukcji GHZ; twirling usuwa tę przypadkową ochronę i zastępuje ją nieskorelowanym stochastycznym szumem Pauliego, przez co wierność GHZ staje się nieco gorsza pod wpływem twirlingu.
To drugie twierdzenie wymaga pewnego wyjaśnienia. Twierdzenie nie mówi, że obwody GHZ są chronione przed wszystkimi rodzajami koherentnej akumulacji błędów, a jedynie przed niektórymi — i że w tych przypadkach ochrona jest niszczona przez twirling. Konkretnie, rozważmy koherentną nadmierną rotację związaną z bramkami CX. Nazwijmy rzeczywistą bramkę CX z nadmierną rotacją :
gdzie jest dowolnym iloczynem operatorów Pauliego, takich jak , , , itd. Dla stanów ogólnych każda z tych nadmiernych rotacji może wpłynąć na statystyki pomiarowe (a tym samym na miary wierności stanu). Podzbiór z nich pozostawia jednak wiele standardowych obserwabli GHZ niezmienionych, w tym operatory takie jak i . W kontekście przygotowania stanu GHZ, odpowiednie błędy nadmiernej rotacji tego typu byłyby następujące:
Przygotowanie całego -kubitowego stanu GHZ wyglądałoby następująco:
Po przygotowaniu stanu GHZ, stan jest idealnie:
Ten stan jest jednoczesnym stanem własnym dużego zbioru operatorów Pauliego, w tym następujących:
z wartością własną . W rezultacie operator postaci działa na stan GHZ jako mnożenie przez czynnik fazowy , co nie wpływa na standardowe obserwable GHZ, takie jak parzystość, zbiorowe , czy populacje w bazie obliczeniowej. Tak więc, chociaż błędy nadmiernej rotacji są koherentne i systematyczne, są one w praktyce niewidoczne dla pomiarów używanych do oceny wierności GHZ. W tym sensie obwód GHZ korzysta z przypadkowej ochrony koherencji: niektóre koherentne błędy CX komutują ze strukturą przygotowywanego stanu i dlatego nie obniżają mierzonej wydajności.
Pauli twirling zasadniczo zmienia tę sytuację. Twirling nie zachowuje koherentnego błędu nadmiernej rotacji jako deterministycznego procesu . Zamiast tego przekształca koherentny kanał błędu w efektywny stochastyczny kanał Pauliego. W rezultacie kanał błędu zawiera teraz człony takie jak , , i , które nie komutują ze stabilizatorami GHZ.
Gdy wystąpią te stochastyczne błędy Pauliego, tworzą rzeczywiste błędy typu bit-flip i phase-flip na poszczególnych kubitach lub parach kubitów. Błędy te wyprowadzają stan poza podprzestrzeń stabilizatora GHZ, zmniejszają interferencję między a i bezpośrednio obniżają wierność GHZ oraz sygnały parzystości wielu kubitów. Innymi słowy, Pauli twirling usuwa koherentną strukturę błędu, ale usuwa też opartą na symetrii kompensację, która wcześniej sprawiała, że te błędy były nieszkodliwe. Wynikiem jest nieco gorszy stan GHZ — nie dlatego, że twirling dodaje szum, ale dlatego, że przekształca w większości nieszkodliwy koherentny błąd w rzeczywiście szkodliwe błędy stochastyczne.
Ten przykład podkreśla ważną lekcję: Pauli twirling nie jest uniwersalną strategią poprawy. Jest najbardziej korzystny, gdy koherentne błędy kumulują się w obwodzie w sposób niszczący wymaganą wierność. W wysoce symetrycznych obwodach, takich jak przygotowanie stanu GHZ, niektóre koherentne błędy są naturalnie wyrównane ze stabilizatorami stanu, a celowe ich randomizowanie może wyeliminować tę przypadkową ochronę.
Łączenie metod
Co do zasady można łączyć Pauli twirling z dynamicznym odsprzęganiem (dynamical decoupling). Nie użyliśmy DD w tym przypadku z dwóch powodów: po pierwsze, w tym obwodzie nie powinno być żadnych bardzo długich okresów bezczynności. Po drugie, stany GHZ nie przechowują większości swoich informacji w koherencji fazowej pojedynczego kubitu, zwłaszcza jeśli obserwujemy wierność tylko w kategoriach liczby zliczeń ciągów bitów, a nie w kategoriach fazy między pożądanymi ciągami bitów i .
Gdybyśmy mieli rozszerzyć przygotowanie GHZ na 100+ kubitów, opóźnienia w pomiarze pierwszych/wczesnych kubitów mogłyby rzeczywiście być na tyle długie, że DD mogłoby być przydatne. Jest to szczególnie prawdziwe, gdy weźmiemy pod uwagę głębokość obwodu po transpilacji.
Pauli twirling w strukturze echa RTZ
Nasz ostatni przykład Pauli twirlingu w kontekście redukcji kumulacji koherentnych błędów wykorzystuje obwód z warstwami kombinacji X-CZ-X-CZ. Jest to dobrze znana sekwencja bramek, która jest często używana do znoszenia koherentnych członów błędu ZZ w bramkach dwukubitowych, nawet bez twirlingu. Ale dzięki twirlingowi możemy zredukować lub zrandomizować inne formy kumulacji koherentnych błędów.
Zaczniemy od zdefiniowania funkcji do budowania obwodów podobnych do RTZ z różną liczbą warstw.
from qiskit import QuantumCircuit

def rtz_echo_circuit(n_qubits: int, depth: int) -> QuantumCircuit:
    """
    Construct an RTZ echo-style circuit.

    Args:
        n_qubits: Number of qubits in the circuit.
        depth: Number of repeated echo layers.

    Returns:
        A QuantumCircuit implementing the echo sequence with measurements.
    """
    q = QuantumRegister(n_qubits, "q")
    c = ClassicalRegister(n_qubits, "c")
    qc = QuantumCircuit(q, c)

    for _ in range(depth):
        qc.h(q)

        for i in range(0, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.x(q)

        for i in range(1, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.h(q)

    qc.measure(q, c)
    return qc
Teraz zbudujemy obwody o rosnącej liczbie warstw, aż do rozsądnej łącznej głębokości dwukubitowej po transpilacji.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

circuits = []
qcs = []
depths = list(range(3, 27, 4))
n_qubits = 10

opt_level = 0
pm = generate_preset_pass_manager(
    optimization_level=opt_level,
    backend=backend,
    initial_layout=[0, 1, 2, 3, 4, 5, 6, 7, 8, 9],
)

for d in depths:
    qc = rtz_echo_circuit(n_qubits, d)
    qcs.append(qc)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
# We can check the 2-qubit depths of any of our circuits like this:
two_qubit_depths = []
for n in range(len(circuits)):
    two_qubit_depths.append(
        circuits[n].decompose().depth(lambda instr: len(instr.qubits) > 1)
    )
print(two_qubit_depths)
[6, 14, 22, 30, 38, 46]
qcs[0].draw("mpl")
# circuits[0].draw("mpl")
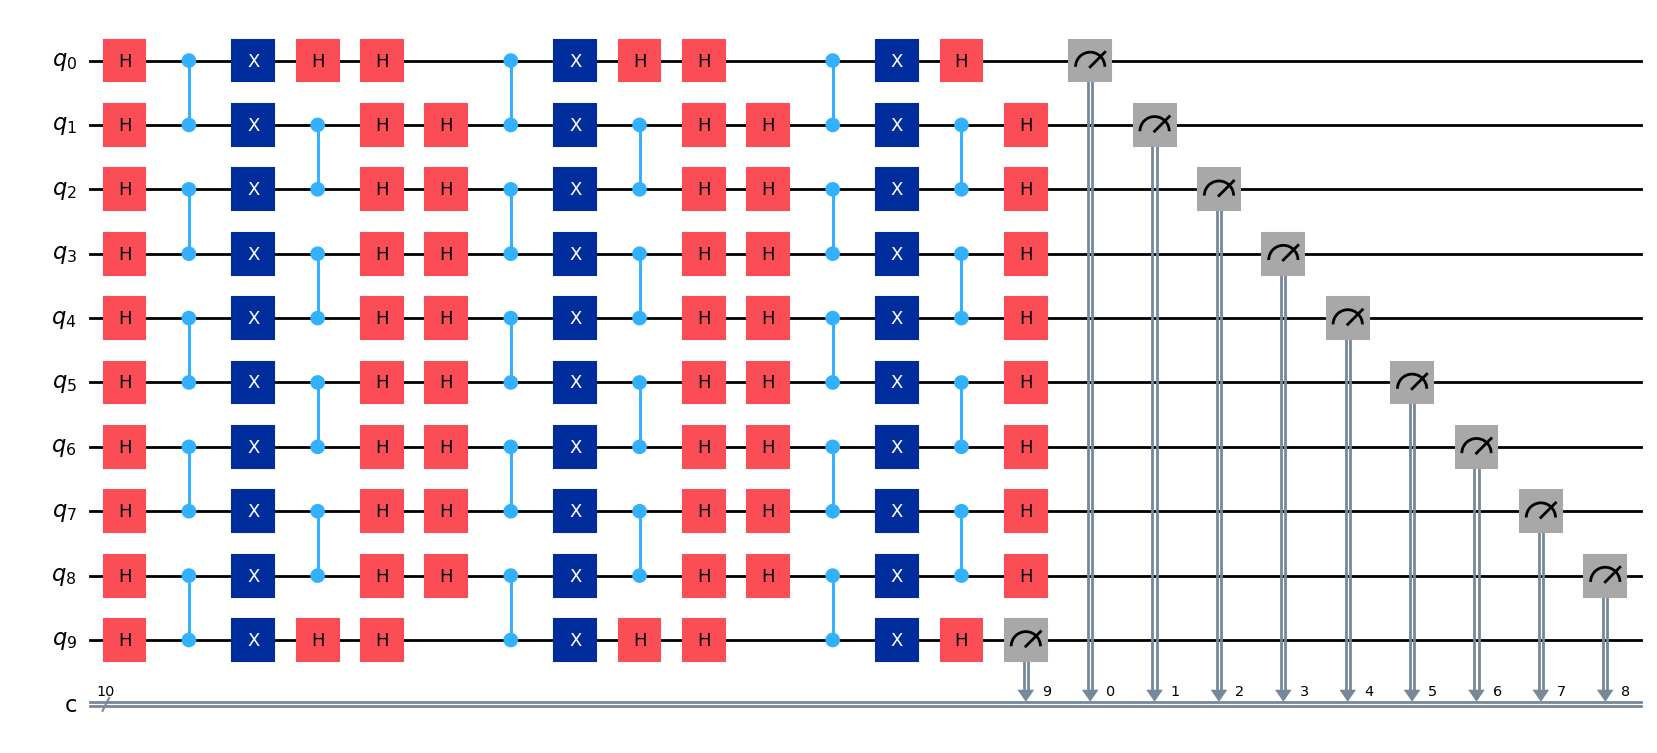
Na górnym końcu niektóre z nich są dość głębokie. Użyjmy AerSimulator bez modelu szumu, aby uzyskać idealne stany na końcu każdego z tych obwodów. Następnie możemy porównać nasze wyniki z rzeczywistych komputerów kwantowych, używając wierności Hellingera.
from qiskit_aer import AerSimulator

sim = AerSimulator()
ideal_results = sim.run(circuits, shots=8192).result()
ideal_counts = ideal_results.get_counts()
Teraz zdefiniujemy SamplerV2 z twirlingiem oraz jeden bez twirlingu.
from qiskit_ibm_runtime import SamplerV2 as Sampler

shots = 8192

# --- No Twirling ---
sampler_no = Sampler(mode=backend)
sampler_no.options.twirling.enable_gates = False
sampler_no.options.twirling.enable_measure = False
sampler_no.options.default_shots = shots

# --- With Twirling ---
sampler_tw = Sampler(mode=backend)
sampler_tw.options.twirling.enable_gates = True
sampler_tw.options.twirling.enable_measure = False
# sampler_tw.options.twirling.num_randomizations = "auto"
sampler_tw.options.twirling.num_randomizations = 32
sampler_tw.options.twirling.strategy = "active-circuit"
sampler_tw.options.default_shots = shots
Teraz uruchamiamy nasze zadania.
# Each job took 17 sec (34 sec total) on ibm_fez. Your times might vary.

job_no = sampler_no.run(circuits)
job_tw = sampler_tw.run(circuits)

res_no = job_no.result()
res_tw = job_tw.result()
Otrzymujemy zliczenia z każdego z uruchomień na rzeczywistym komputerze kwantowym.
counts_no = [r.data.c.get_counts() for r in res_no]
counts_tw = [r.data.c.get_counts() for r in res_tw]
Teraz obliczamy wierność Hellingera, porównując każde z tych uruchomień z wynikami AerSimulator bez szumu.
from qiskit.quantum_info import hellinger_fidelity

f_no = [hellinger_fidelity(counts_no[i], ideal_counts[i]) for i in range(len(circuits))]

f_tw = [hellinger_fidelity(counts_tw[i], ideal_counts[i]) for i in range(len(circuits))]
Teraz wizualizujemy nasze wyniki.
import matplotlib.pyplot as plt

plt.figure(figsize=(8, 5))
plt.plot(two_qubit_depths, f_no, "o-", label="No Twirling")
plt.plot(two_qubit_depths, f_tw, "o-", label="With Twirling")
plt.xlabel("Two-qubit transpiled depth")
plt.ylabel("Hellinger Fidelity")
plt.title("RTZ Echo Circuit: Twirling vs No Twirling")
plt.legend()
plt.grid(True)
plt.show()
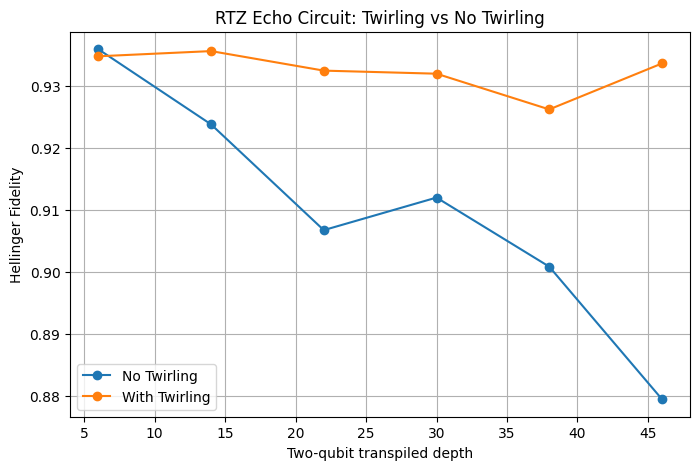
W trakcie tej lekcji przeanalizowaliśmy przypadki, w których Pauli twirling jest wykorzystywany do ograniczenia kumulacji koherentnych błędów - kontekst, w którym można by go opisać jako tłumienie błędów. Jednak Pauli twirling jest często bardziej przydatny jako narzędzie do przekształcania zachowania błędów, przekształcając koherentne błędy w formę, która jest bardziej przewidywalna i łatwiejsza do modelowania. Użyteczność tego stanie się bardziej widoczna w kontekście technik mitygacji błędów, takich jak ekstrapolacja do zerowego szumu (ZNE), które opierają się na w miarę przewidywalnym skalowaniu szumu. Zostanie to omówione w następnej lekcji.