Mitygacja błędów
Ta lekcja przedstawia podstawy różnych technik mitygacji błędów, aby pomóc ci wyrobić intuicję, jak i kiedy najlepiej z nich korzystać. Co ważne, nowoczesne zastosowania tych technik wykorzystują bardziej zaawansowane narzędzia, takie jak Samplomatic, Shaded Lightcones i Executor. Te przepływy pracy zostaną omówione w kolejnych lekcjach.
Ten film przedstawia przegląd technik mitygacji błędów. Poniższy tekst dodaje szczegółów i bada te metody z użyciem Qiskit.
Przegląd technik mitygacji błędów
Mitygacja błędów oznacza każdy proces, który próbuje zmniejszyć skutki błędów w obliczeniach kwantowych już po ich wystąpieniu. Różni się od supresji, która próbuje zapobiegać błędom, oraz od korekcji błędów, która koduje informację w wielu fizycznych kubitach i sprawdza spójność tej informacji, aby zachować informację w pojedynczym kubicie logicznym. W całej tej lekcji techniki mitygacji błędów najlepiej rozumieć jako metody konstruowania lepszych estymatorów idealnych wartości oczekiwanych lub lepszych próbkowników rozkładów prawdopodobieństwa, a nie jako metody korygowania stanów kwantowych podczas wykonania. Przyjrzymy się poniższym metodom mitygacji błędów, które są dostępne w Qiskit i jego dodatkach i które są obiecującymi narzędziami w dążeniu do przewagi kwantowej.
Wygaszanie błędów odczytu z twirlingiem (TREX) losowo zmienia proces pomiaru, stosując losowo wybrane operacje Pauliego przed pomiarem, a następnie klasycznie cofając ich znane skutki na zaobserwowanych ciągach bitów. Przy odpowiednich założeniach dotyczących szumu pomiaru przekształca to kanał błędu odczytu w prostszą i bardziej symetryczną postać, którą łatwiej skalibrować i poddać mitygacji.
Mitygacja pomiaru bez macierzy (M3) to skalowalna technika mitygacji błędów pomiaru, która unika jawnego konstruowania macierzy przypisań lub jej odwrotności.
Ekstrapolacja do zerowego szumu (ZNE) przybliża wartość, jaką miałaby obserwabla przy braku szumu, sztucznie skalując szum o znany czynnik i ekstrapolując z powrotem do przypadku zerowego szumu. Wymaga to, aby szum skalował się w przewidywalny sposób. Ta przewidywalność może wymagać innych metod omawianych w tej lekcji (rozciąganie impulsów, składanie bramek i probabilistyczne wzmacnianie błędów (PEA)).
Probabilistyczne usuwanie błędów (PEC) należy do najpotężniejszych, ale też najbardziej kosztownych obliczeniowo technik mitygacji błędów. Działa przez poznanie zachowania szumu w systemie i próbę jego cofnięcia poprzez statystyczne skonstruowanie nieobciążonego oszacowania idealnych obliczeń. PEC zwraca statystycznie skorygowane obserwable, a nie wyniki skorygowane pod kątem błędów.
Zajmiemy się teraz szczegółowo każdą z tych metod.
M3
Błędy pomiaru są jednym z najbardziej uporczywych i specyficznych dla sprzętu źródeł szumu w urządzeniach kwantowych bliskiej przyszłości. Nawet gdy stan kwantowy zostanie przygotowany i poprawnie ewoluuje, końcowy krok odczytu może błędnie zgłosić prawdziwy wynik w bazie obliczeniowej. Błędy te wynikają z niedoskonałego rozróżniania stanów fizycznych odpowiadających i , relaksacji podczas pomiaru oraz niedoskonałości elektroniki pomiarowej. W rezultacie zaobserwowany rozkład ciągów bitów jest często zniekształconą wersją prawdziwego (idealnego) rozkładu, w której prawdopodobieństwo zostało błędnie przeniesione między wyniki.
Mitygacja pomiaru rozwiązuje ten problem, jawnie modelując, jak wyniki pomiaru są błędnie przypisywane. W standardowym ujęciu to zachowanie opisuje macierz przypisań , której elementy przedstawiają prawdopodobieństwo zarejestrowania wyniku , gdy prawdziwym stanem bazowym było . Jeśli szum pomiaru jest klasyczny i stacjonarny, zaobserwowany wektor prawdopodobieństw jest powiązany z idealnym rozkładem prostą zależnością liniową,
Zauważ, że macierz przypisań jest klasycznym odwzorowaniem stochastycznym, a nie kanałem kwantowym. Działa na klasyczne odczyty, a nie na leżące u ich podstaw stany kwantowe, z których próbkowano odczyty.
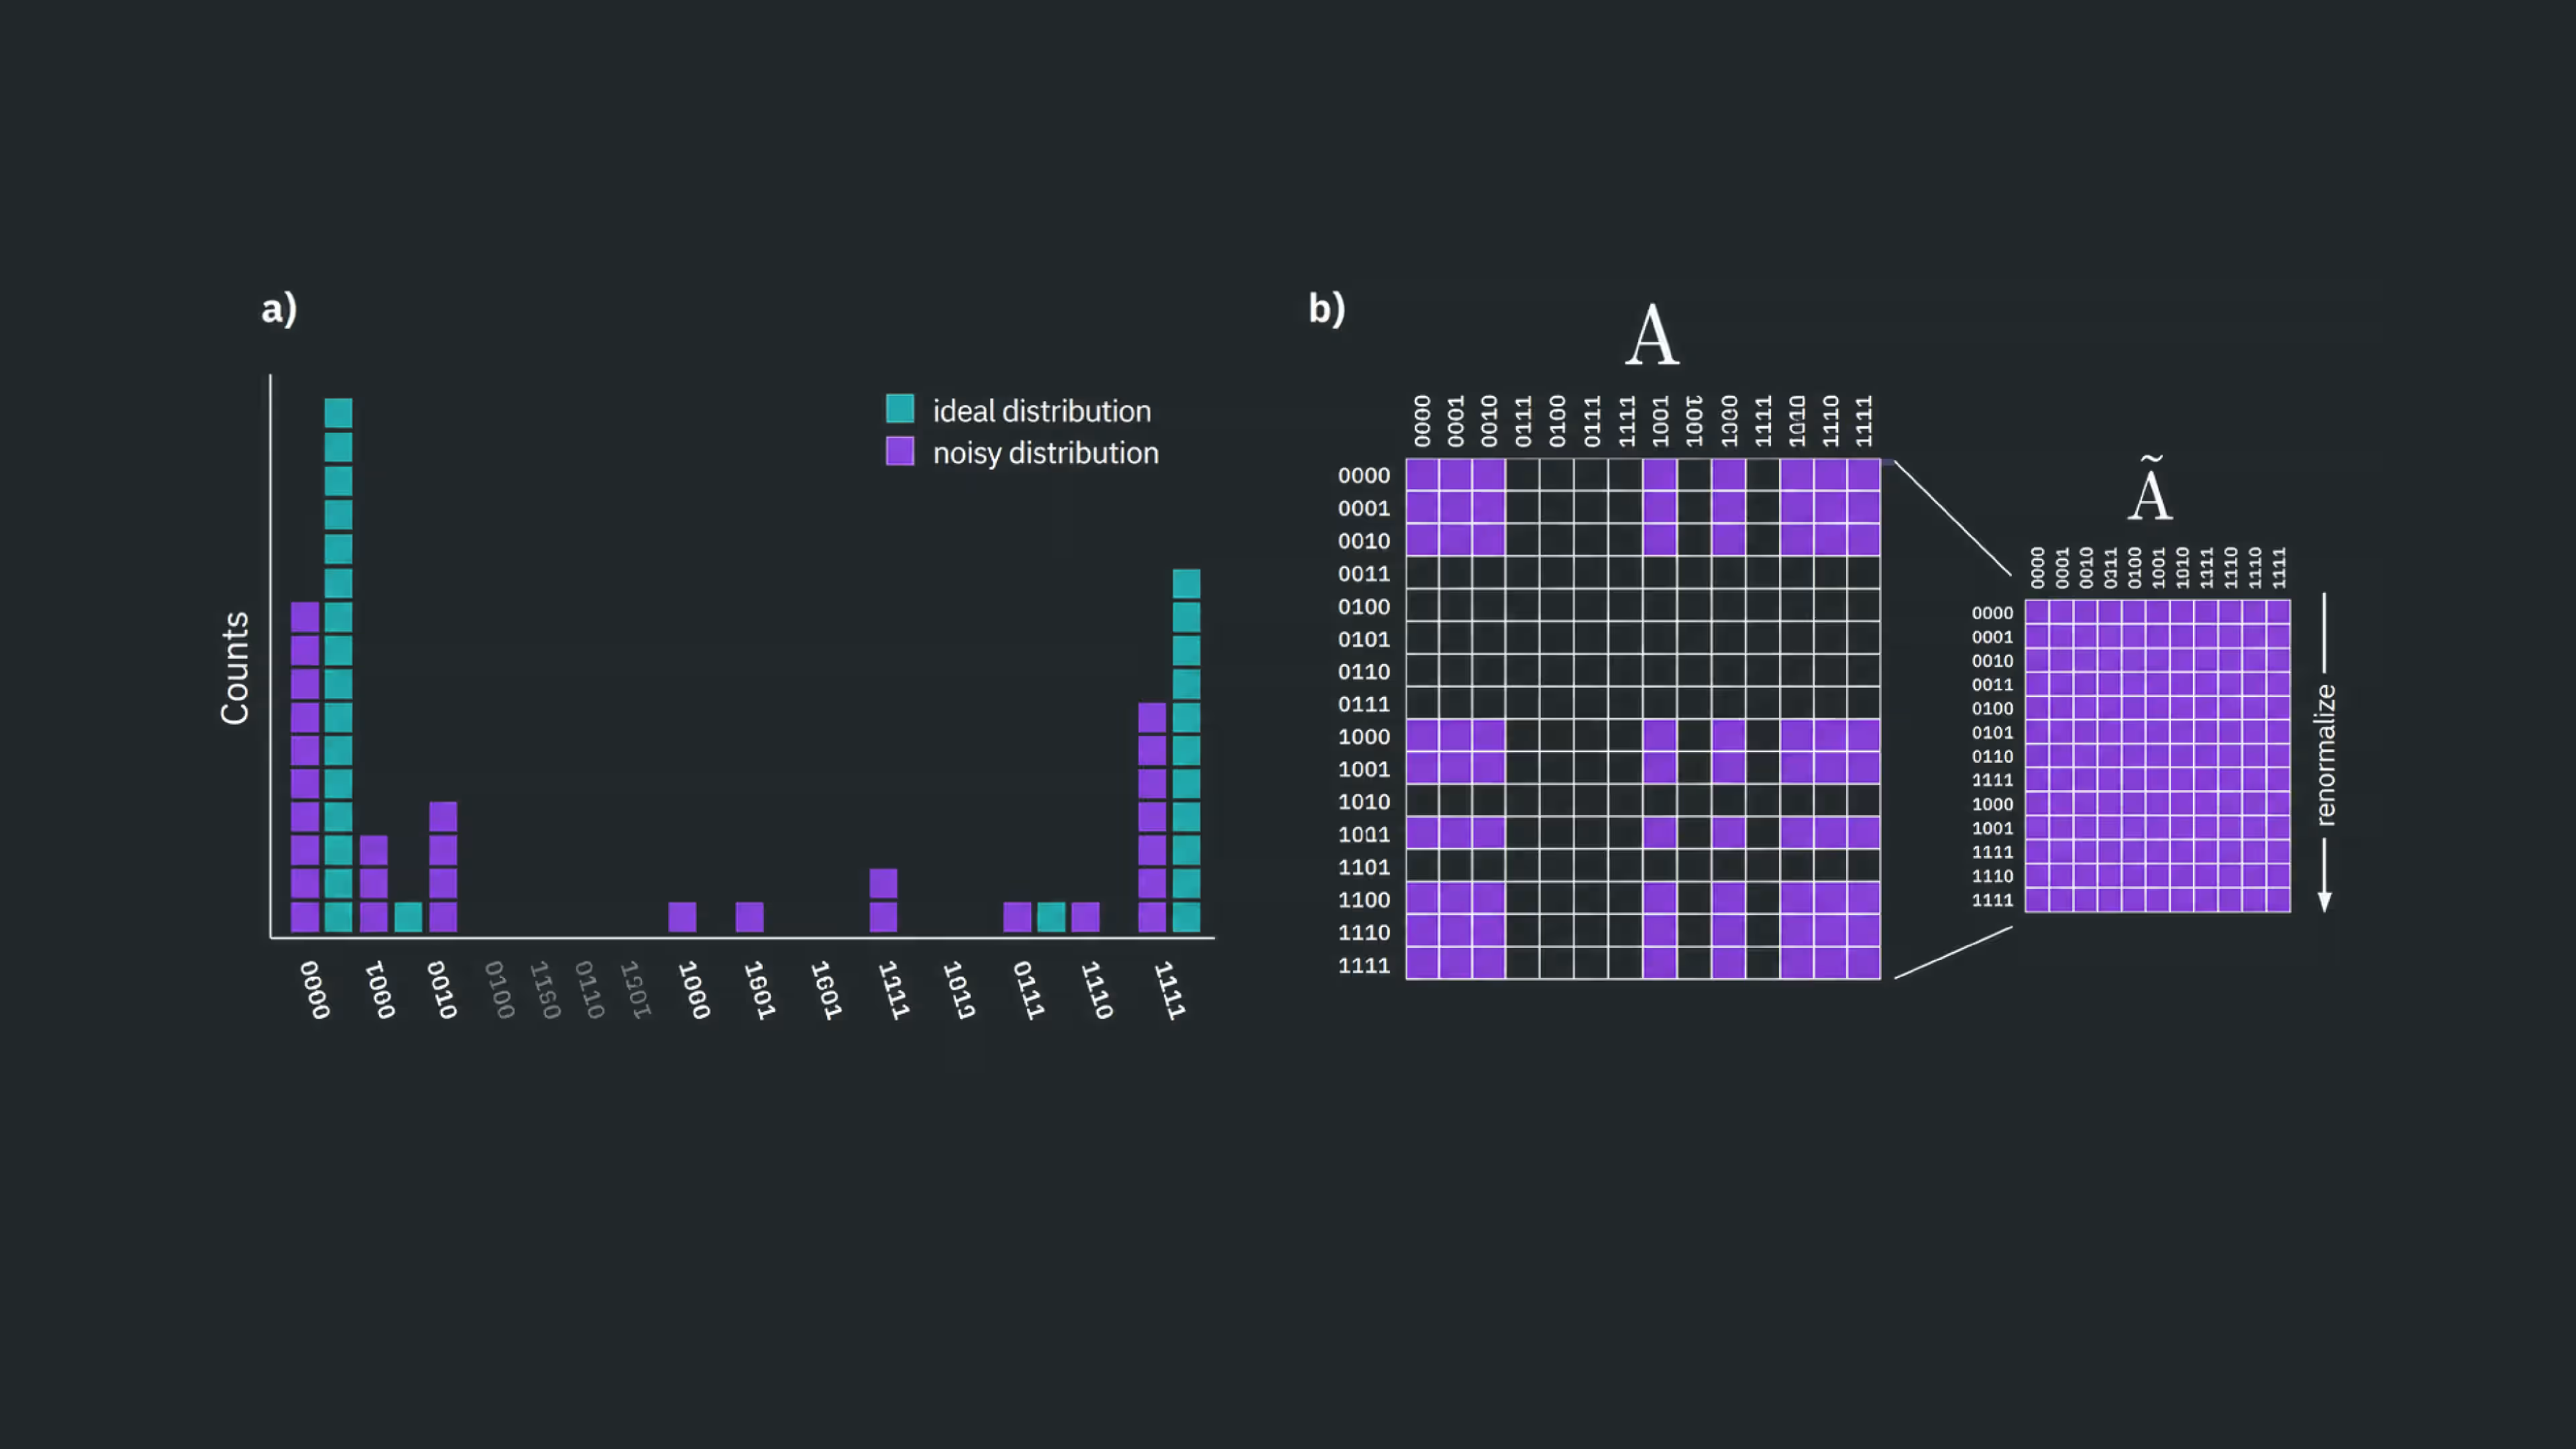
Mitygacja pomiaru bez macierzy (M3) wykorzystuje tę strukturę do skonstruowania poddanego mitygacji oszacowania bez tworzenia ani odwracania pełnej macierzy , co byłoby niewykonalne dla dużej liczby kubitów. Zamiast tego M3 wykorzystuje fakt, że wiele obciążeń roboczych bliskiej przyszłości daje rozkłady silnie skupione lub o niskiej entropii, dzięki czemu mitygacja skupia się tylko na podzbiorze wyników, które istotnie przyczyniają się do zaobserwowanego rozkładu.
Aby zbudować model przypisań, na sprzęcie kwantowym trzeba przeprowadzić dodatkowe eksperymenty kalibracyjne. Zwykle polegają one na przygotowaniu znanych stanów bazy obliczeniowej i zapisaniu, jak zgłasza je układ pomiarowy. Narzut kalibracji skaluje się z liczbą mierzonych kubitów, natomiast koszt obliczeniowy mitygacji zależy od struktury zaobserwowanego rozkładu. Koszt ten jest znacznie mniejszy niż ten, który byłby potrzebny do jawnego scharakteryzowania pełnej macierzy przypisań . Choć ten narzut kalibracji jest realny, jest lekki w porównaniu z technikami na poziomie obwodu, takimi jak ekstrapolacja do zerowego szumu czy probabilistyczne usuwanie błędów, co czyni M3 praktycznym i szeroko stosowanym narzędziem do mitygacji błędów odczytu w eksperymentach kwantowych bliskiej przyszłości.
Zauważ, że kalibracja jest użyteczna tylko w takim stopniu, w jakim proces pomiaru pozostaje dostatecznie stabilny między przebiegami kalibracyjnymi a docelowym eksperymentem.
Najpierw ręcznie przeprowadzimy prosty przypadek, aby zilustrować, jak to działa, a następnie użyjemy narzędzi wbudowanych w Qiskit, aby pokazać zastosowanie M3 w bardziej realistycznej skali.
Mały przykład M3
Zaczynamy od zbudowania prostego stanu Bella.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "mthree": "mthree", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
import numpy as np

qc = QuantumCircuit(2, 2)
qc.h(0)
qc.cx(0, 1)
qc.measure([0, 1], [0, 1])
<qiskit.circuit.instructionset.InstructionSet at 0x714a5fa4d630>
Możemy użyć symulatora z modelem szumu, ponieważ ograniczamy ten przykład do bardzo małego obwodu. Jawnie konfigurujemy nasz model szumu tak, aby miał błąd odczytu o postaci:
if true=0: [95% chance of reading 0, 5% chance of reading 1]
if true=1: [8% chance of reading 0, 92% chance of reading 1]
Te wskaźniki błędów odczytu są znacznie wyższe niż te, które widać w prawdziwych komputerach kwantowych IBM®. Wysokie wartości wybrano ze względów dydaktycznych, abyśmy mogli wyraźnie zobaczyć działanie M3.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, ReadoutError

ro_error = ReadoutError([[0.95, 0.05], [0.08, 0.92]])

noise_model = NoiseModel()
noise_model.add_readout_error(ro_error, [0])
noise_model.add_readout_error(ro_error, [1])

backend_noisy = AerSimulator(noise_model=noise_model)
Możemy uruchomić obwód na zaszumionym symulatorze, aby zaobserwować skutki błędu odczytu.
result = backend_noisy.run(qc, shots=5000, seed_simulator=123).result()
raw_counts = result.get_counts()
raw_counts
{'01': 290, '11': 2165, '10': 304, '00': 2241}
W naszym przykładzie poglądowym sami zdefiniowaliśmy błąd odczytu dla modelu szumu. Jednak w przypadku prawdziwego komputera kwantowego błąd odczytu nie jest znany a priori. Zamiast tego trzeba go oszacować eksperymentalnie. W tym celu tworzymy obwody, które przygotowują kubit w znanym stanie bazy obliczeniowej lub i go mierzą. Przy braku błędu odczytu mierzylibyśmy dokładnie przygotowany stan. Zbierając statystyki z tych pomiarów, możemy zbudować macierz przypisań opisującą błąd odczytu. W tym przykładzie poglądowym powinna wyglądać podobnie do zdefiniowanej przez nas.
W bardziej realistycznym systemie statystyki trzeba by zebrać dla każdego fizycznego kubitu. Bywa to nietrywialne, ponieważ transpilacja odwzorowuje abstrakcyjny obwód na sprzęt, a numer kubitu się zmienia. Wrócimy do tego w następnym przykładzie. W tym przykładzie z symulatorem przypisaliśmy ten sam model błędu odczytu każdemu kubitowi, więc wystarczy jedna charakteryzacja.
# Define a function to make a state and measure it.
def measure_state(state):
    qc = QuantumCircuit(1, 1)
    if state == 1:
        qc.x(0)
    qc.measure(0, 0)
    return backend_noisy.run(qc, shots=5000, seed_simulator=123).result().get_counts()
# Use the function to get statistics on readout errors
cal_counts_0 = measure_state(0)  # True state = 0
cal_counts_1 = measure_state(1)  # True state = 1

cal_counts_0, cal_counts_1
({'1': 244, '0': 4756}, {'0': 420, '1': 4580})
# Create the normalized readout error matrix

# def normalize(d):
#    s = sum(d.values())
#    return {k: v/s for k,v in d.items()}
# p0 = normalize(cal_counts_0)
# p1 = normalize(cal_counts_1)

p0 = {k: v / sum(cal_counts_0.values()) for k, v in cal_counts_0.items()}
p1 = {k: v / sum(cal_counts_1.values()) for k, v in cal_counts_1.items()}

A_1q = np.array(
    [
        [p0["0"], p1["0"]],  # row: measured 0, columns true 0/1
        [p0["1"], p1["1"]],
    ]
)
A_1q
array([[0.9512, 0.084 ],
       [0.0488, 0.916 ]])
Zauważ, że jest to bardzo bliskie macierzy błędu odczytu użytej do skonstruowania symulatora.
Ponownie, na prawdziwym komputerze kwantowym mielibyśmy takie statystyki dla wielu fizycznych kubitów. Dla tego symulatora zakładamy, że dwa kubity mają identyczne i niezależne błędy odczytu, co pozwala skonstruować dwukubitową macierz przypisań A_2q jako iloczyn tensorowy odpowiednich macierzy jednokubitowych. Zauważ też, że celem M3 nie jest konstruowanie całej macierzy przypisań. Zamiast tego M3 skupia się na podzbiorze wyników, które istotnie przyczyniają się do zaobserwowanego rozkładu. Zbudujemy całą macierz dla naszego bardzo małego przykładu, aby zobaczyć, jak to działa. Implementacja M3 w qiskit-ibm-runtime jest bardziej wyrafinowana niż ten przykład poglądowy, ponieważ musi obsłużyć wiele kubitów o odmiennych charakterystykach odczytu, jednocześnie unikając konstruowania pełnej macierzy przypisań.
A_2q = np.kron(A_1q, A_1q)
print(A_2q)
[[0.89794576 0.07107    0.07107    0.005625  ]
 [0.04965424 0.87653    0.00393    0.069375  ]
 [0.04965424 0.00393    0.87653    0.069375  ]
 [0.00274576 0.04847    0.04847    0.855625  ]]
W tym przykładzie zakładamy, że błędy odczytu na różnych kubitach są niezależne, co pozwala skonstruować dwukubitową macierz przypisań jako iloczyn tensorowy odpowiednich macierzy jednokubitowych.
Uzyskujemy surowe i poddane mitygacji wyniki do porównania.
bitstrings = ["00", "01", "10", "11"]
# Normalize raw counts
raw_probs = np.array([raw_counts.get(b, 0) for b in bitstrings], dtype=float)
raw_probs /= raw_probs.sum()
raw_probs
array([0.4482, 0.0592, 0.0598, 0.4328])
Na tym etapie scharakteryzowaliśmy eksperymentalnie, jak proces pomiaru zniekształca idealne prawdopodobieństwa wyników. Naszym celem jest teraz cofnięcie tego zniekształcenia i zastosowanie uzyskanej korekty do surowych prawdopodobieństw.
Ponieważ wykonujemy odwrócenie liniowe, a nie korektę fizyczną, otrzymane "prawdopodobieństwa" nie zawsze muszą być dodatnie. Bardzo małe ujemne kwazi-prawdopodobieństwa są oczekiwane i odzwierciedlają fakt, że mitygacja pomiaru daje estymator, a nie fizyczny rozkład prawdopodobieństwa.
# Explicit inversion is feasible only for very small systems
# This is why M3 avoids creating the entire A matrix.

A_inv = np.linalg.inv(A_2q)

# Note: mitigated_probs might contain negative values.
# This is expected and reflects estimator, not physical, probabilities.

mitigated_probs = A_inv @ raw_probs
print(mitigated_probs)
[ 4.96000451e-01 -4.69852308e-04 2.17747967e-04 5.04251654e-01]
Przeliczamy je na zliczenia na potrzeby wykresu.
shots = sum(raw_counts.values())  # e.g., 5000
ideal_probs = [0.50, 0.00, 0.00, 0.50]  # ideal Bell distribution
# Convert probabilities to integer counts for plotting only.
# Not physically meaningful when probabilities are negative

def probs_to_counts(bitstrings, probs, shots):
    """
    Convert a probability vector into a Qiskit-style counts dictionary.
    Ensures integer shot counts and correct normalization.
    """
    counts = {}
    # First convert to raw integer counts
    int_counts = [round(p * shots) for p in probs]
    # Fix rounding error by adjusting the last entry
    diff = shots - sum(int_counts)
    int_counts[-1] += diff
    # Build dict
    for b, c in zip(bitstrings, int_counts):
        if c > 0:
            counts[b] = c
    return counts

mitigated_counts = probs_to_counts(bitstrings, mitigated_probs, shots)
ideal_counts = probs_to_counts(bitstrings, ideal_probs, shots)
Na koniec przyglądamy się rozkładom surowemu, poddanemu mitygacji i idealnemu. Poniższe "zliczenia" po mitygacji są tylko pomocą wizualizacyjną uzyskaną przez przeskalowanie kwazi-prawdopodobieństw po mitygacji.
from qiskit.visualization import plot_histogram

plot_histogram(
    [raw_counts, mitigated_counts, ideal_counts],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
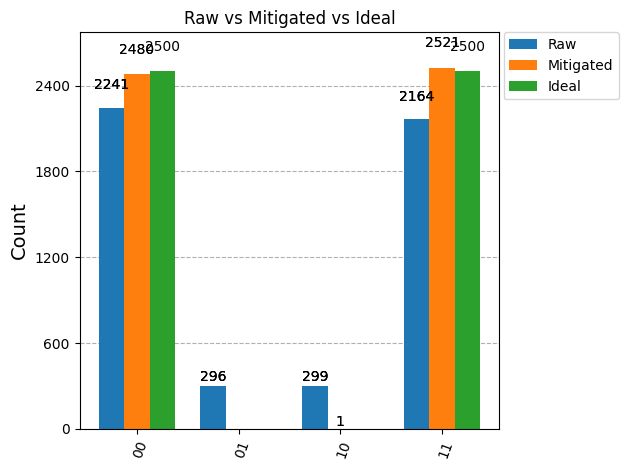
Wyraźnie widać, że wyniki po mitygacji M3 są znacznie bliższe idealnym rozkładom i możemy zobaczyć dlaczego.
Zastosowanie M3 w bardziej realistycznych przepływach pracy jest znacznie bardziej złożone. Rozważ:
- Prawdziwe komputery kwantowe zawierają wiele fizycznych kubitów, z których każdy ma własną charakterystykę błędu odczytu. Błędy te trzeba odpowiednio zamodelować i połączyć.
- Pełna macierz przypisań rośnie wykładniczo wraz z liczbą kubitów i szybko staje się niepraktyczna do jawnego skonstruowania. Dlatego M3 skupia się na podzbiorze wyników, które istotnie przyczyniają się do zaobserwowanego rozkładu, zamiast konstruować całą macierz przypisań.
- W przypadku rzeczywistych interesujących problemów idealny rozkład może nie być znany.
Z tych wszystkich powodów pełny przepływ pracy mitygacji jest zawarty w dodatku Qiskit mthree.
Większy przykład M3
Stosujemy teraz M3 do większego obwodu, takiego, dla którego ręczne wyznaczenie odpowiedniej podprzestrzeni byłoby uciążliwe, ale który jest nadal na tyle prosty, że znamy idealny rozkład: stanu GHZ. Zaczynamy od zaimportowania pakietu mthree i zdefiniowania obwodu kwantowego GHZ.
import numpy as np
from qiskit import QuantumCircuit

# from qiskit_ibm_runtime.fake_provider import FakeCasablancaV2
import mthree

num_qubits = 10

qc = QuantumCircuit(num_qubits)
qc.reset(range(num_qubits))
qc.h(0)
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)
qc.measure_all()
qc.draw("mpl")
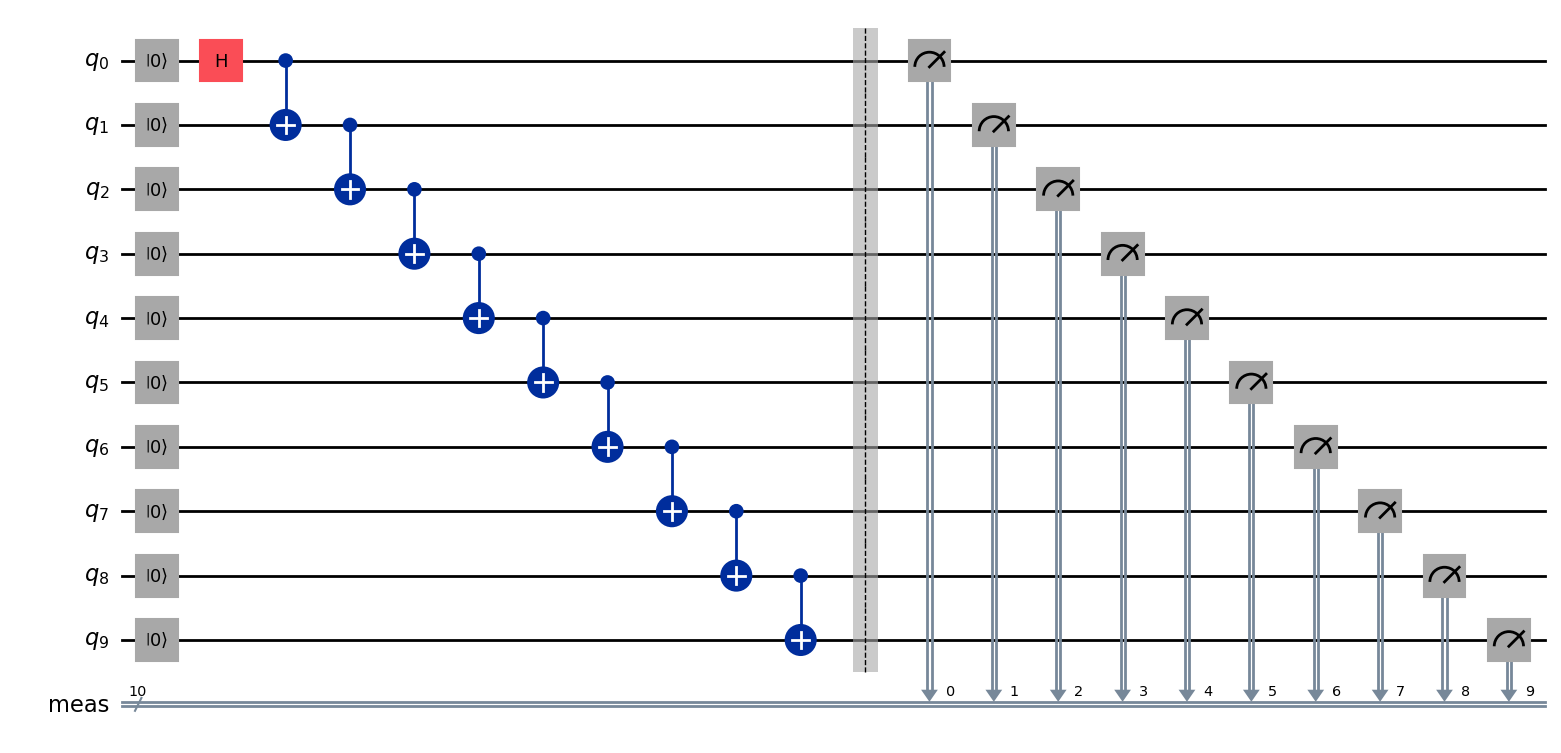
Aby uruchomić to na prawdziwym komputerze kwantowym, importujemy qiskit_ibm_runtime i inne niezbędne pakiety. Używamy SamplerV2, aby uzyskać rozkład wyników.
# Import packages needed for using real quantum computers

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime.executor_sampler import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# --------- Configuration ----------
service = QiskitRuntimeService(channel="ibm_quantum_platform", instance="your crn here")

# backend_real = service.backend("ibm_fez")     # adjust if needed
backend_real = service.least_busy(simulator=False, operational=True)
Teraz transpilujemy obwód na nasz backend. Ustawiamy tu poziom optymalizacji na 0, aby skupić się na skutkach M3 bez dodawania dodatkowych narzędzi. Oznacza to, że końcowa wierność nie będzie reprezentatywna dla tego, co można osiągnąć na sprzęcie IBM Quantum® przy użyciu pełnego zestawu dostępnych narzędzi, ale pozwala skupić się konkretnie na użyteczności M3.
# Exclude any optimization to focus only on M3 effects
opt_level = 0
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend_real)
qc_isa = pm.run(qc)
Konfigurujemy teraz Sampler, ponownie wyłączając dodatkowe techniki supresji błędów, takie jak dynamiczne rozprzęganie i twirling.
shots = 8192

# No twirling
sampler_no_twirl = Sampler(mode=backend_real)
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = False
sampler_no_twirl.options.default_shots = shots
sampler_no_twirl.options.dynamical_decoupling.enable = False
Na koniec wykonujemy nasze zadanie.
# This job took 7 seconds on ibm_fez. Your actual execution time can vary.
job = sampler_no_twirl.run([qc_isa])
res_real = job.result()
job_id = job.job_id()
print("job number for real  ", job_id)
job number for real d7ark4e5nvhs73a2fu6g
Możemy wyodrębnić surowe zliczenia z powyższego obwodu.
counts_real = []
for i in range(len(res_real)):
    counts_real.append(res_real[i].data.meas.get_counts())
Teraz uruchamiamy mthree na naszym backendzie, aby scharakteryzować model przypisań używany do mitygacji pomiaru. Przeskalowujemy surowy rozkład z użyciem tej informacji. Zauważ, że czasami może to dać bardzo małe ujemne prawdopodobieństwa (stąd termin kwazi-prawdopodobieństwa).
# Added 6 sec on ibm_fez, on top of original 7 sec to run circuits. Your time might differ.
mit_real = mthree.M3Mitigation(backend_real)
mappings_real = mthree.utils.final_measurement_mapping(qc_isa)
mit_real.cals_from_system(mappings_real)
quasis_real = mit_real.apply_correction(counts_real, mappings_real)
Korekta mthree daje kwazi-prawdopodobieństwa, a nie zliczenia. Możemy ręcznie przeskalować je na zliczenia. Poniższa funkcja pomocnicza przelicza na zliczenia i zaokrągla do wartości całkowitych. Ponadto w dużych obwodach pojawi się wiele błędnych ciągów o bardzo niewielu zliczeniach, które jednak zaśmiecają histogram. Druga funkcja pomocnicza poniżej usuwa wszystkie ciągi o liczbie zliczeń mniejszej niż wybrany przez nas próg, abyśmy mieli wyraźny widok dominujących składników rozkładu.
def quasidistribution_to_counts(quasi_list, shots):
    return [
        {bitstr: int(round(float(prob) * shots)) for bitstr, prob in quasi.items()}
        for quasi in quasi_list
    ]

def filter_counts_by_threshold(counts_list, t):
    filtered = []

    for counts in counts_list:
        new_counts = {}
        for bitstr, val in counts.items():
            c = int(round(float(val)))  # FORCE conversion
            if abs(c) >= t:
                new_counts[bitstr] = c
        filtered.append(new_counts)

    return filtered
quasi_counts = quasidistribution_to_counts(quasis_real, shots)
trim_threshold = 30
trimmed_quasi = filter_counts_by_threshold(quasi_counts, trim_threshold)
trimmed_raw = filter_counts_by_threshold(counts_real, trim_threshold)
Możemy też łatwo wygenerować teoretyczny, idealny rozkład, w którym stany same-zera i same-jedynki mają równe prawdopodobieństwa, a wszystkie pozostałe wyniki mają prawdopodobieństwo zero, do porównania.
ideal = [
    {
        "0" * num_qubits: int(round(float(shots) / 2)),
        "1" * num_qubits: int(round(float(shots) / 2)),
    }
]
Na koniec możemy zwizualizować nasze wyniki.
from qiskit.visualization import plot_histogram

plot_histogram(
    [trimmed_raw[0], trimmed_quasi[0], ideal[0]],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
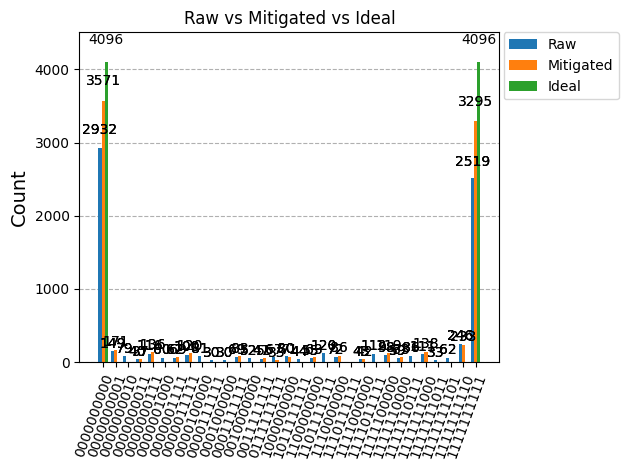
Wyniki po mitygacji są bliższe idealnemu rozkładowi niż wyniki bez mitygacji. Możemy lepiej to oszacować ilościowo, używając zliczeń dla idealnych ciągów bitów.
def extract_all_zero_and_all_one(counts):
    """
    Extract counts for the all-0 and all-1 bitstrings.

    Parameters
    ----------
    counts : dict[str, int]
        Counts dictionary.

    Returns
    -------
    dict[str, int]
        Dictionary containing only 00...0 and 11...1 entries if present.
    """
    n = len(next(iter(counts)))  # infer bitstring length
    zero_state = "0" * n
    one_state = "1" * n

    return {k: counts[k] for k in (zero_state, one_state) if k in counts}

correct_counts_raw = extract_all_zero_and_all_one(trimmed_raw[0])
correct_counts_mitigated = extract_all_zero_and_all_one(trimmed_quasi[0])
keys = ["0" * num_qubits, "1" * num_qubits]
fidelity_raw = (
    correct_counts_raw.get(keys[0]) + correct_counts_raw.get(keys[1])
) / shots
fidelity_mit = (
    correct_counts_mitigated.get(keys[0]) + correct_counts_mitigated.get(keys[1])
) / shots
print("Percent correct raw counts: ", fidelity_raw)
print("Percent correct mitigated counts: ", fidelity_mit)
Percent correct raw counts:  0.6654052734375
Percent correct mitigated counts:  0.838134765625
To proste narzędzie poprawiło naszą wierność o 26% względem wierności bez mitygacji, przy dość niskim narzucie. Wyraźnie M3 może być bardzo cenne. Ale obwód GHZ wybrano jako dobry przypadek użycia, ponieważ jest silnie skupiony na dwóch stanach wyjściowych. Niektóre problemy dają bardziej równomiernie rozłożone zliczenia (stany o wysokiej entropii). W przypadku bardzo głębokich obwodów z wieloma kubitami błędy bramek i szum niezwiązany z błędami pomiaru będą często prowadzić do stanu o wysokiej entropii. W takich przypadkach M3 działa na dość dużej przestrzeni stanów. Istnieją trzy możliwe podejścia:
(1) Zaakceptować, że jest to ograniczenie M3.
(2) Zauważ, że górne ograniczenie przestrzeni macierzy tworzonej przez M3 wynosi num_shots num_shots, a nie , przy czym ta pierwsza jest znacznie mniejsza dla dużej liczby kubitów .
(3) Tylko z wielką ostrożnością usuwać ciągi bitów o bardzo niskim prawdopodobieństwie z surowych zliczeń podawanych do M3. Może to wprowadzić obciążenie, a ograniczenie nośnika twoich stanów może zakłócać zbieżność w podejściach takich jak metoda Kryłowa. Należy to robić tylko wtedy, gdy dokładnie wiesz, dlaczego to robisz, i potrafisz przewidzieć wszystkie jego skutki. Dlatego takie przycinanie nie jest wbudowaną funkcją M3.
Więcej o dodatku Qiskit mthree znajdziesz w przykładach, instrukcjach instalacji, opisie tła i dokumentacji API w jego dokumentacji.
Wygaszanie błędów odczytu z twirlingiem (TREX)
Wygaszanie błędów odczytu z twirlingiem (TREX) to technika mitygacji błędów pomiaru stosowana we współczesnych komputerach kwantowych. Jej celem jest usunięcie obciążenia wprowadzanego przez klasyczne błędy odczytu bez konieczności pełnej charakteryzacji ani odwracania macierzy przypisań pomiaru.
TREX nie jest korekcją błędów i nie poprawia wierności stanu. Zamiast tego zapewnia, że estymatory wartości oczekiwanych są nieobciążone względem szumu odczytu, z dokładnością do błędu statystycznego, poprzez uśrednianie po losowych bazach pomiarowych i przeskalowanie. Na sprzęcie IBM Quantum TREX jest domyślną metodą mitygacji do estymacji wartości oczekiwanych i odpowiada resilience_level = 1 w prymitywie IBM Quantum Estimator.
Natura błędów odczytu w sprzęcie nadprzewodzącym
W nadprzewodzących kubitach IBM błędy odczytu są zdominowane przez:
-
Asymetryczne prawdopodobieństwa przeskoku bitu (na przykład częściej niż odwrotnie)
-
Zależną od stanu relaksację podczas samego pomiaru
-
Niewielkie, ale nieistotne do pominięcia przesłuchy między sąsiednimi rezonatorami odczytu
Co ważne, błędy te można często modelować jako klasyczny proces stochastyczny działający na wyniki pomiaru. TREX wykorzystuje standardową ideę z kształtowania szumu: randomizację (twirling) procedury pomiarowej. TREX zwykle przebiega w dwóch etapach:
-
Twirling i klasyczne "odwirowanie" (untwirling)
-
Przeskalowanie wartości oczekiwanych z użyciem obwodów kalibracyjnych
Załóżmy, że wartość oczekiwana obserwabli jest powiązana z zaszumionymi oszacowaniami w następujący sposób:
gdzie jest stałym czynnikiem skalującym oszacowanie, a jest obciążeniem pochodzącym ze źródeł opisanych powyżej. Używamy tu jako przypomnienia, że zajmujemy się tu tylko błędem odczytu; nadal pozostaje błąd bramek do rozważenia.
Tuż przed pomiarem każdy kubit jest losowo sprzęgany z operatorem Pauliego (takim jak I lub X). Wyniki pomiaru są następnie klasycznie odwirowywane.
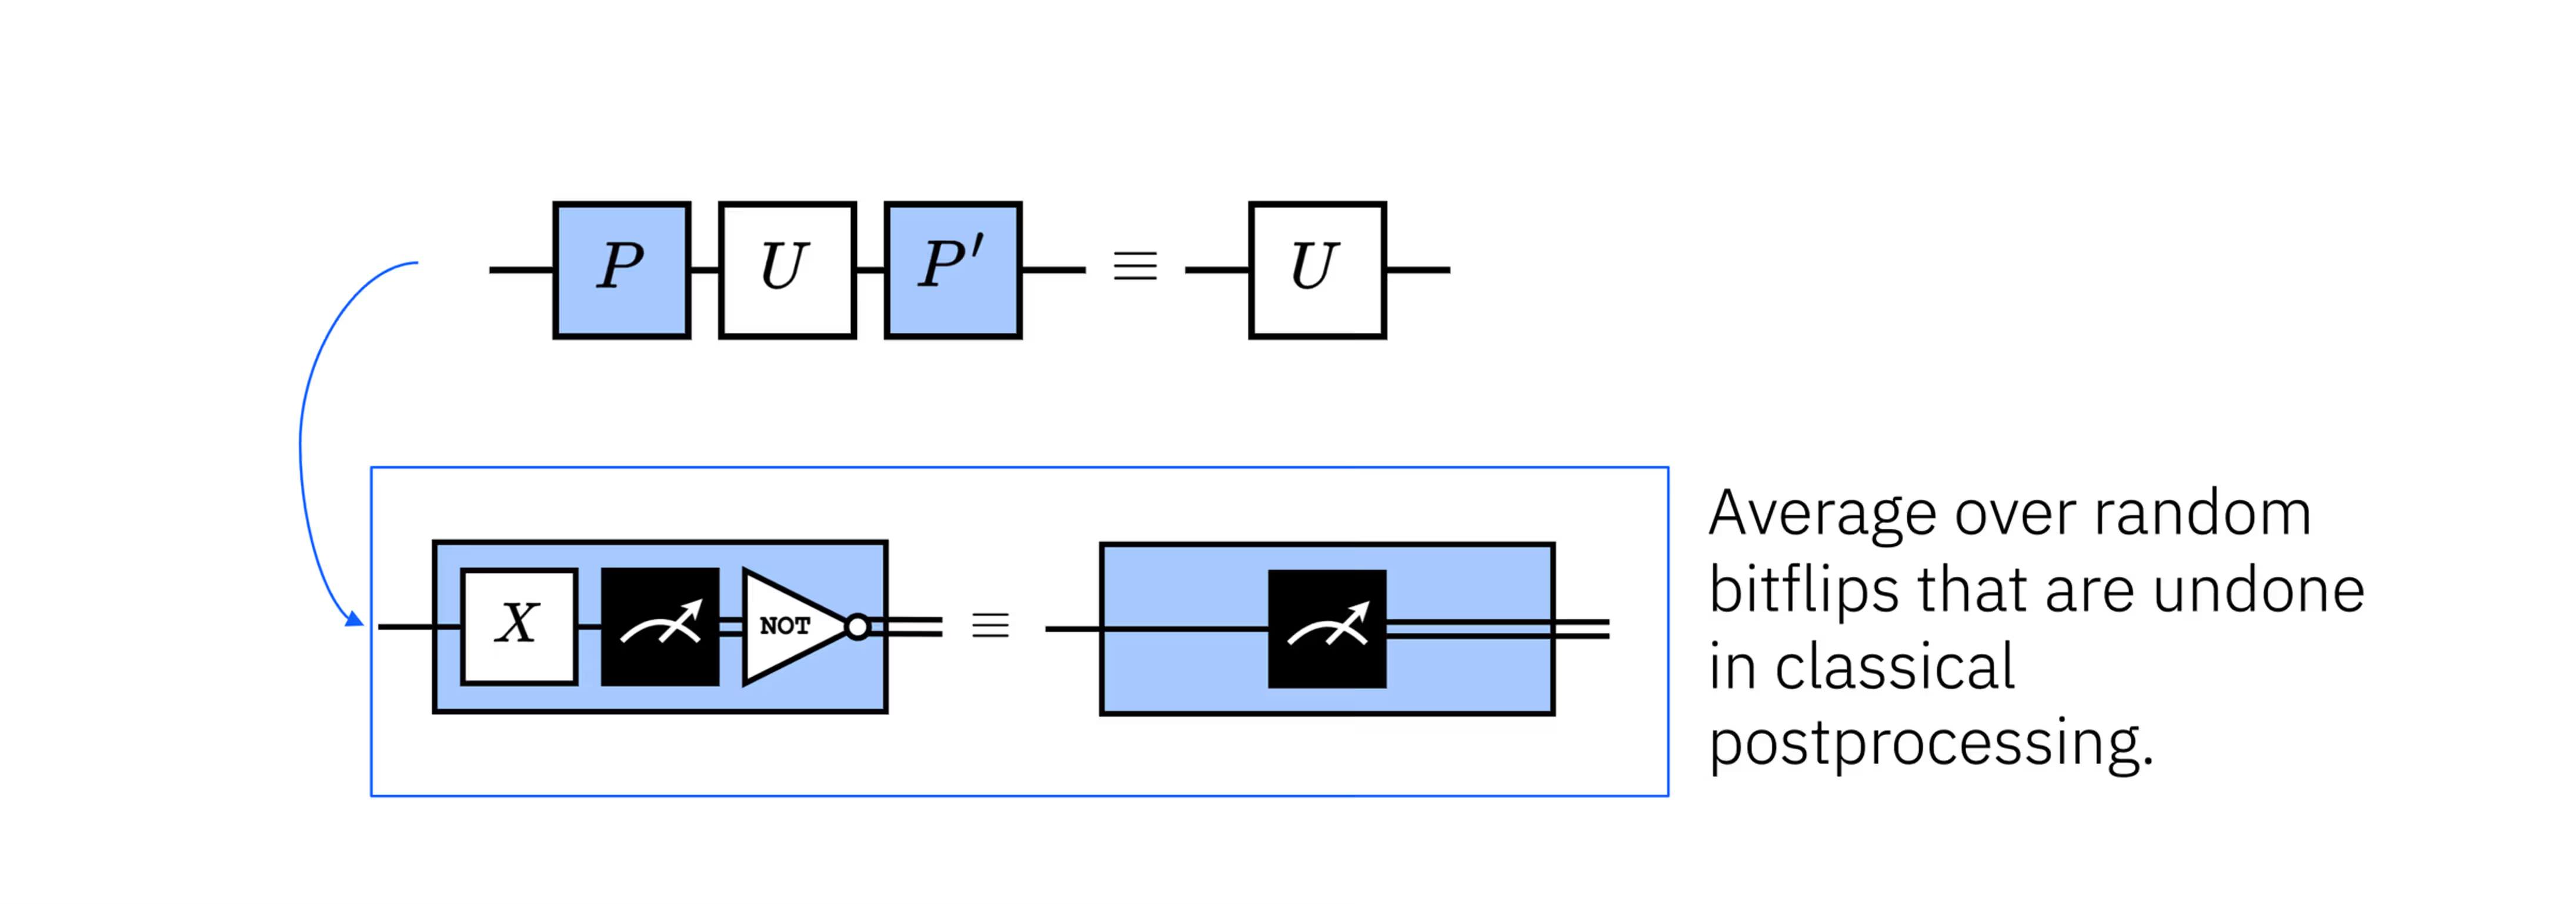
Uśrednianie po tych randomizacjach symetryzuje kanał odczytu. W rezultacie systematyczne asymetrie procesu odczytu zostają przekształcone w bardziej symetryczny kanał błędu, którego pozostały wpływ można uwzględnić za pomocą kalibracji i przeskalowania. Mówiąc prosto, gdyby na przykład występowało obciążenie w stronę stanu , brakowałoby nam części pomiarów . Stosując twirling wokół pomiaru, losowo zamieniamy, który wynik logiczny jest powiązany z fizycznym procesem odczytu, a następnie klasycznie cofamy tę zamianę. Uśrednianie po wielu takich zrandomizowanych pomiarach usuwa systematyczne preferowanie jednego zgłaszanego wyniku względem drugiego. Usuwa to dominujące obciążenie pomiaru przy założeniach modelu TREX, więc mamy:
Jednak wartości oczekiwane mogą nadal wymagać przeskalowania. Drugi etap polega na użyciu obwodów kalibracyjnych (obwodów o znanych wynikach) do oszacowania czynnika skalującego . Można go następnie użyć do uzyskania znacznie lepszego oszacowania.
Wartości oczekiwane obserwabli Pauliego stają się nieobciążonymi estymatorami swoich idealnych wartości. Żaden jawny model szumu nie jest uczony ani odwracany, dlatego TREX jest numerycznie stabilny i tani. Ponownie, błąd bramek nie został tu uwzględniony.
W estymacji wartości oczekiwanej obserwabli może występować wariancja wynikająca ze skończonego próbkowania, mogą występować różne rodzaje błędów niekoherentnych i koherentnych, a także obciążenie wynikające z błędu odczytu. To obciążenie pochodzi ze źródeł takich jak omówione asymetryczne przejścia. W praktyce jest ono zwykle dobrze modelowane jako klasyczny kanał stochastyczny działający po ewolucji kwantowej. TREX przekształca efektywny kanał pomiarowy tak, aby estymator był nieobciążony względem błędu odczytu. Łatwo to zobaczyć na najprostszym przykładzie bramek twirlingu: X. Jeśli istnieje asymetria w w porównaniu z , ale losowo zamieniamy, który stan jest odczytywany (a później klasycznie zamieniamy z powrotem), to oczywiście usuwa to systematyczną asymetrię (choć skończone próbkowanie nadal oznacza, że w pomiarze może pozostać niewielka asymetria stochastyczna). W praktyce bramki twirlingu dla TREX nie ograniczają się do I i X, ale to wystarcza do wyjaśnienia.
TREX pozwala uzyskać oszacowanie wartości oczekiwanej wolne od obciążenia wynikającego z błędu odczytu. Nadal może występować obciążenie z innego źródła (na przykład koherentne nadmierne obrócenie); TREX dotyczy tylko odczytu. Ponieważ TREX zastępuje obciążenie systematyczne randomizowaną symetryzacją, zwykle zamienia obciążenie w dodatkową wariancję stochastyczną, zwiększając wariancję estymatora przy stałym koszcie próbkowania.
Sprawdź, czy rozumiesz
Załóżmy, że używamy estymatora na obwodzie, który przygotował stan , do estymacji . Załóżmy dalej, że błędy pomiaru powodują, iż wyniki odpowiadające są zgłaszane jako w 10% przypadków, podczas gdy wyniki odpowiadające są zgłaszane jako tylko w 1% przypadków. Asymetria między tymi błędami zgłaszania wprowadza obciążenie pomiaru.
(a) Jaka byłaby idealna wartość oczekiwana obserwabli przy braku takich błędów pomiaru?
(b) Jaka jest wartość oczekiwana obserwabli przy asymetrycznych błędach pomiaru lub odczytu?
(c) Rozważ ograniczony zbiór bramek twirlingu Pauliego: I i X. Załóż, że I i X są stosowane losowo z prawdopodobieństwem 50% w wielu powtórzeniach. Nadal obowiązują te same wskaźniki błędów pomiaru. Następnie bramka Pauliego (I lub X) jest cofana klasycznie. Sporządź tabelę wszystkich możliwych wyników i ich prawdopodobieństw wynikających z początkowej superpozycji, asymetrycznych błędów pomiaru i losowo przypisanych bramek Pauliego.
(d) Użyj tabeli, aby wyznaczyć wartość oczekiwaną przy strategii z twirlingiem.
(e) Porównaj wartości oczekiwane: idealną, bez twirlingu i z twirlingiem.
(f) Co zostało pominięte w tym ujęciu, a występuje w pełnym zastosowaniu TREX?
Odpowiedź
(a) Możesz po prostu użyć intuicji i symetrii, aby stwierdzić, że . Aby pokazać to jawnie:
(b) Stan może zapaść się przy pomiarze do lub , każdy z szansą 50%. Ale z 50%, które zapadają się do stanu , 1% (czyli 0,5% wszystkich przypadków) zostanie błędnie zgłoszony jako . Z 50%, które zapadają się do , 10% (czyli 5% wszystkich przypadków) zostanie błędnie zgłoszone jako . Zostaje nam więc:
- 54,5%
- 45,5% Pomijając wszystkie inne możliwe rodzaje błędów, otrzymalibyśmy oszacowanie
(c)
| Pauli | Idealny wynik pomiaru | Wynik po Paulim | Błąd odczytu | Cofnięcie Pauliego | Końcowy zgłoszony wynik | Prawdopodobieństwo |
|---|---|---|---|---|---|---|
| I | 0 | 0 | Brak | I | 0 | 50% 50% 99% = 24.75% |
| I | 0 | 0 | I | 1 | 50% 50% 1% = 0.25% | |
| I | 1 | 1 | Brak | I | 1 | 50% 50% 90% = 22.5% |
| I | 1 | 1 | I | 0 | 50% 50% 10% = 2.5% | |
| X | 0 | 1 | Brak | X | 0 | 50% 50% 90% = 22.5% |
| X | 0 | 1 | X | 1 | 50% 50% 10% = 2.5% | |
| X | 1 | 0 | Brak | X | 1 | 50% 50% 99% = 24.75% |
| X | 1 | 0 | X | 0 | 50% 50% 1% = 0.25% |
(d) Z poprzednich części znamy wartości oczekiwane Z w każdym ze stanów końcowych. Wystarczy wziąć średnią ważoną:
(e) W tym bardzo prostym przypadku nasze zastosowanie twirlingu odzyskało dokładnie idealną wartość oczekiwaną. To nietypowe. Typowe jest to, że twirling cofa obciążenia takie jak te wprowadzone przez asymetryczne przejścia i zwraca wartość oczekiwaną bliższą idealnej.
(f) To zastosowanie na modelu poglądowym. Mogło zabraknąć kilku rzeczy. W szczególności nie uruchomiliśmy tu obwodów kalibracyjnych, aby oszacować czynnik przeskalowania . Zwykle jest to konieczne.
Szczegóły implementacji
TREX jest stosowany automatycznie przy użyciu prymitywu EstimatorV2 z resilience_level = 1 (wartość domyślna). Zauważ, że nie jest stosowany automatycznie do prymitywu Sampler, ponieważ Sampler zwraca pełne rozkłady prawdopodobieństwa, a nie wartości oczekiwane.
Gdy TREX jest włączony, środowisko uruchomieniowe generuje warianty obwodów z twirlingiem pomiaru, wstawiając losowe jednokubitowe operatory Pauliego tuż przed pomiarem. Klasyczne przetwarzanie końcowe cofa te operatory Pauliego. Warianty obwodów są losowe w różnych powtórzeniach, a także dla różnych kubitów w obrębie jednego powtórzenia. Wszystkie warianty obwodów są następnie łączone w jeden estymator.
TREX jest bardzo skalowalny. Wymaga dodatkowych obwodów kalibracyjnych, tak że narzut próbkowania jest zwykle niewielkim stałym czynnikiem (często 2-4x). Ale mitygacja jest specyficzna dla obserwabli i nie zachowuje rozkładu.
TREX jest zaprojektowany tak, aby dobrze współpracować z wieloma metodami supresji i mitygacji błędów, w tym z następującymi:
-
Dynamiczne rozprzęganie (DD) - działa w czasie bezczynności, ortogonalnie do mitygacji odczytu.
-
Twirling bramek lub Pauliego - często uzupełniający; TREX już opiera się na twirlingu, ale dotyczy tylko szumu odczytu.
-
Ekstrapolacja do zerowego szumu (ZNE) - ZNE dotyczy szumu bramek, a TREX zajmuje się obciążeniem pomiaru. Ta kombinacja jest używana na poziomie odporności 2.
-
Probabilistyczne wzmacnianie błędów i probabilistyczne usuwanie błędów w przepływach pracy Estimator.
Jednak niektórych metod nie można (lub nie należy) łączyć z TREX:
-
Korekta prawdopodobieństw na poziomie Sampler: TREX nie zwraca skorygowanych prawdopodobieństw ciągów bitów.
-
Mitygacja post hoc na danych już poddanych mitygacji TREX: podwójna korekta może ponownie wprowadzić obciążenie.
Łączenie TREX z redukcją błędów odczytu opartą na macierzy przypisań, taką jak M3, jest trudne. M3 zakłada stały kanał pomiarowy. TREX celowo losowo zmienia pomiar, co unieważnia założenie przyjęte w M3. W tym sensie nie można po prostu połączyć tych technik. Jeśli jednak zastosujesz twirling pomiaru podczas kalibracji używanej w M3, możesz być w stanie wykorzystać jednocześnie podejście zbliżone do macierzy przypisań i podejście oparte na twirlingu (choć to podejście twirlingowe nie jest dokładnie tym samym co TREX). To powracający motyw w łączeniu technik redukcji i tłumienia błędów: ślepe dodawanie technik zawodzi; dodawanie ich ostrożnie, tak aby były wzajemnie "świadome" swojego istnienia, może działać i być bardzo korzystne.
TREX gwarantuje jedynie wartości oczekiwane wolne od obciążenia spowodowanego błędami odczytu; nie zmniejsza wariancji ani nie chroni przed innymi rodzajami obciążenia. Z pewnością nie koryguje wszystkich błędów. Często jednak daje znaczną poprawę i można go osiągnąć przy znacznie mniejszym narzucie niż w niektórych innych metodach, które wymagają uczenia pełnych modeli szumu. TREX jest często najtańszą i najbardziej niezawodną dostępną metodą redukcji błędów odczytu, co czyni go doskonałym ustawieniem domyślnym w eksperymentach.
TREX z Qiskit
Tworzymy tu prosty dwukubitowy obwód i używamy Estimator do oszacowania wartości oczekiwanej bardzo prostej obserwabli, ZX. Idealna wartość oczekiwana wynosi 1. Porównamy wartości oczekiwane z TREX i bez niego.
# Import packages needed for using real quantum computers

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Session
import numpy as np

# --------- Configuration ----------

backend = service.backend("ibm_fez")  # adjust if needed
Utwórz prosty obwód kwantowy.
qc = QuantumCircuit(2)
qc.x(0)
qc.h(0)
qc.cx(0, 1)
qc.h(0)
qc.barrier()
qc.draw("mpl")

Dokonaj transpilacji obwodu za pomocą pass managera.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend)

qc_t = pass_manager.run(qc)
Zastosuj do obserwabli ten sam układ (layout) uzyskany w transpilacji.
# Observable: X on qubit 0, Z on qubit 1, ideal expectation value is 1.0.
observable = SparsePauliOp("ZX")
observable_t = observable.apply_layout(qc_t.layout)
Uruchom eksperyment na prawdziwym komputerze kwantowym. Najpierw używamy reslience_level = 1; jest to wartość domyślna, ale podajemy ją jawnie, aby odróżnić oba przypadki.
# First, we run this on an ideal simulator to confirm the ideal expectation value.

from qiskit.primitives import StatevectorEstimator as Estimator

estimator = Estimator()

job = estimator.run(pubs=[(qc, observable)])

res = job.result()
val = res[0].data.evs

print("⟨ZX⟩ ideal:", val)
⟨Z₀⟩ ideal: 0.9999999999999996
# This took 27 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ with TREX:", val)
⟨Z₀⟩ with TREX: 0.9520029143897996
Teraz ustawiamy resilience_level na 0, aby uruchomić bez TREX.
# This took 12 sec on ibm_fez. Your runtime might differ.
with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ without TREX:", val)
⟨Z₀⟩ without TREX: 0.8651
Wartość oczekiwana jest z TREX wyraźnie bliższa wartości idealnej (1), zgodnie z oczekiwaniami. Oczywiście była to pojedyncza wartość oczekiwana na pojedynczym kubicie. Teraz przygotowujemy obwód z bramkami nie-Cliffordowskimi i wieloma kubitami, aby sprawdzić, czy poprawa dzięki TREX pozostaje stabilna w innym przypadku.
import numpy as np

num_qubits = 20
qc = QuantumCircuit(num_qubits)
for i in range(num_qubits):
    qc.rx(np.pi * 7 / 8, i)
qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=20, num_clbits=0, params=[]), qubits=(<Qubit register=(20, "q"), index=0>, <Qubit register=(20, "q"), index=1>, <Qubit register=(20, "q"), index=2>, <Qubit register=(20, "q"), index=3>, <Qubit register=(20, "q"), index=4>, <Qubit register=(20, "q"), index=5>, <Qubit register=(20, "q"), index=6>, <Qubit register=(20, "q"), index=7>, <Qubit register=(20, "q"), index=8>, <Qubit register=(20, "q"), index=9>, <Qubit register=(20, "q"), index=10>, <Qubit register=(20, "q"), index=11>, <Qubit register=(20, "q"), index=12>, <Qubit register=(20, "q"), index=13>, <Qubit register=(20, "q"), index=14>, <Qubit register=(20, "q"), index=15>, <Qubit register=(20, "q"), index=16>, <Qubit register=(20, "q"), index=17>, <Qubit register=(20, "q"), index=18>, <Qubit register=(20, "q"), index=19>), clbits=())
Kąt obrotu nie ma tu nic szczególnego. Po prostu wybraliśmy dowolną nierówną superpozycję i , aby zbadać skutki asymetrycznych błędnych przejść i to, jak radzi sobie z nimi TREX. Dla tego stanu idealna wartość oczekiwana Z na każdym kubicie, przy braku jakichkolwiek błędów (odczytu lub innych), wynosiłaby:
Mamy zatem nadzieję uzyskać wartości oczekiwane bliskie -0.924 na wszystkich kubitach. Zobaczymy, czy TREX poprawia każdą wartość oczekiwaną z osobna, a także czy poprawia średnią po wszystkich kubitach.
Sprawdź swoją wiedzę
Zweryfikuj powyższą wartość oczekiwaną przez bezpośrednie obliczenie.
Odpowiedź
Dokonujemy transpilacji za pomocą pass managera.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend_real)

qc_t = pass_manager.run(qc)
Teraz konstruujemy po jednej obserwabli na kubit, aby oszacować wszystkie dwadzieścia wartości oczekiwanych w jednym przepływie pracy. Oznacza to, że dla kubitu chcemy obserwablę złożoną z samych identyczności , z wyjątkiem pozycji , na której chcemy mieć . Pamiętaj, aby zastosować swój transpilowany układ (layout) także do obserwabli.
# Observables: Z on qubit i for all i.
observables = []
for i in range(num_qubits):
    obs_string = "I" * i + "Z" + "I" * (num_qubits - i - 1)
    obs = SparsePauliOp(obs_string)
    observables.append(obs)
observables_t = [obs.apply_layout(qc_t.layout) for obs in observables]
Teraz możemy wykonać obliczenia. Poniższa komórka kodu używa session mode; jeśli nie masz dostępu do sesji, możesz zastąpić go batch mode, aby uruchomić ten sam przepływ pracy, ale z możliwym czasem oczekiwania w kolejce między obwodami.
# This took 20 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX turned off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_no_trex = job.result()
    val_no_trex = res_no_trex[0].data.evs

print("⟨Z_i⟩ without TREX:", val_no_trex)
⟨Z_i⟩ without TREX: [-0.90645 -0.89755 -0.89125 -0.9165  -0.87655 -0.91035 -0.8757  -0.87905
 -0.66035 -0.8876  -0.87125 -0.89975 -0.83745 -0.89755 -0.82645 -0.90325
 -0.84385 -0.90195 -0.85865 -0.8884 ]
# This took 36 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_trex = job.result()
    val_trex = res_trex[0].data.evs

print("⟨Z_i⟩ with TREX:", val_trex)
⟨Z_i⟩ with TREX: [-0.92086303 -0.90253698 -0.91688854 -0.93308327 -0.91273953 -0.9221892
 -0.903782   -0.93046052 -0.90348934 -0.90284174 -0.89499677 -0.91630959
 -0.89508481 -0.92233292 -0.90497141 -0.91867138 -0.91421506 -0.91646851
 -0.9268364  -0.91669818]
Porównujemy tu średnie błędy bezwzględne z TREX i bez niego.
ideal = np.cos(7 * np.pi / 8)

mean_abs_error_no_trex = np.mean(np.abs(val_no_trex - ideal))
mean_abs_error_trex = np.mean(np.abs(val_trex - ideal))

print("The mean absolute error without TREX is: ", mean_abs_error_no_trex)
print("The mean absolute error with TREX is: ", mean_abs_error_trex)
The mean absolute error without TREX is:  0.05238453251128674
The mean absolute error with TREX is:  0.011980732757900719
zx = list(range(num_qubits))
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(zx, val_no_trex, c="blue", linestyle="-", label="No TREX", alpha=0.7)

## Add values with DD
ax.scatter(zx, val_trex, c="red", linestyle="-", label="With TREX", alpha=0.7)

# Add ideal reference line
ax.axhline(y=-0.924, color="black", linestyle="--", linewidth=2, label="Ideal ⟨Z⟩")

# Add labels and plot
ax.set_xlabel("Qubits")
ax.set_ylabel("<Z>")
ax.legend()
ax.set_title("<Z> in RX(7pi/8)|0> state with and without TREX")
ax.grid(True)

plt.show()
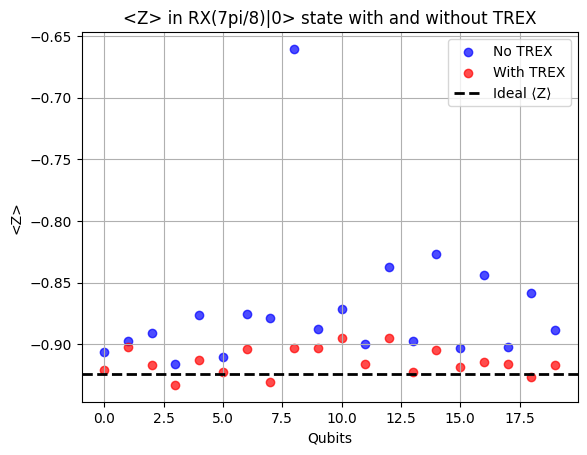
TREX wyraźnie pomógł. Wartość oczekiwana na każdym kubicie uległa poprawie, z jedynym wyjątkiem kubitu 16. Taki odstający wynik jest do przewidzenia. Ogólny efekt zastosowania TREX do obwodu możemy określić ilościowo, licząc średnie wartości.
mean_no_trex = sum(val_no_trex) / num_qubits
mean_trex = sum(val_trex) / num_qubits

print("Mean without TREX", mean_no_trex)
print("Mean with TREX", mean_trex)
Mean without TREX -0.8714950000000001
Mean with TREX -0.9137729590315635
Średnio TREX przybliżył nasze wyniki do wyników idealnych o około 2.9% i pozostawił nas z wynikiem, który średnio różni się od teoretycznego ideału zaledwie o 0.4%. To świetnie, a ta poprawa przy niskim narzucie to dokładnie powód, dla którego TREX jest domyślną metodą redukcji błędów w Estimator. Musimy jednak jeszcze raz podkreślić, że TREX usuwa obciążenie błędu odczytu, a nie koryguje wszystkich naszych błędów. Wybraliśmy stan początkowy, który miał duże szanse być dotknięty asymetrią odczytu. Efekt byłby inny, gdybyśmy przygotowali każdy kubit w innym stanie. Trywialnym argumentem, dlaczego tak musi być, jest rozważenie, co by się stało, gdybyśmy zostawili każdy kubit w stanie podstawowym . Nie byłoby wtedy możliwości zaobserwowania (ani skorygowania) asymetrii błędu odczytu między stanami i .
Ekstrapolacja do zerowego szumu (ZNE)
Ekstrapolacja do zerowego szumu (ZNE) jest jedną z najczęściej stosowanych technik redukcji błędów. Ogólna strategia jest też łatwa do zrozumienia, choć szczegóły jej implementacji są złożone. ZNE działa następująco:
-
Uruchamia docelowy obwód przy wielu "poziomach szumu" — modyfikacjach obwodu, które powodują skalowanie jego szumu w przewidywalny sposób
-
Szacuje interesującą obserwablę dla każdej skali szumu.
-
Ekstrapoluje z powrotem do zerowego szumu za pomocą modelu dopasowania (liniowego, wielomianowego, wykładniczego itd.).
Wynikiem jest oszacowanie tego, jaka byłaby wartość obserwabli w granicy zerowego szumu wynikającej z modelu ekstrapolacji.
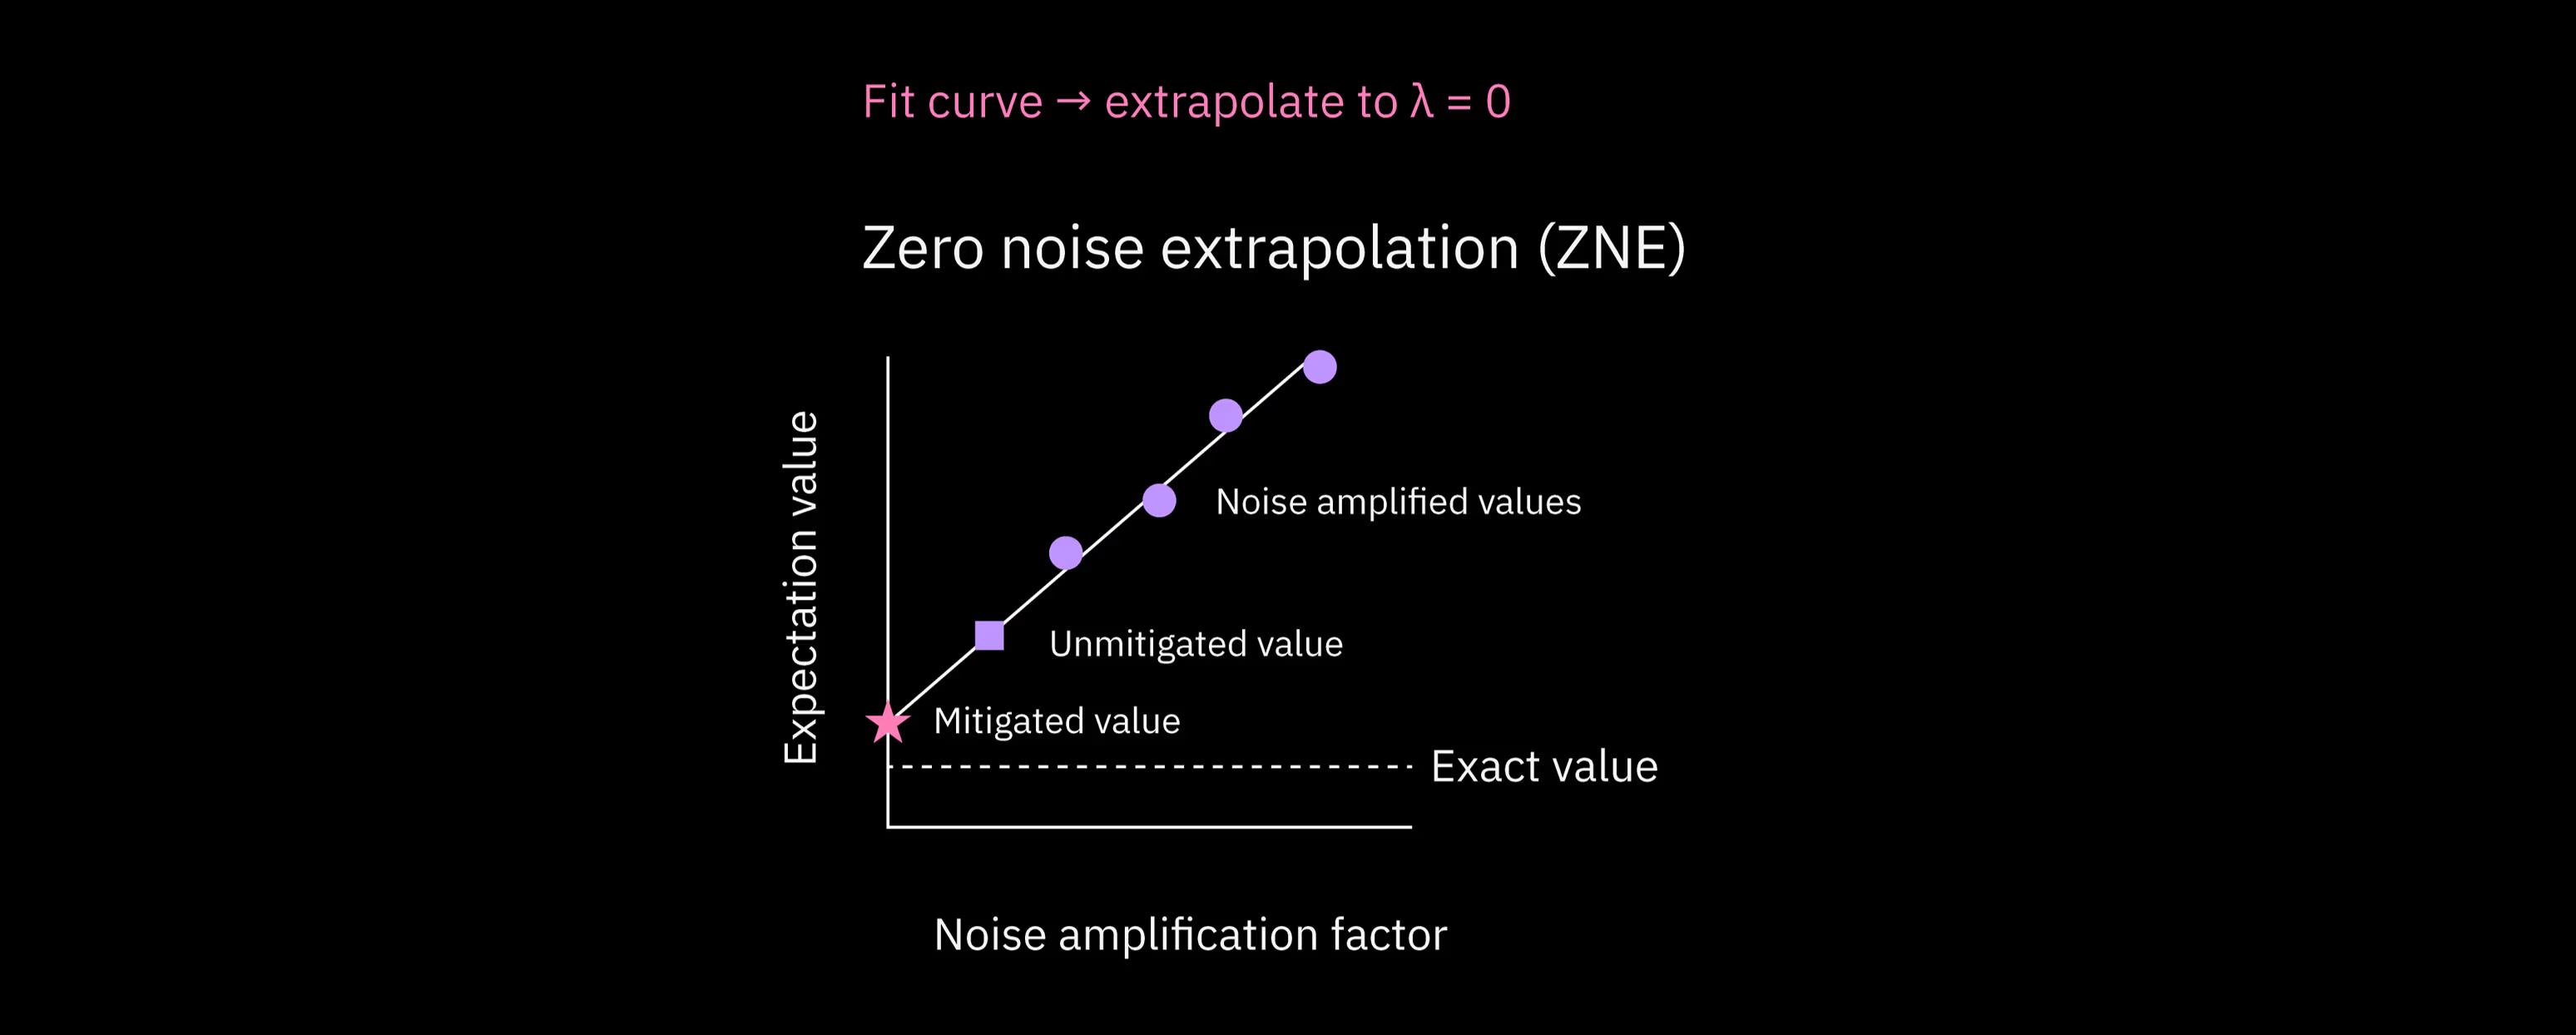
ZNE nie gwarantuje, że szum rośnie płynnie ani liniowo, gdy modyfikujemy obwody. Zamiast tego zakłada, że skalowanie szumu jest na tyle poprawne, by umożliwić ekstrapolację. Złożoność ZNE polega na tym, jak modyfikować obwody, aby jak najlepiej spełnić to założenie. W tej lekcji omówimy kilka podejść.
Skalowanie zasobów w ZNE
W ZNE narzut ma głównie charakter kwantowy. Oznacza to, że aby uzyskać wartości oczekiwane dla poziomów szumu, musisz przeprowadzić eksperyment na obwodach, każdy z wieloma strzałami (shots). Aby utrzymać stałą precyzję statystyczną, całkowita liczba próbek zwykle rośnie wraz z wprowadzaniem kolejnych obwodów ze skalowanym szumem.
Liczba badanych poziomów szumu, , zależy od metody użytej do skalowania szumu. Dla jednej prostej techniki skalowania szumu (zwanej "gate-folding", omówionej poniżej) wynosi zwykle od 3 do 5. Inna metoda (probabilistyczne wzmacnianie szumu (PNA)) dopuszcza niecałkowite współczynniki szumu i zazwyczaj daje niższe poziomy szumu niż gate-folding. Całkowity narzut skaluje się w przybliżeniu jak:
gdzie to bazowa liczba strzałów. Warto też pamiętać, że jeśli skalowanie szumu wymaga powtarzania bramek, głębokość obwodu może wzrosnąć o czynnik proporcjonalny do wartości skalowania szumu. Skalowanie szumu wynikające ze zwiększonej głębokości jest właśnie celem, ale miej na uwadze całkowitą głębokość.
ZNE dobrze nadaje się do problemów, w których spełnione są następujące warunki:
-
Potrzebujesz uniwersalnej metody redukcji błędów, skutecznej dla wielu rodzajów błędów.
-
Głębokość obwodu nie jest zbyt duża; ZNE zawodzi, gdy przeskalowany obwód staje się zbyt zaszumiony, by dało się go ekstrapolować.
-
Możesz zaakceptować umiarkowany narzut czasu wykonania w zamian za większą dokładność.
W praktyce czyni to ZNE idealnym dla wielu obwodów wariacyjnych, estymacji wartości oczekiwanych i innych algorytmów kwantowych bliskiej przyszłości. Jest zaimplementowane w Estimator za pomocą resilience_level = 2. Zauważ, że ZNE ekstrapoluje w przestrzeni, w której mamy jeden wynik jako funkcję szumu w całym obwodzie. Oznacza to, że nadaje się do problemów estymacji, ale nie do problemów próbkowania. Nie jest przeznaczone do pracy na rozkładach ciągów bitów.
Współczynniki szumu
Jak dokładnie możemy zwiększyć poziom szumu w obwodzie? Istnieją dwa główne sposoby, choć jest wiele wariantów.
-
Zastąp bramkę lub blok bramek przez . Ponieważ bramki na komputerach kwantowych są unitarne, wiemy, że , więc logicznie: . Jednak każde powtórzenie lub dodaje podobny lub identyczny błąd, co pozwala zwiększać poziomy szumu/błędu. Zauważ, że pokazana wyżej zamiana przenosi nas od pierwotnego szumu bramki (poziom szumu 1) do trzykrotnie wyższego poziomu szumu w (poziom szumu 3). W praktyce możemy powtórzyć dwie ostatnie bramki razy: , aby uzyskać poziom szumu . Nazywa się to gate folding i jest to bardzo powszechna technika skalowania szumu.
-
Istnieją inne metody zwiększania poziomu szumu, takie jak probabilistyczne wzmacnianie błędów (PEA). W PEA najpierw uczymy się odpowiedniego modelu szumu dla obwodu, zwykle wyrażonego jako kanał Pauliego. Następnie szum jest wzmacniany przez próbkowanie z przeskalowanej wersji tego wyuczonego kanału szumu. Dostosowując próbkowanie, można w sposób ciągły skalować efektywną siłę szumu, także do wartości niecałkowitych.
W praktyce gate folding może bardzo niezawodnie skalować błędy, ale może też prowadzić do bardzo głębokich obwodów. Jeśli potrzebujesz tylko trzech poziomów szumu (1, 3 i 5), oznacza to zwiększenie głębokości obwodu pięciokrotnie przy nadal rozsądnych wynikach. Dlatego jeśli twój docelowy obwód ma po transpilacji głębokość dwukubitową równą 60 lub więcej, PEA jest prawdopodobnie lepszym wyborem niż gate-folding.
Bramki można składać lokalnie (czyli powtarzać dla każdej bramki dwukubitowej zaraz po jej wystąpieniu) albo grupować w blok bramek i powtarzać cały blok (jak bramki ). Często składanie lokalne lepiej spełnia założenia ZNE, ale możliwe są oba sposoby.
Statystyczne traktowanie wyników ze skalowanym szumem w ZNE wymaga wielu niuansów. Na przykład przy pięciokrotnie wyższym poziomie szumu wyniki mają na pewno większą wariancję i są mniej wiarygodne. Czy należy je traktować z taką samą wagą jak punkty o niższym szumie? Nie. Jednak na potrzeby zobaczenia ZNE w działaniu pominiemy część tej złożoności w eksperymencie z modelem zabawkowym, w którym zbudujemy składane obwody ręcznie i wykonamy naiwną ekstrapolację z równymi wagami, aby zilustrować kluczowe kroki. Potem wykonamy eksperyment z użyciem funkcjonalności ZNE wbudowanej w Qiskit i zobaczymy, że radzi sobie ze składnikami złożoności, które pomijamy, znacznie lepiej.
ZNE ręcznie
Zaczynamy od wyboru obwodu kwantowego i obserwabli, dla których możemy obliczyć idealną wartość oczekiwaną przy braku szumu i błędów. Wybieramy stan GHZ z parzystą liczbą kubitów. Naszą obserwablą jest . Wybieramy ją z kilku powodów:
- Wartość oczekiwana jest w przypadku idealnym trywialna do obliczenia. Ponieważ liczba kubitów jest parzysta, albo dostajemy
1z każdego , pomnożone razem, albo dostajemy-1z każdego , pomnożone razem parzystą liczbę razy. - Będzie ona dość wrażliwa na błędy i szum, ponieważ pojedynczy błąd na jednym kubicie może odwrócić całkowity wynik danego strzału z +1 na -1.
- Wartość oczekiwana jest daleka od 0. ZNE może napotkać trudności, gdy idealna wartość oczekiwana jest bardzo bliska zera, ponieważ wysokie poziomy szumu mają tendencję do losowania wyników, czyniąc je równie często dodatnimi jak ujemnymi. W rezultacie wysokie wartości szumu dają wartości bliskie idealnym; może to bardzo utrudnić ekstrapolację.
Mając tę motywację na uwadze, zbudujmy nasze obwody.
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
num_qubits = 10  # must be even

# # Noise amplification factors used for folding (2* integer +1 for gate folding)
noise_steps = [1, 3, 5]
ghz_amp = []

for j in noise_steps:
    qc = QuantumCircuit(num_qubits)
    qc.h(0)
    # Since CX^2 = I, odd repetitions implement folded versions of the gate.
    for i in range(num_qubits - 1):
        for gates in range(j):
            qc.cx(i, i + 1)
    qc.barrier()
    ghz_amp.append(qc)
Zwróć uwagę na subtelność: tutaj . Mimo że gate folding przedstawiano jako składanie operatorów postaci , tutaj ta sama struktura wygląda jak CNOT CNOT CNOT.
Upewnijmy się, że nasz obwód jest rzeczywiście zwykłym obwodem GHZ:
ghz_amp[0].draw("mpl")
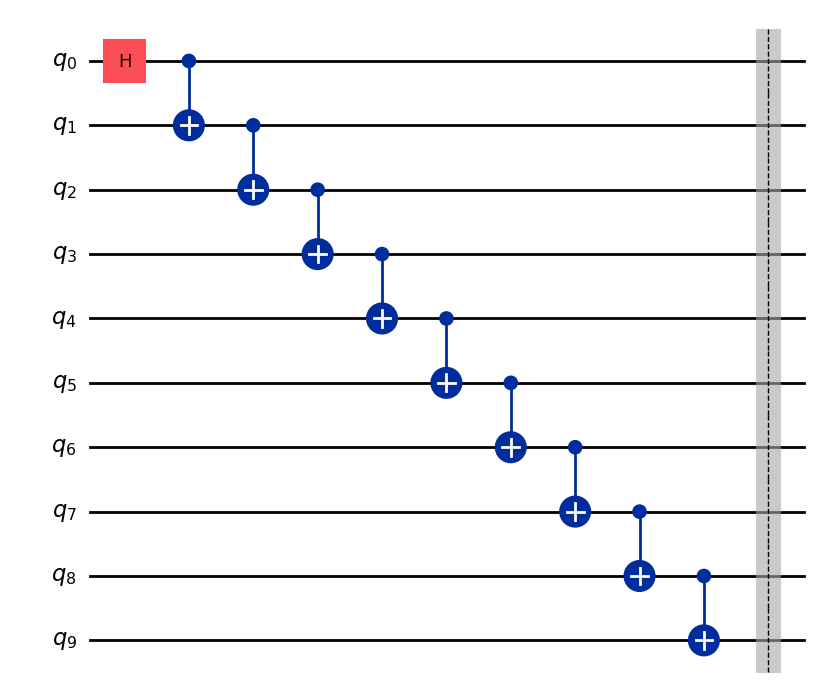
Możesz przejrzeć pozostałe obwody, aby sprawdzić, czy mają oczekiwaną strukturę.
Teraz budujemy nasze obserwable.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
observables = []
for j in range(len(noise_steps)):
    observables.append(observable)
Budujemy pass manager i stosujemy go do naszych obwodów. Następnie bierzemy układy (layouty) i stosujemy je do naszych obserwabli.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=0,
)

qcs_transpiled = []
obs_transpiled = []

for j in range(len(ghz_amp)):
    # Transpile the circuit
    qc_pm = pm.run(ghz_amp[j])
    qcs_transpiled.append(qc_pm)
    # Extract the final layout
    layout = qc_pm.layout
    # Apply the layout to the observable
    obs_transpiled.append(observable.apply_layout(layout))
Sformatuj pubs.
pubs = [(qc, obs) for qc, obs in zip(qcs_transpiled, obs_transpiled)]
Teraz uruchamiamy Estimator. Chcemy skupić się na roli ZNE, więc moglibyśmy ustawić resilience_level = 0, aby nie mieszać efektów twirlingu z efektem ZNE. Chcemy jednak także porównać nasze ZNE "ręczne" z ustawieniami ZNE wbudowanymi w Qiskit, które obejmują twirling. Dlatego ustawiamy tutaj resilience_level = 1. Ustawienie resilience_level = 2 wywołuje ustawienia ZNE z Qiskit, których wkrótce użyjemy.
# This took 21 sec on ibm_fez. Your actual runtime might vary.
options = EstimatorOptions(resilience_level=1)

estimator = Estimator(
    mode=backend_real,
    options=options,
)

job = estimator.run(pubs)

res = job.result()
Teraz wypisujemy poziomy szumu i wartości oczekiwane.
# We save this for later comparisons
value_no_zne = res[0].data.evs

# Print all values used for extrapolation
print("Noise level 1: ", res[0].data.evs)
print("Noise level 3: ", res[1].data.evs)
print("Noise level 5: ", res[2].data.evs)
Noise level 1:  0.8327970939283861
Noise level 3:  0.5612869745718734
Noise level 5:  0.3130254281266217
To jest część, w której jesteśmy najbardziej nonszalanccy: wykonujemy dopasowanie liniowe do tych danych bez zwracania uwagi na wariancję każdej uzyskanej wartości i bez próby teoretycznego przewidzenia, czy dopasowanie musi być liniowe. Ponownie, wbudowane ZNE radzi sobie znacznie lepiej niż to, co robimy ręcznie.
# Data
noise_factors = np.array([1, 3, 5])
values = np.array([res[0].data.evs, res[1].data.evs, res[2].data.evs])

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.12994291645044112
Zero-noise extrapolated value: 0.9588652482269501
Zanim przejdziemy do interpretacji, wykonujemy wykres.
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Zero-noise estimate")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
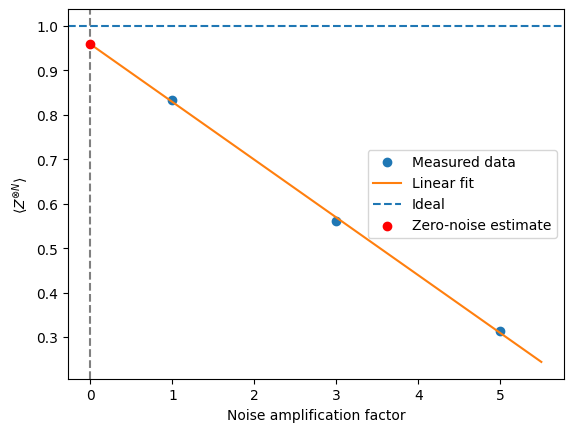
W chwili tworzenia tej lekcji z ekstrapolacji do przypadku zerowego szumu otrzymaliśmy wartość oczekiwaną 0.959. Twoje wartości mogą się różnić. Jest to wyraźnie lepsze niż wartość oczekiwana surowego obwodu, wynosząca 0.83, czyli około 13% bliżej wartości idealnej. Widać jednak również, że używamy jednego punktu danych, w którym wartość oczekiwana spadła do 0.31. Oczywiście ten punkt danych jest gorszej jakości. Gdyby w naszym przybliżeniu liniowym nadać mu mniejszą wagę, a prostą dopasować bardziej do pierwszych dwóch punktów danych, widzimy, że ekstrapolowane oszacowanie zerowego szumu byłoby wyższe (bliższe wartości idealnej). Tego rodzaju względy są obsługiwane automatycznie w ZNE wbudowanym w Estimator.
ZNE wbudowane w Estimator
Zobaczmy teraz, co się stanie, gdy użyjemy funkcjonalności ZNE wbudowanej w Estimator. Zaczynamy od zdefiniowania prostego obwodu GHZ, bez żadnego gate foldingu.
num_qubits = 10  # must be even

qc = QuantumCircuit(num_qubits)
qc.h(0)

for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=10, num_clbits=0, params=[]), qubits=(<Qubit register=(10, "q"), index=0>, <Qubit register=(10, "q"), index=1>, <Qubit register=(10, "q"), index=2>, <Qubit register=(10, "q"), index=3>, <Qubit register=(10, "q"), index=4>, <Qubit register=(10, "q"), index=5>, <Qubit register=(10, "q"), index=6>, <Qubit register=(10, "q"), index=7>, <Qubit register=(10, "q"), index=8>, <Qubit register=(10, "q"), index=9>), clbits=())
Definiujemy tę samą obserwablę co wcześniej.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
Ponownie definiujemy pass manager, używając optimization_level = 1. Do tego wyboru wrócimy poniżej.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)
Dokonaj transpilacji obwodu i zastosuj układ (layout) do obserwabli.
# Transpile the circuit
qc_transpiled = pm.run(qc)

# Extract the final layout
layout = qc_transpiled.layout

# Apply the layout to the observable
obs_transpiled = observable.apply_layout(layout)
Uruchamiamy Estimator z użyciem ZNE i twirlingu i porównujemy wyniki z naszą ręczną implementacją ZNE. W szczególności porównujemy je z wynikiem bez ZNE (value_no_zne).
# This used 18 sec on ibm_fez. Your actual QPU time might vary.

options_zne = {
    "resilience_level": 2,
    "resilience": {
        "zne": {
            "noise_factors": [1, 3, 5],
        }
    },
    "twirling": {
        "enable_gates": True,
        "enable_measure": True,
        "num_randomizations": "auto",
    },
}

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
Wartości dla każdego współczynnika szumu możemy pobrać za pomocą składni job_zne.result()[0].data.evs_noise_factors. Podobnie jak wcześniej, moglibyśmy naiwnie użyć tych wyników do dopasowania liniowego i ekstrapolacji do przypadku zerowego szumu, ale estimator z resilience_level = 2 już wykonał to lepiej, uwzględniając wariancję i inne czynniki. Poniżej pokazujemy, co dałaby ekstrapolacja liniowa, oraz co faktycznie dało wbudowane ZNE.
# Data
noise_factors = np.array([1, 3, 5])
values_qiskit_zne = np.array(job_zne.result()[0].data.evs_noise_factors)

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values_qiskit_zne, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.11745451044574956
Zero-noise extrapolated value: 0.9045922788100509
print("Exp val ideal: 1.0")
print("Exp val with no ZNE: ", value_no_zne)
print("Exp val with ZNE: ", value_zne)
print("Fractional improvement: ", (value_zne - value_no_zne) * 100 / 1.0, "%")
Exp val ideal: 1.0
Exp val with no ZNE:  0.8327970939283861
Exp val with ZNE:  0.9877508802932561
Fractional improvement:  15.495378636487 %
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Linear")
plt.scatter(0, value_zne, color="black", zorder=3, label="Proper ZNE")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
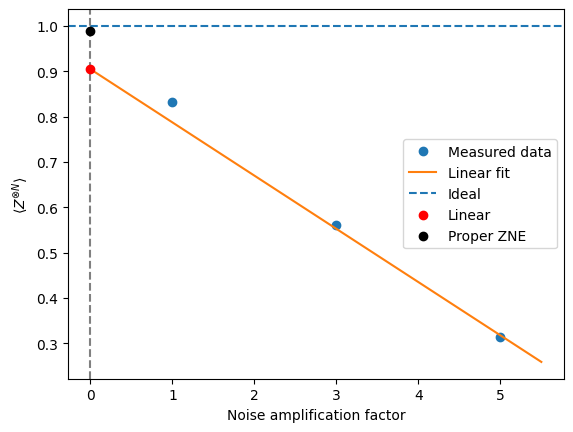
Widzimy, że wbudowane ZNE poprawiło nasze oszacowanie o ponad 15% i działało sporo lepiej niż nasza próba ręczna.
Zanim przejdziemy dalej, zauważ, że w całej tej eksploracji ZNE ustawialiśmy optimization_level = 1 w pass managerze. Wyższe poziomy optymalizacji zmniejszają błąd, a czasem zmniejszenie błędu może sprawić, że błędy skalują się mniej przewidywalnie. Jak to często bywa, trzeba znaleźć równowagę: zmniejszać błędy, chyba że celowo zwiększamy je o znany czynnik.
Łączenie metod
ZNE opiera się na następujących elementach:
-
Dobrze zdefiniowany parametr skalowania szumu
-
Dostatecznie płynne i przewidywalne skalowanie wartości oczekiwanych z
-
Ten sam efektywny kanał szumu, o różnych natężeniach
-
Brak wprowadzonego obciążenia, które nie skaluje się z
ZNE łączy się bez problemów z technikami, które usuwają obciążenia nieskalujące się (jak M3) lub czynią szum bardziej regularnym (jak twirling), ale koliduje z technikami, które próbują całkowicie znieść szum (PEC) lub dynamicznie go kształtują (DD).
W szczególności M3 zajmuje się wyłącznie błędami pomiaru/odczytu, które w praktyce można traktować oddzielnie od błędów bramek (będących przedmiotem procesów skalowania błędów w ZNE). M3 jest w dużej mierze niezależne od gate foldingu; można je bez problemu połączyć z ZNE. TREX jest bardzo podobny i można go łączyć z ZNE.
Pauli twirling, w przeciwieństwie do M3 i TREX, koncentruje się na bramkach. Pamiętaj jednak, że Pauli twirling nie łagodzi bezpośrednio błędu/szumu; zamiast tego zmienia go tak, aby był bardziej przewidywalny. Pauli twirling może w rzeczywistości być korzystny dla procesu ZNE, sprawiając, że błędy bramek skalują się bardziej liniowo, a ekstrapolacja jest dzięki temu dokładniejsza.
Dynamiczne rozprzęganie (DD) jest bardziej złożone. DD dynamicznie zmienia zachowanie szumu, częściowo znosząc pewne błędy przez dodanie sekwencji bramek. Jeśli da się skonstruować obwody tak, aby DD zachowywało się tak samo nawet przy składaniu bramek lub bloków, to w zasadzie można połączyć ZNE i DD, ale w praktyce DD czasem zakłóca skalowanie. Jeśli chcesz je połączyć, warto rozważyć następujące kwestie:
- Czy DD jest stosowane spójnie na wszystkich poziomach szumu?
- Czy składanie zachowuje strukturę DD?
- Czy wynikowe skalowanie szumu nadal zachowuje się monotonicznie?
Ostatnia metoda redukcji błędów, którą omówimy jako samodzielne podejście, nie jest zgodna z ZNE: probabilistyczne znoszenie błędów.
Probabilistyczne znoszenie błędów (PEC)
W przeciwieństwie do ZNE lub redukcji błędów pomiaru, PEC próbuje znosić szum na poziomie bramek, odtwarzając w wartości oczekiwanej kanał idealny. Probabilistyczne znoszenie błędów (PEC) jest najpotężniejszą i najdroższą techniką redukcji błędów omawianą w tej lekcji. PEC opiera się na jawnym odwróceniu kanału szumu, przeprowadzonym statystycznie, a nie fizycznie. PEC działa następująco:
-
Charakteryzuje model szumu w terminach bazy "operacji błędu".
-
Wyraża odwrotność kanału szumu jako rozkład quasi-prawdopodobieństwa na operacjach fizycznych.
-
Próbkuje z tego rozkładu podczas wykonywania obwodu, aby statystycznie skonstruować nieobciążone oszacowanie idealnego obliczenia.
Koncepcyjnie PEC przypomina wirtualną korekcję błędów — "cofa" szum, łącząc zaszumione operacje w starannie ważone losowe wzorce. Proceduralnie jednak PEC nie jest blisko związany z korekcją błędów ani kodami wykrywania. Nieobciążone oszacowanie idealnej, wolnej od szumu wartości oczekiwanej przez PEC odbywa się kosztem bardzo dużego narzutu próbkowania i silnej zależności od dokładnej charakteryzacji szumu.
Na komputerach kwantowych IBM PEC najlepiej postrzegać jako narzędzie precyzyjne, a nie uniwersalną warstwę redukcji błędów: jest najbardziej odpowiedni dla małych obwodów lub małych fragmentów większych obwodów, zadań benchmarkingowych i badań wymagających wysokiej dokładności, w których wysoki narzut kwantowy jest akceptowalny.
Charakteryzacja kanału szumu
W PEC każda idealna bramka w obwodzie kwantowym jest modelowana jako idealny kanał unitarny, po którym następuje proces szumu. Niech oznacza macierz gęstości stanu kwantowego. Idealną bramkę reprezentuje macierz unitarna , która indukuje kanał kwantowy:
Na rzeczywistym sprzęcie ta idealna ewolucja jest zaburzana przez szum. Fizyczną implementację bramki modelujemy jako efektywny kanał zaszumiony:
gdzie jest kanałem szumu opisującym stochastyczne błędy związane z bramką. W całej tej dyskusji , i są odwzorowaniami liniowymi działającymi na operatorach gęstości. Idealny kanał jest unitarny i odwracalny, natomiast kanał szumu (a zatem i ) jest odwzorowaniem całkowicie dodatnim i zachowującym ślad (CPTP).
PEC zakłada, że kanał szumu jest znany lub w przybliżeniu znany. Na sprzęcie IBM Quantum informacje te uzyskuje się zazwyczaj z danych kalibracyjnych urządzenia, z częstości błędów wywnioskowanych z eksperymentów benchmarkingowych oraz z uproszczonych modeli szumu, takich jak aproksymacje Pauliego lub depolaryzacyjne dla małych zbiorów bramek. Choć PEC nie wymaga idealnie dokładnego modelu szumu, jego skuteczność gwałtownie spada, gdy zakładany kanał szumu odbiega od rzeczywistego zachowania sprzętu.
Dekompozycja quasi-probabilistyczna odwrotnego kanału szumu
Główną ideą PEC jest znoszenie wpływu szumu w wartości oczekiwanej przez skonstruowanie stochastycznego przybliżenia odwrotności kanału szumu. Formalnie celem jest zastosowanie odwzorowania liniowego, które w przybliżeniu cofa , tak aby:
w wartości oczekiwanej po wielu wykonaniach obwodu.
Odwrotność jest tu zdefiniowana jako algebraiczna odwrotność traktowanego jako liniowy superoperator działający na operatorach. Odwrotność ta istnieje tylko wtedy, gdy ma pełny rząd; nieodwracalnych procesów szumu nie da się dokładnie zredukować za pomocą PEC.
Gdy odwrócenie jest możliwe, PEC wyraża odwrotny kanał szumu jako kombinację liniową fizycznie implementowalnych operacji:
Tutaj każde jest zaszumioną operacją, którą można wykonać na sprzęcie (zazwyczaj natywne bramki lub krótkie sekwencje bramek), a rzeczywiste współczynniki tworzą rozkład quasi-prawdopodobieństwa. W przeciwieństwie do zwykłych prawdopodobieństw współczynniki mogą być ujemne lub przekraczać 1.
Norma quasi-prawdopodobieństwa:
określa ilościowo koszt odwrócenia szumu. Dla każdego nietrywialnego kanału szumu . Na sprzęcie IBM Quantum dekompozycję tę wykonuje się zazwyczaj:
- dla każdej bramki lub małego zbioru bramek,
- przy założeniu ograniczonych modeli szumu (często aproksymacji diagonalnych w bazie Pauliego),
- z użyciem operacji natywnych dla danego backendu i ograniczeń harmonogramowania.
Rekonstrukcja idealnego obwodu metodą Monte Carlo
Aby oszacować wartość oczekiwaną obserwabli , PEC używa próbkowania Monte Carlo opartego na powyższej dekompozycji. Dla każdego wystąpienia zaszumionej bramki w obwodzie stosuje się następującą procedurę:
-
Losowo wybierz operację z prawdopodobieństwem:
-
Przypisz wagę klasyczną:
-
Wykonaj otrzymany losowy zaszumiony obwód na backendzie kwantowym.
-
Pomnóż zmierzony wynik przez iloczyn wszystkich zgromadzonych wag.
-
Uśrednij ważone wyniki po wielu wykonaniach obwodu.
Otrzymany estymator spełnia
o ile model szumu dokładnie opisuje sprzęt. PEC nie wprowadza zatem żadnego systematycznego obciążenia w wartości oczekiwanej, ale zastępuje obciążenie dużą wariancją statystyczną. Każde uruchomienie daje zaszumione, ale ważone oszacowanie; dopiero po uśrednieniu wielu takich uruchomień wyłania się idealna wartość oczekiwana.
Interpretacja koncepcyjna
PEC bywa opisywany jako wirtualna korekcja błędów. Choć to sformułowanie nie jest całkiem błędne, nie należy mylić go z prawdziwą kwantową korekcją błędów. PEC nie obejmuje kodowania logicznego, ekstrakcji syndromu ani sprzężenia zwrotnego w czasie rzeczywistym. Błędy nie są zapobiegane ani korygowane podczas wykonywania obwodu.
Zamiast tego PEC znosi szum statystycznie, łącząc wiele zaszumionych realizacji obwodu ze znakowanymi wagami klasycznymi, tak aby błędy znosiły się dopiero po klasycznym przetwarzaniu końcowym. Informacja nie jest chroniona podczas wykonania; idealne wyniki są rekonstruowane po fakcie.
Skalowanie zasobów i koszt
Dominujący koszt PEC wynika ze wzmocnienia wariancji. Wariancja estymatora PEC skaluje się jak:
co oznacza:
To skalowanie jest fundamentalne i nie można go poprawić przez klasyczne przetwarzanie końcowe.
W obwodach zawierających wiele zaszumionych bramek każda bramka wnosi czynnik , przez co całkowita norma quasi-prawdopodobieństwa rośnie w przybliżeniu multiplikatywnie:
gdzie jest głębokością obwodu. Na sprzęcie IBM Quantum prowadzi to zazwyczaj do wykładniczego wzrostu kosztu próbkowania wraz z głębokością obwodu, ze szczególnie silną wrażliwością na błędy bramek dwukubitowych. To skalowanie wyznacza praktyczne ograniczenia stosowalności PEC.
PEC jest obecnie praktyczny tylko wtedy, gdy spełniony jest jeden lub wszystkie z poniższych warunków:
-
Obwody są bardzo małe lub płytkie (często bramek),
-
Modele szumu są proste i dobrze zwalidowane (na przykład szum Pauliego),
-
Wysoki koszt statystyczny jest akceptowalny,
-
Celem jest dokładność, a nie przepustowość.
Z tego powodu PEC stosuje się często do:
-
Wyodrębnionych podobwodów w większych przepływach pracy,
-
Kroków ewolucji w krótkim czasie,
-
Procedur przygotowania stanu lub pomiaru,
-
Eksperymentów benchmarkingowych i walidacyjnych.
Stos oprogramowania IBM (IBM Quantum Compute i narzędzia do redukcji błędów) odzwierciedla to, traktując PEC jako wyspecjalizowaną opcję, a nie domyślną warstwę redukcji błędów.
Typowe przypadki użycia PEC obejmują:
-
Precyzyjny benchmarking sprzętu kwantowego,
-
Weryfikacja małych algorytmów kwantowych,
-
Wysokodokładna chemia kwantowa na zredukowanych układach,
-
Krzyżowa weryfikacja ZNE lub innych metod mitygacji.
Relacja PEC do innych metod mitygacji
Wiele innych technik mitygacji poświęca dokładność na rzecz skalowalności; PEC robi dokładnie odwrotnie, stawiając dokładność ponad wszystko.
Ponieważ PEC może być użyty tylko na podobwodzie, szczególnie ważne jest tutaj pytanie, jakie inne metody mitygacji można z nim łączyć. Aby jasno ocenić zgodność z PEC, warto podzielić techniki według tego, co robią z szumem. Rozważ te ogólne kategorie:
-
Kasowanie szumu - próba odwrócenia kanałów błędów
-
Skalowanie szumu - celowe zwiększanie szumu w celu ekstrapolacji
-
Przekształcanie szumu - zmiana struktury lub widma szumu
-
Usuwanie obciążenia (bias) - korekta błędów, które nie skalują się z szumem bramek
PEC mieści się wprost w kategorii (1). Każdą metodę, która zmienia lub przeskalowuje kanał szumu, trzeba dokładnie przeanalizować.
Tabela podsumowująca (ogólna)
| Technika | Zgodna z PEC | Uwagi |
|---|---|---|
| ZNE | Nie | Cofanie a skalowanie, a czasem dopasowywanie błędu |
| Pauli twirling | Tak (z ostrożnością) | Wpływa na zachowanie błędów, ale może ułatwić ich poznanie |
| TREX | Tak | Brak nakładania się w przepływie pracy. W pełni zgodne. |
| Dynamical decoupling | Zwykle nie | Zmienia kanał błędów |
PEC i ZNE dotyczą tych samych źródeł błędów (błędów bramek), ale opierają się na wzajemnie niezgodnych założeniach lub przepływach pracy, albo na jednych i drugich. Na przykład w ZNE zakładamy, że błąd można rozwinąć w parametrze :
oraz że błąd można skutecznie skalować, aby odwzorować to rozwinięcie. PEC cofałby właśnie ten błąd, na którym opieramy skalowanie. Parametr straciłby sens. Można o tym myśleć też tak:
-
Zastosowanie ZNE przed PEC zmienia kanał szumu, który próbujesz odwrócić.
-
Zastosowanie PEC przed ZNE usuwa właśnie ten szum, na którym ZNE opiera ekstrapolację.
PEC i ZNE należy traktować jako alternatywne paradygmaty mitygacji błędów, a nie składalne warstwy. Porównywanie ich obok siebie jest pouczające, natomiast łączenie ich nie.
PEC i Pauli twirling są na ogół zgodne i często korzystne razem. Twirling może pomóc PEC, ponieważ przekształca błędy koherentne w stochastyczne błędy Pauliego. Upraszcza to kanał szumu, ułatwiając jego reprezentację i odwrócenie. Dla PEC jest to niezwykle cenne z następujących powodów:
-
Dekompozycje quasi-probabilistyczne są znacznie prostsze dla kanałów Pauliego
-
Norma quasi-probabilistyczna jest często znacznie mniejsza
-
Wariancja próbkowania jest zmniejszona
Wiele demonstracji PEC zakłada szum po Pauli twirlingu lub wbudowuje go. Warto podkreślić, że Pauli twirling sam w sobie nie łagodzi błędów; przekształca szum do postaci, z którą probabilistyczne kasowanie błędów radzi sobie wydajniej.
PEC można i należy łączyć z TREX. Podejścia te są w pełni zgodne i pełnią ortogonalne role. TREX działa wyłącznie na pomiar, usuwa obciążenie odczytu za pomocą losowych twirli kanału pomiarowego i nie wpływa na szum bramek ani dynamikę obwodu. PEC działa na szum bramek. Ponieważ błąd pomiaru jest addytywny, a nie kompozycyjny, jest niezależny od sekwencji bramek. Stosowanie TREX razem z PEC jest bezpieczne i często pożądane.
Kolejność tych metod jest taka, jakiej można się spodziewać:
- Wykonaj obwód zrandomizowany przez PEC
- Zastosuj TREX, aby złagodzić błąd odczytu
- Zastosuj ważenie PEC i uśrednianie
PEC i DD są na ogół niezgodne, chyba że charakteryzacja szumu użyta dla PEC jest wykonywana przy aktywnym DD. PEC zakłada, że jest stacjonarny, powtarzalny i da się go dokładnie scharakteryzować. DD jawnie przekształca kanał szumu w czasie, modulując oddziaływania układu z otoczeniem i wprowadzając nietrywialne efekty czasowe impulsów. W rezultacie efektywny szum z DD nie jest tym samym kanałem co bez DD. Komplikuje to dodatkowo fakt, że kanał szumu może silnie zależeć od harmonogramu obwodu. W efekcie odwrócenie szumu staje się źle zdefiniowane lub nieprawidłowe.
Teoretycznie możliwe jest scharakteryzowanie szumu przy aktywnym DD i zbudowanie na tej podstawie modelu PEC, ale jest to bardzo zaawansowane i obecnie nie jest to zalecany przepływ pracy.
Ręczne stosowanie PEC
PEC jest złożony i nie zaleca się implementowania go ręcznie. Mimo to chcemy przejść przez matematykę podstawowego zastosowania na pojedynczym kubicie, aby zrozumieć, jakie kroki obejmuje ten proces. Wybieramy stan mieszany, ale nietrywialny, aby wyraźnie zobaczyć efekty numeryczne.
Weźmy kubit, który powinien być w stanie czystym
Idealna macierz gęstości to:
Wybraliśmy tę macierz gęstości, ponieważ nie jest diagonalna i dotyczy tylko pojedynczego kubitu, więc można ją łatwo zbadać „ręcznie".
Stosujemy teraz bardzo prosty, ale realistyczny model szumu: jednokubitowy kanał depolaryzacyjny o małej sile .
Aby rachunki były przyjazne, przyjmij . Ten kanał jest całkowicie dodatni i zachowuje ślad (CPTP), tak jak powinien. Jest to realistyczny kanał szumu dla prawdziwego sprzętu, a przynajmniej realistyczny do opisu części szumu. Co więcej, ten kanał szumu jest analitycznie odwracalny jako odwzorowanie liniowe. Innymi słowy, istnieje macierz odwrotna, ale to nie znaczy, że odpowiada ona fizycznemu kanałowi CPTP, a już na pewno nie odpowiada operacji unitarnej, którą można zaimplementować na sprzęcie.
Teraz stosujemy nasz kanał depolaryzacyjny do jednokubitowej macierzy gęstości i otrzymujemy:
Dla : oraz .
So:
Stosując to do naszego stanu:
Obliczmy jawnie:
Jest to nadal fizyczna macierz gęstości i nadal ma ślad równy jeden — ale jest teraz bardziej mieszana.
Teraz obliczamy idealny kanał odwrotny, będąc w pełni przygotowanymi na możliwość, że może nie być fizyczny. Sprawdzimy, czy jest. Matematycznie odwrotne odwzorowanie liniowe ma postać:
Gdyby to odwrotne działanie samo było poprawnym kanałem fizycznym, kusiłoby nas, aby spróbować zaimplementować je dokładnie. Oczywiście nadal musielibyśmy ustalić, jak zaimplementować je za pomocą operacji unitarnych i kroków klasycznych, ale celem byłoby jego zaimplementowanie. Okazuje się jednak, że to odwzorowanie nie jest CPTP i na ogół nie ma gwarancji, że takie odwrotne odwzorowania będą CPTP. Jest to kluczowe dla naszej dyskusji, ponieważ właśnie dlatego istnieje PEC.
Możesz zauważyć, że nie jest CPTP, już na pierwszy rzut oka. Niezawodnym sprawdzeniem jest zastosowanie go do macierzy gęstości i zobaczenie, czy zwraca wyniki fizyczne. Zostawiamy to jako ćwiczenie sprawdzające zrozumienie.
Sprawdź swoje zrozumienie
Sprawdź, czy powyższe odwrotne odwzorowanie jest CPTP, stosując je do nowej macierzy gęstości:
Zinterpretuj wyniki jako fizyczne lub niefizyczne.
Odpowiedź
Jako fizyczna macierz gęstości odpowiada to klasycznemu prawdopodobieństwu większemu niż 1, że układ jest w stanie , oraz ujemnemu prawdopodobieństwu bycia w stanie . Wyraźnie to odwzorowanie może dawać bezsensowne macierze gęstości. Ponadto, na podstawie oględzin widać, że wartości własne otrzymanej macierzy gęstości wynoszą 1.0625 i -0.0625, co oznacza, że nie wszystkie wartości własne są dodatnie. Zatem odwzorowanie nie jest „całkowicie dodatnie", czyli „CP" w CPTP.
Sprawdź swoje zrozumienie
Sprawdź przez jawne obliczenie, że powyższa operacja odwrotna cofa kanał szumu i zwraca stan bez szumu.
Odpowiedź
Zastosuj ją do zaszumionego stanu:
Jest to dokładnie stan początkowy (z dokładnością do zaokrągleń).
Powtórzmy, aby było absolutnie jasne: nie możemy dokładnie odwrócić kanału szumu; odwrotność nie jest CPTP ani poprawnym kanałem fizycznym. Możemy jednak skutecznie odwrócić kanał jako kombinację liniową kanałów fizycznych.
Dla kanału depolaryzacyjnego:
gdzie: itd.
Odwrotność można zapisać jako:
with:
-
= fizycznie implementowalne kanały Clifforda
-
= quasi-prawdopodobieństwa
-
Some
To jest główna idea PEC:
-
Próbkuj kanały zgodnie z ∣
-
Dołączaj znaki do wyników pomiarów
-
Wartości oczekiwane zbiegają do wartości bez szumu
Stosujemy PEC „ręcznie" do oszacowania , używając macierzy gęstości , i sprawdzamy, czy uda się odtworzyć wyniki dla . Dla oczekujemy:
Zauważ też, że dla zaszumionej macierzy gęstości otrzymujemy:
To właściwy rząd wielkości, ale wyraźnie daleko od przypadku idealnego.
Teraz krok po kroku pokażemy, jak za pomocą procesu PEC można odtworzyć nieobciążoną wartość oczekiwaną z zaszumionej macierzy gęstości. W prawdziwych przepływach pracy jest to probabilistyczne i zautomatyzowane. W tym przepływie „ręcznym" wybierzemy wartości probabilistyczne, które są realistyczne, ale może wygodne dla naszej prezentacji. Nie należy tego traktować jako twierdzenia, że PEC jest doskonały. Ma to jedynie pokazać wiarygodny scenariusz, który mógłby się zdarzyć wewnątrz pakietów PEC.
Przypomnij sobie, że nasz kanał szumu ma postać:
Odwrotność można zapisać (dokładnie):
based on symmetry of the transformation and the completeness of the Pauli operators. Inverting the noise channel somehow in the estimation process should yield an estimator that is unbiased and normalized. To do this, we must at least determine the coefficents and and then think about how to implement the inverse transformation. When done by a noise learner, the inversion of this noise channel would be done at the channel level, independent of a specific case like our density matrix. The coefficients and would come from this inversion.
W tym wprowadzeniu prościej jest skupić się na wpływie kanału na naszą macierz gęstości. Pozwala to pracować ze znanymi obiektami, takimi jak macierze gęstości i wartości oczekiwane. W tym celu zastanówmy się, co musi być prawdą o skutkach tej operacji odwrotnej dla naszego procesu estymacji: estymator tworzony przez PEC musi być znormalizowany i nieobciążony. Odpowiada to dwóm warunkom:
-
Normalizacja: Aby ta operacja nie zmieniała skali obserwabli, wymagamy, by . Aby zrozumieć, dlaczego tak jest, możemy rozważyć działanie odwrotności na macierz gęstości albo jej działanie na wartość oczekiwaną czegoś trywialnego, jak sama .
-
Kalibracja: W prawdziwym przepływie pracy używamy obwodów kalibracyjnych, aby poznać zachowanie szumu na poziomie bramek. Następnie wykorzystujemy wiedzę o szumie na poziomie bramek i liniowość wartości oczekiwanych, aby zastosować poznany model szumu do większego obwodu. W naszym przypadku zaczęliśmy od sztucznej wiedzy, że idealna wartość oczekiwana to . Ale bardzo łatwo byłoby wymyślić stan, dla którego teoretycznie wiemy, że to jest wartość idealna, a następnie użyć rzeczywistych pomiarów do kalibracji. Kluczowe jest to, że w PEC zazwyczaj nie uczy się pełnego modelu szumu całego obwodu. Zamiast tego uczy się lokalnych modeli szumu dla poszczególnych bramek lub warstw obwodu i używa się ich do skonstruowania dekompozycji quasi-probabilistycznej.
Używamy tych warunków do wyznaczenia i . Rozważamy ansatz
and apply it to an arbitrary single-qubit density matrix .
Przypomnij sobie, że kanały Pauliego działają przez sprzężenie:
Zastosowanie do daje:
Biorąc ślad, otrzymujemy:
Każdy operator Pauliego jest unitarny, więc sprzężenie zachowuje ślad:
Therefore,
Aby estymator PEC był znormalizowany, efektywne odwzorowanie odwrotne musi zachowywać ślad wszystkich macierzy gęstości. To znaczy, wymagamy:
Wynika z tego warunek normalizacji:
Ale w naszym przypadku daje to warunek:
Teraz używamy informacji kalibracyjnych, aby powiązać zaobserwowaną wartość oczekiwaną ze znaną wartością idealną.
Or equivalently,
Rozwiązując nasze dwa warunki względem i , otrzymujemy:
Te współczynniki sumują się do 1, ale jeden z nich jest ujemny.
Możemy odzyskać idealną wartość oczekiwaną, losowo modyfikując obwód, mierząc, mnożąc wynik przez ważoną wagę ze znakiem i uśredniając. W szczególności nie rekonstruuje się żadnych macierzy gęstości i nie implementuje się fizycznie żadnego kanału odwrotnego.
Kluczowy krok: to jest PEC
Dla naszej siły szumu kanał odwrotny można zapisać jako:
Ważne fakty:
-
Współczynniki sumują się do 1
-
Jeden współczynnik jest ujemny
-
Każdy wyraz jest fizycznie implementowalny
-
Ujemność przenosi się do klasycznego postprocessingu
Tworzymy rozkład próbkowania z wartości bezwzględnych wag:
(dla każdego z X, Y, Z)
Całkowita waga:
Aby otrzymać prawdopodobieństwa próbkowania, podziel przez W.
| Operacja | Prawdopodobieństwo | Znak |
|---|---|---|
| Nic nie rób () | 1.1875 / 1.375 ≈ 0.864 | + |
| Zastosuj X | 0.0625 / 1.375 ≈ 0.045 | - |
| Zastosuj Y | 0.0625 / 1.375 ≈ 0.045 | - |
| Zastosuj Z | 0.0625 / 1.375 ≈ 0.045 | - |
Znak pochodzi z oryginalnego współczynnika, a nie z prawdopodobieństwa.
Każdy strzał (shot) składa się z następujących kroków:
-
Przygotuj stan
-
Pozwól, aby sprzęt zastosował zaszumiony obwód
-
Wybierz losowo operację z powyższej tabeli, używając przypisanych prawdopodobieństw
-
Apply it
-
Zmierz , otrzymując
-
Pomnóż wynik przez
-
Zapisz tę liczbę
Przejdźmy teraz do przykładów kilku strzałów.
Strzał 1 (przypadek tożsamości)
Załóżmy, że wylosowaną operacją jest tożsamość (lub równoważnie: nic nie robimy). Zgodnie z argumentami i tabelą powyżej zdarzy się to w 86.4% przypadków. Ponieważ współczynnik przy w odwrotności kanału szumu jest dodatni, wybieramy znak . Nasz pomiar Z może łatwo dać . Załóżmy, że daje .
Wkład PEC z tego strzału wyniósłby:
Strzał 2 (znów tożsamość)
Załóżmy, że ponownie otrzymujemy jako losową operację (więc znak wyrazu nadal początkowo wynosi ), ale tym razem nasz pomiar Z daje . Tym razem wkład wynosi:
Strzał 3 (wybrano X)
Tym razem losową operacją jest X. Ten wyraz w odwrotności jest ujemny, więc zachowujemy znak . Stosujemy X, a następnie mierzymy Z. Znów możemy otrzymać dowolną z wartości własnych; powiedzmy, że otrzymujemy . Wkład z tego wyrazu wynosi:
Strzał 4 (wybrano Z)
Losową operacją jest Z. Daje nam to znak z tabeli. Załóżmy, że mierzymy Z i otrzymujemy . Wkład wynosi:
Strzał 5 (wybrano Y)
Losową operacją jest Y. Daje nam to znak z tabeli. Załóżmy, że mierzymy Z i otrzymujemy . Wkład wynosi:
Uśrednianie wyników
Wyobraź sobie, że zbieramy wiele takich wyników ważonych przez PEC:
Z konstrukcji stosujemy tożsamość w 86.4% przypadków. Każdą z pozostałych bramek stosujemy w 4.5% przypadków. W prawdziwym przepływie pracy nie znamy dokładnych stanów leżących u podstaw ani całego kanału szumu. Ale znamy współczynnik wagowy z powyższych obliczeń oraz względne prawdopodobieństwo zastosowania każdej operacji. W prawdziwym przepływie pracy polegamy na nieznanej macierzy gęstości, która dostarcza nam wyników pomiarów. Zweryfikujemy tutaj, że ta procedura dałaby poprawne wyniki.
Chcemy obliczyć średnią wszystkich ważonych pomiarów ze znakiem, wraz ze zastosowaniami operatorów Pauliego przed pomiarem. Oznaczmy całkowitą liczbę wszystkich strzałów przez . Zbiór wszystkich strzałów, dla których zastosowano operator Pauliego , oznaczmy i użyjmy do indeksowania tych strzałów. Wynik pomiaru -tego strzału przy zastosowaniu -tego operatora Pauliego oznaczmy . Tę średnią możemy zapisać jako:
Operator Pauliego jest stosowany probabilistycznie z prawdopodobieństwem . W granicy dużej liczby strzałów,
Możemy użyć tego do zapisania:
gdzie jest wartością oczekiwaną Z tylko po zespole strzałów, w których zastosowano . Jest to przydatne, ponieważ wiemy z macierzy gęstości, jaka musi być każda taka wartość oczekiwana. Ponownie, w prawdziwym przepływie pracy wynikałaby ona z pomiaru, a nie ze znanej macierzy gęstości.
Sprawdź swoje zrozumienie
Zweryfikuj powyższe wartości oczekiwane przez obliczenia lub rozumowanie logiczne.
Odpowiedź
Y i Z przebiegają dokładnie tak samo jak powyżej.
Możemy teraz przepisać naszą całkowitą wartość oczekiwaną jako:
Jeśli znamy parametry i szumu naszej bramki (lub więcej parametrów dla bardziej złożonych kanałów szumu), to wystarczy, aby wyznaczyć (1) całkowity czynnik wagowy oraz (2) prawdopodobieństwa, z jakimi powinniśmy stosować operatory Pauliego. Powyższy wynik pokazuje, że jeśli tak postąpimy, to złagodzimy szum i odzyskamy nieobciążone wartości oczekiwane. Średnia ze wszystkich tych shotów zbiegła do , mimo że:
-
Pojedyncze shoty dają wkłady większe niż ±1
-
Niektóre shoty mają ujemną wagę statystyczną
-
Każda operacja kwantowa była fizyczna
Przegląd przepływu pracy PEC
W PEC wszystkie kroki na komputerze kwantowym to:
-
Uczenie szumu
-
Przygotowanie stanu dla docelowego obwodu
-
Probabilistyczne zastosowanie bramek Pauliego, jak opisano powyżej
-
Measurement
Efektywna odwrotna mapa szumu jest realizowana statystycznie w klasycznym przetwarzaniu końcowym. Pozwala to na bardziej ogólne odwracanie kanałów szumu, które w przeciwnym razie wymagałoby nieFizycznych kroków, takich jak ujemne prawdopodobieństwa.
Ceną, jaką za to płacimy, jest wariancja. Każdy shot miał wcześniej „wielkość” równą wielkościom możliwych wyników pomiaru . Po przeskalowaniu czynnikiem wagowym ma wielkość (1.375 w naszym przykładzie powyżej).
To jest źródło narzutu próbkowania w PEC.
Wbudowany PEC
Teraz użyjemy PEC w postaci, w jakiej jest wbudowany w prymitywy IBM Quantum. Ważne jest tu rozróżnienie między pełnym PEC na poziomie bramek a lokalnym modelem uczenia szumu dla bardziej skalowalnego PEC, który jest używany przez prymitywy IBM Quantum. Narzut pełnego PEC ograniczyłby jego zastosowanie do małych obwodów. To w porządku, ale bardziej przydatne jest narzędzie, które skaluje się do rozmiaru, przy którym obliczenia kwantowe stają się wartościowe dla rzeczywistych problemów. Z tego powodu prymitywy IBM Quantum używają warstwowego PEC opartego na wyuczonym modelu szumu Pauli-Lindblada, z agresywnymi zabezpieczeniami skalowalności. W tej implementacji PEC szum jest uczony dla każdej powtarzanej warstwy obwodu, a nie dla każdej instancji bramki, a model szumu jest typu Pauli-twirled, lokalny i markowowski. Bramki Clifforda są wchłaniane do modelu szumu, natomiast bramki spoza grupy Clifforda dominują w koszcie mitygacji. Narzut próbkowania jest ograniczony, aby uniknąć wykładniczego wzrostu.
Zastosujemy PEC wbudowany w prymitywy IBM Quantum w dwóch skalach: małej (sześć kubitów) i średniej (30 kubitów), aby zobaczyć, jak w tej wersji PEC koszt jest utrzymywany pod kontrolą. W każdym rozmiarze eksperymentu porównamy też jawnie wyniki PEC z wynikami bez mitygacji, z ZNE oraz z wartością idealną.
Zaczynamy od zaimportowania kilku niezbędnych pakietów.
import numpy as np

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp, Statevector

# from qiskit_aer import AerSimulator
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    # QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
Wybieramy obserwablę do oszacowania. Poniższa obserwabla to hamiltonian łańcucha spinów typu Isinga ze sprzężeniem tylko między najbliższymi sąsiadami w składowej ich oddziaływania oraz jednokubitowym członem w , jak gdyby od pola zewnętrznego w kierunku .
Nie ma szczególnego powodu wyboru tego hamiltonianu. Potrzebujemy po prostu nietrywialnej kombinacji obserwabli i obwodu, aby mitygacja błędów miała co robić. Jawnie skalujemy hamiltonian (za pomocą współczynników), dzieląc przez liczbę kubitów, tak aby energia pozostawała tego samego rzędu wielkości wraz ze wzrostem liczby kubitów. Zaczynamy od zaledwie sześciu.
# This cell builds the observable

num_qubits = 6

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)
Podobnie jak w przypadku wyboru hamiltonianu, poniższy obwód do przygotowania stanu nie został wybrany z powodów fizycznych. Wybrano go raczej tak, aby miał wystarczającą głębokość dwukubitową i dostatecznie wiele bramek spoza grupy Clifforda, by PEC mógł być użyteczny. Nie ma powodu sądzić, że ten obwód jest na przykład dobrym przybliżeniem stanu podstawowego tego łańcucha spinów.
qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.5, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)
qc.rz(3.141592653589793 / 8, 2)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")
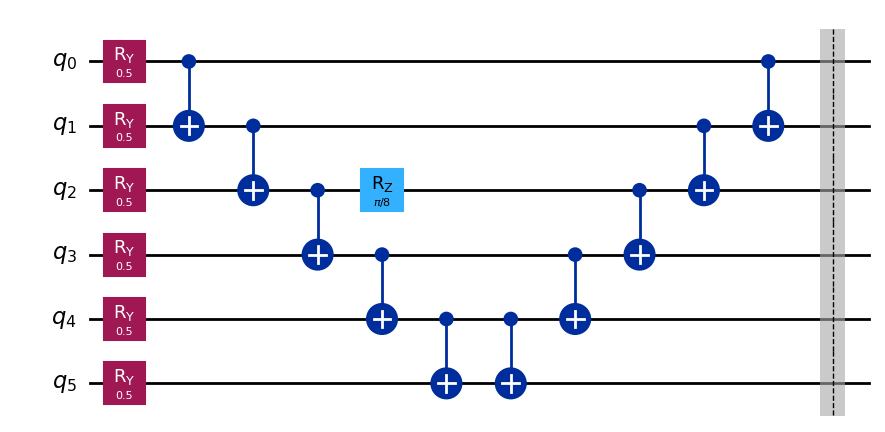
Transpilujemy nasz obwód i stosujemy powstały układ do naszych obserwabli.
# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)
Idealną wartość oczekiwaną uzyskujemy za pomocą symulatora Statevector.
# Compute the ideal final state
state = Statevector.from_instruction(qc)

# Compute expectation value
ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.6651408876730361
Spodziewamy się, że inne wartości idealne będą podobnej wielkości. Teraz uruchamiamy to na prawdziwym komputerze kwantowym IBM bez mitygacji błędów.
# This took 3 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.569677734375
Teraz stosujemy ZNE do tego samego problemu.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.6573718927156127
Na koniec stosujemy PEC.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

from qiskit_ibm_runtime.options import EstimatorOptions

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

result = job_pec.result()
value_pec = result[0].data.evs

print("PEC:", value_pec)
PEC: 0.6666196849843695
Poniżej rysujemy wyniki i porównujemy je.
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
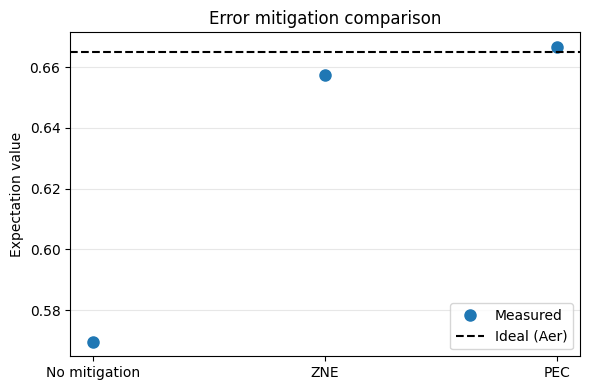
To zadziałało bardzo dobrze. Nasze oszacowanie z użyciem PEC różni się od wartości idealnej zaledwie o 0.2%.
Pamiętaj jednak, że narzut kwantowy rośnie wykładniczo. Wymusiliśmy maksymalny narzut max_overhead = 100. Sądząc po czasie i jakości wyników, wygląda na to, że możemy nie osiągnąć tego maksimum. Jeśli jednak zwiększymy skalę obliczeń i pozostawimy to maksimum, osiągniemy je, a nasze wyniki ucierpią.
Zobaczmy, co się stanie, gdy zwiększymy nasz obwód do 30 kubitów. Co ciekawe, na wielu laptopach symulator Statevector zacznie przekraczać limit czasu przy około 24-28 kubitach. Moglibyśmy znaleźć obliczeniowe sposoby obejścia tego. Zamiast tego jednak przyjmijmy do wiadomości, że komputery kwantowe będą w stanie rozwiązywać niektóre problemy w skali, w której komputery klasyczne nie nadążają. O to właśnie chodzi. Co zatem możemy zrobić, aby zweryfikować wyniki obliczeń kwantowych w takich przypadkach? Istnieje kilka potencjalnych odpowiedzi:
- Niektóre problemy są trudne do rozwiązania, ale łatwe do sprawdzenia (jak rozkład na czynniki pierwsze w algorytmie Shora).
- Niektóre problemy mają reżimy parametrów lub warianty, w których złożoność maleje i można je rozwiązać klasycznie, a nawet analitycznie, aby porównać kilka punktów. W tym przypadku wybraliśmy hamiltonian intensywny (podzieliliśmy przez liczbę kubitów). Idealna wartość oczekiwana powinna być dość stabilna. Zobaczmy, jak idealna wartość oczekiwana zmienia się wraz z liczbą kubitów i czy możemy dokonać klasycznych przewidywań wartości dla 30 kubitów.
import numpy as np
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit
from qiskit.quantum_info import Statevector, SparsePauliOp

num_qubits_max = 24

qubits = [4, 8, 12, 16, 20, 24]
exp_vals = []
for num_qubits in qubits:
    qc = QuantumCircuit(num_qubits)

    for i in range(num_qubits):
        qc.ry(0.7, i)
    for i in range(num_qubits - 1):
        qc.cx(i, i + 1)
    for i in range(num_qubits):
        qc.rz(np.pi / 5, i)
    for i in reversed(range(num_qubits - 1)):
        qc.cx(i, i + 1)
    qc.barrier()

    terms = []
    coeffs = []

    # XX interactions
    for i in range(num_qubits - 1):
        pauli = ["I"] * num_qubits
        pauli[i] = "X"
        pauli[i + 1] = "X"
        terms.append("".join(pauli))
        coeffs.append(1.0 / (num_qubits - 1))

    # Z fields
    for i in range(num_qubits):
        pauli = ["I"] * num_qubits
        pauli[i] = "Z"
        terms.append("".join(pauli))
        coeffs.append(0.5 / num_qubits)

    observable = SparsePauliOp(terms, coeffs)

    # Compute the ideal final state
    state = Statevector.from_instruction(qc)

    # Compute expectation value
    ideal_value = np.real(state.expectation_value(observable))
    exp_vals.append(ideal_value)

print(exp_vals)

plt.figure()
plt.plot(qubits, exp_vals, "o", label="Statevector")
plt.xlabel("Number of qubits")
plt.ylabel(r"$\langle O^{\otimes N} \rangle$")
plt.legend()
plt.show()
[np.float64(0.7181764372838925), np.float64(0.7181764372838922), np.float64(0.7181764372838931), np.float64(0.7181764372838906), np.float64(0.7181764372838907), np.float64(0.7181764372838709)]
Rzeczywiście widzimy, że wybraliśmy hamiltonian i stan, które nie zmieniają się wraz z liczbą kubitów. Jest to bardzo kiepski wybór dla zastosowania badawczego obliczeń kwantowych, ale doskonały do testowania technik mitygacji błędów. Możemy z pewnością używać tej stałej wartości oczekiwanej jako wyniku idealnego, nawet gdy zwiększamy liczbę kubitów na potrzeby testów mitygacji błędów.
num_qubits = 30

qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.7, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)

for i in range(num_qubits):
    qc.rz(np.pi / 5, i)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")

# This cell builds the observable

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)

# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)

# Compute the ideal final state
# This might time out above about 26 qubits. The Hamiltonian has been "normalized".
# The same expectation value calculated on the smaller example above is still valid.
# state = Statevector.from_instruction(qc)

# Compute expectation value
# ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.7181764372838709
# This took 5 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.5869884271731322
Teraz uruchamiamy ten większy obwód z ZNE.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.7096089981595511
Na koniec uruchamiamy przykład 30-kubitowy z PEC.
# This took 4 min 57 sec on ibm_fez. Your actual runtime might vary.

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

value_pec = job_pec.result()[0].data.evs
print("PEC:", value_pec)
PEC: 0.3481257778627795
job_id_none = job_none.job_id()
job_id_zne = job_zne.job_id()
job_id_pec = job_pec.job_id()
print("job number with no mitigation:  ", job_id_none)
print("job number with ZNE  ", job_id_zne)
print("job number with PEC  ", job_id_pec)
job number with no mitigation:   d7uc79back5s73be1cv0
job number with ZNE   d7uc7c3ack5s73be1d40
job number with PEC   d7uc9k4inasc738smhu0
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
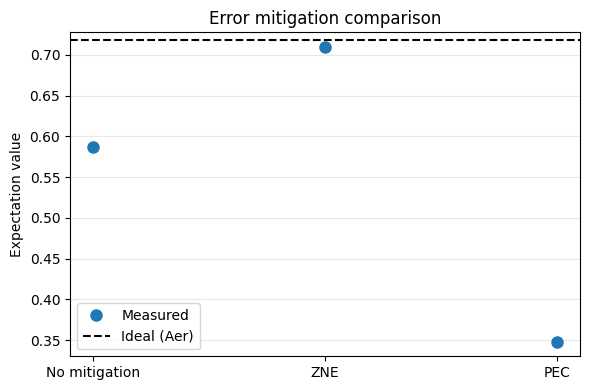
PEC nie tylko trwał znacznie dłużej niż pozostałe opcje, ale też wyraźnie osiągnęliśmy nasz maksymalny próg narzutu. Wyniki PEC poniosły koszt narzutu, ale ograniczenie narzutu uniemożliwiło dostatecznie dokładne skasowanie wyuczonego modelu szumu. To kluczowe. Przy sześciu kubitach mogliśmy wykorzystać PEC i uzyskać lepsze wyniki przy jedynie umiarkowanym wzroście narzutu kwantowego (około pięciokrotnym). Przy 30 kubitach zapłaciliśmy znacznie wyższą cenę (około 60 razy wyższą), a wyniki były nawet gorsze niż oszacowanie bez mitygacji. Nie oznacza to, że PEC nigdy nie może działać z 30 kubitami; może to zależeć od obwodu. Wniosek jest po prostu taki, że wykładniczy wzrost narzutu kwantowego utrudnia uruchamianie go dla dużych obwodów.
Kluczowe wnioski:
-
Mitygacja pomiaru często pomaga i zwykle wiąże się z niskim narzutem: usuwa obciążenie, które nie skaluje się z głębokością obwodu, i czysto komponuje się niemal ze wszystkim.
-
Niektórych technik nie można łączyć. Nawet gdy można, upewnij się, że łączysz je w spójny sposób, tak aby jedna nie cofała drugiej. Dobrym przykładem jest zapewnienie, że twirling jest włączony podczas kalibracji dla M3, jeśli te metody mają być łączone.
-
PEC i ZNE należy traktować jako alternatywy względem siebie. Rozwiązują ten sam problem z przeciwstawnymi kompromisami:
-
PEC: daje nieobciążone wartości oczekiwane kosztem wykładniczej wariancji.
-
ZNE zwykle daje resztkowe obciążenie zależne od modelu ekstrapolacji, ale przy umiarkowanym koszcie.
-
-
DD może pomóc przy długich okresach bezczynności, ale zmienia kształt modelu szumu i może unieważnić założenia ekstrapolacji lub inwersji.
-
Pauli twirling nie redukuje szumu. Zmienia jego kształt i często sprawia, że inne techniki (ZNE i PEC) działają lepiej.