Szum i błędy
Ta lekcja wprowadzi szum i błędy kwantowe, w tym wiele ich źródeł, i przedstawi analogie z błędami klasycznymi. Zrozumienie rodzajów błędów, które mogą wystąpić, oraz umiejętność modelowania szumu za pomocą kanałów kwantowych będą kluczowe dla zrozumienia kolejnych lekcji. W istocie większość metod radzenia sobie z błędami wymaga, abyśmy wiedzieli coś o rodzaju szumu lub błędów, które chcemy zredukować lub skorygować.
Ten film przedstawia przegląd szumu i błędów oraz zwraca uwagę na kilka wyników obliczeniowych. Poniższy tekst zawiera więcej szczegółów i omawia niektóre rodzaje błędów z użyciem Qiskit.
Przyczyny
Szum i błędy klasyczne
Aby zrozumieć błędy i szum kwantowy, zacznijmy od klasycznego odpowiednika. W komputerach klasycznych błędy występują z wielu powodów, w tym z powodu różnych mechanizmów niepożądanej akumulacji ładunku, pojedynczych zdarzeń zakłócających (single-event upsets) oraz powolnej degradacji materiałów. Niektóre z tych mechanizmów (choć nie wszystkie) mają swoje odpowiedniki w obliczeniach kwantowych i będą pomocne w zrozumieniu błędów i szumu kwantowego. Pokrótce omówimy kilka z nich, a następnie przejdziemy do odpowiedników kwantowych.
Szum termiczny:
W miarę nagrzewania się podzespołów komputera, termiczny ruch atomów i nośników ładunku zmienia rezystywność materiału (zazwyczaj ją zwiększając). Oznacza to, że rezystancja w obwodzie może się zmieniać. Choć rzadko, może to prowadzić do niepożądanego przejścia logicznego w tranzystorze. Chociaż drobne wahania są nieuniknione, właściwe chłodzenie podzespołów jest kluczowe dla unikania tych efektów.
Uszkodzenia termiczne i degradacja:
Powtarzające się nagrzewanie i chłodzenie materiałów może powodować bardzo powolną migrację elementów przewodzących (metali). W najlepszym razie zmienia to rezystancję lub pojemność (lub obie te wielkości) elementów obwodu, prowadząc do niedokładności czasowej w działaniu obwodu. W najgorszym razie skutkuje to zwarciem lub trwałą awarią. Również w tym przypadku właściwa kontrola temperatury ma kluczowe znaczenie w zapobieganiu takiej degradacji.
Efekty wywołane promieniowaniem (pojedyncze zdarzenia zakłócające, SEU):
Czasami wysokoenergetyczne cząstki mogą jonizować atomy wewnątrz procesora, prowadząc do niepożądanego ładunku. Jeśli zdarzy się to w niewłaściwym miejscu i czasie, może to prowadzić do błędów logicznych. Źródłem tych wysokoenergetycznych cząstek (w tym promieniowania elektromagnetycznego i neutronów) są zazwyczaj wysokoenergetyczne interakcje w górnych warstwach atmosfery. Dlatego takie zakłócenia są częstsze w środowiskach na dużych wysokościach, w tym w przestrzeni kosmicznej. Radzi się sobie z nimi za pomocą kodów korekcji błędów i projektowania odpornego na promieniowanie.
Zakłócenia elektromagnetyczne:
Błędy mogą być również powodowane przez zewnętrzne pola elektromagnetyczne (EM) pochodzące z przełączanych linii zasilających, nadajników radiowych lub innych elementów systemu. Różni się to od wysokoenergetycznego promieniowania omówionego w poprzednim zjawisku. W tym przypadku błądzące, zmienne w czasie pola EM indukują prąd i napięcie w elementach obliczeniowych (w przeciwieństwie do jonizacji konkretnego atomu podczas jednego zdarzenia). Ponieważ zmienność pól w czasie jest czynnikiem decydującym o indukowanych napięciach, ten rodzaj zakłóceń jest szczególnie istotny w systemach wysokiej częstotliwości. Błędom tym można przeciwdziałać między innymi poprzez ekranowanie i uziemianie.
Przesłuch między połączeniami:
Sprzężenie pojemnościowe lub indukcyjne między sąsiadującymi przewodnikami, zwłaszcza w układach scalonych o skali nanometrowej, może prowadzić do niepożądanych sygnałów. Jest to zjawisko powiązane z zakłóceniami elektromagnetycznymi, lecz różni się od nich, ponieważ źródłem zakłócającego pola jest inny element wewnątrz obwodu komputera. Wyobraź sobie dwa przewody znajdujące się bardzo blisko siebie. Jeśli w przewodzie A wystąpi nagłe przejście (zmiana napięcia), może ono indukować prądy w sąsiednim przewodzie B. Dokładny kierunek i wielkość zależą od układu obwodu; może to być spójny, ukierunkowany przepływ ładunku lub coś bliższego prądom wirowym ładunku. W niektórych przypadkach może to jednak prowadzić do niepożądanych przejść logicznych. Te efekty przesłuchu można łagodzić poprzez optymalne rozmieszczenie elementów, ekranowanie i kontrolowany czas narastania sygnału.
Nie jest to pełna lista, ale wystarcza, abyśmy mogli dostrzec pierwsze podobieństwa do obliczeń kwantowych. Zauważ, że we wszystkich powyższych rodzajach niepożądanych interakcji, przejaw szumu w postaci błędu logicznego może przybrać jedynie formę zmiany 0 na 1 lub 1 na 0. To jedyna możliwość dopuszczalna w przestrzeni stanów bitów klasycznych.
Szum i błędy kwantowe
W obliczeniach kwantowych szum i błędy są często omawiane razem, jednak ważne jest, aby rozróżniać te pojęcia. Szum kwantowy odnosi się do leżącego u podstaw fizycznego zakłócenia wpływającego na kubity i systemy kwantowe. Obejmuje on wszelkie formy niepożądanych interakcji lub fluktuacji pochodzących ze środowiska, niedoskonałych sterowań lub wad sprzętu, które powodują odchylenie stanu kwantowego od stanu idealnego. Błędy kwantowe to konkretne odchylenia lub usterki w informacji kwantowej, będące wynikiem szumu kwantowego. Błędy kwantowe są mierzalnymi lub operacyjnymi przejawami szumu, a do błędów należą m.in. odwrócenia bitowe (bit-flip), odwrócenia fazowe (phase-flip), tłumienie amplitudy i inne. Zarówno szum, jak i błędy mogą występować w sposób ciągły. Na przykład pole używane w bramce kwantowej może być błędne o 0,1%, 0,15% lub dowolny inny ułamek. Może to skutkować niepoprawną fazą kubitu, również o dowolną wartość ciągłą. Zobaczysz jednak, że w praktyce, a zwłaszcza w korekcji błędów, powszechnie traktuje się błędy tak, jakby były dyskretne: grupując zakumulowane efekty w pojedyncze, dyskretne odwrócenie bitowe lub pojedynczy obrót fazowy. Jest to przydatne przy korygowaniu i charakteryzowaniu błędów, ale nie oznacza to, że wpływ szumu na kubit ogranicza się wyłącznie do dyskretnego zbioru błędów.
Istnieje wiele rodzajów szumu wpływających na komputery kwantowe. Niektóre mogą powodować wiele rodzajów błędów, podczas gdy inne są powiązane z konkretnymi przejawami błędów. Pełna lista wykracza poza cel tej lekcji; poniżej znajduje się częściowa lista istotna dla dalszej części tego kursu, z których niektóre mają odpowiedniki w szumie komputerów klasycznych.
Thermal:
Dwa bazowe stany obliczeniowe i kubitu są rozdzielone bardzo małą ilością energii. Dokładna wartość zależy oczywiście od sprzętu kwantowego. Dla kubitów w stanie stałym (transmonów o stałej częstotliwości), takich jak te używane przez IBM Quantum®, przerwa energetyczna między tymi stanami wynosi rzędu J, czyli kilku mikroelektronowoltów. Tę skalę energii można powiązać z częstotliwością poprzez lub z charakterystyczną temperaturą. Ponieważ temperatura jest związana ze średnią energią kinetyczną cząstek w próbce, możemy użyć stałej Boltzmanna, aby oszacować temperaturę, przy której przeciętne cząstki miałyby wystarczającą energię, aby spowodować przejście:
Aby zmniejszyć szansę, że interakcje termiczne spowodują przejścia z jednego bazowego stanu obliczeniowego kubitu do drugiego, temperatura kubitów musi być utrzymywana znacznie poniżej 100 mK, najlepiej bliżej 15–25 mK. Jakikolwiek znaczący wzrost temperatury powyżej tych progów spowodowałby całkowicie losowe obsadzenie stanów i całkowitą utratę informacji kwantowej.
Jest to analogiczne do błędów termicznych, które mogą wystąpić w komputerach klasycznych, w tym sensie, że oba mają termiczne pochodzenie — jednak skala temperatury jest oczywiście inna, podobnie jak mechanizm utraty informacji.
Przesłuch i zakłócenia:
Przesłuch w obliczeniach kwantowych odnosi się do wszelkiego niepożądanego sprzężenia lub zakłóceń między kubitami lub liniami sterującymi, w wyniku których operacja lub sygnał przeznaczony dla jednego kubitu niezamierzenie wpływa na inne. Objawia się to jako błędy lub korelacje między kubitami, które w idealnym przypadku powinny być niezależne.
W architekturach kubitów nadprzewodzących, takich jak te używane przez IBM®, przesłuch może wynikać z przecieku mikrofalowych sygnałów sterujących do sąsiednich kubitów, niezamierzonego sprzężenia między rezonatorami odczytu lub przesłuchu strumienia magnetycznego między pętlami kubitów.
Wiele podejść do minimalizowania przesłuchu jest wbudowanych w projekt komputera kwantowego, na przykład rozmieszczenie kubitów oraz zapewnienie, że sąsiadujące kubity mają różne częstotliwości robocze. Istnieją również programowe metody łagodzenia błędów przesłuchu, które zostaną omówione w kolejnych lekcjach.
Niedoskonałe operacje bramkowe:
Operacje na kubitach są wykonywane za pomocą sprzętu o skończonej precyzji, który może być podatny na szum lub inne źródła niedokładności. W szczególności do realizacji bramek obrotu wykorzystuje się impulsy mikrofalowe o określonym czasie trwania i określonej orientacji. Załóżmy na przykład, że impuls mikrofalowy ma obrócić stan o 0,30 radiana wokół osi . Precyzja orientacji jest skończona, co prowadzi do pewnej niedokładności osi obrotu. Ponadto zawsze istnieje fundamentalny kompromis między częstotliwością impulsu a jego czasem trwania. Bardzo długi impuls może mieć zasadniczo przebieg sinusoidalny o praktycznie jednej częstotliwości. Aby uzyskać krótki pakiet, potrzebna jest superpozycja wielu częstotliwości. Jest to ten sam kompromis, który leży u podstaw relacji nieoznaczoności energia-czas, choć precyzja bramek jeszcze nie zbliża się do tych fundamentalnych granic; wciąż jest miejsce na poprawę.
Szum nieodłącznie związany z naturą kwantową:
Ten ostatni rodzaj szumu znacznie różni się od pozostałych; nie wynika on z błędów, lecz z samej natury mechaniki kwantowej. Załóżmy, że kubit w stanie kwantowym jest mierzony i zapada się do stanu własnego ( lub ). W układzie transmonu o stałej częstotliwości kubit jest sprzężony dyspersyjnie z rezonatorem mikrofalowym, którego częstotliwość rezonansowa nieznacznie zależy od stanu kubitu. Przez rezonator przesyłany jest mikrofalowy impuls sondujący, a wychodzący sygnał zyskuje zależne od stanu przesunięcie fazowe i zmianę amplitudy. Sygnał ten jest następnie wzmacniany i mierzony za pomocą klasycznej elektroniki.
Na poziomie kwantowym sygnał pomiarowy jest niesiony przez koherentne pole mikrofalowe o skończonej średniej liczbie fotonów. Ze względu na kwantową naturę pól elektromagnetycznych, kwadratury pola wykazują nieodłączne fluktuacje. Fluktuacje te są niezależne od niedoskonałości technicznych i występują nawet dla idealnego stanu koherentnego. Zwiększenie średniej liczby fotonów zwiększa sygnał pomiarowy, ale podstawowy poziom szumu pozostaje skończony, przez co rozróżnialność między wynikami poprawia się jedynie jak .
Tak więc nawet jeśli kubit jest idealnie przygotowany, a łańcuch pomiarowy jest idealny, sygnał odczytu odpowiadający danemu stanowi kubitu nie jest pojedynczą, ustaloną wartością, lecz rozkładem, który ogranicza możliwość rozróżnienia wyników. To nakładanie się rozkładów stanowi fundamentalne źródło niepewności w samym procesie pomiaru. W praktyce, choć szum techniczny pochodzący od wzmacniaczy i innych elementów często dominuje, ten nieodłączny szum kwantowy wyznacza dolną granicę wierności odczytu.
Niepewność to nie błąd:
Wszystkie te źródła szumu różnią się od fundamentalnej niepewności związanej z pomiarami stanów kwantowych. Dla kontrastu, załóżmy, że mamy kubit w stanie kwantowym:
Ten stan ma 64% szans na zmierzenie w stanie i 36% szans na zmierzenie w stanie . Jednak pojedynczy pomiar da w wyniku jedynie lub — więc pojedynczy pomiar rzadko powie nam wiele o stanie sprzed pomiaru. Aby uzyskać szczegółowe informacje o stanie, potrzeba wielu pomiarów. Spośród dziesięciu pomiarów moglibyśmy oczekiwać, że sześć lub siedem z nich da . Nie byłoby jednak szokujące, gdyby pierwsze dziesięć pomiarów dało akurat (podobnie jak rzucanie uczciwą monetą i uzyskanie „orła” dziesięć razy z rzędu: rzadkie, ale całkowicie możliwe). Gdybyśmy jednak powtórzyli pomiar 1000 razy i zawsze otrzymywali , byłoby to rzeczywiście szokujące.
Istnieje więc niepewność w naszej wiedzy o stanie kwantowym opartej na dowolnej skończonej liczbie pomiarów. W miarę powtarzania pomiarów nasza wiedza o stanie kwantowym sprzed pomiaru poprawia się, ale nigdy nie jest doskonała. Można by potocznie powiedzieć, że w każdym wyniku pomiaru kwantowego zawsze kryje się jakiś „błąd”. Jest to jednak inne znaczenie słowa „błąd” i lepiej opisać to jako niepewność statystyczną. Proces zwiększania wiedzy o stanie kwantowym poprzez wiele pomiarów nazywa się tomografią stanów kwantowych. Tomografia stanów kwantowych nie ogranicza się jednak do pomiarów wzdłuż osi Z; ogólnie odnosi się do pomiarów wzdłuż osi ortogonalnych (takich jak X, Y i Z) w celu wyznaczenia amplitud i fazy względnej. Aby dowiedzieć się więcej o tym procesie, zobacz tę sekcję w kursie Johna Watrousa General Formulation of Quantum Information, a po praktyczną implementację zobacz tę lekcję o teleportacji w ramach kursu Utility-Scale Quantum Computing.
Obserwowanie błędów i ich kumulacji
W tej sekcji wykorzystamy rzeczywiste komputery kwantowe, aby zaobserwować błędy kwantowe i ich kumulację w różnych warunkach. W praktyce zazwyczaj jednocześnie występuje wiele źródeł błędów kwantowych. Aby zaobserwować różne rodzaje błędów w sposób w miarę izolowany, będziemy musieli użyć obwodów zaprojektowanych specjalnie w tym celu. Obwody wykorzystywane w praktycznych zastosowaniach obliczeń kwantowych będą wyglądać znacznie bardziej skomplikowanie.
Zacznijmy od błędów relaksacji energetycznej.
Błędy relaksacji energetycznej ()
Przypomnijmy z naszej dyskusji o szumie termicznym, że w każdej niezerowej temperaturze istnieje pewne prawdopodobieństwo, że układ kwantowy przejdzie między stanami własnymi energii. Relaksacja () dominuje, ponieważ jest napędzana przez emisję spontaniczną (niezależną od temperatury), podczas gdy niska temperatura tłumi konkurujący proces wzbudzenia. Im dłużej kubit pozostaje bezczynny, tym więcej ma czasu na przejście tego typu. Prawdopodobieństwo, że kubit przygotowany w stanie pozostanie w stanie po czasie , jest dane wzorem
Tutaj czas to eksperymentalnie wyznaczony czas charakterystyczny, różny dla każdego kubitu, który może nawet nieznacznie zmieniać się w czasie. Komputery kwantowe IBM® są regularnie testowane (benchmarkowane), więc czasy podawane dla kubitów w komputerach kwantowych IBM powinny być dokładne i aktualne. Duża wartość oznacza, że kubit pozostaje (średnio) dłużej w przygotowanym stanie. Typowe wartości różnią się w zależności od architektury; kubity w komputerach kwantowych IBM mają zwykle czasy rzędu 200–300 , a najnowsze wartości można sprawdzić na stronie Zasoby obliczeniowe.
Czas charakterystyczny mierzy coś innego: utratę informacji o fazie. Wrócimy do tego później.
Aby zaobserwować błędy relaksacji energetycznej, przygotujemy kubity w stanie , a następnie celowo pozostawimy je bezczynne przez długie okresy czasu. To jest sztuczny element tego eksperymentu. W rzeczywistych przepływach pracy kwantowej może się zdarzyć, że kilka kubitów pozostaje bezczynnych przez dłuższy czas, podczas gdy na innych kubitach wykonywane są operacje; dlatego kilka przypadków takich okresów bezczynności nie jest sztuczne.
Zacznijmy od zaimportowania kilku pakietów i wybrania najmniej obciążonego backendu.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"cycler": "cycler", "matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_runtime import QiskitRuntimeService
import numpy as np
import matplotlib.pyplot as plt

# If your credentials are already saved locally
service = QiskitRuntimeService()

# To load an unsaved instance, uncomment the line below
# service = QiskitRuntimeService(channel = "ibm_quantum_platform", instance = "your crn here")

# To select the least-busy backend:
# backend = service.least_busy(simulator=False, operational=True)

# To specify the backend by name:
backend = service.backend("ibm_boston")

props = backend.properties()
print(backend)
<IBMBackend('ibm_boston')>
Teraz wybierzemy kubit, na którym będziemy pracować — w tym przypadku kubit zero. Możemy bezpośrednio zaimportować właściwości tego kubitu, w tym i .
qubit_idx = 0
qubit_props = props.qubit_property(qubit_idx)

t1 = qubit_props["T1"][0]  # * 1e6  # Convert seconds to µs
t2 = qubit_props["T2"][0]  # * 1e6  # Convert seconds to µs

# print(f"Qubit {qubit_idx}: T1={t1} µs, T2={t2} µs")
print(f"Qubit {qubit_idx}: T1={t1} s, T2={t2} s")
Qubit 0: T1=0.0002737016180018049 s, T2=0.00042784777605680494 s
Znajomość wartości w mikrosekundach jest ważna, ale możesz nie mieć intuicyjnego wyczucia, co to oznacza. Wszak operacje bramkowe na komputerach kwantowych są bardzo szybkie. Prawdziwe pytanie brzmi: ile możemy zrobić na komputerze kwantowym w tym czasie. W tym celu warto odnieść do innych skal czasowych używanych w obliczeniach kwantowych — a konkretnie do następujących:
-
czas próbkowania - najmniejszy takt zegara, w ramach którego można realizować procesy sterujące na komputerze kwantowym.
-
czasy bramek jednokubitowych - czas potrzebny do wykonania operacji bramkowej na pojedynczym kubicie. Nie będzie to pojedyncza wartość, lecz zakres możliwych liczb w zależności od rodzaju bramki.
-
czasy bramek dwukubitowych - czas potrzebny do wykonania operacji bramkowej na dwóch sąsiadujących kubitach. Może to również przyjmować zakres wartości, ale zazwyczaj jest to o rząd wielkości dłuższe niż w przypadku bramki jednokubitowej.
Sprawdźmy dla naszego backendu i wyświetlmy kilka prawdopodobnych zakresów czasów bramek.
print(f"Using backend: {backend.name}")

# Access the backend target
target = backend.target

def get_gate_times(target, gate_name):
    results = []

    if gate_name not in target:
        return results  # gate not supported

    # target[gate_name] is a dict: {(qubits): InstructionProperties}
    for qubits, props in target[gate_name].items():
        if props.duration is not None:
            results.append({"qubits": qubits, "duration_ns": props.duration * 1e9})

    return results

# Query some gates
for gate in ["cz", "x"]:
    times = get_gate_times(target, gate)

    print(f"\nGate: {gate}")
    if times:
        for entry in times[:5]:
            print(f"  Qubits {entry['qubits']}: {entry['duration_ns']:.2f} ns")
    else:
        print("  Not available on this backend")
Using backend: ibm_boston

Gate: cz
  Qubits (0, 1): 68.00 ns
  Qubits (1, 0): 68.00 ns
  Qubits (1, 2): 68.00 ns
  Qubits (2, 1): 68.00 ns
  Qubits (2, 3): 88.00 ns

Gate: x
  Qubits (0,): 32.00 ns
  Qubits (1,): 32.00 ns
  Qubits (2,): 32.00 ns
  Qubits (3,): 32.00 ns
  Qubits (4,): 32.00 ns
Te czasy bramek będą się różnić w zależności od backendu. Wpiszemy na sztywno czas bramki dwukubitowej pobrany z ibm_boston, wynoszący 68 ns.
dt = backend.configuration().dt
two_q_gate_time = 68e-9
print("The sampling time is : ", dt)
print("dts per T_1 : ", t1 / dt)
print("2-qubit characteristic time : ", two_q_gate_time)
print("The sampling time intervals per two-qubit gate : ", two_q_gate_time / dt)
print("2-qubit gates per T_1 : ", t1 / two_q_gate_time)
The sampling time is :  4e-09
dts per T_1 :  68425.40450045122
2-qubit characteristic time :  6.8e-08
The sampling time intervals per two-qubit gate :  17.0
2-qubit gates per T_1 :  4025.0237941441897
Miej na uwadze, że nie uwzględniono tu żadnych innych źródeł błędów ani ich tłumienia czy łagodzenia. Błędy nie są jedynymi błędami działającymi w systemie kwantowym, więc nie przejmuj się zbytnio tymi liczbami. Oznacza to po prostu, że przy braku jakiegokolwiek tłumienia moglibyśmy prawdopodobnie zaimplementować rzędu tysięcy bramek dwukubitowych, zanim błędy zaczną dominować. Inne błędy zazwyczaj zdominują sytuację przy znacznie mniejszych głębokościach obwodu, a odwrotnie — tłumienie błędów może być wciąż warte zastosowania przy znacznie krótszych czasach niż te potrzebne do całkowitego zatarcia sygnału.
Zaczniemy od użycia symulatora z modelem szumu, a następnie porównamy wyniki z rzeczywistym sprzętem.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, thermal_relaxation_error
from qiskit import QuantumCircuit
from qiskit.quantum_info import Pauli
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_aer.primitives import EstimatorV2

pass_manager = generate_preset_pass_manager(backend=backend, optimization_level=0)
Zdefiniujmy krok czasowy dla naszych pomiarów odpowiadający górnemu oszacowaniu czasu bramki dwukubitowej. Następnie zbudujemy 50 obwodów w przyrostach tego kroku czasowego. W ten sposób zobaczymy, co dzieje się w skali czasowej podobnej do wykonania 80 bramek dwukubitowych. Precyzja nie jest tu kluczowa, więc użyjemy jedynie garstki strzałów (shots).
n_points = 50  # We will show 50 steps
delay_unit = 80  # The delay in units of two-qubit-time from above
shots = 100
Budujemy model szumu dla naszego symulatora, który jawnie uwzględnia błędy relaksacji termicznej.
# Create noise model with thermal relaxation for delays
noise_model = NoiseModel()
error = thermal_relaxation_error(
    t1, t2, two_q_gate_time * delay_unit
)  # error model characterized by times in ns
noise_model.add_all_qubit_quantum_error(error, ["delay"])

sim = AerSimulator(noise_model=noise_model)
Teraz zbudujemy nasze obwody i obserwable. Są one wyjątkowo proste. Obwody będą polegać po prostu na przygotowaniu kubitu w stanie i wprowadzeniu opóźnień na rosnące okresy czasu, wykorzystując zdefiniowane wcześniej charakterystyczne czasy bramek i . Obserwablą będzie po prostu , ponieważ chcemy wiedzieć, czy kubit pozostał w stanie , czy rozpadł się do stanu . Chociaż transpilacja nie zawsze jest konieczna w przypadku symulatorów, i tak transpilujemy tutaj nasze obwody, aby móc ich później użyć na rzeczywistym backendzie.
observables = [Pauli("Z")] * n_points
circuits = []
obs = []
delay_times_sim = []
for i in range(n_points):
    qc = QuantumCircuit(1, 1)
    qc.x(0)
    if i > 0:
        for j in range(i):
            qc.delay(delay_unit * two_q_gate_time, 0, "s")
            j = j + 1
    qc_opt = pass_manager.run(qc)
    circuits.append(qc_opt)
    delay_times_sim.append(delay_unit * two_q_gate_time * i)
    observables_isa = observables[i].apply_layout(layout=qc_opt.layout)
    obs.append(observables_isa)
Uruchamiamy nasze zadanie za pomocą symulatora.
pubs = list(zip(circuits, obs))

# Create AerSimulator with noise model as backend
simulator = AerSimulator(noise_model=noise_model)

# Create SamplerV2 from the AerSimulator backend
estimator = EstimatorV2.from_backend(simulator)

# Run the sampler on the circuit, specify shots
job = estimator.run(pubs)
result = job.result()
Na koniec wykreślamy wyniki.
# Optional: color palette similar to 'mpl', style = 'clifford'

from cycler import cycler

plt.rcParams["axes.prop_cycle"] = cycler(
    color=[
        "#4C78A8",  # muted blue
        "#72B7B2",  # teal
        "#54A24B",  # green
        "#9C89CC",  # purple
        "#B279A2",  # mauve
    ]
)

# Everything else stays at Matplotlib defaults

# Example data: assume result is a list of objects with structure result[i].data.evs.item()
# and delay_times is already defined as a list of floats.

# Extract y-values
y_sim_values = [(1 - r.data.evs.item()) / 2 for r in result]

# Use delay_times as x-values
x_sim_values = delay_times_sim

# Create the plot
plt.figure(figsize=(8, 5))
plt.plot(x_sim_values, y_sim_values, marker="o", linestyle="-", label="EV Data")

plt.xlabel("Idle Time (s)")
plt.ylabel("Probability of measuring |1>")
plt.title("T1 Decay")
plt.grid(True)
plt.show()
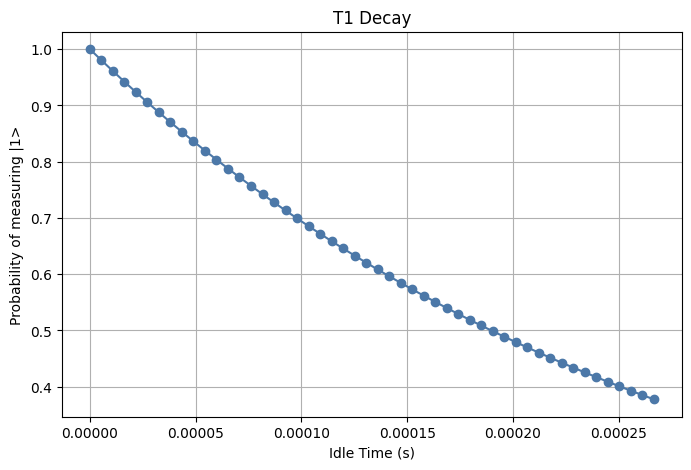
Wyraźnie widać wykładniczy zanik, a w tym czasie spada on do nieco poniżej 40% szansy na bycie w stanie . Zauważ, że jest to dokładnie zgodne z modelem: , gdzie wybraliśmy maksymalne tego samego rzędu co ; przypomnijmy, że powiedzieliśmy, iż może odpowiadać 60 bramkom (lub temu rzędowi wielkości), a tutaj odpowiada 60 bramkom. Zatem
Teraz uruchommy te same obwody na rzeczywistym komputerze kwantowym. Aby objąć ten sam czas trwania opóźnienia przy mniejszej liczbie zadań, zwiększymy jednostkę opóźnienia i zmniejszymy liczbę punktów.
# This took 27 s on ibm_boston

from qiskit_ibm_runtime import EstimatorV2

# Explicitly use a pass manager with optimization level 0 so that we don't remove the delays
pass_manager = generate_preset_pass_manager(backend=backend, optimization_level=0)

# Use the same time parameters and shots
n_points = 10
delay_unit = 400
shots = 100

# Measure Pauli Z's as your observables
observables = [Pauli("Z")] * n_points
circuits = []
obs = []
delay_times = []
for i in range(n_points):
    qc = QuantumCircuit(1, 1)
    qc.x(0)
    if i > 0:
        qc.delay(delay_unit * two_q_gate_time * i, 0, "s")
    qc_opt = pass_manager.run(qc)
    circuits.append(qc_opt)
    delay_times.append(delay_unit * two_q_gate_time * i)
    observables_isa = observables[i].apply_layout(layout=qc_opt.layout)
    obs.append(observables_isa)

pubs = list(zip(circuits, obs))
estimator = EstimatorV2(mode=backend)
job = estimator.run(pubs=pubs)
result = job.result()

# To print the job id for later retrieval of data
# job_id = job.job_id()
# print(f"Job ID: {job_id}")
Teraz wykreślamy wyniki.
fig, ax = plt.subplots()

# Convert from the expectation value of Z to the probability of a transition
y_real_values = [(1 - r.data.evs.item()) / 2 for r in result]

# Use delay_times as x-values
x_real_values = delay_times

# Exponential decay to match theoretical model
t_smooth = np.linspace(0, x_sim_values[19], 100)  # Smooth x-range covering your data
y_decay = np.exp(-t_smooth / (t1))  # y = exp(-t/t1)
ax.plot(t_smooth, y_decay, "k--", linewidth=1, label=f"Perfect Decay (t1={t1:3f} s)")

# Add simulator values
ax.scatter(x_sim_values, y_sim_values, label="Simulator", alpha=0.7)

# Add real QC values
ax.scatter(x_real_values, y_real_values, label="Real", alpha=0.7)

# Add labels and plot
ax.set_xlabel("Idle Time (s)")
ax.set_ylabel("Probability of measuring |1>")
ax.legend()
ax.set_title("T1 Decay")
ax.grid(True)

plt.show()
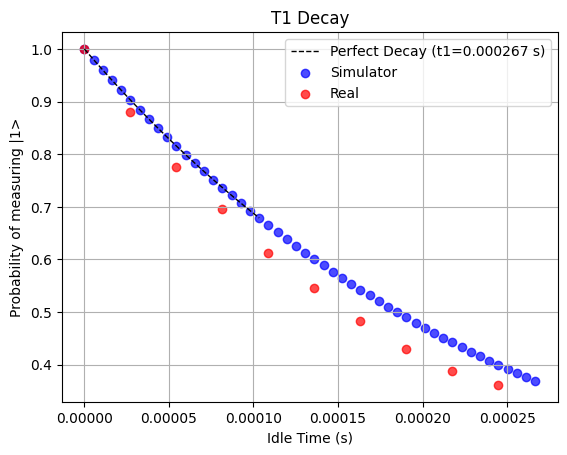
Jak widać, zanik stanu w czasie odpowiada teorii (oraz definicji ). Ponadto symulator dość dobrze odwzorowuje zachowanie rzeczywistego komputera kwantowego w tym przypadku. Oto kilka rzeczy, o których warto pamiętać w kontekście zaniku tego stanu:
- Sztucznie opóźniliśmy pomiar o nierealistyczny czas. Te opóźnienia odpowiadają skali czasowej niezwykle głębokich obwodów, które mogłyby składać się z tysięcy bramek dwukubitowych. Zrobiono to jedynie po to, aby pokazać, że efekty szumu termicznego istnieją. W rzeczywistych obwodach stosowanych do rzeczywistych problemów operacje byłyby wykonywane na innych kubitach, podczas gdy garstka mogłaby pozostawać bezczynna wystarczająco długo, aby błędy relaksacji energetycznej miały znaczenie — jednak inne błędy zdominowałyby sytuację, zanim osiągnięty zostałby pełny .
- Nie zastosowano żadnych technik łagodzenia ani tłumienia błędów. Możemy zmienić tę krzywą zaniku, wykorzystując techniki, których nauczymy się w tym kursie.
- Użyliśmy tu jedynie 100 strzałów (shots), co jest niezwykle małą liczbą, ponieważ chcieliśmy jedynie wykazać, że efekt istnieje. W praktycznych zastosowaniach prawdopodobnie użyjesz ponad 1000 strzałów.
Ta pierwsza wizualizacja błędu nie wymagała prawie żadnych bramek poza opóźnieniami (i pojedynczą bramką X użytą do przygotowania stanu ). Przyjrzyjmy się teraz innemu przykładowi, który skupia się na błędzie bramek.
Błędy bramek i ich kumulacja
Kiedy stosujemy bramkę kwantową, powiedzmy bramkę , teoretycznie bramka ta obraca stan kwantowy o kąt radianów wokół osi na sferze Blocha, przekształcając w poprzez
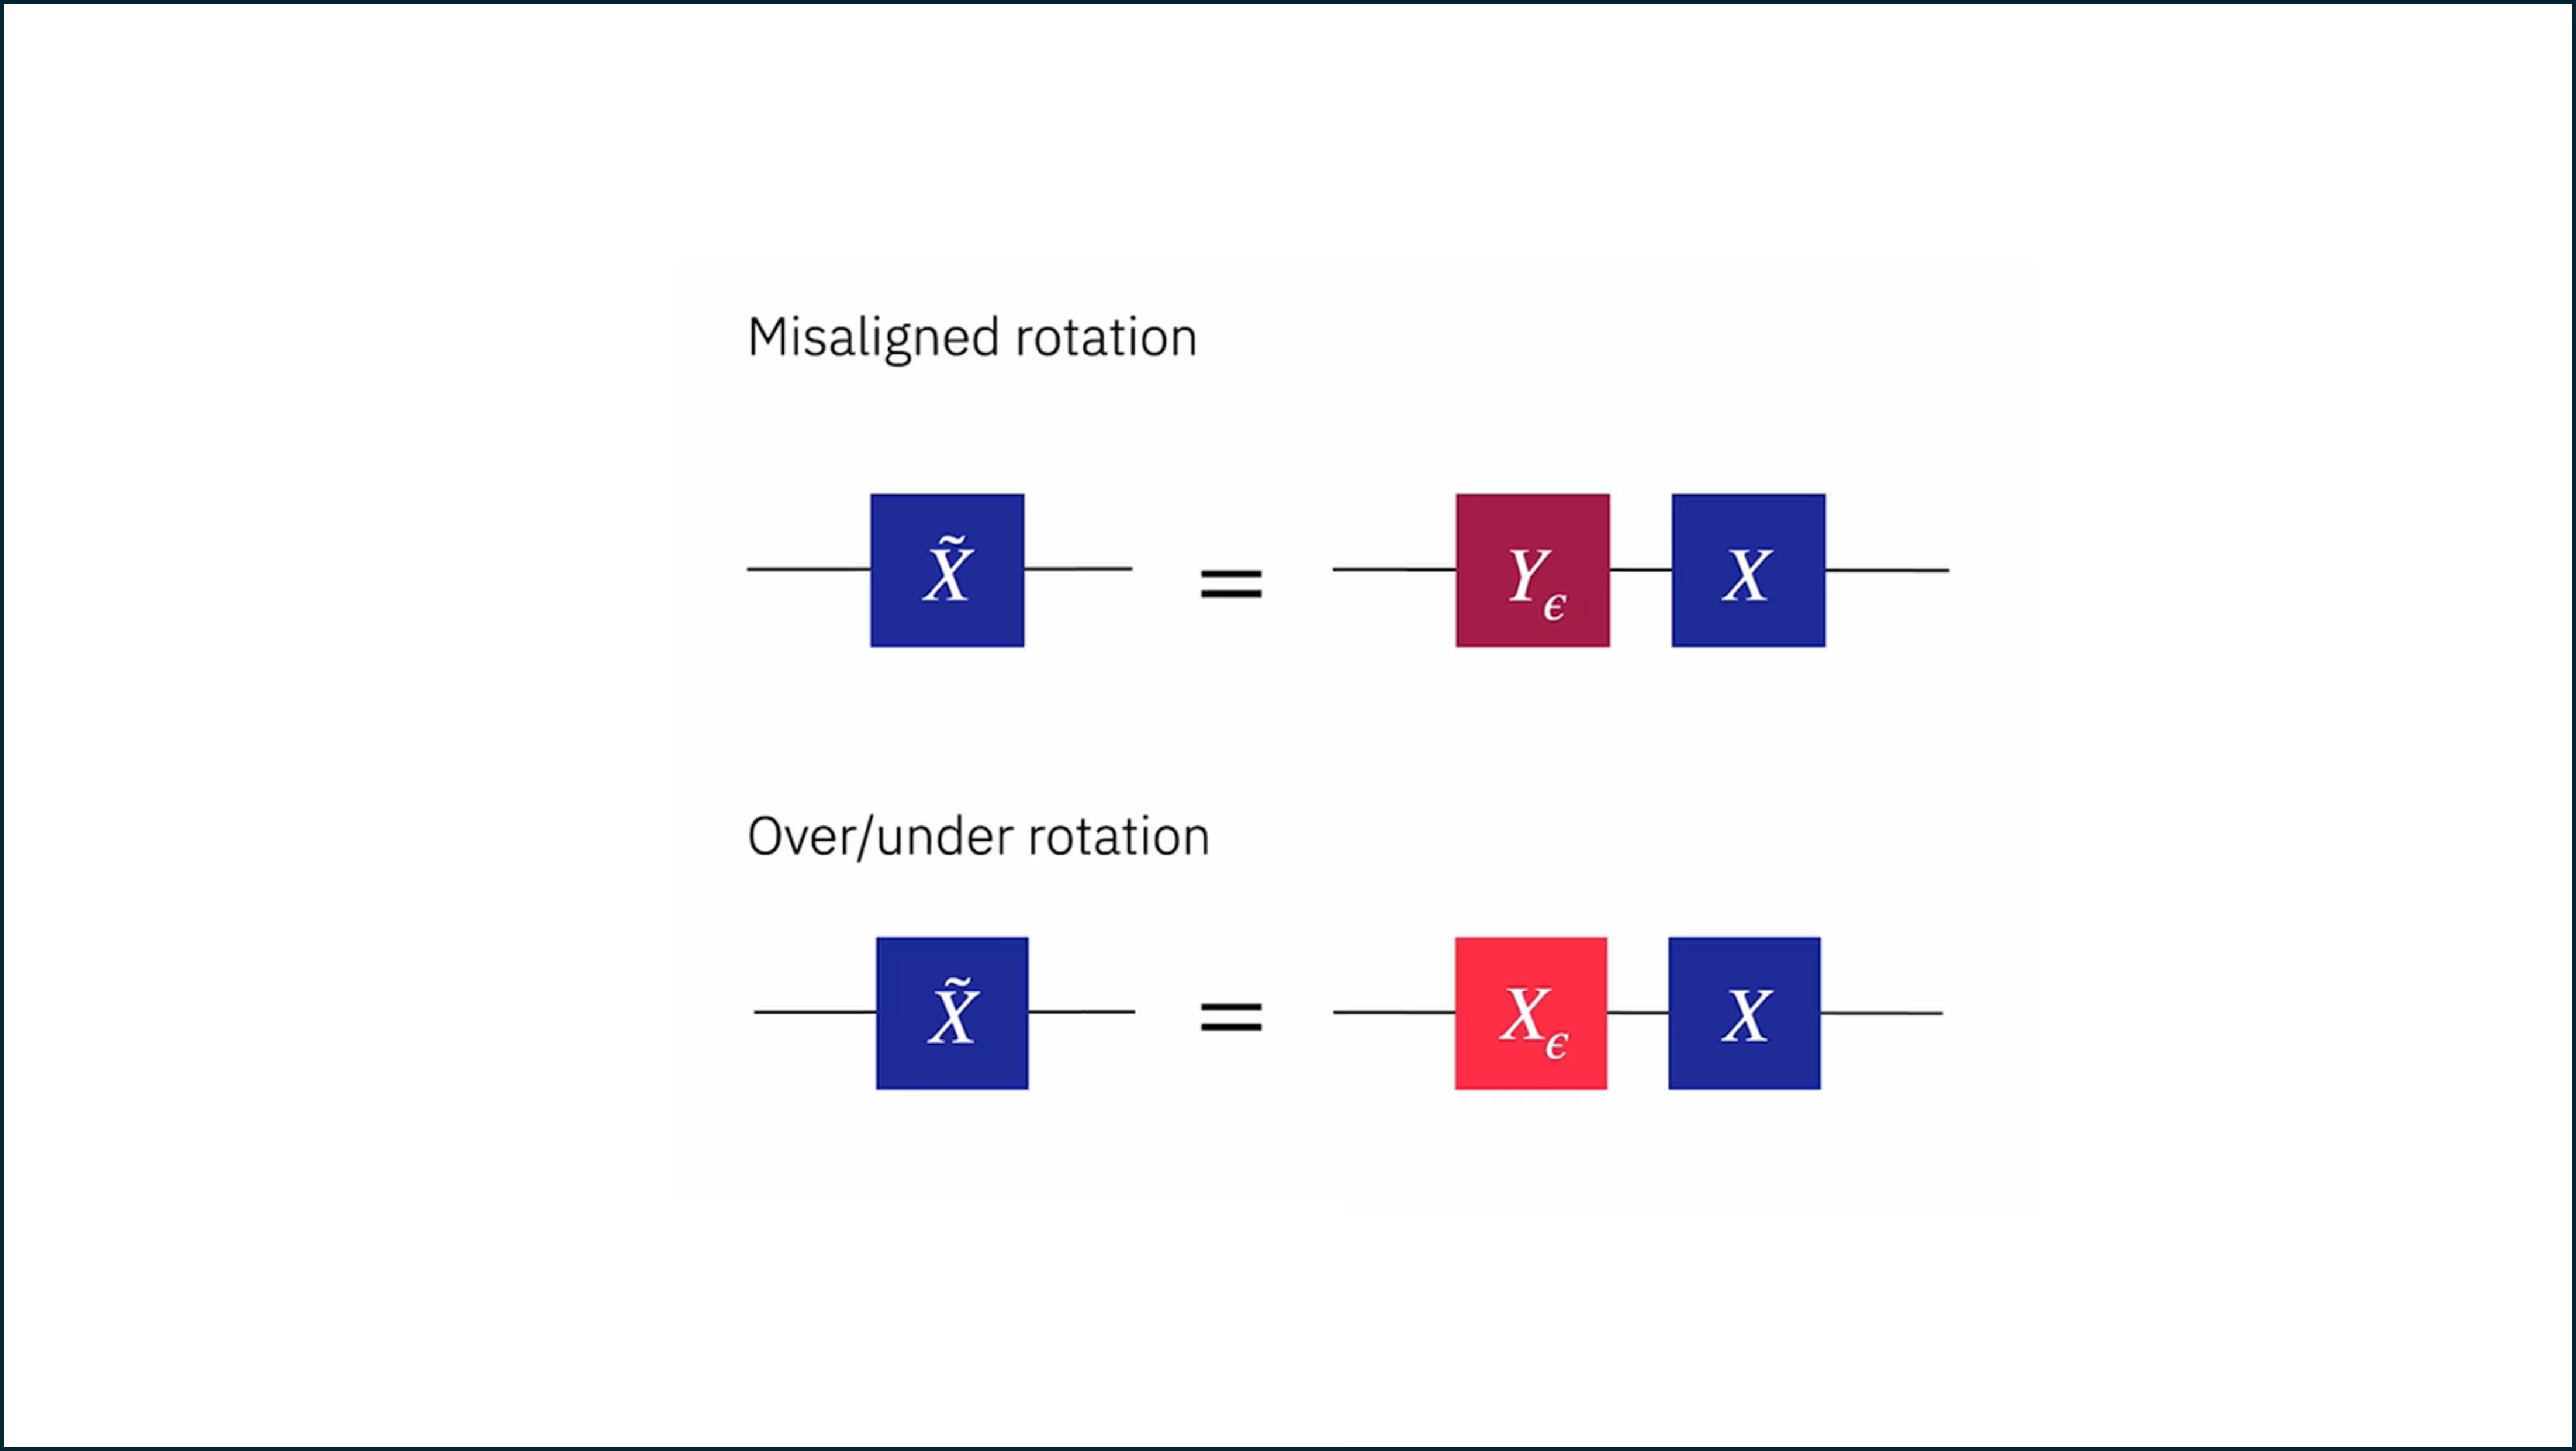
Jednak rzeczywista bramka jest niedoskonała. Może być niedokładnie zorientowana (powodując obroty niedokładnie wokół osi X) albo może powodować obrót nieco większy lub mniejszy niż zamierzony. Zamodelujmy błąd bramki wyłącznie jako obrót nadmierny lub niedostateczny o mały kąt .
Jeśli niedoskonała bramka jest stosowana wielokrotnie, małe błędy mogą się kumulować. Czasami te wielokrotne błędy powodują nawet, że stan przesuwa się za każdym razem w tym samym kierunku (zjawisko zwane „koherentną akumulacją”, do którego wrócimy poniżej). Zobaczmy, co się dzieje, gdy stosujemy rzeczywistą bramkę X na kubicie wiele razy.
# This took 78 s on penguino1

from qiskit_ibm_runtime import EstimatorV2

# Explicitly use a pass manager with optimization level 0 so that we don't remove the delays
pass_manager = generate_preset_pass_manager(backend=backend, optimization_level=0)

# Use the same bit flips
max_depth = 60
circuits = []
observables = []

for depth in range(max_depth + 1):
    qc = QuantumCircuit(1)
    # Repeat flipping back and forth depth times
    for _ in range(depth):
        #    qc.x(0)
        qc.x(0)
        qc.barrier()
        qc.x(0)
        qc.barrier()
    circuits.append(qc)
    observables.append(Pauli("Z"))

pubs = list(zip(circuits, observables))

estimator = EstimatorV2(mode=backend)
results = estimator.run(pubs=pubs).result()
real_expectations = [pub_res.data.evs for pub_res in results]
# from qiskit_ibm_runtime import QiskitRuntimeService

# service = QiskitRuntimeService()           # uses stored IBM Quantum account
# job_id = "d5immof67pic7386l8eg"

# job = service.job(job_id)                 # retrieve the job
# results = job.result()                        # this is your .result() object
# Convert from the expectation value of Z to the probability of a transition
# y_real_values = [(1-r.data.evs.item())/2 for r in results]

# Create the plot
plt.figure(figsize=(8, 5))
# plt.plot(range(max_depth + 1), y_real_values, 'o-')
# plt.plot(x_real_values, y_real_values, marker='o', linestyle='-', color='blue', label='EV Data')
plt.plot(
    range(max_depth + 1),
    real_expectations,
    marker="o",
    linestyle="-",
    color="blue",
    label="EV Data",
)

plt.xlabel("Number of Flip-Back Cycles")
plt.ylabel("Expectation ⟨Z⟩")
plt.title("Accumulated Gate Noise Effects on Flips")
plt.grid(True)
plt.show()
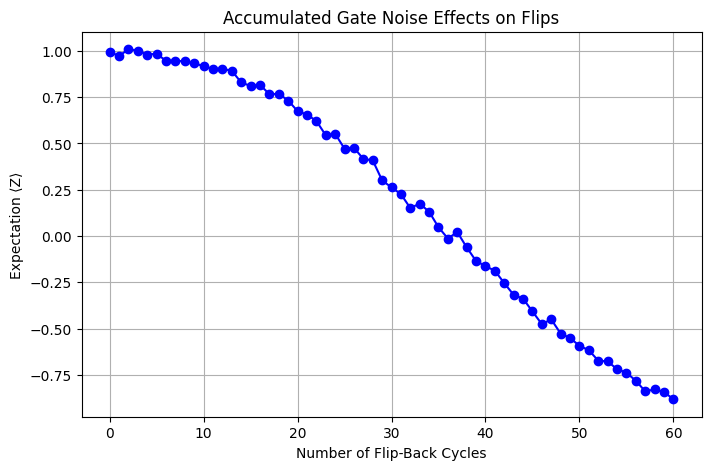
Wartość oczekiwana zaczyna się w okolicach 1.0, zgodnie z oczekiwaniami, i maleje, ale nie maleje po prostu do zera! Staje się ujemna. Gdyby był to szum termiczny lub losowe oddziaływania, nie sprawiłoby to, że byłby bardziej prawdopodobny do zmierzenia niż . Ten błąd jest wyraźnie inny. I ma to sens w kontekście naszej dyskusji o zbyt dużym/zbyt małym obrocie. Jeśli każda para obrotów, które powinny się znosić, w rzeczywistości powoduje obrót o mały kąt, to wiele takich powtórzeń stopniowo pozwoliłoby stanowi obrócić się od w stronę .
Pokazana tu akumulacja błędów prawdopodobnie nie przebiegałaby tak klarownie w rzeczywistym przepływie pracy. Po pierwsze, celowo wyłączyliśmy mitygację błędów i wykonaliśmy tę samą powtarzającą się sekwencję bramek, aby umożliwić koherentną akumulację błędów. Robimy to wyłącznie po to, aby pokazać, że te błędy istnieją. Gdy używamy technik radzenia sobie z szumem (na przykład Pauli twirling), możemy wpływać na sposób akumulacji błędu, często uzyskując niższy błąd całkowity.
Możemy dokładnie sprawdzić, jak dobrze nasz model tego błędu pasuje do danych eksperymentalnych, budując jawnie model szumu i wykorzystując symulator. W poniższym modelu jawnie wbudowujemy błąd odpowiadający 0,025 radiana. To nie jest magiczna liczba; można po prostu dostroić błąd, aż rozsądnie opisze eksperyment.
from qiskit_aer.noise import NoiseModel, coherent_unitary_error
from qiskit_aer import AerSimulator
import numpy as np

# For your SINGLE-QUBIT test on qubit 0, just override X error specifically
noise_model = NoiseModel.from_backend(backend, gate_error=True, thermal_relaxation=True)

theta_error = 0.025  # model over-rotation error around 0.01-0.03 radians
U_over = np.array(
    [
        [np.cos(theta_error / 2), -1j * np.sin(theta_error / 2)],
        [-1j * np.sin(theta_error / 2), np.cos(theta_error / 2)],
    ]
)

unitary_error = coherent_unitary_error(U_over)
# Target ONLY qubit 0 (your circuit) - no warning!
noise_model.add_quantum_error(unitary_error, ["x"], [0])

simulator = AerSimulator(noise_model=noise_model)
WARNING: quantum error already exists for instruction "x" on qubits (0,) , appending additional error.
max_depth = 60
circuits = []
observables = []

for depth in range(max_depth + 1):
    qc = QuantumCircuit(1)
    # Repeat flipping back and forth depth times
    for _ in range(depth):
        #    qc.x(0)
        qc.x(0)
        qc.barrier()
        qc.x(0)
        qc.barrier()
    circuits.append(qc)
    observables.append(Pauli("Z"))

pubs = list(zip(circuits, observables))

estimator = EstimatorV2.from_backend(simulator)
results = estimator.run(pubs).result()
expectations = [pub_res.data.evs for pub_res in results]  # no [0], use value directly
Teraz możemy nanieść na wykres rzeczywistą i symulowaną krzywą razem.
fig, ax = plt.subplots()

# Add simulator values
ax.scatter(range(max_depth + 1), expectations, c="blue", label="Simulator", alpha=0.7)

# Add real QC values
ax.scatter(range(max_depth + 1), real_expectations, c="red", label="Real", alpha=0.7)

# Add labels and plot
ax.set_xlabel("Number of Flip-Back Cycles")
ax.set_ylabel("Expectation ⟨Z⟩")
ax.set_title("Accumulated Gate Noise Effects on Flips")
ax.legend()
ax.grid(True)

plt.show()
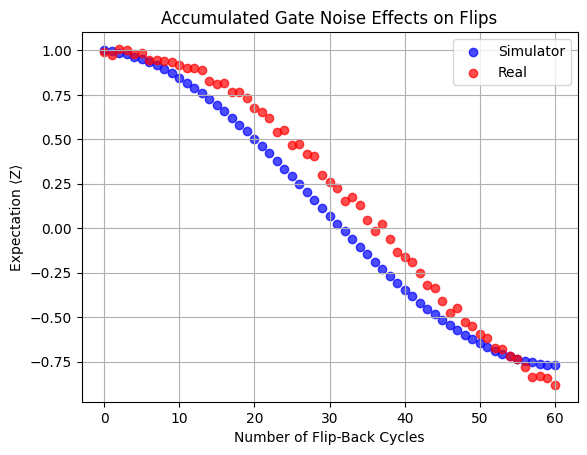
Błąd w rzeczywistym obwodzie był dość dobrze opisany przez model błędu zbyt dużego/zbyt małego obrotu. Oczywiście różne rodzaje szumu i błędów będą kumulować się w różny sposób i skutkować drastycznie różnymi efektami dla wierności naszych obwodów kwantowych. Dlatego bardzo ważne staje się bardziej formalne niż dotychczas klasyfikowanie i charakteryzowanie błędów, które mogą wystąpić.
Charakteryzowanie błędów kwantowych
Opisaliśmy już niektóre źródła szumu kwantowego i moglibyśmy klasyfikować błędy według kategorii szumu, które je powodują. Mogą jednak istnieć różne kategorie błędów kwantowych, przydatne w korekcji i mitygacji błędów. Na przykład, jeśli chcemy je korygować lub mitygować, musimy wiedzieć, w którym momencie występują błędy i jak się kumulują. Przy określaniu, gdzie (w jakich procesach) występują błędy, istotną i powszechną kategorią są błędy przygotowania stanu i pomiaru (w skrócie błędy SPAM). Tutaj termin „przygotowanie stanu” nie oznacza wszystkiego, co robi się ze stanem, przygotowując go do pomiaru. Odnosi się raczej do inicjalizacji kubitów, „przygotowania” kubitów do wykonania algorytmu, a więc ta kategoria SPAM wyklucza takie rzeczy jak błędy bramek podczas wykonywania algorytmu.
Kolejnym ważnym rozróżnieniem jest to, czy błędy są koherentne, czy niekoherentne. Podsumowując krótko (omówimy je bardziej szczegółowo poniżej), błędy koherentne są zwykle modelowane przez operacje unitarne i zachowują czystość stanu. Błędy niekoherentne są modelowane przez nieunitarne kanały kwantowe i na ogół zmniejszają czystość stanu. Łatwo jest wyobrazić sobie błędy niekoherentne jako oddziaływania termiczne powodujące utratę informacji kwantowej, ale w rzeczywistości mogą być spowodowane dowolnym losowym sprzężeniem ze środowiskiem. Jako przykład błędu koherentnego, załóżmy, że istnieje niedoskonałość orientacji impulsu przy implementacji bramki RY, taka że bramka w rzeczywistości powoduje . Taka niedoskonałość zawsze powodowałaby błędny obrót wokół osi X w tym samym kierunku. Byłby to błąd koherentny.
Zauważ, że błędy SPAM obejmują mieszankę błędów koherentnych, takich jak systematyczne usterki sterowania, oraz błędów niekoherentnych, takich jak utrata fotonów i efekty termiczne. Ponieważ obejmuje to wiele etapów i źródeł błędów, błędy SPAM najlepiej opisać jako połączenie zarówno błędów koherentnych, jak i niekoherentnych.
Błędy SPAM
Jak sugeruje nazwa, błędy SPAM powstają na dwóch odrębnych etapach eksperymentu kwantowego: początkowego przygotowania oraz odczytu/pomiaru. Błędy przygotowania stanu występują, gdy sprzęt nie jest w stanie niezawodnie zainicjalizować kubitów w pożądanym stanie początkowym ( w przypadku komputerów kwantowych IBM). Przyczyny obejmują:
- wzbudzenie termiczne (rzeczywiste kubity nie są idealnie schłodzone i mogą czasami zaczynać w stanie zamiast )
- resztkowe fotony lub szum w rezonatorach w kubitach nadprzewodzących
- dryfy kalibracji wpływające na dokładność resetowania kubitów
Błędy pomiaru występują podczas procesu odczytu, gdy aparatura pomiarowa błędnie identyfikuje stan kubitu. Źródła obejmują:
-
szum wzmacniacza odczytu powodujący pomylenie i
-
relaksacja kubitu podczas odczytu (na przykład kubit w stanie rozpada się do tuż przed pomiarem lub w jego trakcie)
-
przesłuch między liniami odczytu: odczyt jednego kubitu nieznacznie wpływa na odczyty sąsiednich kubitów
-
Niedoskonałe progi dyskryminacji w systemach pomiarowych IBM opartych na rezonatorach
Błędy SPAM są przede wszystkim niekoherentne. Błędy przygotowania działają jak losowe mieszaniny stanów wzbudzonych i podstawowych. Błędy pomiaru zachowują się jak klasyczne pomylenie: z prawdopodobieństwem stan jest raportowany jako lub odwrotnie. Różnią się one od koherentnych błędów unitarnych (takich jak źle skalibrowane bramki powodujące systematyczne przesunięcia fazy). Błędy SPAM przypominają natomiast losowy szum klasyczny, choć mogą występować rzadkie koherentne obciążenia w odczycie.
Błędy SPAM mogą być problematyczne dla benchmarkingu randomizowanego lub dla obwodów o małej głębokości, gdzie przygotowanie stanu i pomiar stanowią dużą część całkowitego błędu. Są mniejszym problemem dla bardzo głębokich obwodów, zwłaszcza tych z wieloma bramkami dwukubitowymi.
Matematycznie błędy SPAM można opisać jako generujące zaszumiony rozkład , powiązany z rozkładem idealnym za pomocą macierzy :
Tutaj to prawdopodobieństwo zmierzenia ciągu bitów , a to prawdopodobieństwo uzyskania stanu , gdy stan powinien był zostać przygotowany w stanie . Wyobraź sobie kontekst próbkowanych ciągów bitów z Sampler. Twój zmierzony rozkład stanów będzie się składał z wielu dokładnych pomiarów, ale także z pewnych pomiarów, w których instrukcje przygotowania stanu nie odpowiadają obserwowanemu stanowi. Oznacza to, że prawdopodobieństwa będą nieco niedokładne.
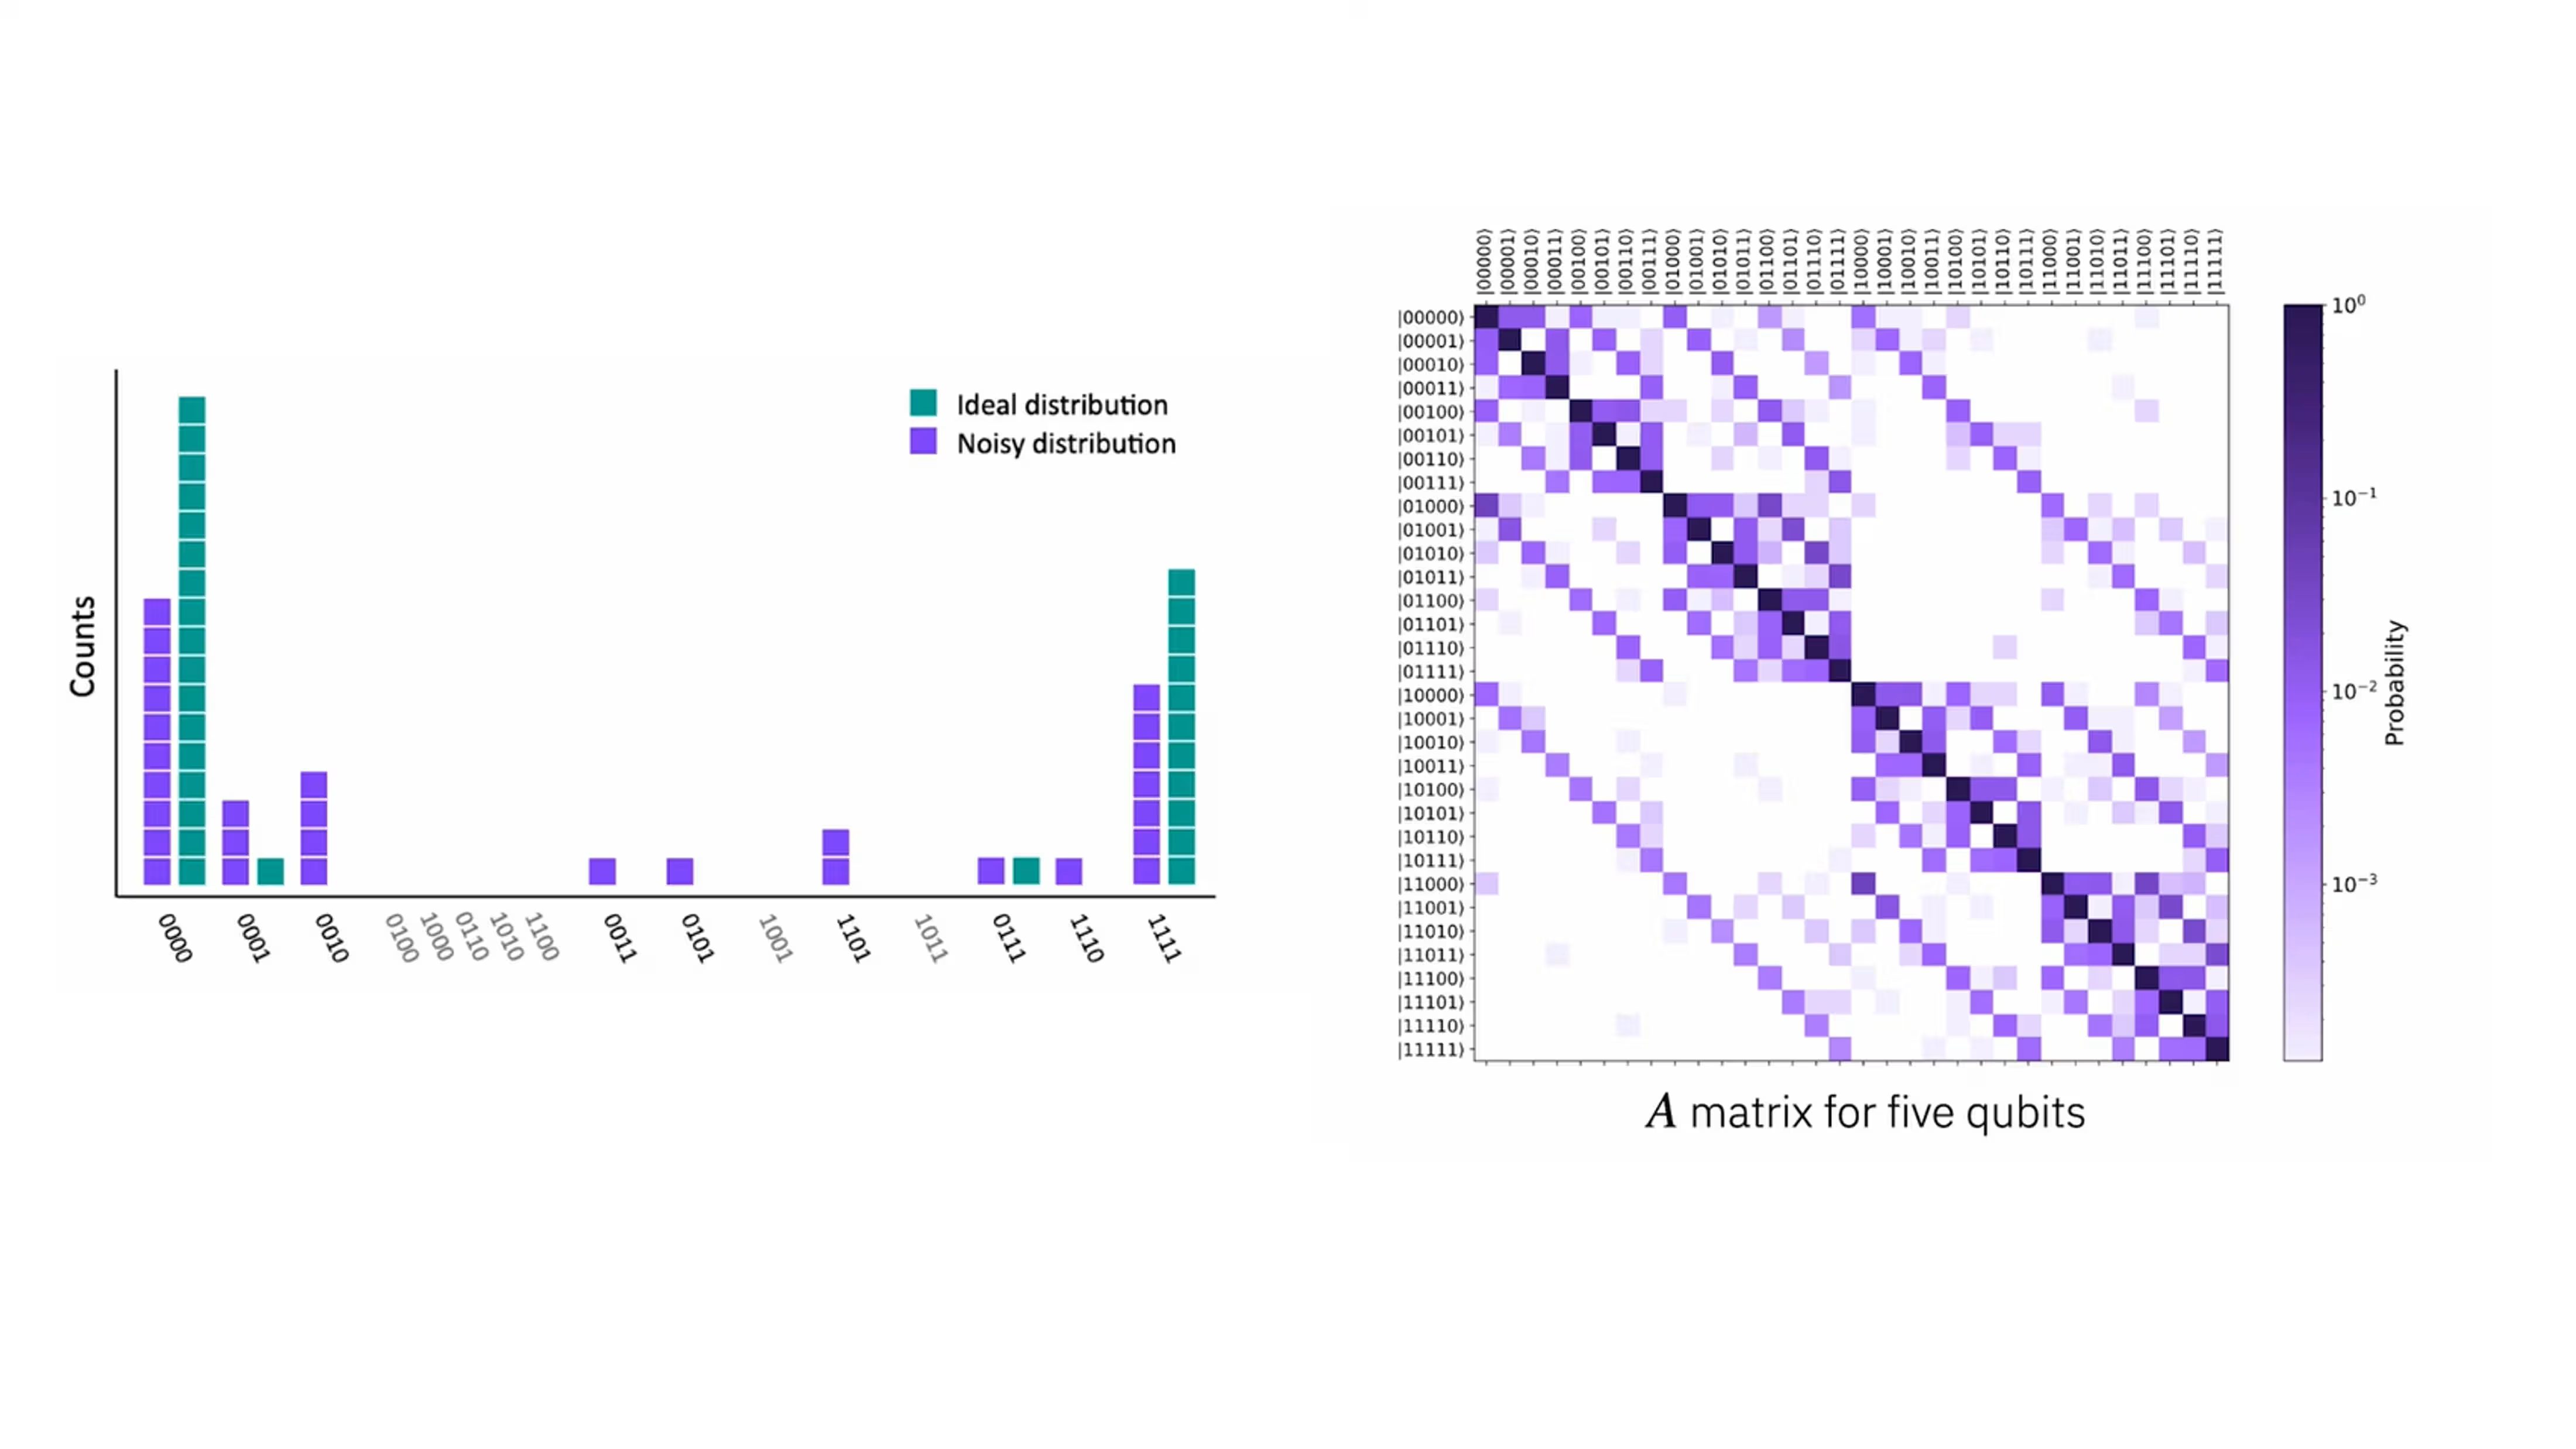
Na powyższym rysunku część (a) pokazuje idealny rozkład stanu GHZ w kolorze morskim oraz rzeczywiste pomiary w kolorze fioletowym. W części (b) widzimy przykład macierzy . Zauważ, że macierz nie jest idealnie symetryczna względem przekątnej, ponieważ każdy kubit nie musi być tak samo skłonny do błędnego zwrócenia 0, jak do błędnego zwrócenia 1. W praktyce często trudno jest oddzielić błędy przygotowania od błędów odczytu, więc są one często traktowane łącznie (stąd powszechne użycie terminu SPAM).
Jednym ze sposobów korekcji tych błędów SPAM jest użycie prostych obwodów o znanych idealnych wynikach pomiaru i porównanie ich z wynikami zmierzonymi w obecności błędów SPAM. Można to wykorzystać do odtworzenia (metodą inżynierii wstecznej) idealnych wyników bardziej złożonych obwodów. Dla ogólnych stanów o wysokiej entropii może to wymagać skonstruowania macierzy z prawdopodobieństwami, ale w mniej ekstremalnych przypadkach błędy te można mitygować.
Błędy koherentne kontra błędy niekoherentne
Błędy koherentne to systematyczne, deterministyczne i unitarne błędne obroty stanu kwantowego. Powstają z niedoskonałych operacji kwantowych, które odchylają się w przewidywalny sposób. Przykłady obejmują niewielkie błędy w obrocie stosowanym przez jednokubitowe bramki obrotu, w tym te spowodowane dryfem kalibracji, który konsekwentnie powodowałby zbyt duży lub zbyt mały obrót. Matematycznie moglibyśmy zapisać, że rzeczywista bramka obrotu, powiedzmy , jest dana przez idealną bramkę obrotu plus pewien dodatkowy błąd:
dla pewnego małego zbyt małego lub zbyt dużego obrotu . Inne przykłady obejmują bramkę dwukubitową dodającą małe niepożądane przesunięcie fazy oraz impulsy sterujące, które systematycznie odchylają się od idealnego kształtu.
Kluczową cechą błędów koherentnych jest to, że są deterministyczne i same mogą być modelowane przez bramki unitarne. W związku z tym zachowują czystość stanu kwantowego: informacja kwantowa nie jest tracona, została jedynie przetworzona niedoskonale. Inną ważną kwestią jest to, że powtarzające się błędy koherentne interferują konstruktywnie i czasami rosną kwadratowo wraz z liczbą bramek.
Błędy te są czasami przewidywalne, a więc w pewnym stopniu można je usunąć poprzez kalibrację. Jednak pozostałe błędy koherentne mogą szybko się kumulować, powodując kłopotliwe odchylenia od stanów idealnych. Oznacza to, że czasami korzystne jest celowe „randomizowanie” błędów koherentnych. Ta procedura i jej użyteczność zostaną omówione w lekcji poświęconej mitygacji błędów.
Dlaczego są kłopotliwe
Błędy koherentne mogą „kumulować się” w niebezpieczny sposób, powodując duże odchylenia od poprawnego stanu, jeśli nie zostaną zrandomizowane lub skorygowane.
Błędy niekoherentne są stochastyczne, losowe i często nieunitarne. Powstają w wyniku oddziaływań ze środowiskiem lub niekontrolowanych źródeł szumu. Widzieliśmy już kilka przykładów: relaksacja energetyczna / rozpad jest niekoherentny. Podobnie jak stochastyczny szum bramek, szum termiczny i błąd pomiaru.
Kluczową cechą błędów niekoherentnych jest to, że nie są takie same za każdym razem, gdy wykonywana jest operacja. Są nieunitarne, więc nie można ich modelować za pomocą prostej unitarnej bramki kwantowej, tak jak można to zrobić z błędami koherentnymi. Ponieważ są niekoherentne, zwykle kumulują się w sposób liniowy, jak losowy szum, a nie jak konsekwentny nadmierny obrót.
Błędy niekoherentne powodują, że kubity nieodwracalnie tracą informację (utrata czystości i informacji o fazie).
Więc który jest gorszy? Jak w większości spraw w obliczeniach kwantowych, to zależy. Wniosek jest taki, że błędy koherentne kumulują się szybciej i nieliniowo (co jest złe). Można je jednak częściowo usunąć poprzez kalibrację, a informacja o fazie wciąż jest obecna w systemie, jeśli tylko potrafisz odpowiednio ją wydobyć. Błędy niekoherentne kumulują się liniowo, co jest korzystne z dwóch powodów: jest to wolniejsze niż akumulacja koherentna, a ponadto stosunkowo łatwo jest zobaczyć, jak efekty błędów niekoherentnych skalują się w procesach takich jak ekstrapolacja do zerowego szumu (ZNE), które zostaną omówione w lekcji poświęconej mitygacji błędów. Jednak gdy występują błędy niekoherentne, informacja kwantowa jest naprawdę tracona, a nie tylko zasłonięta.
Macierze gęstości i kanały kwantowe
W kolejnych sekcjach zagłębimy się w kilka rodzajów błędów koherentnych i niekoherentnych oraz zobaczymy, jak można je matematycznie modelować za pomocą kanałów kwantowych. Najpierw warto krótko przypomnieć sobie macierze gęstości i kanały kwantowe. Pełne, rygorystyczne omówienie tych zagadnień znajdziesz w kursie Johna Watrousa General formulation of quantum information na IBM Quantum Learning. Omówienie tutaj będzie oparte na przykładach i mniej formalne.
Kanały kwantowe to najbardziej ogólny sposób opisania tego, jak system kwantowy ewoluuje, oddziałuje i podlega szumowi. Jeśli jesteś przyzwyczajony do stanów czystych i ewolucji unitarnej, kanały kwantowe są naturalnym kolejnym krokiem.
W standardowej mechanice kwantowej stan „czysty” zapisuje się jako . Tutaj „czysty” odnosi się do czystości informacji lub wiedzy o przygotowaniu stanu; nie oznacza to stanu własnego jakiegoś systemu. Dla przykładowego kubitu jest stanem czystym, ponieważ mamy pełną wiedzę o względnych amplitudach i fazie. Ewolucja czasowa takiego stanu czystego jest rządzona przez operator unitarny :
zgodnie z równaniem Schrödingera, w którym , gdzie to hamiltonian systemu, a to zredukowana stała Plancka, często „przyjmowana jako równa jeden” lub, bardziej rygorystycznie, wchłaniana w hamiltonian, tak że wszystkie energie są wyrażone w jednostkach .
Ewolucja unitarna jest odwracalna, deterministyczna i izolowana. Nie wystarcza to jednak do opisania rzeczywistych systemów kwantowych. W rzeczywistych systemach kwantowych:
- Wykonujemy pomiary, powodujące kolaps stanu kwantowego do stanu własnego systemu. Jest to wyraźnie nieunitarne.
- System oddziałuje ze środowiskiem. Oznacza to, że system nie jest naprawdę izolowany, a ponieważ środowiska nie można śledzić w nieskończoność, odpowiada to utracie informacji.
- Praktycznie rzecz biorąc: szum zaburza stan. I wiele więcej.
Sama ewolucja unitarna nie może opisać tych procesów; potrzebujemy więc bardziej ogólnej reprezentacji stanów i procesów kwantowych. Stan mieszany opisuje klasyczny rozkład stanów kwantowych. To znaczy, znamy już fakt, że stan kwantowy: ma 50% szans na zmierzenie (kolaps do informacji klasycznej) w stanie i 50% szans na zmierzenie w stanie . Twierdzimy jednak, że początkowy stan kwantowy to dokładnie ze 100% prawdopodobieństwem. Teraz chcemy dodać, ponad prawdopodobieństwem mechaniki kwantowej, prawdopodobieństwo klasyczne, na przykład:
Początkowy stan kwantowy jest przygotowany w z 25% prawdopodobieństwem klasycznym, oraz przygotowany w z 75% prawdopodobieństwem klasycznym (zwróć uwagę na różne fazy względne).
Czasami może to wynikać z jawnych klasycznych prawdopodobieństw w przygotowaniu; innym razem może to wynikać ze splątania z częściami środowiska, które ignorujemy. Tak czy inaczej, potrzeba narzędzia do opisania tego klasycznego rozkładu stanów mechaniki kwantowej jest oczywista. Same stany czyste nie mogą reprezentować tych możliwości. Dlatego wprowadzamy macierz gęstości.
Stan mieszany jest opisywany przez operator gęstości:
Tutaj to stan kwantowy (niekoniecznie stan własny jakiegoś konkretnego operatora), a to klasyczne prawdopodobieństwo, że system został przygotowany w stanie . Jest to dobry przepis na to, jak zbudować macierz gęstości ze znanego klasycznego rozkładu stanów kwantowych. Z drugiej strony, mając zarówno klasyczny rozkład stanów kwantowych, jak i mechaniczno-kwantowe prawdopodobieństwo różnych wyników pomiaru, możemy chcieć wiedzieć, jakie jest prawdopodobieństwo, że pomiar da konkretny stan (na przykład , lub inne stany, gdy zaangażowanych jest więcej kubitów). Właśnie w tym macierz gęstości jest szczególnie użyteczna. Możemy ją również zapisać w bazie jako:
Tutaj elementy diagonalne są prawdopodobieństwami:
-
= prawdopodobieństwo, że kubit jest w stanie
-
= prawdopodobieństwo, że kubit jest w stanie
Są rzeczywiste, nieujemne i sumują się do 1.
Elementy pozadiagonalne to koherencje: relacje fazowe lub zdolność do interferencji, i ogólnie odpowiadają temu, ile informacji mechaniczno-kwantowej znajduje się w stanie. To stwierdzenie jest nieformalne, ale zobaczmy, co to oznacza w praktyce.
Przykład
Rozważ stan czysty . (a) Co wiesz o prawdopodobieństwach pomiaru i informacji o fazie bez wykonywania jakichkolwiek obliczeń? (b) Zbuduj macierz gęstości i zweryfikuj swoją intuicję.
Solution:
(a) Ponieważ jest to stan czysty, istnieje tylko jedna możliwa faza między a : +1. To jest doskonała informacja o fazie, więc spodziewamy się, że elementy pozadiagonalne w naszej macierzy gęstości będą duże. Możesz mieć więcej intuicji na temat elementów pozadiagonalnych niż to, ale na razie to wystarczy. Ponadto amplitudy dwóch stanów bazowych są równe, więc spodziewamy się 50% prawdopodobieństwa zmierzenia zarówno , jak i . Spodziewamy się więc, że wpisy diagonalne wynoszą 1/2. (b) Korzystając z powyższej definicji:
tylko dla stanu . Możemy więc zapisać
Wpisy diagonalne wynoszą, zgodnie z oczekiwaniami, po każdy, a elementy pozadiagonalne są duże (sumują się do jedynki).
Zobaczmy teraz, co się dzieje, gdy nie mamy dobrej informacji o fazie.
Przykład
Rozważ podobny przypadek, ale teraz z 50% klasycznym prawdopodobieństwem bycia w stanie i 50% klasycznym prawdopodobieństwem bycia w stanie . Te same dwa pytania: (a) Co wiesz o prawdopodobieństwach pomiaru i informacji o fazie bez wykonywania jakichkolwiek obliczeń? (b) Zbuduj macierz gęstości i zweryfikuj swoją intuicję.
Solution:
(a) Podobnie jak wcześniej, amplitudy dwóch stanów bazowych są równe, więc spodziewamy się 50% prawdopodobieństwa zmierzenia zarówno , jak i . Spodziewamy się więc, że wpisy diagonalne wynoszą 1/2. Tym razem jednak istnieją dwie przeciwne możliwości fazy między a : +1 i -1, i każda z nich jest jednakowo prawdopodobna. Można by oczekiwać, że przy dwóch jednakowo prawdopodobnych, przeciwnych fazach, mamy niewiele lub żadnej informacji o fazie. Można by oczekiwać, że elementy pozadiagonalne będą małe. (b) Ponownie korzystając z powyższej definicji
tylko dla dwóch stanów i . Możemy więc zapisać
Elementy pozadiagonalne są małe, a właściwie zerowe, zgodnie z oczekiwaniami. Elementy diagonalne wciąż wynoszą po 50%, co ma sens, ponieważ każdy ze stanów w mieszaninie miał i o równych wagach.
Ta konstrukcja staje się bardziej interesująca wraz ze wzrostem liczby kubitów. Zbadaj to w poniższych pytaniach.
Sprawdź swoje zrozumienie
Zapisz macierz gęstości dla czystego stanu Bella .
Odpowiedź
tylko dla stanu . Możemy więc zapisać
Zapisz macierz gęstości dla 25% klasycznego prawdopodobieństwa i 75% klasycznego prawdopodobieństwa .
Odpowiedź
tylko dla dwóch stanów i . Możemy więc zapisać
Zmodyfikuj swoje rozwiązanie z poprzedniego pytania, aby zapisać macierz gęstości dla 50% klasycznego prawdopodobieństwa i 50% klasycznego prawdopodobieństwa . Przewidź, jaka informacja o fazie powinna się zachować.
Odpowiedź
tylko dla dwóch stanów i . Możemy więc zapisać
Wyrazy diagonalne sumują się do 1, jak być powinno. Wyrazy pozadiagonalne nie znoszą się tutaj tak, jak we wcześniejszym przykładzie z jednym kubitem. Widać dlaczego w matematyce, ale skrótowe wyjaśnienie jest takie, że w naszej przestrzeni Hilberta jest teraz więcej stanów. Chociaż pierwszy stan Bella miał dodatnią fazę względną, a drugi ujemną, te fazy dotyczyły różnych stanów bazowych. Pierwszy stan Bella miał fazę między a , podczas gdy drugi miał fazę względną między a .
Kanały kwantowe
Kanał kwantowy to najbardziej ogólna fizycznie dozwolona transformacja stanu kwantowego. Przekształca on początkową macierz gęstości w inną macierz gęstości:
Tutaj oznacza kanał kwantowy działający na macierzy gęstości , co nie należy mylić ze stanami Bella lub .
Kanały kwantowe są niezwykle ogólne. Mogą obejmować:
-
Ewolucję unitarną
-
Probabilistyczne mieszaniny unitarnych operacji
-
Measurements
-
Decoherence
-
Tłumienie amplitudy (utrata energii)
-
Defazowanie (utrata informacji o fazie)
-
Oddziaływanie ze środowiskiem I wiele innych rzeczy.
Jednym ze sposobów myślenia o kanałach kwantowych jest to, że są one dla macierzy gęstości tym, czym operacje unitarne są dla stanów czystych. Jednak ogólność macierzy gęstości pozwala odpowiadającym im kanałom kwantowym być znacznie bardziej ogólnymi, a przez to potężniejszymi.
Jedynymi ograniczeniami nakładanymi na kanał kwantowy jest to, że musi być:
- Liniowy Mieszaniny stanów powinny ewoluować spójnie:
- Całkowicie dodatni Nie powinien produkować ujemnych prawdopodobieństw, nawet jeśli twój system jest splątany z czymś innym.
- Zachowujący ślad Prawdopodobieństwa muszą sumować się do 1. Cechy te są czasami zbierane razem pod akronimem CPTP: odwzorowania Completely Positive Trace-Preserving (całkowicie dodatnie, zachowujące ślad).
Istnieją różne reprezentacje kanałów kwantowych, w tym reprezentacje Stinespringa, Krausa i Choi. Są one szczegółowo omówione w tej lekcji poświęconej kanałom kwantowym w kursie General formulation of quantum information, gdzie pokazano również, że są one równoważne. Nie będziemy tutaj wchodzić w te różne reprezentacje. Wystarczy powiedzieć, że są one analogiczne do opisywania wektorów przy użyciu trzech różnych układów współrzędnych. Każda z nich może podkreślać inne aspekty i budować intuicję w inny sposób; ale wszystkie dają poprawną odpowiedź. Reprezentacje Krausa są wygodne do naszych celów. Oferują wygodny, sformalizowany sposób wyrażania działania kanału poprzez mnożenie i dodawanie macierzy. W szczególności reprezentacja Krausa to specyfikacja kanału w następującej postaci.
Tutaj to macierze mające wszystkie takie same wymiary: ich kolumny odpowiadają klasycznym stanom systemu wejściowego, , a ich wiersze odpowiadają klasycznym stanom systemu wyjściowego, niezależnie od tego, czy jest to , czy jakiś inny system . Aby był prawidłowym kanałem, macierze te muszą spełniać następujący warunek.
Macierze te nazywane są macierzami Krausa. To sformułowanie ma zastosowanie nie tylko do kanałów szumu, ale do ogólnych procesów i kanałów kwantowych, w tym pomiaru. Zobaczmy przykład tego, jak można ich użyć do budowania kanałów w kontekście szumu i błędów.
Kanał całkowicie defazujący
Rozważ kanał, który niszczy całą informację o fazie, i nazwij go kanałem całkowicie defazującym. Oznacza to, że kanał powinien przyjmować dowolną macierz gęstości postaci
i odwzorowywać ją na
Jeśli założymy, że macierz gęstości została już zapisana w bazie obliczeniowej, możemy wyrazić jako . Sugeruje to zbiór macierzy Krausa, które mogą zrealizować to działanie kanału: . Zastosujmy tę strategię do przykładowego przypadku pojedynczego kubitu i zobaczmy, czy działa tak, jak wymagamy:
Ustaw i .
Ponieważ jest liczbą, możemy po prostu przesunąć wektor poza nią. Dotyczy to również drugiego wyrazu. Mamy:
Zauważ, że te macierze spełniają wymagany warunek:
Warto zauważyć, że ten wybór macierzy Krausa nie jest jedyny.
Charakteryzowanie szumu jako kanałów
W tej sekcji użyjemy modelu sfery Blocha oraz matematyki kanałów kwantowych, aby lepiej zrozumieć różne rodzaje szumu i błędów.
Błędy niekoherentne
Wróćmy do błędów niekoherentnych i przyjrzyjmy się konkretnie błędom relaksacji energetycznej. Przypomnijmy, że stan jest stanem podstawowym kubitu, a stan ma nieco wyższą energię. Czasami stany kwantowe po prostu spontanicznie rozpadają się z wyższego poziomu energetycznego do niższego. Proces emisji spontanicznej jest bogatym tematem i nie można go w pełni zrozumieć bez ujęcia kwantowej teorii pola. Ale intuicja jest nam wszystkim bardzo dobrze znana: losowe zaburzenia mogą sprawić, że kamień stoczy się w dół zbocza; nie sprawią jednak, że kamień wtoczy się pod górę. Jak długo kubit pozostaje w wyższym stanie energetycznym, charakteryzuje czas . Dokładniej, prawdopodobieństwo, że kubit przygotowany w stanie pozostanie w tym stanie po czasie , wynosi . Innymi słowy, prawdopodobieństwo wystąpienia błędu relaksacji energetycznej po czasie wynosi
Aby opisać to za pomocą kanału kwantowego w reprezentacji Krausa, potrzebujemy macierzy Krausa odpowiadających
- pozostawieniu stanów bez zmian
- zmianie stanów na z pewnym prawdopodobieństwem p.
Zdefiniujmy
Najpierw sprawdźmy, czy ma to zamierzony wpływ na macierz gęstości. Rozważmy system znajdujący się w stanie czystym . Widzieliśmy w powyższym przykładzie, że macierz gęstości dla tego przypadku wynosi
Stosując kanał relaksacji energetycznej za pomocą macierzy Krausa, otrzymujemy nową, przekształconą macierz gęstości:
Przyjrzyjmy się temu i porównajmy z naszą intuicją:
Najpierw sprawdźmy granicę, gdy dąży do zera. Odzyskujemy naszą początkową macierz gęstości, tak jak powinniśmy:
Wraz z upływem czasu spodziewalibyśmy się, że prawdopodobieństwo zmierzenia stanu wzrośnie, a prawdopodobieństwo zmierzenia spadnie. To dokładnie to, co widzimy, ponieważ
Możemy również w oczywisty sposób zauważyć, że prawdopodobieństwa zmierzenia i sumują się do 1, jak być powinno.
Precyzyjne skalowanie wyrazów koherencji (pozadiagonalnych) wykracza poza zakres tego opracowania. Jasne jest jednak, że początkowo mamy doskonałą informację o fazie, a po bardzo długim czasie nie może być żadnej informacji o fazie, ponieważ system jest całkowicie zrelaksowany do stanu . Zatem wyrazy koherencji muszą zaniknąć do zera w bardzo długich czasach. Rzeczywiście,
Wiele ograniczeń nałożonych na nasze macierze Krausa jest niejawnie sprawdzanych poprzez te intuicyjne rozważania. Należy rygorystycznie sprawdzić, czy ograniczenia nałożone na kanały (a w szczególności na macierze Krausa) są spełnione, ale pozostawiamy to jako ćwiczenie dla czytelnika.
Graficznie ten typ kanału można przedstawić za pomocą sfery Blocha. Stan czysty leży na powierzchni sfery Blocha. Stany mieszane przesuwają się w głąb sfery i rozmywają się z pojedynczego punktu. Uwzględnienie prawdopodobieństw klasycznych widoczne jest poprzez zmniejszenie odległości bezwzględnej od początku układu do dowolnego stanu w mieszaninie, a rozmycie z pojedynczego punktu do obszaru wskazuje na mieszanie wielu możliwych stanów. W szczególnym przypadku kanału relaksacji energetycznej stan mieszany (macierz gęstości) po pewnym niezaniedbywalnym czasie wyglądałby jak na poniższym obrazie: obszar wewnątrz sfery Blocha, przesunięty w górę w kierunku bieguna , i skurczony zarówno wzdłuż osi , jak i wzdłuż płaszczyzny , choć w mniejszym stopniu niż wzdłuż .

Zauważ, że obszar ten nie jest „czapką” sfery Blocha, jak czasami wygląda przy renderowaniu perspektywicznym. Jak wyraźnie widać na filmie, jest to spłaszczona sferoida, skurczona i przesunięta w kierunku stanu . Kanały szumowe (i kanały ogólnie) mają oczywiście zastosowanie do systemów dowolnego rozmiaru. Ale przedstawienie ich wizualnie (jak za pomocą sfery Blocha) staje się trudne wraz ze wzrostem liczby wzajemnie ortogonalnych stanów w przestrzeni Hilberta.
Sprawdź swoje zrozumienie
Zweryfikuj, że macierze Krausa użyte w powyższym kanale relaksacji energetycznej spełniają warunek tożsamości:
Odpowiedź
Przedstawimy dwa kolejne typy niekoherentnych kanałów szumowych, ale większość interpretacji i weryfikacji pozostawimy jako ćwiczenia. Kolejnym jest kanał defazujący, który opisuje utratę informacji o fazie, przy zachowaniu amplitud. Chociaż nadal można mieć zarówno prawdopodobieństwa klasyczne, jak i kwantowo-mechaniczne wpływające na całkowite prawdopodobieństwo pomiaru, utrata informacji o fazie jest często opisywana jako utrata informacji kwantowej lub jako to, że system staje się bardziej klasyczny.
W bardzo podobny sposób, w jaki relaksacja energetyczna była opisywana charakterystycznym czasem , błędy defazowania opisywane są drugim parametrem czasowym . Prawdopodobieństwo błędu defazowania po czasie jest dane przez
Zestaw macierzy Krausa dla kanału defazującego na pojedynczym kubicie, wyrażony przez to prawdopodobieństwo, jest następujący:
Wynik działania tego kanału defazującego jest wizualizowany za pomocą sfery Blocha na poniższym rysunku.

Zauważ, że amplitudy nie ulegają zmianie, więc wszelkie stany leżące dokładnie na biegunie ( lub ) pozostają niezmienione i nadal są odwzorowywane na powierzchnię sfery w zacienionym obszarze. Ale informacja o fazie zostaje utracona, co odpowiada zmniejszeniu zacienionego obszaru wzdłuż płaszczyzny . Sposobem na zrozumienie tego jest: każdy możliwy stan kwantowy może wciąż mieć dobrze zdefiniowaną fazę, ale ponieważ istnieje klasyczne prawdopodobieństwo znalezienia kilku stanów z różnymi dobrze zdefiniowanymi fazami, całkowite prawdopodobieństwo dowolnej jednej dobrze zdefiniowanej fazy jest zmniejszone.
Sprawdź swoje zrozumienie
Zweryfikuj, że macierze Krausa zdefiniowane powyżej dla kanału defazującego spełniają warunek tożsamości:
Odpowiedź
Zacznij od dowolnie wybranego jednokubitowego stanu czystego, z dobrze zdefiniowaną fazą pomiędzy i . Zapisz go jako macierz gęstości. Zastosuj kanał defazujący, używając operatorów Krausa zaproponowanych powyżej. Zinterpretuj wynikową, przekształconą macierz gęstości.
Odpowiedź
Wybierzmy stan . Odpowiadająca mu macierz gęstości wynosi
Teraz zastosujemy kanał defazujący do tej macierzy gęstości, używając operatorów Krausa.
Po pierwsze, zauważamy, że suma elementów diagonalnych rzeczywiście wynosi jeden, jak być musi. Po drugie, zauważ, że elementy pozadiagonalne były początkowo duże, z sumą 24/25, wskazującą na silną koherencję. Zauważ, że wraz ze wzrostem prawdopodobieństwa błędu defazowania , te elementy pozadiagonalne maleją. To również zgadza się z naszym oczekiwaniem. Jedna subtelność: zauważ, co dzieje się, gdy . Koherencja ponownie staje się silna! Wydaje się to na pierwszy rzut oka sprzeczne z intuicją, ponieważ wysokie prawdopodobieństwo błędu defazowania powinno zaburzyć naszą fazę, prawda? Haczyk polega na tym, że jeśli mamy 100% pewność, że błąd fazy wystąpił, to ponownie mamy silną informację o fazie; faza po prostu się odwróciła. Mając na uwadze tę obserwację, moglibyśmy oczekiwać, że najmniej informacji o fazie mamy przy szansie 50/50 na wystąpienie błędu fazy — i tak właśnie jest.
Naszym ostatnim przykładem kanału szumowego opisującego błędy niekoherentne jest kanał szumu Pauliego. Ten kanał opisuje wystąpienie trzech typów błędów z niezależnymi prawdopodobieństwami:
- Błąd odwrócenia bitu (błąd X) z prawdopodobieństwem
- Błąd odwrócenia fazy (błąd Z) z prawdopodobieństwem
- Połączony błąd X i Z (błąd Y) z prawdopodobieństwem Tutaj dla wszystkich . Wnioskiem jest, że prawdopodobieństwo braku błędu wynosi .
Operatory Krausa dla tego kanału to:
W przypadku kanału szumu Pauliego pouczające jest wypisanie samego kanału:
Widzimy z tej postaci, że kanał szumu Pauliego implementuje jeden lub więcej błędów odpowiadających działaniu macierzy Pauliego , każdy z prawdopodobieństwem .
Różne kombinacje prawdopodobieństw odwrócenia dają różne wizualizacje. Tutaj wizualizujemy szczególny przypadek, gdy , nazywany też kanałem depolaryzującym.

Modelowanie błędów koherentnych
Kanały kwantowe mogą reprezentować zarówno błędy koherentne, jak i niekoherentne, ale w praktyce są wykorzystywane głównie do błędów niekoherentnych, ponieważ błędy koherentne są lepiej modelowane jako błędy kalibracji unitarnej lub konwertowane na kanały stochastyczne w celu łatwiejszej analizy. W tej sekcji przedstawimy podejścia bardziej odpowiednie dla błędów koherentnych.
Błędy koherentne można modelować za pomocą niepożądanych bramek unitarnych. Kilka prostych przykładów obejmuje obroty wokół niewłaściwej osi lub zbyt mały/zbyt duży obrót. Na poniższym obrazie pokazujemy obrót wokół niewłaściwej osi jako dodatkowy obrót o niewielką wartość oprócz zamierzonego obrotu wokół osi . Zbyt duży obrót jest opisany zamierzonym obrotem oraz dodatkowym obrotem wokół tej samej osi .
Błędy dwukubitowe i zacienione stożki świetlne
Bramka jednokubitowa obraca izolowany kubit. Bramka dwukubitowa implementuje logikę opierającą się na dwóch kubitach, ale nie może dokonać bezpośredniego pomiaru żadnego z kubitów; musi zatem uruchomić interakcję między kubitami. Ta interakcja jest powodem, dla którego możemy budować splątanie, a jest to również miejsce, z którego pochodzi znaczna część szumu, przesłuchu (crosstalk) i trudności kalibracyjnych. Ta interakcja między kubitami pozwala również na rozprzestrzenianie się błędów. Jeśli jeden kubit ma jakiś błąd i pełni rolę kubitu kontrolnego dla innego kubitu docelowego, błąd może zostać przekazany do kubitu docelowego. W tej lekcji przyjrzymy się temu, co bramki dwukubitowe oznaczają dla wskaźników błędów i ich rozprzestrzeniania się w obwodzie.
Bramki cross-resonance z echem
Różne architektury sprzętowe i rodziny bramek inżynierują tę interakcję na różne sposoby. Komputery kwantowe IBM implementują abstrakcyjne bramki dwukubitowe, takie jak bramki CZ czy CX, za pomocą sprzętowo natywnych bramek cross-resonance z echem (ECR). Bramki ECR generują efektywną interakcję za pomocą napędu mikrofalowego. Powiązane bramki, takie jak CNOT, są budowane z poprzez dodanie rotacji jednokubitowych.
Różne kubity mają różne częstotliwości rezonansowe (częstotliwości, na które silnie reagują). Standardowa operacja może wykorzystywać tę częstotliwość rezonansową do wywołania przejścia w kubicie. Ale co się dzieje, jeśli napędzasz kubit C przy częstotliwości rezonansowej sąsiedniego kubitu T? Sąsiednie kubity są połączone stałą interakcją pojemnościową lub za pośrednictwem rezonatora. Z powodu tego sprzężenia napęd na kubicie C „przecieka” do hamiltonianu kubitu T. Siła i kierunek tego efektywnego napędu zależą od stanu kubitu C ( lub ). Tutaj kubit C jest kubitem kontrolnym, a kubit T kubitem docelowym.
Wynikiem jest efektywna rotacja kubitu docelowego uwarunkowana stanem kubitu kontrolnego. Matematycznie:
Ta interakcja ZX jest dokładnie tym, czego potrzebujesz, aby zbudować bramkę CNOT. Ale pozostałe wyrazy mogą zawierać pewne błędy i niemal na pewno zawierają sprzężenie pojemnościowe między kubitami C i T, co odpowiada wyrazowi ZZ.
Możemy myśleć o tych dodatkowych wyrazach w następujący sposób:
-
IX = kubit docelowy zostaje niezamierzenie wysterowany
-
ZI = kubit kontrolny ulega niepożądanemu obrotowi Z
-
IZ = kubit docelowy nabywa niepożądany obrót Z
-
ZZ = statyczne przesunięcie fazy zależne od stanu
-
pozostałe = małe interakcje XY, XX, wyższego rzędu
Bramka ECR to po prostu kontrolowana rotacja plus starannie dobrany impuls echa na kubicie kontrolnym. Echo odwraca znak wielu niepożądanych wyrazów, zachowując przy tym interakcję ZX. Ten proces całkiem dobrze anuluje błędy IX i ZI, a czasem także pewne wyrazy wyższego rzędu. Ale echo nie może anulować statycznego sprzężenia ZZ, ponieważ komutuje ono z impulsem echa. Istnieją inne interakcje, które nie zostaną anulowane w tym procesie: pewne resztkowe nieliniowości i efekty kubitów-obserwatorów, upływność (leakage) i zanieczyszczenie napędem dalekiego zasięgu, a także kilka innych — ale to wyraz ZZ jest szczególnie istotny.
Ten proces często wymaga czasów napędu, które są o rząd wielkości dłuższe niż w przypadku bramek jednokubitowych. Połączenie dłuższych czasów napędu, utrzymujących się wyrazów ZZ w hamiltonianie oraz niedoskonałości sprzężenia sprawia, że bramki dwukubitowe są dominującym źródłem błędów bramek. Zauważ również, że jeśli w obwodzie potrzebne są interakcje między kubitami, które nie są sąsiednie, niezbędne bramki SWAP są oczywiście również bramkami dwukubitowymi. Dlatego standardową metryką związaną z głębokością jest: dwukubitowa, stranspilowana głębokość. Zależy nam głównie na bramkach dwukubitowych, ponieważ dominują one w błędach bramek, a musimy patrzeć na stranspilowane obwody, ponieważ transpilacja często wprowadza wiele dodatkowych bramek dwukubitowych w postaci bramek SWAP.
Sprawdź swoje zrozumienie
Wyjaśnij, dlaczego zależy nam głównie na dwukubitowej stranspilowanej głębokości. Upewnij się, że uwzględniasz ograniczenia sprzętowe oraz fakt, że głębokość bramek jednokubitowych może być dużo większa.
Odpowiedź
Bramki dwukubitowe mają dużo wyższe wskaźniki błędów niż bramki jednokubitowe. Bramki jednokubitowe nie są doskonałe, więc mogą zdarzyć się przypadki, w których uwzględnienie także głębokości jednokubitowej jest przydatne. Ale głębokość bramek dwukubitowych zwykle dominuje w zachowaniu błędów obwodu. Musimy rozważyć stranspilowany obwód. Nowoczesne komputery kwantowe nie mają łączności kubitów typu wszystko-ze-wszystkim. Komputery kwantowe IBM wykorzystują albo sieć kwadratową, albo sieć typu „heavy hex”, co oznacza, że kubity mają 2, 3 lub 4 najbliższych sąsiadów, z którymi mogą być bezpośrednio sprzężone za pomocą pojedynczej bramki dwukubitowej. Jakiekolwiek splątanie z innymi, niesąsiadującymi kubitami wymaga przemieszczenia informacji po komputerze kwantowym za pomocą dwukubitowych bramek SWAP. Zatem transpilacja zwykle zwiększa głębokość bramek dwukubitowych. W przypadku obwodów o wysokim stopniu splątania ten wzrost może być bardzo duży.
Zacienione stożki świetlne
Załóżmy, że pojedynczy kubit jest dobrze izolowany od wszystkich innych. Błąd na tym kubicie nie spowoduje żadnych błędów na żadnym innym kubicie. Ale gdy kubit oddziałuje z innym, błędy mogą się rozprzestrzeniać. Sposób, w jaki błędy się rozprzestrzeniają, zależy od sposobu, w jaki kubity oddziałują. Rozważ poniższy obwód. Załóż, że wszelkie kubity sąsiadujące na diagramie obwodu są również sąsiednie na chipie kwantowym (to znaczy, że informacja nie będzie musiała być przenoszona między innymi kubitami, aby umożliwić opisane interakcje).
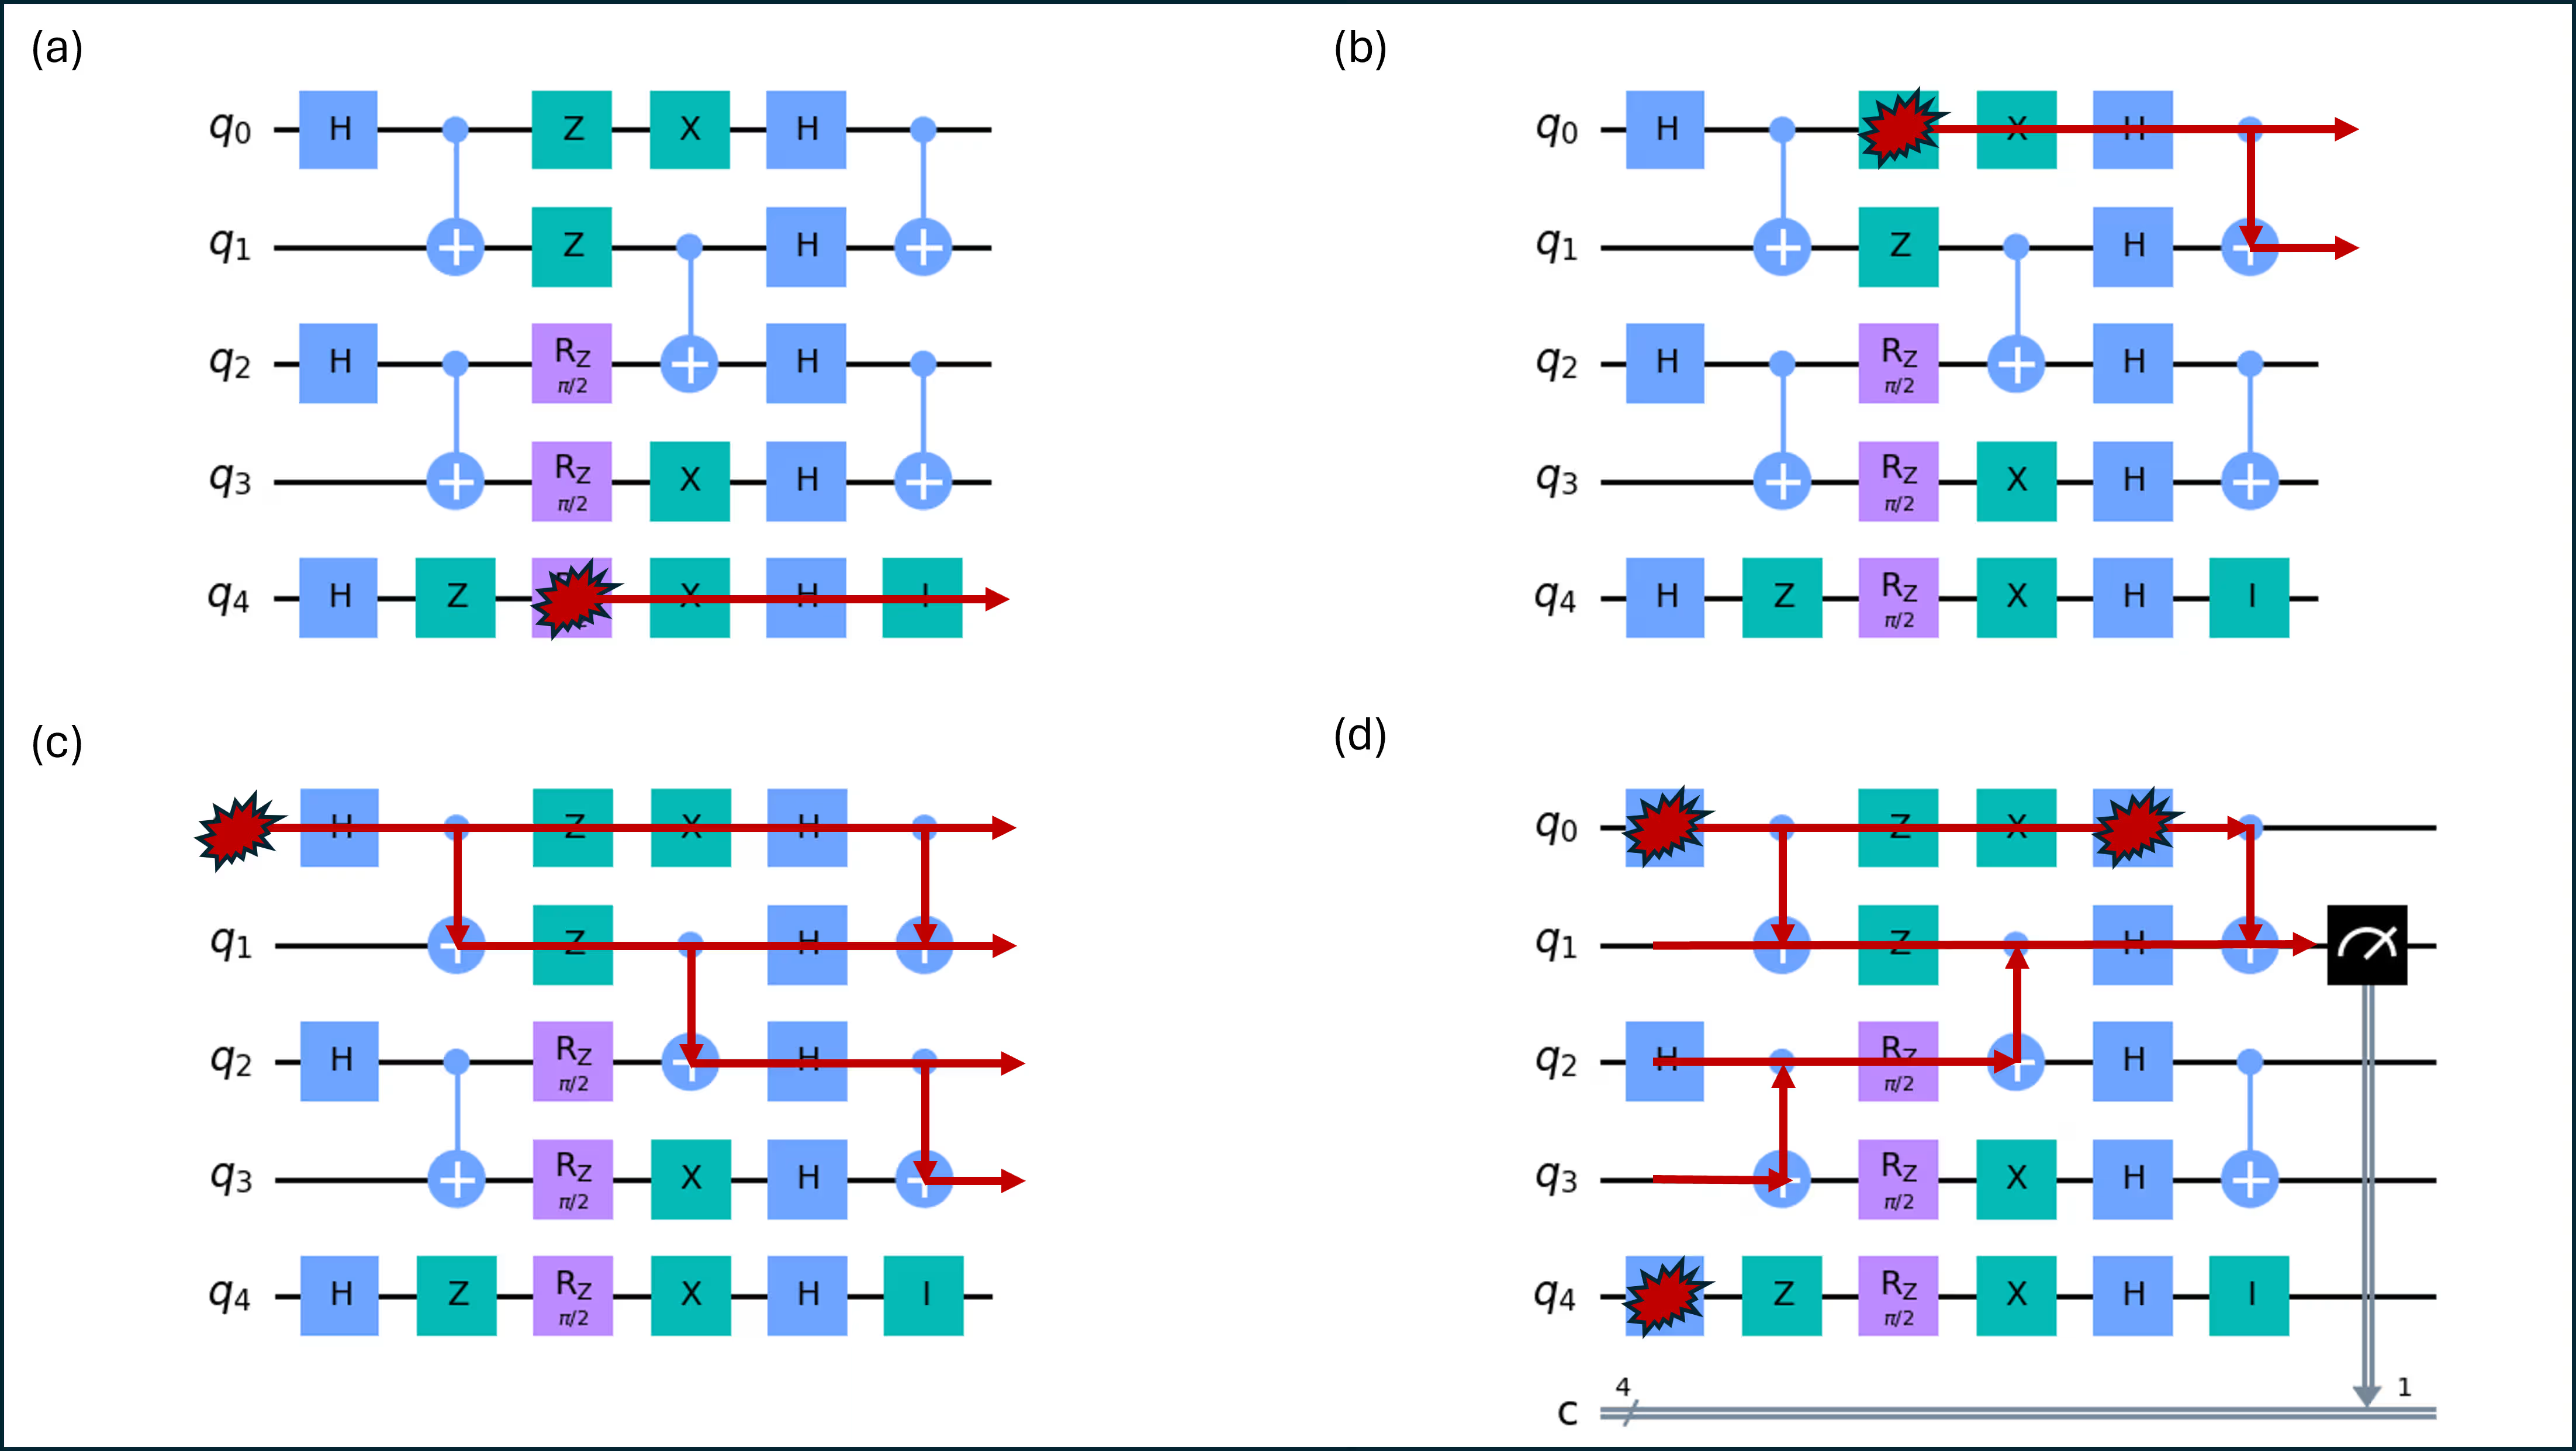
Choć mogłeś nie myśleć o tym w ten sposób, jest to swego rodzaju diagram czasoprzestrzenny. Oś pionowa na obwodzie kwantowym reprezentuje różne kubity rozmieszczone w przestrzeni. Oś pozioma reprezentuje czas, w którym stosowana jest sekwencja bramek. Zapożyczając terminologię z teorii względności, stożek świetlny reprezentuje obszar czasoprzestrzeni osiągalny z danego punktu poprzez interakcje przyczynowe.
Na powyższym rysunku typ błędu nie został określony. Okazuje się, że typ błędu wpływa na stożek świetlny, ponieważ niektóre błędy wpływają na logikę bramki dwukubitowej, a inne nie. Wrócimy do tego wkrótce. Na razie potraktuj żółte linie jako ścieżki potencjalnego rozprzestrzeniania się pewnego typu błędu. Zauważ, na przykład w części (a) rysunku, że błąd jednokubitowy na bramce RZ na kubicie 4 może rozprzestrzeniać się w przód w czasie tylko na tym jednym kubicie. Nie może rozprzestrzenić się na inne kubity, ponieważ kubit 4 nie jest splątany z żadnym innym kubitem. To dobry moment, aby zauważyć, że kubit 4 jest w tym obwodzie dość bezużyteczny, a rzeczywiście cały obwód został zbudowany wyłącznie w celach dydaktycznych.
Błąd na bramce Z kubitu 0 (niekoniecznie błąd typu Z, po prostu jakiś błąd w tym miejscu) może jednak rozprzestrzenić się na inny kubit: kubit 1, poprzez końcową bramkę CNOT, która używa kubitu 0 jako kontrolnego, a kubitu 1 jako docelowego. Pokazano to w części (b). Jak można się spodziewać, błąd wcześniej w obwodzie będzie miał częściej szansę rozprzestrzenić się na więcej kubitów. Część (c) pokazuje, że błąd w początkowym przygotowaniu stanu kubitu 0 może rozprzestrzenić się na wszystkie kubity oprócz kubitu 4, który jest izolowany.
Ten układ pokazuje, jak błąd może rozprzestrzeniać się w przód w czasie, wpływając na pomiary. Ale możesz też zbadać odwrotne pytanie: dla konkretnego jednokubitowego pomiaru, które części mojego obwodu mogły wnieść do niego jakiś błąd? W takim przypadku po prostu zaczynasz od pomiaru lub innego interesującego punktu i cofasz się (w czasie) przez obwód, podążając za wszelkimi obwodami splątującymi, jak pokazano w części (d). Pokazano również kilka losowo wybranych punktów, w których mogą wystąpić błędy.
Na powyższym rysunku błędy rozprzestrzeniają się między kubitami za pomocą bramek ECR, ale podobna dyskusja mogłaby dotyczyć innych bramek dwukubitowych. Bramki te mają kubit kontrolny i docelowy. Jasne jest, że błąd na kubicie kontrolnym może wpłynąć na logikę bramki i tym samym skutkować błędem na kubicie docelowym. Ale co z drugim kierunkiem? Czy błąd na kubicie docelowym może rozprzestrzenić się na kubit kontrolny? Przypomnij sobie, że sprzężenie między kontrolą a celem dla bramek ECR nie jest czysto typu ZX; ma również niepożądane sprzężenie ZZ.
Jeśli błąd na kubicie docelowym komutuje ze sprzężeniem ZZ, to nie może się on rozprzestrzenić na kubit kontrolny. Możemy to zobaczyć poprzez mechanizmy fizyczne, które tu działają. Szybkim sposobem, aby to zobaczyć, jest to, że jeśli błąd komutuje z , to ich kolejność można zamienić bez wpływu na wynik. Jednakże, jeśli występujący tuż przed sprzężeniem jest tym samym, co działanie po sprzężeniu , to nie może to wpłynąć na kontrolę, ponieważ w tym drugim przypadku błąd musiałby przemieszczać się wstecz w czasie. Jeśli błąd nie komutuje ze sprzężeniem ZZ, to może rzeczywiście rozprzestrzenić się z celu z powrotem na kontrolę. Zatem w przypadku bramki ECR błędy Z nie mogłyby rozprzestrzenić się z celu na kontrolę, ale błędy X lub Y mogłyby.
Sprawdź swoje zrozumienie
W części (d) powyższego rysunku spójrz na pionowe linie między kubitami 0 i 1. Czy słuszne jest, że niektóre błędy mogłyby rozprzestrzenić się wzdłuż tych linii? Ponownie, może to zależeć od typu błędu, a jeszcze tego nie omówiliśmy. Pytanie brzmi, czy istnieje jakiś błąd, który mógłby się rozprzestrzenić tak, jak pokazują te pionowe linie. Wyjaśnij.
Odpowiedź
Tak, mają rację. Szkicując stożek świetlny wstecz od pomiaru, można odnieść wrażenie, że twierdzisz, że coś przemieszcza się z celu do kontroli. Jednak znaczenie diagramu polega w rzeczywistości na tym, że błąd mógł przemieścić się z kontroli (kubit 0) do celu (kubit 1), aby spowodować błąd w interesującym nas punkcie. Jeśli twoja intuicja mówi, że zależy to od typu błędu, masz absolutną rację. Zostanie to częściowo omówione w następnej sekcji.
Zaczynając od wolnej od błędów wersji obwodów z powyższego diagramu, prześledź potencjalne rozprzestrzenianie się błędu na pierwszej bramce Hadamarda działającej na kubicie 2. Wymień wszystkie kubity, które mogłyby zostać dotknięte do końca obwodu, jeśli błąd jest (a) odwróceniem fazy oraz (b) odwróceniem bitu. Wskazówka: pomyśl o tym, jak informacja na każdym kubicie jest wykorzystywana.
Odpowiedź
(a) Kubit 3 mógłby zostać dotknięty, podobnie jak oczywiście sam kubit 2. Żaden inny! Jeśli wymieniłeś kubity 0 i 1, zauważ, że kubit 2 jest celem bramki ECR splątującej go z kubitem 1. W tej bramce żadna zmiana nie zachodzi na kubicie 1. (b) Kubity 0-3 mogłyby zostać dotknięte. Odwrócenie bitu, czyli błąd typu X, nie komutuje ze sprzężeniem ZZ w bramce ECR i dlatego może rozprzestrzenić się z celu na kontrolę.
Rozprzestrzenianie się błędu
W poprzedniej sekcji omówiliśmy rozprzestrzenianie się błędu bez podania jego formalnej definicji. W dalszej części:
Dla błędu , który występuje przed pewną częścią logicznej treści obwodu , rozprzestrzenianie się błędu oznacza znalezienie równoważnego operatora , który odtwarza ten sam błędny wynik, gdy zostanie zastosowany po zamiast przed nim.
Obraz rozprzestrzeniania się błędu z poprzedniej sekcji sugerował, że błędy mogą rozprzestrzeniać się z kubitu kontrolnego na kubit docelowy poprzez bramkę CNOT. Jednym ze sposobów sprawdzenia, kiedy jest to prawdą, jest rozważenie błędu na kubicie kontrolnym lub docelowym przed splątaniem i sprawdzenie, czy ten operator komutuje z bramką CNOT. Jeśli oba operatory komutują, to nie ma różnicy, czy zastosujesz je w odwrotnej kolejności, co oznacza, że błąd mógłby zostać po prostu „przesunięty za” bramkę CNOT bez wpływu na inne kubity. Jest to najczęstszy sposób, w jaki ludzie podchodzą do rozprzestrzeniania się błędów, i daje on następujące reguły:
Niech kontrolą będzie kubit 0, a celem kubit 1. Rozważ błędy X i Z na kubitach kontrolnym i docelowym (, , i odpowiednio). Przesunięcie tych błędów za sprawia, że błędy stają się:
Podajemy powyższe bez dowodu. Ale jeśli jesteś jak autor tej lekcji i wolisz obraz Schr"odingera, możesz również zapisać dowolne stany kontrolny i docelowy, zastosować błąd, następnie CNOT, i zbadać stan końcowy. Jeśli porównasz ten stan końcowy z przypadkiem bez błędu, możesz zobaczyć, jaka kombinacja błędów zastosowana po bramce CNOT dałaby błędny stan, a w szczególności możesz zobaczyć, czy operacja błędu rozprzestrzeniła się z jednego kubitu na drugi.
| Stan początkowy kontrolny | Stan początkowy docelowy | Błąd | Stan końcowy | Odpowiednik błędu po CNOT |
|---|---|---|---|---|
| Brak | Nie dotyczy | |||
| X na kubicie kontrolnym | ||||
| Z na kubicie kontrolnym | ||||
| X na kubicie docelowym | ||||
| Z na kubicie docelowym |
Być może zaskakująco, błąd Z na celu rzeczywiście powoduje rozprzestrzenienie błędu z powrotem na kontrolę!
Jak można sobie wyobrazić, śledzenie takiego rozprzestrzeniania się operatorów błędów w przód przez obwody (lub równoważnie, propagowanie wstecz operatorów do zmierzenia) jest skomplikowane. Qiskit posiada narzędzia ułatwiające to zadanie, o których dowiemy się w lekcji 6 poświęconej nowoczesnym przepływom pracy.
Istnieje dodatek Qiskit o nazwie Shaded Lightcones. Dodatek shaded lightcones (SLC) analizuje rozprzestrzenianie się błędów w obwodach kwantowych, wykorzystując propagację Pauliego do zidentyfikowania, które części obwodu mogą faktycznie wpłynąć na docelową obserwablę. Jest zaprojektowany przede wszystkim, aby uczynić łagodzenie błędów bardziej wydajnym, zwłaszcza dla przepływów pracy probabilistycznego anulowania błędów (PEC). Zbadamy to narzędzie tutaj tylko pokrótce, a szerzej wykorzystamy je w kontekście technik łagodzenia błędów w przyszłych lekcjach. Wykorzystuje ono propagację operatorów Pauliego do wyznaczenia rozprzestrzeniania się błędów różnych typów, tworząc stożek świetlny dla błędów typu X, Y i Z.
Zacienione stożki świetlne (SLC, Shaded lightcones) idą dalej, wykorzystując symulacje klasyczne, aby ściślej ograniczyć wrażliwość na błędy w całym obwodzie. Wymienia to część czasu QPU na czas CPU i zmniejsza narzut próbkowania potrzebny do renormalizacji obciążenia. Zamiast twardego progu, każdemu potencjalnemu błędowi w obwodzie przypisywany jest stopniowany „cień”, który ogranicza od góry wrażliwość obserwabli na ten błąd. Ta udoskonalona charakterystyka pozwala na bardziej efektywne, ukierunkowane zastosowania PEC ze zmniejszoną wariancją, dając jednocześnie użytkownikowi możliwość kontrolowanego dostrajania obciążenia w estymacji obserwabli. Więcej szczegółów znajdziesz w Lightcone shading for classically accelerated quantum error mitigation.
Nie przedstawimy tutaj pełnego przepływu pracy. Pokażemy jedynie schematycznie, jak ten przepływ pracy przetwarza obwód:

Przepływ pracy dzieli obwód na „pudełka” przydatne do uczenia się zachowania szumu:

Na koniec wykorzystuje propagację operatorów i uczenie się szumu, aby wytworzyć cieniowaną mapę wrażliwości na błędy w całym obwodzie:
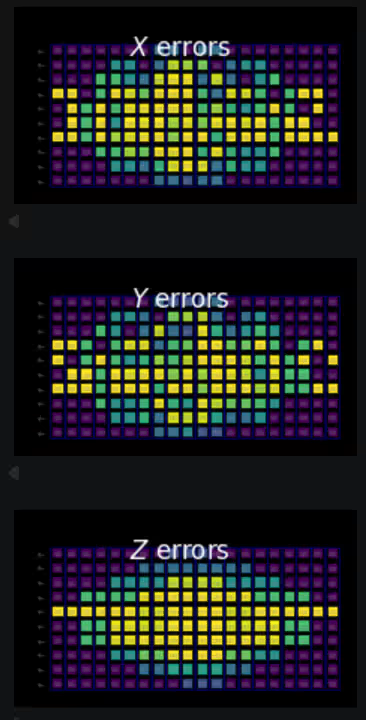
Każde kolorowe pole na wyjściu odpowiada konkretnemu kubitowi w konkretnym momencie. Najciemniejsze (fioletowe) pola wskazują kubit i warstwę, w której błąd nie może rozprzestrzenić się do interesujących nas pomiarów. Najjaśniejsze (żółte) pola odpowiadają kubitowi i warstwie, w której błąd może mieć silny wpływ na interesujące nas pomiary.
Zwróć uwagę na fioletowe obszary po prawej stronie każdej mapy. Błąd w tej samej warstwie co pomiar, ale na innym kubicie, nie może wpłynąć na pomiar poprzez pokazaną łączność obwodu. Podobnie błąd o jedną warstwę wcześniej w czasie (jedna warstwa w lewo) może rozprzestrzenić się jedynie na sąsiedni kubit w kolejnym kroku, ze względu na strukturę warstwy splątującej, i tak dalej. Dlatego kształt stożka po prawej stronie jest zjawiskiem ogólnym, gdy w interesującym nas pomiarze uczestniczy stosunkowo niewiele kubitów.
Sprawdź swoje zrozumienie
Czy uważasz, że lepiej jest tworzyć cieniowaną mapę światłostożka przed czy po transpilacji? Dlaczego?
Odpowiedź
Musi to być zrobione po transpilacji. Aby te różne mapy były użyteczne, musimy upewnić się, że sąsiadujące kubity w naszym obwodzie odpowiadają sąsiadującym kubitom na naszym chipie kwantowym. W przeciwnym razie bramki splątujące pokazane jako działające na sąsiadujących kubitach na diagramie obwodu wymagałyby ostatecznie bramek SWAP i bardziej skomplikowanej struktury obwodu.