Postselekcja z nie-markowowskimi kontrolami błędów
Ten przewodnik wyjaśnia, czym są nie-markowowskie kontrole błędów i jak zaimplementować je programowo za pomocą qiskit-mitigation. Zaczniesz od małego, dwukubitowego przykładu, aby zwizualizować kontrole i omówić, jak działają. Gdy zbudujesz już pewną intuicję, wypróbujesz przykład z 20 kubitami, w którym zaimplementujesz kontrole i porównasz różne strategie postselekcji.
Czym są nie-markowowskie kontrole błędów?
Nie-markowowskie kontrole błędów to oparte na pomiarach testy tego, czy stan kubitu jest prawdopodobnie zniekształcony przez nie-markowowskie źródło błędów. Test polega na umieszczeniu na każdym kubicie na początku obwodu bramki odwracającej bit o wydłużonym czasie trwania (xslow lub szereg bramek rx o kącie ), po której następuje zwykła XGate, a następnie na pomiarze w celu upewnienia się, że stan został pomyślnie odwrócony . Test ten można też wykonać na końcu obwodu po każdym pomiarze końcowym, aby upewnić się, że urządzenie potrafi pomyślnie odwrócić zmierzony stan kubitu z . Próbki powiązane z nieudanymi kontrolami można uznać za niewiarygodne, a postselekcja tylko próbek, które przechodzą wszystkie kontrole, może zwiększyć wierność zaszumionego rozkładu.
Strategie postselekcji na podstawie nie-markowowskich kontroli błędów
-
Postselekcja oparta na węzłach: zachowaj tylko próbki, w których każdy kubit przeszedł swoje kontrole. Jest to najściślejsza strategia i zazwyczaj prowadzi do odrzucenia większej liczby próbek.
-
Postselekcja oparta na krawędziach: dla każdej krawędzi w grafie sprzężeń kubitów upewnij się, że co najmniej jeden kubit przechodzi kontrole. Ta strategia jest łagodniejsza; jeśli kubit nie przejdzie kontroli, próbka może nadal zostać zachowana, jeśli wszyscy jego sąsiedzi przejdą swoje kontrole.
Kubity-obserwatorzy
Można określić pomocnicze kubity „obserwatorów” sąsiadujące z kubitami użytymi do wykonania oryginalnego obwodu. Na tych obserwatorach można umieścić nie-markowowskie kontrole błędów, zapewniając większe pokrycie przed nie-markowowskim szumem, który te kontrole mają wykrywać.
Część 1. Wizualizacja nie-markowowskich kontroli błędów
Zanim pokażesz tę technikę na QPU, utworzysz mały, dwukubitowy obwód i dodasz kontrole, aby zwizualizować, jak to działa. Zacznij od stanu Bella poddanego transpilacji do QPU backendu ibm_kingston.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "qiskit_mitigation": "qiskit-mitigation", "samplomatic": "samplomatic"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService(channel="ibm_quantum_platform")
backend = service.backend("ibm_kingston")

qc = QuantumCircuit(2)
qc.h(0)
qc.cx(0, 1)
qc.measure_all()
qc_isa = generate_preset_pass_manager(
    optimization_level=0, backend=backend
).run(qc)
qc_isa.draw("mpl")

Dodaj kilka nie-markowowskich kontroli błędów na początku obwodu. Kontrole zostaną umieszczone tylko na kubitach, które kończą się pomiarem. Kontrole te zapewniają, że urządzenie potrafi pomyślnie odwrócić początkowy stan kubitu z , a pomiary tych kontroli są odczytywane do nowego rejestru klasycznego o nazwie meas_pre.
from qiskit.transpiler import PassManager
from qiskit_mitigation.postselection.passes import (
    AddPreCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager([AddPreCircuitNonMarkovianErrorChecks()]).run(
    qc_isa
)
qc_w_checks.draw("mpl", idle_wires=False)

Podobnie możesz dodać kontrole na końcu obwodu po każdym pomiarze końcowym. Kontrole te zapewniają, że urządzenie potrafi odwrócić stan kubitu z , a ich pomiary są odczytywane do nowego rejestru klasycznego o nazwie meas_ps.
from qiskit_mitigation.postselection.passes import (
    AddPostCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager([AddPostCircuitNonMarkovianErrorChecks()]).run(
    qc_w_checks
)
qc_w_checks.draw("mpl", idle_wires=False)

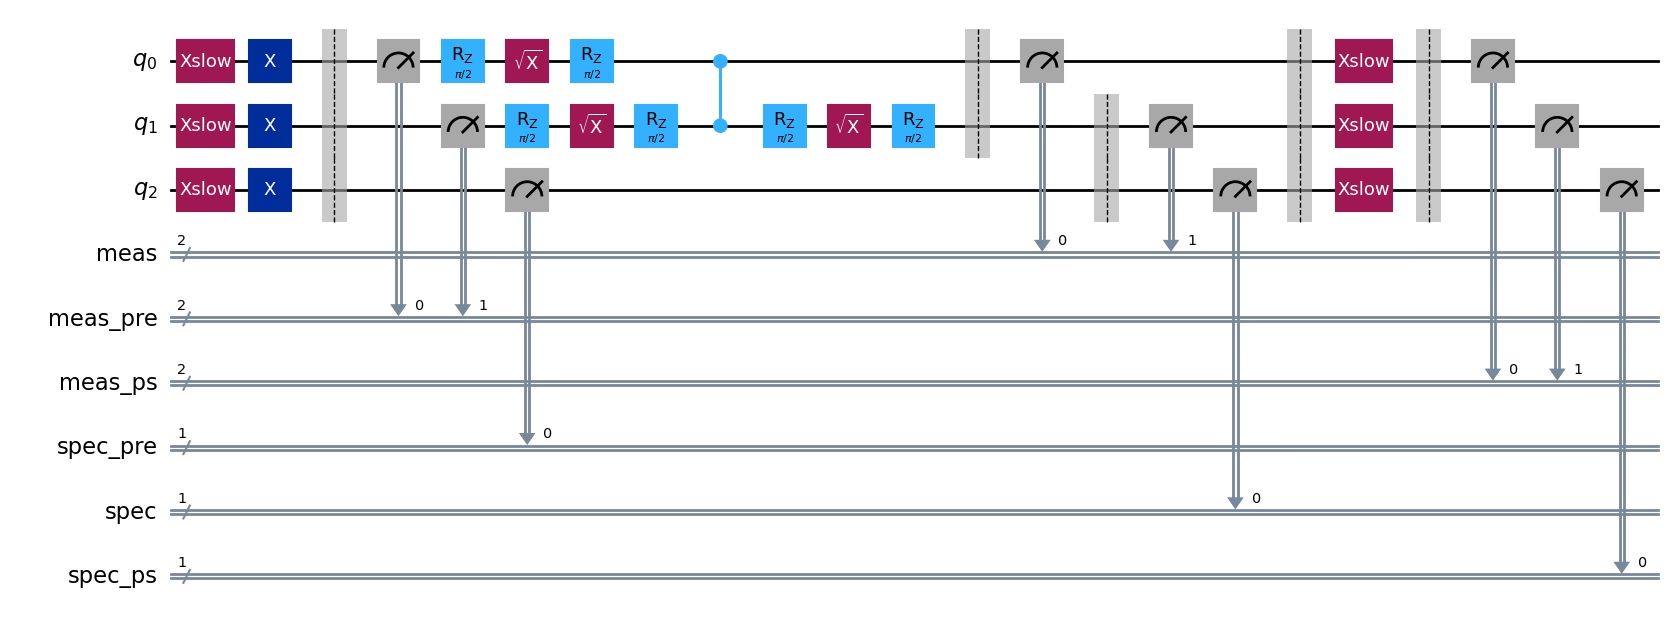
Jak wspomniano we wstępie, możesz użyć kubitów pomocniczych (ancilla) sąsiadujących z kubitami danych jako „obserwatorów” (spectators), aby zapewnić szersze pokrycie błędów. Dodaj kontrole obserwatorów przed obwodem i po obwodzie. Widać, że ponieważ fizyczny kubit 2 na ibm_kingston sąsiaduje z kubitem danych 1, został dodany jako obserwator i dodano do niego kontrole przed obwodem i po obwodzie. Pomiary obserwatorów zostały dodane do nowych rejestrów klasycznych o nazwach spec_pre i spec.
Taki obwód zawiera wszystkie możliwe kontrole błędów niemarkowowskich, więc próbkowanie z tego obwodu daje użytkownikom możliwość postselekcji na podstawie dowolnej kombinacji kontroli [przed/po] obwodzie i strategii postselekcji opartej na [węzłach/krawędziach]. W części 2 tego przewodnika zobaczysz, jak to działa na sprzęcie kwantowym.
from qiskit_mitigation.postselection.passes import (
    AddSpectatorPostCircuitNonMarkovianErrorChecks,
    AddSpectatorPreCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager(
    [
        AddSpectatorPreCircuitNonMarkovianErrorChecks(
            coupling_map=backend.coupling_map
        ),
        AddSpectatorPostCircuitNonMarkovianErrorChecks(
            coupling_map=backend.coupling_map
        ),
    ]
).run(qc_w_checks)
qc_w_checks.draw("mpl", idle_wires=False, fold=-1)
Część 2: Demonstracja kontroli błędów niemarkowowskich na QPU i porównanie strategii postselekcji
Skoro rozumiesz już, czym są kontrole błędów niemarkowowskich i jak się je implementuje w oprogramowaniu, możesz uruchomić większy przykład na QPU i zobaczyć, jak to działa. Najpierw przygotuj obwód. Wybór obwodu nie jest zbyt istotny; potrzebujesz tylko obwodu, którego wynik łatwo zweryfikować. Tutaj wybieramy 20-kubitowy, jednowymiarowy lustrzany obwód Isinga. Wykonanie tego obwodu na sprzęcie nie jest trywialne i powinien on podlegać błędom niemarkowowskim, co daje okazję do zademonstrowania skuteczności kontroli błędów niemarkowowskich. Ponadto struktura lustrzana pozwala w prosty sposób porównać zaszumione wartości oczekiwane z wartościami dokładnymi.
W tym eksperymencie obliczamy wartości oczekiwane obserwabli. Wybór obserwabli również nie jest istotny, więc po prostu wybieramy średnią jednowęzłową magnetyzację .
import numpy as np
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import CouplingMap

num_qubits = 20
initial_layout = initial_layout = [
    124,
    125,
    126,
    127,
    128,
    129,
    130,
    131,
    132,
    133,
    134,
    135,
    139,
    155,
    154,
    153,
    152,
    151,
    150,
    149,
][:num_qubits]
coupling_map = CouplingMap.from_line(num_qubits, bidirectional=False)

# Num Trotter steps and `rx` angle
num_steps = 6
theta_rx = np.pi / 6

# Average single-site magnetization
observable = (
    SparsePauliOp(
        [
            "I" * iq + "Z" + "I" * (num_qubits - iq - 1)
            for iq in range(num_qubits)
        ]
    )
    / num_qubits
)

# Create the Trotter circuit
circuit = QuantumCircuit(num_qubits)
edges = CouplingMap.from_line(num_qubits, bidirectional=False).get_edges()
edges_a = [e for e in edges if e[0] % 2 == 0]
edges_b = [e for e in edges if e[0] % 2 == 1]
for _ in range(num_steps):
    circuit.rx(theta_rx, [i for i in range(num_qubits)])
    for edge in edges_a:
        circuit.cz(edge[0], edge[1])
    for edge in edges_b:
        circuit.cz(edge[0], edge[1])
circuit = circuit.compose(circuit.inverse())
circuit.measure_all()

# Transpile circuit to backend
pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=initial_layout
)
isa_circuit = pm.run(circuit)
print(
    f"two-qubit depth: {isa_circuit.depth(lambda instr: instr.operation.num_qubits == 2)}"
)
print(f"total depth:     {isa_circuit.depth()}")
isa_circuit.draw("mpl", fold=-1, idle_wires=False)
two-qubit depth: 24
total depth:     85
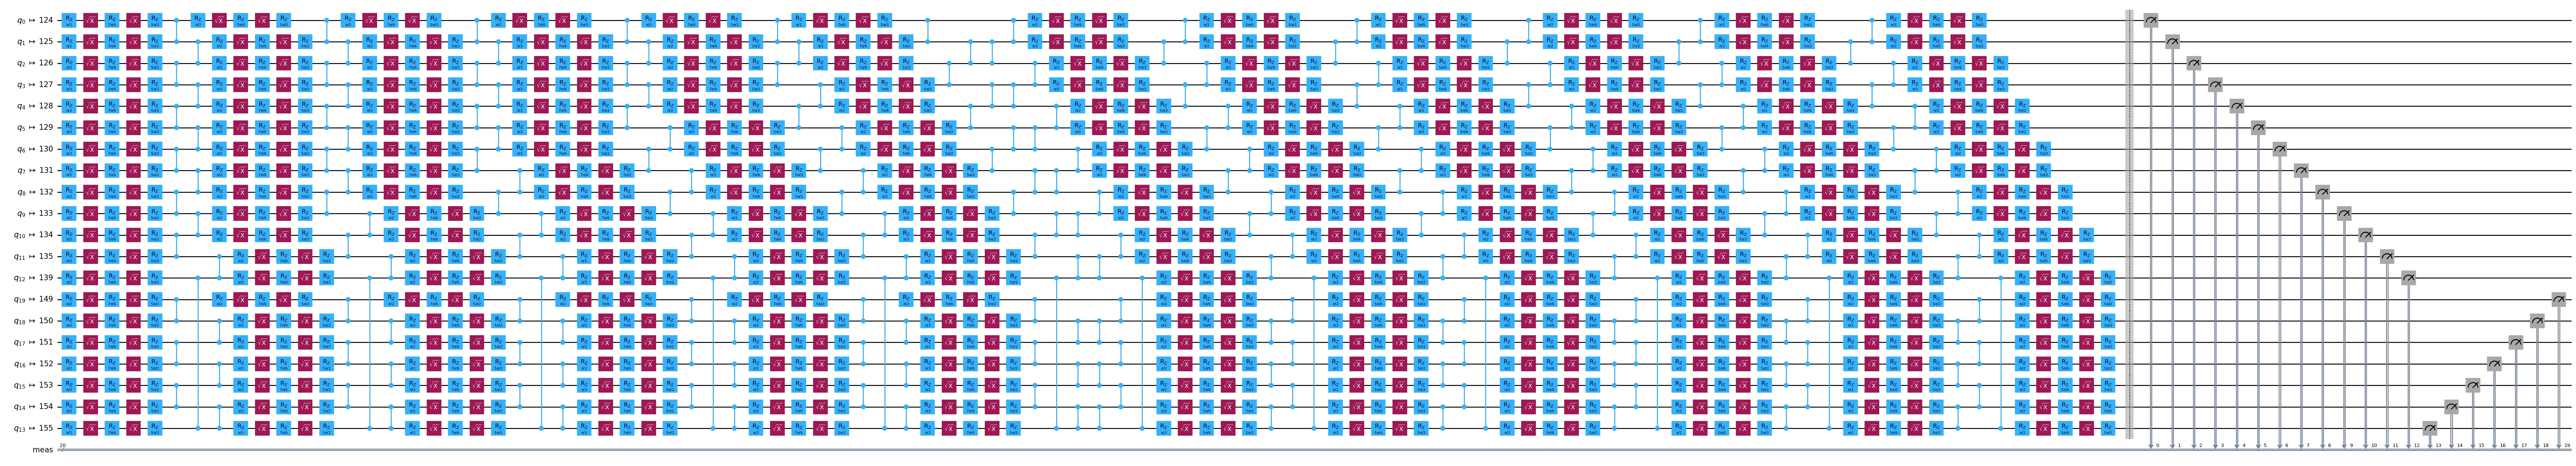
Teraz dodajemy kontrole przed obwodem i po obwodzie na każdym kubicie, łącznie z siedmioma sąsiednimi kubitami-obserwatorami. Gdy dodasz do obwodu wszystkie możliwe kontrole, możesz zdecydować, której strategii postselekcji użyć podczas przetwarzania końcowego.
# Use all non-Markovian error checks so we can compare all strategies in post-processing.
combined = PassManager(
    [
        AddPreCircuitNonMarkovianErrorChecks(x_pulse_type="rx"),
        AddSpectatorPreCircuitNonMarkovianErrorChecks(
            backend.coupling_map, x_pulse_type="rx"
        ),
        AddPostCircuitNonMarkovianErrorChecks(x_pulse_type="rx"),
        AddSpectatorPostCircuitNonMarkovianErrorChecks(
            backend.coupling_map, x_pulse_type="rx"
        ),
    ]
).run(isa_circuit)
combined_isa = generate_preset_pass_manager(
    optimization_level=0, backend=backend
).run(combined)

print("cregs:", [(c.name, c.size) for c in combined_isa.cregs])
cregs: [('meas', 20), ('meas_pre', 20), ('spec_pre', 7), ('meas_ps', 20), ('spec', 7), ('spec_ps', 7)]
Użyj prymitywu Executor, aby spróbkować obwód zawierający kontrole.
from qiskit_ibm_runtime import Executor
from samplomatic.quantum_program import QuantumProgram

# Raw and combined-checks circuits in a single 100k-shot program so they share calibration.
program = QuantumProgram(shots=100_000)
program.append_circuit_item(isa_circuit)  # raw circuit, no checks
program.append_circuit_item(
    combined_isa
)  # combined pre + post non-Markovian error checks
job = Executor(backend).run(program)
print(f"job id: {job.job_id()}")
print(f"status: {job.status()}")
job id: d9badrm6hjac73ffe31g
status: QUEUED
Klasa PostSelector zna strukturę creg kontroli, więc potrafi powiązać każdy bit w próbkach z odpowiadającym mu pomiarem obwodu. Jej metody compute_mask można użyć do utworzenia maski dla sekwencji próbek, podając strategię postselekcji (węzłową lub krawędziową) oraz typ kontroli błędów niemarkowowskich, które mają być brane pod uwagę (przed obwodem lub po obwodzie). Aby połączyć strategie przed obwodem i po obwodzie w jedną maskę, można obliczyć ich maski niezależnie, a następnie połączyć je operacją AND. Tutaj używamy PostSelector do utworzenia masek dla wszystkich strategii i przeglądamy wyniki dla każdej dostępnej permutacji strategii.
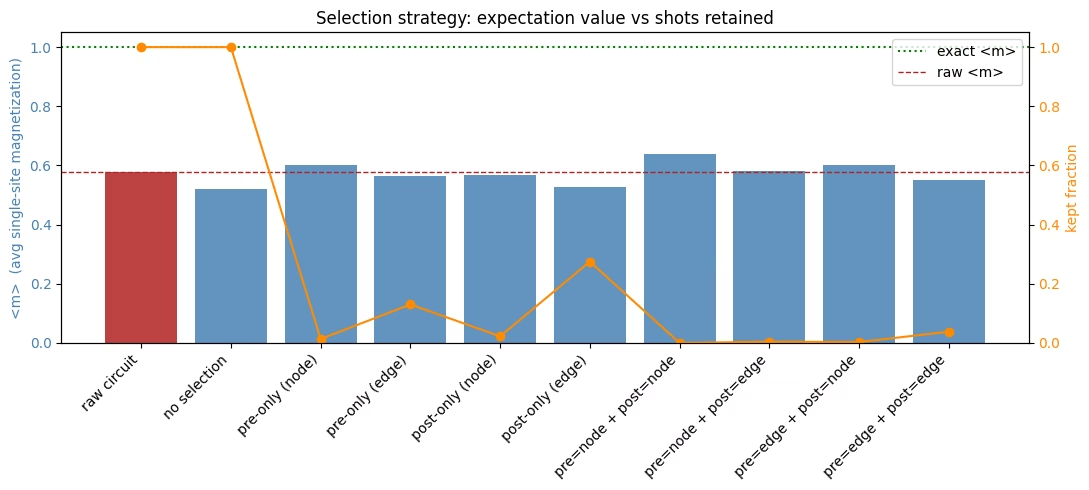
Na poniższej wizualizacji widać, jak strategia postselekcji wpływa na współczynnik postselekcji oraz na jakość odpowiedzi. Zgodnie z oczekiwaniami strategie oparte na postselekcji węzłowej dały najniższe współczynniki postselekcji. Strategie oparte na krawędziach są łagodniejsze i zwykle dają wyższe współczynniki postselekcji. Użytkownicy powinni poeksperymentować z różnymi strategiami na swoim problemie, aby określić właściwą równowagę między współczynnikiem postselekcji a jakością próbkowanego rozkładu. W tym przykładzie użycie postselekcji węzłowej z kontrolami przed obwodem i po obwodzie dało najlepszą odpowiedź przy współczynniku postselekcji .028%. Niektóre strategie nie przewyższyły surowego obwodu. Widać też, że dodanie kontroli bez użycia żadnej z nich (słupek z etykietą „no selection” na wykresie poniżej) daje najgorszy wynik.
import matplotlib.pyplot as plt
from qiskit_mitigation.postselection import PostSelector

selector = PostSelector.from_circuit(combined_isa, backend.coupling_map)

exec_results = job.result()
# The Executor returns numpy arrays keyed by classical-register name, so each result item is
# already the {creg_name: ndarray} mapping that compute_mask expects.
raw_bits = exec_results[0]["meas"]  # raw circuit, no checks
bits = exec_results[1]  # combined pre+post circuit

meas_bits = bits["meas"]
total = meas_bits[..., 0].size

def magnetization(b, mask=None):
    """Average single-site magnetization over the (optionally masked) measurement bits."""
    kept = b if mask is None else b[mask]
    return (1 - 2 * kept.astype(int)).mean()  # bit 0 -> +1, bit 1 -> -1

rows = []

def report(label, mask=None, b=meas_bits):
    """Record and print the magnetization and kept fraction for one selection strategy."""
    kept = b[..., 0].size if mask is None else int(mask.sum())
    ev = magnetization(b, mask)
    rows.append((label, ev, kept / total))
    print(f"{label:<24}: <m> = {ev:+.4f}   (kept {kept:>6}/{total})")

# Compare all possible postselection strategies
report("raw circuit", b=raw_bits)
report("no selection")
for s in ("node", "edge"):
    report(f"pre-only ({s})", selector.compute_mask(bits, s, mode="pre"))
for s in ("node", "edge"):
    report(f"post-only ({s})", selector.compute_mask(bits, s, mode="post"))
for pre_s in ("node", "edge"):
    for post_s in ("node", "edge"):
        keep = selector.compute_mask(
            bits, pre_s, mode="pre"
        ) & selector.compute_mask(bits, post_s, mode="post")
        report(f"pre={pre_s} + post={post_s}", keep)

labels = [r[0] for r in rows]
evs = [r[1] for r in rows]
fracs = [r[2] for r in rows]
x = range(len(labels))

fig, ax1 = plt.subplots(figsize=(11, 5))

# Bars: expectation value per selection strategy.
bar_colors = ["firebrick"] + ["steelblue"] * (len(evs) - 1)
ax1.bar(x, evs, color=bar_colors, alpha=0.85)
ax1.axhline(1.0, color="green", ls=":", lw=1.5, label="exact <m>")
ax1.axhline(rows[0][1], color="firebrick", ls="--", lw=1, label="raw <m>")
ax1.set_ylabel("<m>  (avg single-site magnetization)", color="steelblue")
ax1.tick_params(axis="y", labelcolor="steelblue")
ax1.set_xticks(list(x))
ax1.set_xticklabels(labels, rotation=45, ha="right")
ax1.legend(loc="upper right")

# Line: fraction of shots retained (right axis).
ax2 = ax1.twinx()
ax2.plot(x, fracs, "o-", color="darkorange")
ax2.set_ylabel("kept fraction", color="darkorange")
ax2.tick_params(axis="y", labelcolor="darkorange")
ax2.set_ylim(0, 1.05)

ax1.set_title("Selection strategy: expectation value vs shots retained")
fig.tight_layout()
plt.show()
raw circuit             : <m> = +0.5791   (kept 100000/100000)
no selection            : <m> = +0.5211   (kept 100000/100000)
pre-only (node)         : <m> = +0.6026   (kept   1357/100000)
pre-only (edge)         : <m> = +0.5637   (kept  13029/100000)
post-only (node)        : <m> = +0.5682   (kept   2254/100000)
post-only (edge)        : <m> = +0.5265   (kept  27514/100000)
pre=node + post=node    : <m> = +0.6393   (kept     28/100000)
pre=node + post=edge    : <m> = +0.5799   (kept    442/100000)
pre=edge + post=node    : <m> = +0.6006   (kept    317/100000)
pre=edge + post=edge    : <m> = +0.5521   (kept   3836/100000)