PEC z SLC
Probabilistyczne usuwanie błędów (PEC) to technika łagodzenia szumu kwantowego w obliczeniach wartości oczekiwanych obserwabli. Pozwala obliczyć nieobciążone oszacowanie wartości oczekiwanych. Technika ta polega na wykonaniu zespołu zaszumionych obwodów, w które wstrzyknięto odwrotność nauczonego modelu szumu. Model szumu jest następnie przybliżany kanałem Pauliego za pomocą twirlingu Pauliego (znanego też jako randomized compiling). Takie modele szumu można uczyć się efektywnie i można je łagodzić za pomocą PEC (więcej szczegółów w Probabilistic error cancellation with sparse Pauli-Lindblad models on noisy quantum processors).
PEC wymaga wykładniczego narzutu strzałów, aby obliczyć nieobciążone oszacowanie. Shaded Lightcones (SLC) to technika, która wykorzystuje zasoby klasyczne do ograniczenia wrażliwości na błędy w całym obwodzie. Dzięki tym ograniczeniom użytkownik może w kontrolowany sposób dostrajać obciążenie w oszacowaniu obserwabli.
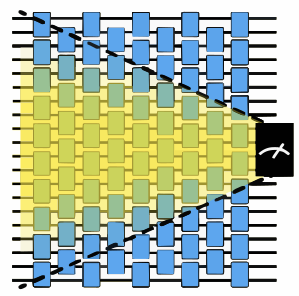
Ten przewodnik pokazuje, jak użyć PEC w połączeniu z SLC, aby łagodzić szum bramek przy mniejszym narzucie strzałów niż w zwykłym PEC.
Przebieg pracy jest następujący:
- Określ obwód i obserwablę.
- Oblicz zaszumione wartości oczekiwane bez mitygacji.
- Oblicz ograniczenia obciążenia w przód i wstecz.
- Naucz się szumu warstw splątujących za pomocą qiskit-noise-learning.
- Użyj nauczonego szumu, aby scalić obliczone ograniczenia w macierz skal lokalnych.
- Wybierz pożądane ograniczenie obciążenia na podstawie kompromisu między narzutem strzałów a obciążeniem.
- Przygotuj program PEC + SLC, wykonaj go i przeprowadź przetwarzanie końcowe.
- Porównaj zmitygowane wartości oczekiwane i narzut strzałów.
Określenie obwodu i obserwabli
Przygotuj obwód lustrzany trotteryzowanej ewolucji w czasie hamiltonianu jednowymiarowego łańcucha Isinga na ośmiu kubitach. Obwód odbijamy lustrzanie, aby zniwelować jego operator unitarny i uzyskać obwód tożsamościowy, dzięki czemu idealna wartość oczekiwana każdej obserwabli wynosi 1 i nie trzeba jej obliczać. Dodatkowo odbicie lustrzane podwaja głębokość obwodu, co z kolei podwaja wpływ szumu.
Użyj kąta , aby dynamika nie była klifordowska.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_addon_slc": "qiskit-addon-slc", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "qiskit_mitigation": "qiskit-mitigation", "qiskit_noise_learning": "qiskit-noise-learning", "samplomatic": "samplomatic"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import warnings

import numpy as np
from qiskit.circuit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_mitigation.utils import get_measurement_bases

warnings.filterwarnings("ignore")

def construct_ising_circuit(
    num_qubits: int,
    num_trotter_steps: int,
    rx_angle: float,
) -> QuantumCircuit:
    circuit = QuantumCircuit(num_qubits)

    for _ in range(num_trotter_steps):
        circuit.rx(rx_angle, range(num_qubits))
        for first_qubit in (1, 2):
            for idx in range(first_qubit, num_qubits, 2):
                # equivalent to Rzz(-pi/2):
                circuit.sdg([idx - 1, idx])
                circuit.cz(idx - 1, idx)

    return circuit

def prepare_basis(
    circuit: QuantumCircuit, basis: list[int]
) -> QuantumCircuit:
    # basis is a list of integer values from 0 to 3. These map to the basis measurement as:
    # 0 = I; 1 = Z; 2 = X; 3 = Y
    assert len(basis) == circuit.num_qubits

    out_circ = circuit.copy_empty_like()
    for qb, bas in enumerate(basis):
        if bas == 2:
            out_circ.h(qb)
        elif bas == 3:
            out_circ.rx(-np.pi / 2, qb)

    out_circ.barrier()
    out_circ.compose(circuit, inplace=True)
    return out_circ

def mirror_circuit(circuit: QuantumCircuit) -> QuantumCircuit:
    mirror_circ = circuit.copy_empty_like()
    mirror_circ.compose(circuit.inverse(), inplace=True)
    mirror_circ.barrier()
    mirror_circ.compose(circuit, inplace=True)
    mirror_circ.measure_active()
    return mirror_circ

# define observables
num_qubits = 8  # Width of the Ising chain
# The observable to measure: one X component (on qubit 2) and one Z component (on qubit 5)
target_obs_sparse = [("XZ", [2, 5], 1.0)]
observable = SparsePauliOp.from_sparse_list(
    target_obs_sparse, num_qubits=num_qubits
)

# Determine the measurement basis each qubit requires for this observable.
bases, _ = get_measurement_bases(observable)

# Instantiate the mirrored circuit and prepend the basis-preparation gates
num_trotter_steps = 6
rx_angle = np.pi / 4
circuit = construct_ising_circuit(num_qubits, num_trotter_steps, rx_angle)
mirrored_circuit = mirror_circuit(circuit)
mirrored_circuit = prepare_basis(mirrored_circuit, bases[0])
print("Visualization of 1 mirrored Trotter step")
prepare_basis(
    mirror_circuit(construct_ising_circuit(num_qubits, 1, rx_angle)), bases[0]
).draw("mpl", scale=0.6, fold=-1)
Visualization of 1 mirrored Trotter step

Obliczenie zaszumionych wartości oczekiwanych bez mitygacji
QuantumProgram zawiera obwód kwantowy i samplex w formacie odpowiednim dla prymitywu Executor. MitigationTask.prepare buduje QuantumProgram z obwodu, obserwabli i wartości parametrów oraz otacza obwód boxami zgodnie z podanymi opcjami boxingu. Ustaw opcję boxingu measure_annotations na "change_basis", aby obrócić pomiary do wymaganych baz, i dodaj add_tags: "unique_box", aby symulator mógł odwzorować model szumu na boxy obwodu. Program domyślnie przechodzi twirling Pauliego, który na sprzęcie zamienia szum koherentny w szum Pauliego, jakiego zakładają metody mitygacji. num_randomizations określa, ile instancji obwodu po twirlingu jest próbkowanych dla każdego obwodu, a shots_per_randomization określa, ile strzałów otrzymuje każda instancja, więc ich iloczyn jest limitem strzałów na obwód.
Jeśli masz dostęp do QPU, możesz wykonać program za pomocą Executor zbudowanego z backendu QiskitRuntimeService. Ten przykład używa AerSimulator do lokalnego uruchomienia programu. Jego opcja symulatora layer_noise_model wstrzykuje szum z podanego modelu szumu Pauliego-Lindblada do każdej warstwy bramek splątujących. Tutaj generujemy losowy model szumu Pauliego-Lindblada z błędem na warstwę bramek (EPLG) równym 0.01, prawie o rząd wielkości wyższym niż w typowych obecnych QPU Heron, aby wzmocnić efekt użycia SLC także w problemie małej skali.
from qiskit.circuit import CircuitInstruction
from qiskit.quantum_info import PauliLindbladMap, pauli_basis
from qiskit_aer import AerSimulator
from qiskit_ibm_runtime import Executor
from qiskit_mitigation import MitigationTask, find_combined_unique_layers
from samplomatic import Tag
from samplomatic.utils import get_annotation

def generate_random_pauli_lindblad_noise(
    layers,
    num_qubits: int,
    eplg: float = 3e-3,
    seed: int | None = None,
) -> list[tuple[CircuitInstruction, PauliLindbladMap]]:
    """Generate random Pauli-Lindblad noise over the full Pauli basis."""
    layer_noise_model = []
    for layer in layers:
        layer_instructions = layer.operation.params[0]
        contain_measurement = any(
            inst.name.startswith("measure") for inst in layer_instructions
        )
        if contain_measurement:  # do not add measurement noise
            layer_noise = PauliLindbladMap.identity(num_qubits)
        else:
            edges = [
                (inst.qubits[0]._index, inst.qubits[1]._index)
                for inst in layer_instructions
            ]  # extract the edges of the layer

            basis_paulis = [p for p in pauli_basis(2) if np.sum(p.x + p.z)]
            rng = np.random.default_rng(seed=seed)
            num_generators = len(basis_paulis)
            rates = rng.random(len(basis_paulis)) * eplg / num_generators

            layer_noise = PauliLindbladMap.from_sparse_list(
                [
                    (pauli.to_label(), edge, rate)
                    for pauli, rate in zip(basis_paulis, rates, strict=True)
                    for edge in edges
                ],
                num_qubits=num_qubits,
            )
        layer_noise_model.append((layer, layer_noise))
    return layer_noise_model

num_randomizations = 400
shots_per_randomization = 16

boxing_options = {"add_tags": "unique_box"}

# find the unique layers to generate the layered noise for
box_layers = find_combined_unique_layers(
    [mirrored_circuit], custom_boxing_options=boxing_options
)
layer_noise_model = generate_random_pauli_lindblad_noise(
    box_layers, num_qubits, eplg=1e-2, seed=42
)

# a local noisy simulator in place of a QPU backend
noisy_executor = Executor(
    AerSimulator(),
    options={"simulator": {"layer_noise_model": layer_noise_model}},
)

task = MitigationTask()
program = task.prepare(
    circuit=mirrored_circuit,
    observables=observable,
    parameters=None,
    num_randomizations=num_randomizations,
    shots_per_randomization=shots_per_randomization,
    custom_boxing_options=boxing_options,
)

program._semantic_role = "simulation"  # flag the program for the simulator
job_unmit_res = noisy_executor.run(program).result()
unmitigated_res = task.postprocess(job_unmit_res)

print(f"unmitigated result: {unmitigated_res.data.evs[0]}")
unmitigated result: 0.63125
Obliczenie ograniczeń obciążenia w przód i wstecz
Zanim poświęcisz jakikolwiek czas QPU na uczenie się szumu, SLC używa symulacji klasycznej, aby ograniczyć wkład każdego potencjalnego błędu w obciążenie obserwabli. Odbywa się to w dwóch uzupełniających się przejściach:
-
Propagacja w przód: każdy błąd Pauliego jest propagowany w przód przez resztę obwodu i obliczany jest jego komutator z obserwablą. Jedynie błąd antykomutujący z obserwablą może obciążyć wynik, więc to przejście daje górne ograniczenie wpływu każdego błędu w przód.
-
Propagacja wstecz: każdy błąd jest propagowany wstecz do początku obwodu i obliczany jest jego komutator ze stanem początkowym. Ponieważ obwód zaczyna się od stanu samych zer, błędy komutujące z nim nie mogą wpłynąć na wynik, co zacieśnia ograniczenie z drugiej strony.
Oba ograniczenia razem tworzą ciasne ramy wokół najgorszego wkładu każdego błędu w obciążenie. W następnym kroku te ograniczenia są scalane z nauczonymi współczynnikami szumu, aby uszeregować, które błędy warto korygować, a które można bezpiecznie pominąć. Opcja boxingu inject_noise_strategy="individual_modification" jest tu wymagana, aby każda adnotacja InjectNoise w obwodzie z boxami miała unikalną tożsamość, do której można przypisać ograniczenia SLC.
W przypadku problemów większej skali obliczenia te mogą wymagać znacznych klasycznych zasobów obliczeniowych.
from qiskit_addon_slc.bounds import (
    compute_backward_bounds,
    compute_forward_bounds,
    tighten_with_speed_limit,
)
from qiskit_mitigation import PEC

slc_boxing_options = {
    "add_tags": "unique_box",
    "inject_noise_strategy": "individual_modification",
}

slc_pec_task = PEC()

boxed_circuit, noise_model_paulis = (
    slc_pec_task.generate_slc_bounds_computation_input(
        mirrored_circuit, custom_boxing_options=slc_boxing_options
    )
)

forward_bounds = compute_forward_bounds(
    boxed_circuit, noise_model_paulis, observable
)
tighten_forward_bounds = tighten_with_speed_limit(
    forward_bounds, boxed_circuit, noise_model_paulis, observable
)
backward_bounds = compute_backward_bounds(boxed_circuit, noise_model_paulis)
Poznanie szumu warstw splątujących
Aby obliczyć ostateczne oszacowanie, jak bardzo każdy błąd wpływa na obciążenie wartości oczekiwanej, a także jak kosztowne byłoby jego skorygowanie, uczymy się współczynników szumu i stosujemy je do przewidywanych ograniczeń szumu obliczonych wcześniej.
PEC (a także PEC+SLC) zakłada model szumu po twirlingu dla każdej warstwy bramek splątujących w obwodzie. Jeśli zakładasz markowowski model szumu, przyjmuje się, że głębokość obwodu nie wpływa na kanał szumu danej warstwy splątującej. Dlatego należy nauczyć się tylko modelu szumu każdej unikalnej warstwy bramek splątujących. Obwód użyty w tym przewodniku można podzielić na dwie unikalne warstwy. Projektowanie obwodów tak, aby miały minimalny zestaw unikalnych warstw splątujących, jest ważne, jeśli chcesz uczyć się modelu szumu, ponieważ unikalne warstwy trzeba uczyć niezależnie. Jeśli w obwodzie jest zbyt wiele unikalnych warstw, uczenie się szumu może stać się niewykonalne z powodu kosztu próbkowania przy uczeniu się wielu warstw.
Do uczenia się szumu używany jest qiskit-noise-learning. Learner powtarza każdą warstwę fragment_depths razy w swoich obwodach uczących, wykonuje twirling każdego obwodu num_randomizations razy i dopasowuje zanik zmierzonych wierności do modelu Pauliego-Lindblada. Parametry te mogą wpływać na dokładność nauczonego modelu. Im dokładniejszy nauczony model szumu, tym dokładniejsze będzie usuwanie szumu.
Poniższy kod rysuje nauczony model szumu z dwiema warstwami połączonymi w jedną mapę. Każdy kubit jest wykresem kołowym swoich współczynników X, Y i Z o wadze 1, zsumowanych po obu warstwach, a każda krawędź pokazuje nauczone współczynniki o wadze 2. Na przykład współczynnik 3e-4 oznacza, że błąd ten występuje średnio przy około trzech na każde 10 000 użyć warstwy.
from qiskit.providers.fake_provider import GenericBackendV2
from qiskit.quantum_info import PauliList
from qiskit_ibm_runtime.results import LayerError, PauliLindbladError
from qiskit_ibm_runtime.visualization.embeddings import Embedding
from qiskit_noise_learning.aer_executor import AerExecutor
from qiskit_noise_learning.noise_learner import LearningOptions, NoiseLearner
from samplomatic import InjectNoise

line_coupling = [(i, i + 1) for i in range(num_qubits - 1)]
backend = GenericBackendV2(
    num_qubits=num_qubits,
    basis_gates=["id", "rz", "sx", "x", "cz"],
    coupling_map=line_coupling,
)

# first learn only the layers PEC will inject noise into, i.e. not the measurement layer
pec_layers = [
    layer
    for layer in slc_pec_task.find_unique_layers(
        mirrored_circuit, slc_boxing_options
    )
    if get_annotation(layer.operation, InjectNoise)
]
layers = slc_pec_task.find_unique_layers(mirrored_circuit, slc_boxing_options)

learning_options = LearningOptions(
    fragment_depths=[2, 4, 8, 16],
    num_randomizations=250,
    shots_per_randomizations=16,
)

# qiskit-noise-learning is not compatible with the Executor in local mode,
# and requires the simulator present in the package for running simulation
noise_dict = {
    get_annotation(layer.operation, Tag).ref: noise_layer
    for layer, noise_layer in layer_noise_model
}
noise_learner_simulator = AerExecutor(
    qasm_simulator=AerSimulator(), noise_dict=noise_dict
)
learner = NoiseLearner(
    backend, options=learning_options, executor=noise_learner_simulator
)
learned_noise = (
    learner.run(pec_layers).result().to_dict()
)  # keyed by InjectNoise reference

# Draw the learned model on the line, laid out as a line with the qubits in order.
# Composing the two layers' maps sums their rates, giving one map over all the edges.
embedding = Embedding(
    [(0, 0), (0, 2), (0, 4), (2, 4), (4, 4), (4, 2), (4, 0), (2, 0)],
    line_coupling,
)
first, second = learned_noise.values()
learned_model = first.compose(second).simplify()
error = PauliLindbladError(
    PauliList(
        learned_model.get_qubit_sparse_pauli_list_copy().to_pauli_list()
    ),
    learned_model.rates,
)
fig = LayerError(circuit, list(range(num_qubits)), error).draw_map(
    embedding, radius=0.4, height=460, width=620
)
fig.update_traces(
    marker={
        "cmin": 0,
        "cmax": max(learned_model.rates),
        "colorbar": {"tickformat": ".1e", "title": "rate"},
    },
    selector={"mode": "markers"},
)
fig.show()

Użycie nauczonego szumu do scalenia obliczonych ograniczeń w macierz skal lokalnych
Mając zarówno ograniczenia klasyczne (z poprzedniego kroku), jak i nauczone współczynniki szumu, możemy teraz obliczyć macierz skal lokalnych — wagę dla każdego błędu, która określa, jak agresywnie PEC powinno kasować każdy pojedynczy składnik szumu.
Kluczowa idea SLC polega na tym, że nie wszystkie błędy trzeba w pełni kasować. Błąd, którego ograniczenia w przód i wstecz są oba małe, ma pomijalny wpływ na obserwablę niezależnie od swojego współczynnika, więc można go zostawić częściowo lub całkowicie bez mitygacji. merge_bounds scala ograniczenia klasyczne z nauczonymi współczynnikami Pauliego-Lindblada, a następnie compute_local_scales przypisuje każdemu błędowi skalę od 0 (całkowicie ignorowany) do 1 (w pełni kasowany), zgodnie z określoną przez użytkownika wartością bias_tolerance. Błędy o dużym szacowanym wkładzie w obciążenie otrzymują skalę bliską 1 (pełne traktowanie PEC), a błędy o małym wkładzie otrzymują niższą skalę, co zmniejsza niesiony przez nie narzut próbkowania.
SLC udostępnia ciągłe pokrętło między dwoma skrajnościami — zwykłym PEC (zerowe obciążenie, najwyższy narzut) i brakiem mitygacji (zerowy narzut, pełne obciążenie szumem). Parametr bias_tolerance steruje tym pokrętłem: ustawienie go na 0 odtwarza pełne PEC, a większe wartości dopuszczają większe obciążenie resztkowe w zamian za niższy narzut próbkowania γ².
Ten krok przeszukuje bias_tolerance w zakresie wartości i oblicza wynikowy narzut próbkowania dla każdej z nich. Wykreślenie tych punktów na tle narzutu pełnego PEC pomaga wybrać punkt pracy dopasowany do Twojego budżetu strzałów. Na przykład tolerowanie 5 % obciążenia resztkowego może zmniejszyć narzut próbkowania o rząd wielkości w porównaniu z pełnym PEC, czyniąc obliczenia wykonalnymi na dzisiejszych QPU, na których inaczej by nie były.
import matplotlib.pyplot as plt
from qiskit_addon_slc.bounds import compute_local_scales, merge_bounds

merged_bounds = merge_bounds(
    boxed_circuit,
    tighten_forward_bounds,
    backward_bounds,
    noise_rates=learned_noise,
)

biases = []
costs = []
for bias in [0.0, *np.arange(0.01, 0.11, 0.01).tolist()]:
    _, cost_, bias_ = compute_local_scales(
        boxed_circuit,
        merged_bounds,
        noise_rates=learned_noise,
        bias_tolerance=bias,
    )
    biases.append(bias_)
    costs.append(cost_)

# Compute tha full PEC overhead and compare it with the overhead and bias of different SLC configurations
vanilla_gamma = slc_pec_task.calculate_gamma(
    slc_pec_task.boxed_circuit, learned_noise, 1
)

xticks = np.arange(0, 11, 2)

fig, ax = plt.subplots()
ax.scatter(
    [0], [vanilla_gamma**2], marker="D", c="tab:orange", label="full PEC"
)
ax.plot(
    100 * np.array(biases),
    np.array(costs),
    "o-",
    c="tab:blue",
    label="PEC+SLC",
)
ax.set_xticks(xticks, [f"{x:.2f}" for x in xticks])

ax.set_xlabel("Remaining bias [%]")
ax.set_ylabel(r"Sampling overhead, $\gamma^2$")
ax.grid()
ax.legend()
fig.suptitle("PEC sampling overhead reduction due to SLC")
Optimal spacetime partitioning not implemented! Just partitioning list of noisy boxes.
Text(0.5, 0.98, 'PEC sampling overhead reduction due to SLC')

Wybór pożądanego ograniczenia obciążenia na podstawie kompromisu między narzutem strzałów a obciążeniem
W tym przewodniku wybieramy tolerancję obciążenia równą 5%. Zauważ, że to obliczenie obciążenia opiera się na nauczonym modelu szumu, który może nie być idealnie zgodny z rzeczywistym szumem urządzenia.
chosen_bias_threshold = 0.05
local_scales, sampling_cost, bias = compute_local_scales(
    boxed_circuit, merged_bounds, learned_noise, bias_tolerance=bias
)
slc_pec_task.set_slc_local_scales(
    local_scales, float(np.sqrt(sampling_cost)), bias
)
Przygotowanie programu PEC + SLC, jego wykonanie i przetwarzanie końcowe
Mając wybrane skale lokalne, możemy zbudować pełny program wykonawczy PEC+SLC. Wywołanie PEC.prepare tworzy QuantumProgram, który koduje strategię wstrzykiwania antyszumu w adnotacjach boxów obwodu. Przekazanie noise_gain="slc_local_scales" nakazuje executorowi użyć wag dla poszczególnych błędów ustawionych przez set_slc_local_scales, zamiast stosować to samo pełne odwrotne wzmocnienie szumu do każdego błędu, jak robiłoby zwykłe PEC.
Aby uzyskać uczciwe porównanie, przygotowywane jest drugie zadanie PEC z noise_gain=0, co odpowiada pełnemu kasowaniu PEC bez dopuszczalnego obciążenia SLC. Oba programy są dodawane do tego samego QuantumProgram, więc współdzielą jedno zadanie wykonawcze — ich obwody są przeplatane i wykonywane razem, co oznacza, że ewentualny dryf sprzętu wpływa na oba w równym stopniu.
Po zakończeniu zadania postprocess zamienia surowe ciągi bitów z pomiarów na wartości oczekiwane, stosując odpowiedni współczynnik przeskalowania PEC γ dla każdego zadania.
program_pec = slc_pec_task.prepare(
    circuit=mirrored_circuit,
    observables=[observable],
    parameters=None,
    num_randomizations=num_randomizations,
    shots_per_randomization=shots_per_randomization,
    custom_boxing_options=slc_boxing_options,
    noise_maps=learned_noise,  # PEC option
    noise_gain="slc_local_scales",  # PEC option. Defines the usage of SLC
    max_sampling_overhead=100,  # PEC option
)

full_pec_task = PEC()
program_pec = full_pec_task.prepare(
    circuit=mirrored_circuit,
    observables=[observable],
    parameters=None,
    num_randomizations=num_randomizations,
    shots_per_randomization=shots_per_randomization,
    custom_boxing_options=boxing_options,
    quantum_program=program_pec,
    noise_maps=learned_noise,  # PEC option
    noise_gain=0,  # PEC option
    max_sampling_overhead=100,  # PEC option
)

# Execute
program_pec._semantic_role = (
    "simulation"  # flag the program for the simulator
)
job_pec_results = noisy_executor.run(program_pec).result()

# post-processing
pec_slc_res = slc_pec_task.postprocess(job_pec_results)
full_pec_res = full_pec_task.postprocess(job_pec_results)
Porównanie zmitygowanych wartości oczekiwanych i narzutu strzałów
Idealna wartość oczekiwana obwodu lustrzanego wynosi z konstrukcji 1, więc obciążenie dowolnego oszacowania to po prostu |1 - result|. Ta ostatnia komórka drukuje obok siebie obciążenie i łączną liczbę strzałów dla trzech scenariuszy:
-
Bez mitygacji: surowa zaszumiona wartość oczekiwana bez zastosowanego kasowania błędów.
-
Pełne PEC: kasowanie błędów bez obciążenia z użyciem pełnego odwrotnego modelu szumu na każdej warstwie, przy pełnym narzucie próbkowania γ².
-
PEC+SLC: kasowanie błędów kierowane skalami lokalnymi shaded lightcone, tolerujące wybraną wartość
bias_tolerancew zamian za znacznie mniejszą liczbę strzałów.
Porównanie trzech wierszy pokazuje konkretną korzyść z SLC: zmitygowane obciążenie PEC+SLC pozostaje znacznie poniżej obciążenia bez mitygacji, podczas gdy łączna liczba strzałów jest znacznie mniejsza niż wymagała jej pełna PEC.
print(
    f"Unmitigated result bias: {np.abs(1 - unmitigated_res.data.evs[0]) * 100:.2f}%, \
total shots ran: {job_unmit_res[0]['_meas'].shape[0] * job_unmit_res[0]['_meas'].shape[2]}"
)

print(
    f"Full PEC final result bias: {np.abs(1 - full_pec_res.data.evs[0]) * 100:.2f}%, \
total shots ran: {job_pec_results[1]['_meas'].shape[0] * job_pec_results[1]['_meas'].shape[2]}"
)

print(
    f"PEC+SLC final result bias: {np.abs(1 - pec_slc_res.data.evs[0]) * 100:.2f}%, \
total shots ran: {job_pec_results[0]['_meas'].shape[0] * job_pec_results[0]['_meas'].shape[2]}"
)
Unmitigated result bias: 36.88%, total shots ran: 6400
Full PEC final result bias: 0.97%, total shots ran: 48528
PEC+SLC final result bias: 1.46%, total shots ran: 24480