Symulacja dynamiki 2D Fermiego-Hubbarda za pomocą zbiorów przepływu
Koncepcje z tego przewodnika są obecnie dostępne tylko w interfejsie API Pythona. Równoważna funkcjonalność zostanie udostępniona w interfejsie API C w przyszłym wydaniu.
Najpierw przeczytaj przewodnik po zbiorach przepływu 1D. Ten przewodnik jest jego dwuwymiarową kontynuacją i nie powtarza informacji tam rozwiniętych: operatorów transferu i wierzchołka, czym jest zbiór przepływu, jak groups przetrwa w obwodzie oraz jak własne kodowanie jest podłączane do transpilera przez MapperFnEvolutionSynthesis.
Zobacz przewodnik po transpilacji, by poznać etapy transpilera wspominane w całym tekście, oraz przewodnik po mapperach, by poznać ogólny przepis na napisanie własnego mappera.
Przewodnik 1D zakończył się wzmianką, że przy pracy w dwóch wymiarach potrzebne są kodowania lokalne. Ten przewodnik robi ten krok, dla dwuwymiarowego modelu Fermiego-Hubbarda na sieci kwadratowej, z użyciem kodowania Verstraete-Cirac (VC) [2].
Są trzy różnice względem problemu 1D, stanowiące podstawę tej pracy:
-
Zbiory przepływu się mnożą. Łańcuch ma dwie orientacje strzałek; sieć kwadratowa ma cztery (wschód, zachód, północ, południe), a każda jest sumą rozłącznych wierzchołkowo skierowanych ścieżek (po jednej na wiersz lub kolumnę sieci), a nie pojedynczą ścieżką.
-
Kodowanie zyskuje kubit pomocniczy na węzeł, a nie jeden na cały układ, co daje
stosunek kubitów do modów równy . Operatory transferu stają się operatorami Pauliego o wadze 3 (poziome) i 4 (pionowe), a każdy z czterech zbiorów przepływu odwzorowuje się na własny kształt Pauliego, więc każdy potrzebuje własnego diagonalizującego operatora Cliffordowskiego.
-
Zakodowany hamiltonian jest wierny tylko na podprzestrzeni: wspólnej
podprzestrzeni własnej więzów płytkowych, które niesie każde lokalne kodowanie 2D [2] [3]. W 1D kodowanie było zwykłą izometrią, a weryfikacją było sprawdzenie widma. Tutaj porównanie musi być rzutowane, jak ilustruje krok 9.
Zysk ma ten sam kształt co w 1D: dwukubitowa głębokość jednego kroku Trottera staje się stała względem rozmiaru sieci, równa ( dla przeskoków, zgodnie z pracą [1], plus dla oddziaływania; odnośnik: [1]), podczas gdy trotteryzacja wyraz po wyrazie tego samego zakodowanego hamiltonianu rośnie liniowo. Liczba bramek nadal rośnie z liczbą wiązań, oczywiście; niezależne od rozmiaru staje się to, ile warstw te bramki zajmują. Głębokości są wszędzie liczone na abstrakcyjnym, w pełni połączonym rejestrze; odwzorowanie kodowania na ograniczoną mapę połączeń urządzenia to osobny problem, omówiony na końcu.
Sieć i jej cztery orientacje
Pierwsza zmiana jest widoczna na skierowanym grafie oddziaływań. Węzły są numerowane wierszami, site(r, c) = r * cols + c, a każde wiązanie niesie obie orientacje, jak łańcuch w 1D, ale teraz wiązania biegną wzdłuż dwóch osi:
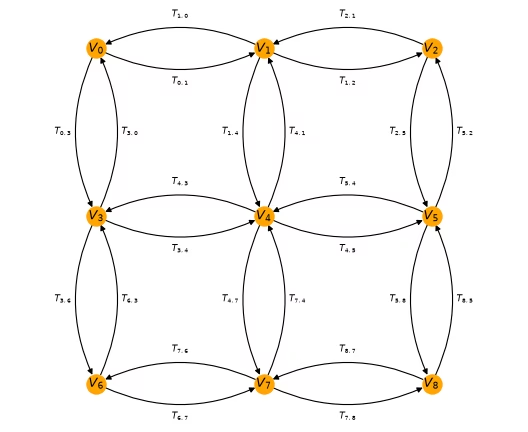
Reguła komutacji jest ta z 1D, bez zmian: dwa operatory transferu dzielące węzeł komutują, gdy strzałki przepływają przez niego, i antykomutują, gdy się zderzają. Jednak węzeł ma teraz do czterech wiązań zamiast dwóch, więc strzałki przez niego mogą zderzać się na więcej sposobów, a zbiór strzałek, które nigdy się nie zderzają, nie jest już pojedynczą ścieżką. Odczytanie poziomych strzałek od lewej do prawej daje jeden taki zbiór, pionowych od góry do dołu kolejny, a odwrócenie każdego daje dwa następne. To są zbiory przepływu wschodni, zachodni, północny i południowy, które organizują wszystko, co dalej.
Kodowanie Verstraete-Cirac
Verstraete-Cirac (VC) łączy każdą modę fermionową z własnym kubitem pomocniczym. Przy węzłach sieci moda leży na kubicie , a jej kubit pomocniczy jest na kubicie , więc rejestr liczy kubitów. Operatory wierzchołka pozostają tak proste, jak to możliwe,
co sprawia, że obsadzenia można później bezpośrednio odczytać. Operatory transferu zależą od orientacji krawędzi. Dla krawędzi poziomej , gdzie jest węzłem zachodnim, oraz krawędzi pionowej, gdzie jest węzłem północnym,
trójkąt o wadze 3 i kwadrat o wadze 4. Identyfikacja każdej strzałki ma znaczenie: gdy jest węzłem zachodnim, wskazuje wschód, ale gdy jest węzłem północnym, wskazuje południe. Orientacje odwrotne wynikają z tożsamości , która zamienia trójkąt XXZ w YYZ, a kwadrat XYXY w YXXY. Te cztery różne etykiety to cztery zbiory przepływu, a reszta tego przewodnika śledzi właśnie je.
To nie jest dokładnie równanie (A1) z Ref. [1], które mówi o „z dokładnością do rotacji jednokubitowych” i różni się na trzy sposoby warte nazwania, bo czytelnik sprawdzający artykuł je zauważy:
-
Współczynnik: Równanie (A1) go nie zawiera. Czynnik tutaj sprawia, że , zgodnie z normalizacją , której używa
TransferVertexOperator. Artykuł potrzebuje swoich operatorów transferu wyłącznie wewnątrz , gdzie czynnik skalujący jest pochłaniany przez kąt rotacji; tutaj muszą to być operatory spełniające tożsamość. -
Orientacja: Równanie (A1) wybiera litery według parzystości wiersza , która dla krawędzi poziomej jest taka sama dla obu końców, więc nie odróżnia od . Artykuł odzyskuje orientację osobno, przez sprzężenie warstwą . Ten przewodnik zamiast tego wbudowuje ją w kodowanie, wyprowadzając odwrotną orientację z , dzięki czemu obie orientacje trafiają na różne operatory Pauliego w kroku 3.
-
Kształt pionowy: Równanie (A1) na przemian używa
XXXXiYYYYwedług parzystości wiersza, podczas gdy ten przewodnik używa jednegoXYXY. To dwa sposoby osiągnięcia tego samego: asymetrii liter, która sprawia, że krawędź pionowa poprawnie koliduje z krawędziami poziomymi, które się z nią spotykają. Nie traktuj tej różnicy jako dowolnego wyboru bazy. Porzucenie naprzemienności parzystości i użycie jednegoXXXXcałkowicie psuje algebrę, dlatego różne litery są sprawdzane, a nie zakładane.
Ancilla jest przypisana do węzła, co daje stosunek ; to kodowanie Derby'ego-Klassena umieszcza jeden pomocniczy kubit na (nieparzystą) płytkę, dla mniejszego stosunku . VC jest tu użyte, ponieważ jego operatory transferu to te, których diagonalizujące operacje Cliffordda podaje Ref. [1] w postaci zamkniętej.
1. Hamiltonian na siatce kwadratowej
Konstrukcja jest taka sama jak w 1D, ale z dwuwymiarową listą krawędzi. Węzły zachowują numerację wierszami użytą na rysunku powyżej, site(r, c) = r * cols + c, tak że wiązania poziome łączą kolejne indeksy, a wiązania pionowe łączą indeksy różniące się o cols:
>>> from collections import defaultdict
>>> from qiskit_fermions.operators import TransferVertexOperator
>>>
>>> def fermi_hubbard_2d(rows, cols, tunneling, interaction):
...     site = lambda r, c: r * cols + c
...     edges = [(site(r, c), site(r, c + 1)) for r in range(rows) for c in range(cols - 1)]
...     edges += [(site(r, c), site(r + 1, c)) for r in range(rows - 1) for c in range(cols)]
...     data: defaultdict[tuple[tuple[int, int], ...], complex] = defaultdict(complex)
...     for j, k in edges:
...         # hopping: -t (a^dag_j a_k + a^dag_k a_j) = t (T_jk + T_kj)
...         data[((j, k),)] += tunneling
...         data[((k, j),)] += tunneling
...         # interaction: U n_j n_k with n_j = (1 - V_j) / 2
...         data[()] += interaction / 4
...         data[((j, j),)] -= interaction / 4
...         data[((k, k),)] -= interaction / 4
...         data[((j, j), (k, k))] += interaction / 4
...     return TransferVertexOperator.from_dict(data)
>>>
>>> rows, cols = 3, 3
>>> num_sites = rows * cols
>>> hamiltonian = fermi_hubbard_2d(rows, cols, tunneling=1.0, interaction=2.0)
>>> print(f"Number of terms: {len(hamiltonian)}")
Number of terms: 46
2. Cztery zbiory przepływu zamiast dwóch
Każdy wyraz przeskoku jest klasyfikowany według kierunku, w którym wskazuje jego strzałka na siatce. Porównanie współrzędnych wiersza/kolumny divmod obu końców rozdziela krawędzie poziome od pionowych, a znak różnicy wybiera orientację. Wszystko, co diagonalne (tożsamość oraz wyrazy i ), trafia do piątej grupy:
Konwencja orientacji. Nazwy są po prostu odczytane z rysunku powyżej: strzałka jest skierowana na wschód lub zachód, gdy wskazuje w prawo lub w lewo wzdłuż wiersza, oraz na północ lub południe, gdy wskazuje w górę lub w dół kolumny. Ponieważ numeracja idzie wierszami, wschód i południe to kierunki rosnących indeksów. Nic dalej nie zależy od tych nazw (służą tylko do oznaczania grup), ale łatwo je pomylić, więc warto je ustalić względem rysunku. Ref. [1] nazywa swoje zbiory przepływu na siatce kwadratowej w ten sam sposób.
>>> EAST, WEST, NORTH, SOUTH, DIAGONAL = range(5)
>>>
>>> def flow_set_groups(operator, cols):
...     groups = []
...     for terms, _ in operator.iter_terms():
...         if len(terms) == 1 and terms[0][0] != terms[0][1]:
...             j, k = terms[0]
...             row_j, col_j = divmod(j, cols)
...             row_k, col_k = divmod(k, cols)
...             if row_j == row_k:
...                 groups.append(EAST if col_k > col_j else WEST)
...             else:
...                 groups.append(SOUTH if row_k > row_j else NORTH)
...         else:
...             groups.append(DIAGONAL)
...     return groups
>>>
>>> hamiltonian.groups = flow_set_groups(hamiltonian, cols)
>>>
>>> names = ["east", "west", "north", "south", "diagonal"]
>>> for index, name in enumerate(names):
...     count = sum(1 for group in hamiltonian.groups if group == index)
...     print(f"{name:9s} {count:2d}")
east       6
west       6
north      6
south      6
diagonal  22
W obrębie jednego zbioru przepływu każda strzałka albo spotyka inną „głowa do ogona”, albo wcale się z nią nie spotyka, tak jak w 1D, więc zbiór przepływu nadal komutuje wyraz po wyrazie, a jego ewolucja nie niesie błędu Trottera. Nowością jest to, że zbiór przepływu jest teraz niespójny: zbiór wschodni siatki rows x cols składa się z rows niezależnych ścieżek od lewej do prawej. Ta niespójność to dar, a nie komplikacja, co pokazuje krok 6.
3. Zakoduj operator
Kodowanie to jedna funkcja, która odwzorowuje pojedynczy uogólniony operator transferu na ciąg Pauliego, przekazywany do map_transfer_vertex_generators(). W porównaniu z wersją 1D ciało ma więcej przypadków: diagonalny, poziomy, pionowy oraz orientacje odwrotne przez .
Jest jeden problem. map_transfer_vertex_generators() wywołuje zwrotnie funkcję, przekazując tylko generator, a do ustalenia ciągu Pauliego wiązania potrzebne jest też cols, aby odzyskać współrzędne wiersza i kolumny z indeksu modu. Zamiast zagnieżdżać funkcje, by domknąć tę wartość, wiąże ją functools.partial(), co pozwala zachować obie funkcje na najwyższym poziomie i wywoływalne niezależnie.
>>> from functools import partial
>>>
>>> from qiskit.quantum_info import SparseObservable
>>> from qiskit_fermions.mappers import map_transfer_vertex_generators
>>>
>>> def ancilla_qubit(mode, num_sites):
...     """The auxiliary qubit paired with fermionic mode `mode`."""
...     return num_sites + mode
>>>
>>> def vc_action(generator, width, cols):
...     """Map one generalized transfer operator to its Verstraete-Cirac Pauli."""
...     num_sites = width // 2
...     ancilla = partial(ancilla_qubit, num_sites=num_sites)
...     j, k = generator
...     if j == k:  # vertex operator V_j = Z_j
...         return SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_qubits=width)
...     row_j, col_j = divmod(j, cols)
...     row_k, col_k = divmod(k, cols)
...     if row_j == row_k:  # horizontal: weight-3 triangle
...         left, right = (j, k) if col_j < col_k else (k, j)
...         operator = SparseObservable.from_sparse_list(
...             [("XXZ", [left, right, ancilla(left)], 0.5)], num_qubits=width
...         )
...         forward = (j, k) == (left, right)
...     else:  # vertical: weight-4 square
...         up, down = (j, k) if row_j < row_k else (k, j)
...         operator = SparseObservable.from_sparse_list(
...             [("XYXY", [up, down, ancilla(up), ancilla(down)], 0.5)], num_qubits=width
...         )
...         forward = (j, k) == (up, down)
...     if forward:
...         return operator
...     # reverse orientation: T_kj = -V_j V_k T_jk
...     v_j = SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_qubits=width)
...     v_k = SparseObservable.from_sparse_list([("Z", [k], 1.0)], num_qubits=width)
...     return (-1.0 * v_j.compose(v_k).compose(operator)).simplify()
>>>
>>> def vc_encoding(operator, width, cols):
...     """Map a TransferVertexOperator to a qubit observable, Verstraete-Cirac style."""
...     return map_transfer_vertex_generators(
...         operator,
...         partial(vc_action, width=width, cols=cols),
...         identity=lambda: SparseObservable.identity(width),
...         compose=SparseObservable.compose,
...     ).simplify()
>>>
>>> # bind the lattice width once; the transpiler only ever passes (operator, width)
>>> encoding = partial(vc_encoding, cols=cols)
>>> num_qubits = 2 * num_sites
>>> num_qubits
18
Sens grupowania przed odwzorowaniem widać od razu: każdy zbiór przepływu koduje się do jednego kształtu Pauliego, jednolitego w całym zbiorze.
>>> for index, name in enumerate(names):
...     observable = encoding(hamiltonian.split_out_groups()[index], num_qubits)
...     shapes = sorted({label for label, _, _ in observable.to_sparse_list()})
...     print(f"{name:9s} {shapes}")
east      ['XXZ']
west      ['YYZ']
north     ['YXXY']
south     ['XYXY']
diagonal  ['', 'Z', 'ZZ']
Cztery kształty przeskoków są różne, więc każdy zbiór przepływu dostaje własną operację Cliffordda w kroku 5. Orientacje odwrotne to inne operatory Pauliego, a nie te same z zamienionymi etykietami; dlatego synteza zbioru przepływu 2D wymaga czterech obwodów, podczas gdy synteza 1D wymaga jednego.
4. Transpilacja z własnym kodowaniem
Ten etap to wersja 1D z szerszym rejestrem kubitów: CustomF2QLayout odwzorowuje rejestr modów na kubitów, MapperFnEvolutionSynthesis niesie kodowanie, a jego argument product_formula wybiera, jak jest dekomponowana powstała PauliEvolutionGate. Porównaj krok 6 przewodnika 1D, który buduje ten sam potok dla jednego ancilla.
>>> from qiskit.circuit import QuantumRegister
>>> from qiskit.passmanager import MultiStagePassManager
>>> from qiskit.synthesis import LieTrotter
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution
>>> from qiskit_fermions.circuit.library.synthesis import FermionicLieTrotter
>>> from qiskit_fermions.transpiler import FermionicCircuitToDAG, QuantumDAGToCircuit
>>> from qiskit_fermions.transpiler.passes import (
...     CustomF2QLayout,
...     F2QSynthesis,
...     MapperFnEvolutionSynthesis,
... )
>>>
>>> total_time = 1.0
>>>
>>> def flow_set_pass_manager(mode_register, encoding, product_formula=None):
...     """Build the pipeline mapping `mode_register` with the VC `encoding`."""
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         encoding, product_formula=product_formula
...     )
...     # this encoding spends one ancilla per fermionic mode
...     qubit_register = QuantumRegister(2 * mode_register.size, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> circuit = FermionicCircuit(num_sites)
>>> circuit.append(
...     Evolution(
...         num_sites, hamiltonian, time=total_time, synthesis=FermionicLieTrotter()
...     ),
...     circuit.modes,
... )
>>>
>>> # as in 1D, one decompose() splits the Evolution group by group (five gates here,
>>> # the four hopping flow sets in group order, then the diagonal interaction)
>>> flow_set_circuit = circuit.decompose()
>>> flow_set_circuit.count_ops()["Evolution"]
5
Pięć bramek, niosących 6, 6, 6, 6 i 22 wyrazy policzone w kroku 2. Każda jest odwzorowywana i syntetyzowana niezależnie, więc podział ustalony na poziomie fermionowym przetrwa aż do obwodu:
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, encoding, LieTrotter())
>>> qubit_circuit = pass_manager.run(flow_set_circuit)
>>> qubit_circuit.num_qubits
18
>>>
>>> def two_qubit_stats(circuit):
...     decomposed = circuit.decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     return decomposed.count_ops().get("cx", 0), decomposed.depth(two_qubit)
>>>
>>> two_qubit_stats(qubit_circuit)
(144, 47)
To jest punkt odniesienia: kodowanie i grupowanie są na miejscu, ale LieTrotter syntetyzuje każdy zbiór przepływu wyraz po wyrazie, a głębokość rośnie wraz z siatką.
5. Operacja Cliffordda o głębokości 2 na zbiór przepływu
Mechanizm jest taki sam jak w 1D: sprzęgamy cały komutujący zbiór przepływu operacją Cliffordda, która odwzorowuje każdy jego wyraz na odrębny operator Pauliego wagi 1, tak aby ewolucja całego zbioru kosztowała tylko rotacje jednokubitowe. W 1D robił to jeden układ cegiełkowy bramek CZ.
W 2D każdy zbiór przepływu potrzebuje własnego obwodu, zgodnie z sekcją IV C i rys. 7 z Ref. [1]. Wszystkie cztery działają na jednej linii siatki naraz (wiersz dla wschód/zachód, kolumna dla północ/południe) wraz z ancillami tej linii i wszystkie mają ten sam trzyczęściowy kształt:
-
Warstwa rotacji jednokubitowych, ustawiająca każdy kubit w bazie potrzebnej jego zbiorowi przepływu.
-
Pierwsza warstwa
CX, zawsze od węzła do ancilli na tym samym węźle. -
Druga warstwa
CX, sprzęgająca sąsiadów wzdłuż linii.
Kroki 2 i 3 to jedyne warstwy dwukubitowe, więc głębokość dwukubitowa wynosi , niezależnie od długości linii. Poniżej są rozpisane po jednej funkcji na zbiór przepływu. Rotacje są takie, jakie są, ponieważ zostały znalezione przez sprzężenie wyrazów każdego zbioru przepływu i wymaganie odrębnych obrazów wagi 1, więc potraktuj je jako dane i polegaj na sprawdzeniu, które następuje.
Dwa zbiory poziome są najprostsze. Ich wyrazy mają wagę 3, XXZ i YYZ, i różnią się tylko dodatkowym , które zamienia na na węzłach:
>>> from qiskit.circuit import QuantumCircuit
>>>
>>> def east_clifford(circuit, line, ancilla):
...     """Diagonalize the east flow set (XXZ) on one lattice row."""
...     for j in line:
...         circuit.h(ancilla(j))
...     for j in line[:-1]:  # layer 1: each site with its own ancilla
...         circuit.cx(ancilla(j), j)
...     for j, k in zip(line, line[1:]):  # layer 2: ancilla with the next site along
...         circuit.cx(k, ancilla(j))
>>>
>>> def west_clifford(circuit, line, ancilla):
...     """Diagonalize the west flow set (YYZ) on one lattice row."""
...     for j in line:
...         circuit.s(j)  # the only difference from east: X -> Y on the sites
...         circuit.h(ancilla(j))
...     for j in line[:-1]:
...         circuit.cx(ancilla(j), j)
...     for j, k in zip(line, line[1:]):
...         circuit.cx(k, ancilla(j))
Dwa zbiory pionowe mają wagę 4, XYXY i YXXY, i są odpowiednio bardziej złożone: rotacje zmieniają się naprzemiennie wraz z pozycją wzdłuż linii, a druga warstwa CX też się zmienia naprzemiennie, sprzęgając węzły na pozycjach parzystych i ancille na nieparzystych (lub odwrotnie):
>>> def south_clifford(circuit, line, ancilla):
...     """Diagonalize the south flow set (XYXY) on one lattice column."""
...     for position, j in enumerate(line):
...         if position % 2 == 0:
...             circuit.sdg(ancilla(j))
...             circuit.h(ancilla(j))
...         else:
...             circuit.h(j)
...             circuit.s(j)
...             circuit.h(ancilla(j))
...             circuit.s(ancilla(j))
...     for j in line:  # layer 1
...         circuit.cx(ancilla(j), j)
...     for position, (j, k) in enumerate(zip(line, line[1:])):  # layer 2
...         if position % 2 == 0:
...             circuit.cx(ancilla(j), ancilla(k))  # ancilla to ancilla
...         else:
...             circuit.cx(j, k)  # site to site
>>>
>>> def north_clifford(circuit, line, ancilla):
...     """Diagonalize the north flow set (YXXY) on one lattice column."""
...     for position, j in enumerate(line):
...         if position % 2 == 0:
...             circuit.h(ancilla(j))
...             circuit.s(ancilla(j))
...         else:
...             circuit.h(j)
...             circuit.s(j)
...             circuit.sdg(ancilla(j))
...             circuit.h(ancilla(j))
...     for j in line:  # layer 1
...         circuit.cx(ancilla(j), j)
...     for position, (j, k) in enumerate(zip(line, line[1:])):  # layer 2
...         if position % 2 == 0:
...             circuit.cx(k, j)  # site to site, and the other way round from south
...         else:
...             circuit.cx(ancilla(j), ancilla(k))
Narysowany na jednej linii trzech węzłów (najpierw jej węzły, potem ich ancille) cały mechanizm mieści się na jednym rysunku. Kształt trójkąta jest bardziej przejrzysty z obu: zmiana bazy na ancillach, potem dwie warstwy CX, z których pierwsza paruje każdy węzeł z jego własną ancillą, a druga sięga do następnego węzła wzdłuż linii.
>>> line = [0, 1, 2]  # three sites, with ancillas on qubits 3, 4, 5
>>> triangle = QuantumCircuit(6)
>>> east_clifford(triangle, line, lambda mode: 3 + mode)
>>> triangle.draw("mpl")
<Figure size ... with 1 Axes>

Kształt kwadratu wymaga więcej pracy jednokubitowej (rotacje zmieniają się naprzemiennie wzdłuż linii), a jego druga warstwa CX na przemian sprzęga węzły i sprzęga ancille:
>>> square = QuantumCircuit(6)
>>> south_clifford(square, line, lambda mode: 3 + mode)
>>> square.draw("mpl")
<Figure size ... with 1 Axes>

Obie mają głębokość dwóch warstw CX, a dodawanie węzłów do linii je poszerza, ale nie pogłębia; to cała teza o stałej głębokości, widoczna gołym okiem. Operacje Cliffordda dla zachodu i północy różnią się tylko warstwami jednokubitowymi, więc nie są rysowane osobno.
Synteza nadal musi ustalić, gdzie ląduje każdy wyraz. Linia węzłów niesie wiązań, z których każde wnosi jeden wyraz, więc poniższa funkcja pomocnicza zwraca jeden wpis na wiązanie: kubit, na którym wylądował wyraz, i jednokubitowy operator Pauliego, którym się stał. Co kluczowe, są one odczytywane ze sprzężenia, a nie przewidywane. W przeciwieństwie do 1D, gdzie jeden układ cegiełkowy CZ odwzorowuje w postaci zamkniętej, tutaj nie ma takiego wzoru, a ancille linii kolumnowej nie są ciągłe. Jedyne, co różni zbiory przepływu, to ciąg Pauliego na wejściu, który krok 3 już wypisał:
>>> from qiskit.quantum_info import Clifford, SparsePauliOp
>>>
>>> def clifford_supports(clifford, pauli, line, ancilla, num_qubits):
...     """Conjugate a flow set's terms to find which qubit each one lands on.
...
...     `pauli` is the flow set's Pauli string, as printed in step 3. Its letters apply
...     to the i-th term's qubits in the order below: the two sites of the bond, then
...     their ancillas.
...
...     This is the one check that needs SparsePauliOp: Clifford conjugation wants a
...     `Pauli` and its symplectic bits, and SparseObservable exposes neither -- its own
...     `evolve` conjugates by a Pauli, not by a Clifford.
...     """
...     supports = []
...     for i in range(len(line) - 1):
...         qubits = [line[i], line[i + 1], ancilla(line[i]), ancilla(line[i + 1])]
...         term = SparsePauliOp.from_sparse_list(
...             [(pauli, qubits[: len(pauli)], 1.0)], num_qubits=num_qubits
...         )
...         image = term.paulis[0].evolve(clifford, frame="s")
...         # a weight-1 image has exactly one qubit with an X and/or Z bit set
...         (support,) = np.nonzero(image.x | image.z)
...         assert len(support) == 1, f"term {i} is not weight-1"
...         supports.append((int(support[0]), image[support].to_label()))
...     return supports
Obrazy muszą wyjść odrębne i wagi 1, aby każdy wyraz można było obracać niezależnie na jego własnym kubicie; głębokość dwukubitowa jest już widoczna w czterech powyższych konstrukcjach, z których każda emituje dwie warstwy CX niezależnie od długości linii. Poniżej obie własności są sprawdzane dla każdego zbioru przepływu, każdej linii i kilku rozmiarów siatki. Krok 6 następnie wywołuje clifford_supports, więc jest to działająca część syntezy, a nie tylko demonstracja.
6. Synteza świadoma zbiorów przepływu
Synteza dostaje pomocny start. Ponieważ Evolution dzieli się grupa po grupie, synthesize jest wywoływane raz na zbiór przepływu (tutaj pięć razy, cztery zbiory przeskoków plus grupa diagonalna), więc każdy wyraz przeskoku, który widzi, ma ten sam kształt Pauliego, a jedna operacja Cliffordda diagonalizuje je wszystkie. Wystarczy odczytać ten kształt z pierwszego wyrazu i posortować resztę według linii, na której leżą. Potem przychodzi obserwacja, która czyni dwa wymiary tańszymi, niż można by się obawiać:
Składowe pojedynczego zbioru przepływu są rozłączne wierzchołkowo: wiersze zbioru zachodniego nie mają wspólnych kubitów. Dlatego wszystkie operacje Cliffordda zbioru przepływu można emitować razem i dzielą one te same dwie warstwy dwukubitowe, zamiast ustawiać się w kolejce jeden wiersz po drugim. Zbiór przepływu kosztuje więc stałą liczbę warstw (dwie dla operacji Cliffordda i dwie dla jej odwrotności) bez względu na to, ile wierszy lub kolumn ma siatka, dlatego łączna głębokość okazuje się stała.
>>> from qiskit.synthesis.evolution import EvolutionSynthesis
>>>
>>> # The interaction couples nearest neighbors only, so every interior site carries four
>>> # Rzz gates -- one per bond -- and can only do one at a time: four layers is the best
>>> # any schedule can achieve. Horizontal bonds split by column parity, vertical ones by
>>> # row parity, which achieves it.
>>> def rzz_layers(circuit, angles, cols):
...     """Emit the diagonal Rzz gates in four layers of disjoint qubit pairs."""
...     horizontal = [(j, k) for j, k in angles if k - j == 1]
...     vertical = [(j, k) for j, k in angles if k - j == cols]
...     schedule = [
...         [(j, k) for j, k in horizontal if (j % cols) % 2 == 0],
...         [(j, k) for j, k in horizontal if (j % cols) % 2 == 1],
...         [(j, k) for j, k in vertical if (j // cols) % 2 == 0],
...         [(j, k) for j, k in vertical if (j // cols) % 2 == 1],
...     ]
...     # emit layer by layer, since Qiskit's depth follows the order gates were added
...     for layer in schedule:
...         for j, k in layer:
...             circuit.rzz(angles[j, k], j, k)
>>>
>>> class FlowSetSynthesis(EvolutionSynthesis):
...     """Synthesize one 2D line flow set at a time, via its depth-2 Clifford."""
...
...     preserve_order = True
...
...     def __init__(self, rows, cols):
...         self.rows, self.cols = rows, cols
...
...     def rows_of_lattice(self):
...         return [[r * self.cols + c for c in range(self.cols)] for r in range(self.rows)]
...
...     def columns_of_lattice(self):
...         return [[r * self.cols + c for r in range(self.rows)] for c in range(self.cols)]
...
...     def synthesize(self, evolution):
...         num_qubits = 2 * self.rows * self.cols
...         ancilla = partial(ancilla_qubit, num_sites=self.rows * self.cols)
...         circuit = QuantumCircuit(evolution.operator.num_qubits)
...         terms = [
...             (label, indices, 2 * evolution.time * coeff.real)
...             for label, indices, coeff in evolution.operator.to_sparse_list()
...         ]
...
...         # `Evolution.decompose()` hands us one gate per flow set, so every hopping term
...         # here shares a single Pauli shape and one Clifford diagonalizes all of them
...         shapes = tuple({label for label, _, _ in terms} - {"", "Z", "ZZ"})
...         match shapes:
...             case ("XXZ",):
...                 clifford_function, lines = east_clifford, self.rows_of_lattice()
...                 along_rows = True
...             case ("YYZ",):
...                 clifford_function, lines = west_clifford, self.rows_of_lattice()
...                 along_rows = True
...             case ("XYXY",):
...                 clifford_function, lines = south_clifford, self.columns_of_lattice()
...                 along_rows = False
...             case ("YXXY",):
...                 clifford_function, lines = north_clifford, self.columns_of_lattice()
...                 along_rows = False
...             case ():  # the diagonal group: no conjugation needed
...                 self.diagonal(circuit, terms)
...                 return circuit
...             case _:
...                 raise ValueError(f"expected one known flow set per gate, got {shapes}")
...
...         # a term's line is the row it sits in and its slot the column, or vice versa
...         rotations: dict[int, list] = defaultdict(list)
...         for _, indices, angle in terms:
...             row, col = divmod(indices[0], self.cols)
...             line, slot = (row, col) if along_rows else (col, row)
...             rotations[line].append((slot, angle))
...
...         active = sorted(rotations)
...         # the lines of one flow set are vertex-disjoint, so all of their Cliffords
...         # are emitted together and share the same two two-qubit layers
...         conjugation = QuantumCircuit(num_qubits)
...         for line in active:
...             clifford_function(conjugation, lines[line], ancilla)
...         circuit.compose(conjugation, inplace=True)
...         for line in active:
...             supports = clifford_supports(
...                 Clifford(conjugation), shapes[0], lines[line], ancilla, num_qubits
...             )
...             for slot, angle in rotations[line]:
...                 match supports[slot]:
...                     case qubit, "X":
...                         circuit.rx(angle, qubit)
...                     case qubit, "Y":
...                         circuit.ry(angle, qubit)
...                     case qubit, "Z":
...                         circuit.rz(angle, qubit)
...         circuit.compose(conjugation.inverse(), inplace=True)
...         return circuit
...
...     def diagonal(self, circuit, terms):
...         """Synthesize the diagonal group: a phase, single-qubit Z and paired Rzz."""
...         rzz = {}
...         for label, indices, angle in terms:
...             match label, indices:
...                 case "", _:  # the identity contributes only a global phase
...                     circuit.global_phase -= angle / 2
...                 case "Z", [qubit]:  # a lone vertex operator
...                     circuit.rz(angle, qubit)
...                 case "ZZ", [j, k]:  # interaction, see rzz_layers above
...                     rzz[min(j, k), max(j, k)] = angle
...                 case _:
...                     raise ValueError(f"unexpected Pauli term: {label} on {indices}")
...         rzz_layers(circuit, rzz, self.cols)
Podobnie jak w 1D, jest to celowo napisane dla tego kodowania: rozpoznaje cztery kształty Pauliego i zgłasza błąd dla czegokolwiek innego zamiast po cichu się wycofywać. Zakłada też powyższy podział jeden zbiór przepływu na bramkę i mówi o tym wprost; więcej niż jeden kształt przeskoku w jednej bramce oznacza, że grupowanie nie zostało zastosowane, co jest błędem, a nie czymś do obejścia.
Tak jak jej odpowiednik 1D, ta synteza nie przyjmuje liczby kroków Trottera. Krok Trottera musi przechodzić cyklicznie między zbiorami przepływu, ale transpile_trotter_step poniżej dekomponuje obwód fermionowy na jedną bramkę Evolution na zbiór, więc ta metoda widzi zawsze tylko jeden zbiór naraz i mogłaby powtarzać tylko wewnątrz niego, co niczego nie zmienia: powtarzanie jednego operatora po prostu dzieli jego własną ewolucję na równe części.
Wielokrokowa trotteryzacja wymaga więc wzoru produktowego, który respektuje groups operatora wewnątrz pojedynczej bramki, przed dekompozycją. Robi to FermionicLieTrotter, a krok 10 używa go do zmierzenia zbieżności.
Zwróć uwagę na dwie podobnie nazwane klasy. LieTrotter z Qiskit, użyty powyżej jako punkt odniesienia, działa na odwzorowanym hamiltonianie, w którym grupowania już nie ma. FermionicLieTrotter jest jego odpowiednikiem fermionowym i to on nadal widzi zbiory przepływu.
7. Wynik: stała głębokość
Wszystko dotąd działało na jednej siatce zbudowanej w kroku 1. Porównanie obu ścieżek syntezy dla rosnących siatek wymaga powtórzenia całej tej sekwencji (operator, grupowanie, kodowanie, obwód, menedżer przebiegów) dla każdego rozmiaru, więc warto ją raz opakować:
>>> def transpile_trotter_step(rows, cols, product_formula, steps=1):
...     """Transpile `steps` Trotter steps on a `rows` x `cols` lattice."""
...     num_sites = rows * cols
...     operator = fermi_hubbard_2d(rows, cols, 1.0, 2.0)
...     operator.groups = flow_set_groups(operator, cols)
...     encoding = partial(vc_encoding, cols=cols)
...
...     circuit = FermionicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites,
...             operator,
...             time=total_time,
...             synthesis=FermionicLieTrotter(reps=steps),
...         ),
...         circuit.modes,
...     )
...     circuit = circuit.decompose()  # split into one Evolution per flow set
...
...     pass_manager = flow_set_pass_manager(circuit.register, encoding, product_formula)
...     return pass_manager.run(circuit)
Zebranie obu metryk dla zakresu rozmiarów siatki i naniesienie ich na wykres względem krawędzi siatki wyraźnie pokazuje różnicę:
>>> sizes = [3, 4, 5, 6, 7, 8]
>>> lie_trotter = [
...     two_qubit_stats(transpile_trotter_step(n, n, LieTrotter())) for n in sizes
... ]
>>> flow = [
...     two_qubit_stats(transpile_trotter_step(n, n, FlowSetSynthesis(n, n))) for n in sizes
... ]
>>>
>>> figure, axes = plt.subplots(1, 2, figsize=(9, 3.5), layout="constrained")
>>> for panel, index, title in zip(axes, (1, 0), ("two-qubit depth", "CX count")):
...     _ = panel.plot(sizes, [stat[index] for stat in lie_trotter], "o-", label="qubit-level")
...     _ = panel.plot(sizes, [stat[index] for stat in flow], "s-", label="flow set")
...     _ = panel.set(xlabel="lattice edge $L$ (an $L \\times L$ lattice)", title=title)
...     _ = panel.legend()
>>> figure
<Figure size ... with 2 Axes>

Głębokość dwukubitowa wynosi 24 i jest stała od do (czyli od 18 kubitów do 128), podczas gdy LieTrotter zastosowany do identycznie zakodowanego hamiltonianu rośnie liniowo z krawędzią siatki, od 47 do 92. Liczba bramek rośnie w obu przypadkach, bo w obu trzeba zastosować wyrazów; zbiory przepływu usuwają wzrost liczby warstw, które te bramki zajmują.
Budżet dzieli się na 16 dla przeskoków i osiem dla oddziaływania:
-
Każdy z czterech zbiorów przepływu kosztuje warstwy dwukubitowe: jego operacja Cliffordda na wejściu i odwrotność na wyjściu, obie o głębokości dwa z konstrukcji, z samymi rotacjami jednokubitowymi pomiędzy. To daje , czyli liczbę podaną w Ref. [1], ponieważ liczy ona tylko wyrazy przeskoku. Ustawienie w powyższym kodzie ją odtwarza.
-
Grupa diagonalna dodaje pozostałe osiem. Jej bramki
Rzzupakowują się w cztery warstwy, a każdaRzzdekomponuje się na dwie bramkiCXwokół pojedynczej rotacji jednokubitowej, więc . Cztery warstwy to optimum: na siatce kwadratowej oddziaływanie sięga tylko najbliższych sąsiadów, więc każdy węzeł wewnętrzny niesie cztery bramkiRzz(po jednej na wiązanie) i może uczestniczyć tylko w jednej naraz.
Nic w żadnej z sum nie odnosi się do rozmiaru siatki, i o to właśnie chodzi.
8. Zweryfikuj obwód
Synteza zbiorów przepływu i LieTrotter opisują ten sam krok Trottera tego samego zakodowanego hamiltonianu, więc ich unitarności muszą się zgadzać z dokładnością do fazy globalnej. Losowe wektory stanu wykrywają każdą rozbieżność znacznie taniej niż budowanie pełnej macierzy unitarnej:
Oba obwody są dekomponowane do bramek jedno- i dwukubitowych przed zastosowaniem do stanu. Pozostawiona niezdekomponowana, każda instrukcja wysokiego poziomu Evolution zmusza Statevector do zbudowania pełnego gęstego operatora ; dekompozycja najpierw pozwala stosować bramki po kolei, co jest tu kilkaset razy szybsze.
>>> import numpy as np
>>> from qiskit.quantum_info import Statevector
>>>
>>> rng = np.random.default_rng(1234)
>>>
>>> def agrees_up_to_one_phase(rows, cols, samples=3):
...     """Compare both syntheses on random states.
...
...     Returns whether they agree up to a phase, and whether it is the *same* phase
...     for every input state.
...     """
...     lie_trotter = transpile_trotter_step(
...         rows, cols, LieTrotter()
...     ).decompose(reps=6)
...     flow = transpile_trotter_step(
...         rows, cols, FlowSetSynthesis(rows, cols)
...     ).decompose(reps=6)
...     dimension = 2**lie_trotter.num_qubits
...     residuals, phases = [], []
...     for _ in range(samples):
...         vector = rng.normal(size=dimension) + 1j * rng.normal(size=dimension)
...         state = Statevector(vector / np.linalg.norm(vector))
...         a = state.evolve(lie_trotter).data
...         b = state.evolve(flow).data
...         overlap = np.vdot(a, b)
...         phases.append(overlap / abs(overlap))
...         residuals.append(np.linalg.norm(b - a * overlap / abs(overlap)))
...     # the SAME global phase must work for every input state
...     spread = max(abs(phase - phases[0]) for phase in phases)
...     return bool(max(residuals) < 1e-9), bool(spread < 1e-9)
>>>
>>> agrees_up_to_one_phase(rows, cols)
(True, True)
Obie połowy tego sprawdzenia mają znaczenie. Nakładanie o module jeden na pojedynczym stanie jest konieczne, ale niewystarczające: synteza, która źle ustawiła fazę zależną od stanu, nadal by to wykazała. Wymóg tej samej fazy dla kilku losowych stanów zamyka tę lukę.
9. Zweryfikuj fizykę na podprzestrzeni stabilizatorów
To jest dwuwymiarowa zmarszczka. W 1D kodowanie było izometrią, a porównanie widm z odniesieniem Jordana-Wignera wystarczało. VC nie jest izometrią: używa kubitów dla modów, więc -wymiarowa przestrzeń mieści -wymiarową fizyczną. Jest to typowe dla lokalnych kodowań w dwóch wymiarach (nadmiarowe kubity są ograniczone lokalnymi komutującymi symetriami, po jednej na płytkę [2] [3]) i oznacza, że zakodowany hamiltonian reprezentuje fermionowy wiernie tylko na łącznej podprzestrzeni własnej tych ograniczeń.
Słowo stabilizator pełni w tej dziedzinie podwójną rolę, a oba znaczenia są niezwiązane. Ref. [1] używa go dla komutujących operatorów transferu zbioru przepływu, które tworzą grupę stabilizatorów diagonalizowaną przez operacje Cliffordda z kroku 5 (zabieg kompilacyjny i znaczenie używane wszędzie powyżej). Ta sekcja używa go w sensie korekcji błędów: operatory, których podprzestrzeń własna jest podprzestrzenią fizyczną. Ref. [1] wyraźnie zaznacza tę kolizję i odkłada drugie znaczenie na bok; ograniczenia płytek poniżej są własnością kodowania VC [2], a nie wynikiem ramy zbiorów przepływu.
Generatory są tu skonstruowane, a nie zacytowane: po jednym na ścianę kwadratową, a każdy jest po prostu zakodowaną pętlą operatorów krawędziowych wokół tej ściany.
Operatory krawędziowe są do tego naturalnym obiektem. Zamknięta pętla z nich jest symetrią każdego hamiltonianu zachowującego liczbę cząstek, podczas gdy odpowiednia pętla operatorów transferu nią nie jest: oba różnią się operatorem wierzchołkowym na węźle źródłowym każdego wiązania,
Wokół zamkniętej pętli każdy węzeł jest źródłem dokładnie jednego wiązania, więc pętla zbiera po jednym na węzeł, czyli parzystość lokalną czterech węzłów płytki. To właśnie ta parzystość lokalna robi różnicę: hamiltonian przeskakuje cząstki przez granicę płytki, więc zachowuje tylko parzystość globalną. Goła pętla transferu nie komutuje więc z nią, podczas gdy pętla krawędziowa (niosąca czynnik parzystości) komutuje.
Ponieważ kodowanie jest zdefiniowane na operatorach transferu, odwzorowanie operatora krawędziowego wymaga powyższej relacji. To pięciolinijkowe wywołanie zwrotne, które wpasowuje się w map_edge_vertex_generators() dokładnie tak, jak vc_action wpasowuje się w map_transfer_vertex_generators():
>>> from qiskit_fermions.mappers import map_edge_vertex_generators
>>> from qiskit_fermions.operators import EdgeVertexOperator
>>>
>>> def vc_edge_action(generator, width, cols):
...     """Map one generalized *edge* operator to its Verstraete-Cirac Pauli."""
...     j, k = generator
...     if j == k:  # a vertex operator is the same object in both algebras
...         return SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_qubits=width)
...     # The library decomposes T_jk = (i/2) V_j E_jk, so E_jk = -2i V_j T_jk. Reuse the
...     # transfer encoding for T_jk rather than repeating its four cases here. Note that
...     # `compose` left-multiplies its argument, so this composes to V_j T_jk; the other
...     # order carries the opposite sign, since a vertex and a transfer operator sharing a
...     # mode anticommute.
...     vertex = SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_qubits=width)
...     return (-2.0j * vc_action(generator, width, cols).compose(vertex)).simplify()
>>>
>>> def vc_edge_encoding(operator, width, cols):
...     """Map an EdgeVertexOperator to a qubit observable, Verstraete-Cirac style."""
...     return map_edge_vertex_generators(
...         operator,
...         partial(vc_edge_action, width=width, cols=cols),
...         identity=lambda: SparseObservable.identity(width),
...         compose=SparseObservable.compose,
...     ).simplify()
>>>
>>> def plaquette_loops(rows, cols):
...     """The directed edge loop around each square face."""
...     at = lambda r, c: r * cols + c
...     return [
...         [(at(r, c), at(r, c + 1)), (at(r, c + 1), at(r + 1, c + 1)),
...          (at(r + 1, c + 1), at(r + 1, c)), (at(r + 1, c), at(r, c))]
...         for r in range(rows - 1)
...         for c in range(cols - 1)
...     ]
>>>
>>> def stabilizers(rows, cols):
...     """One plaquette stabilizer per square face of the lattice."""
...     num_qubits = 2 * rows * cols
...     out = []
...     for loop in plaquette_loops(rows, cols):
...         loop_operator = EdgeVertexOperator.from_dict({tuple(loop): 1.0})
...         encoded_loop = vc_edge_encoding(loop_operator, num_qubits, cols)
...         out.append(encoded_loop / complex(encoded_loop.coeffs[0]))
...     return out
>>>
>>> plaquette_stabilizers = stabilizers(rows, cols)
>>> for stabilizer in plaquette_stabilizers:
...     print(stabilizer.to_sparse_list())
[('ZZYXXY', [1, 4, 9, 10, 12, 13], (1+0j))]
[('ZZYXXY', [2, 5, 10, 11, 13, 14], (1+0j))]
[('ZZYXXY', [4, 7, 12, 13, 15, 16], (1+0j))]
[('ZZYXXY', [5, 8, 13, 14, 16, 17], (1+0j))]
Każdy generator ma wagę , rozłożoną na dwa fizyczne kubity jego płytki i cztery ancille. Są inwolucyjne i komutują z zakodowanym hamiltonianem, więc dynamika zachowuje podprzestrzeń fizyczną. Obie własności są stwierdzeniami o operatorach, więc sprawdza się je symbolicznie w algebrze SparseObservable, bez potrzeby macierzy :
>>> encoded = encoding(hamiltonian, num_qubits)
>>> identity = SparseObservable.identity(num_qubits)
>>> for stabilizer in plaquette_stabilizers:
...     square = stabilizer.compose(stabilizer).simplify()
...     print(square == identity, stabilizer.commutes(encoded))
True True
True True
True True
True True
Mając stabilizatory, porównanie nie wymaga odpowiedniości baz, ponieważ oznacza, że obsadzenia żyją na tych samych fizycznych kubitach w obu obrazach. Zatem: zapisz stan produktowy bezpośrednio na fizycznych kubitach z ancillami w , zrzutuj go na podprzestrzeń stabilizatorów, ewoluuj zakodowanym hamiltonianem i odczytaj gęstości węzłów po obu stronach.
Każdy krok tutaj pozostaje na poziomie wektora. Rzutnik jest stosowany po jednym czynniku zamiast być wymnażany, a ewolucja czasowa używa expm_multiply(), które oblicza bez tworzenia . Ponieważ zakodowany hamiltonian jest rzadkim operatorem -wymiarowym, to rozróżnienie sprawia, że ta sekcja jest tania.
>>> from scipy.sparse.linalg import expm_multiply
>>> from qiskit_fermions.mappers.library import transfer_vertex_jordan_wigner
>>>
>>> # an exact evolution time, unrelated to the Trotter step above
>>> evolution_time = 0.6
>>> reference = transfer_vertex_jordan_wigner(hamiltonian, num_sites).simplify()
>>>
>>> def to_sparse_matrix(observable):
...     # SparseObservable carries no dense- or sparse-matrix method, so route through
...     # SparsePauliOp. This is only ever needed for the numerical checks below --
...     # the encoding itself never leaves SparseObservable.
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
>>>
>>> def basis_state(occupation, num_qubits):
...     """The computational basis state with `occupation` on the first qubits.
...
...     Qubit `q` carries bit `2**q`, and the ancillas are the *high* qubits `N..2N-1`,
...     so the same integer indexes the same site occupations on either register and
...     leaves every ancilla in |0>.
...     """
...     index = int("".join(str(bit) for bit in reversed(occupation)), 2)
...     state = np.zeros(2**num_qubits, dtype=complex)
...     state[index] = 1.0
...     return state
>>>
>>> def project_onto_codespace(state, stabilizers):
...     """Apply the projector one (1 + S) factor at a time, then renormalize.
...
...     The factors commute, so their product is itself a projector and the order does
...     not matter. Multiplying it out would build a dense 2^2N x 2^2N operator; applied
...     factor by factor this stays a handful of sparse matrix-vector products.
...
...     Each factor is really (1 + S)/2, but every one contributes the same scalar, so the
...     halvings only rescale the result and the final normalization absorbs them.
...     """
...     for stabilizer in stabilizers:
...         state += to_sparse_matrix(stabilizer) @ state
...     return state / np.linalg.norm(state)
>>>
>>> occupation = [1, 0, 1, 0, 1, 0, 0, 1, 0]  # site occupations of the initial state
>>> initial_reference = basis_state(occupation, num_sites)
>>> initial_encoded = project_onto_codespace(
...     basis_state(occupation, num_qubits), plaquette_stabilizers
... )
>>>
>>> evolved_encoded = expm_multiply(
...     -1j * evolution_time * to_sparse_matrix(encoded), initial_encoded
... )
>>> evolved_reference = expm_multiply(
...     -1j * evolution_time * to_sparse_matrix(reference), initial_reference
... )
>>>
>>> def density(state, qubit, width):
...     """Site density <n_j> = (1 - <Z_j>) / 2 of a statevector."""
...     z = to_sparse_matrix(
...         SparseObservable.from_sparse_list([("Z", [qubit], 1.0)], num_qubits=width)
...     )
...     return (1 - (state.conj() @ (z @ state)).real) / 2
>>>
>>> encoded_densities = [density(evolved_encoded, j, num_qubits) for j in range(num_sites)]
>>> reference_densities = [density(evolved_reference, j, num_sites) for j in range(num_sites)]
>>>
>>> for j, density_value in enumerate(encoded_densities):
...     print(f"site {j}: {density_value:.10f}")
site 0: 0.6750993356
site 1: 0.3689791258
site 2: 0.6750993356
site 3: 0.3818130396
site 4: 0.4868585996
site 5: 0.3818130396
site 6: 0.2693544696
site 7: 0.4916285849
site 8: 0.2693544696
>>> np.allclose(encoded_densities, reference_densities, atol=1e-12)
True
To są zakodowane gęstości; zgadzają się z odniesieniem Jordana-Wignera z dokładnością maszynową, na siatce, której kodowanie jest wierne dopiero po rzutowaniu.
10. Zmierz zbieżność Trottera
Krok 8 ustalił, że obie syntezy zgadzają się ze sobą, co jest stwierdzeniem o równoważności, a nie dokładności: obie opisują ten sam pojedynczy krok Trottera, więc niosą ten sam błąd Trottera. Zmierzenie tego błędu wymaga dokładnego odniesienia, a krok 9 właśnie je zbudował.
Liczba kroków pochodzi z FermionicLieTrotter, fermionowego odpowiednika wzoru na poziomie kubitów użytego wcześniej jako punkt odniesienia. Zastosowane do całego zgrupowanego operatora przed dekompozycją, jego powtarzanie cyklicznie przechodzi między czterema zbiorami przepływu a grupą diagonalną, zamiast wewnątrz któregokolwiek z nich:
>>> initial_state = project_onto_codespace(
...     basis_state(occupation, num_qubits), plaquette_stabilizers
... )
>>> exact = expm_multiply(
...     -1j * total_time * to_sparse_matrix(encoded), initial_state
... )
>>>
>>> def trotter_fidelity(steps):
...     # `steps` goes to the fermionic formula inside transpile_trotter_step, so the
...     # repetition cycles between the flow sets rather than within any one of them
...     circuit = transpile_trotter_step(
...         rows, cols, FlowSetSynthesis(rows, cols), steps=steps
...     )
...     evolved = Statevector(initial_state).evolve(circuit.decompose(reps=6))
...     return abs(np.vdot(evolved.data, exact)) ** 2
>>>
>>> for steps in (1, 2, 4, 8):
...     print(f"{steps} step(s): fidelity {trotter_fidelity(steps):.6f}")
1 step(s): fidelity 0.053820
2 step(s): fidelity 0.704014
4 step(s): fidelity 0.932937
8 step(s): fidelity 0.982687
Wierność monotonicznie rośnie ku jedynce wraz ze skracaniem kroków, co jest zachowaniem, jakie musi wykazywać wzór produktowy. Skracanie kroków to tylko jedno z dwóch pokręteł; FermionicSuzukiTrotter wymienia je jedno na drugie w wyższym rzędzie, co mierzy Synteza bramki Evolution w przestrzeni fermionowej.
Pojedynczy krok tego hamiltonianu przy jest słabym przybliżeniem (cztery zbiory przeskoków i oddziaływanie nie komutują), więc pierwszy wiersz jest daleki od jedynki, i o to chodzi: zbieżność potwierdza konstrukcję, a nie żaden pojedynczy wiersz.
Każdy czynnik harmonogramu obejmuje wszystkie mody tej siatki, więc zawężenie czynnika do jego nośnika jest tu operacją pustą, a bezwzględne indeksy kubitów, na których dopasowuje FlowSetSynthesis, pozostają niezmienione. Synteza napisana dla operatora, którego grupy dotykają tylko części rejestru, musiałaby uwzględnić to przenumerowanie.
Co warto zapamiętać
-
Dwa wymiary zmieniają księgowanie, a nie przepis. Każdy składnik z przewodnika 1D przenosi się bez zmian:
groupsdla grupowania,map_transfer_vertex_generators()dla kodowania,CustomF2QLayoutdla niedopasowanego rejestru iMapperFnEvolutionSynthesisdo podłączenia go do transpilera. Urosła liczba przypadków wewnątrz każdego z nich. -
Rozłączność sprawia, że 2D ma stałą głębokość. Zbiór przepływu rozkłada się na rozłączne wierzchołkowo linie, więc jego operacje Cliffordda są emitowane równolegle i dzielą dwie warstwy dwukubitowe bez względu na wielkość siatki. Cztery zbiory przepływu i grupa diagonalna dają wtedy stały budżet: tutaj dla czterech zbiorów przepływu plus dla diagonalnej grupy oddziaływania.
-
Każda orientacja ma własny kształt Pauliego. zamienia
XXZnaYYZiXYXYnaYXXY, więc cztery zbiory przepływu potrzebują czterech operacji Cliffordda. Założenie, że jedna operacja Cliffordda obejmuje obie orientacje osi, to najłatwiejszy sposób na błędną syntezę zbioru przepływu 2D. -
Odczytuj nośniki ze sprzężenia. W 1D jeden układ cegiełkowy
CZdaje obrazy w postaci zamkniętej. W 2D nie ma takiego wzoru, a linie kolumnowe mają nieciągłe ancille, więc ręcznie wyprowadzone zgadywanie, gdzie ląduje każdy wyraz, jest kruche. Sprzęgnięcie i sprawdzenie wyniku kosztuje jedną konstrukcjęCliffordi nie może być błędne; oznacza też, że równie poprawna operacja Cliffordda, która ląduje wyrazy gdzie indziej, nadal działa. -
Niech grupowanie robi sortowanie. Ponieważ
Evolutiondzieli się według grup, synteza dostaje jeden zbiór przepływu naraz i nigdy nie musi na nowo wyprowadzać podziału: odczytuje jeden kształt Pauliego z pierwszego wyrazu i wybiera pasującą operację Cliffordda. Założenie tego i zgłaszanie błędu, gdy nie zachodzi, sprawia, żesynthesizejest krótkie. -
Liczba kroków leży ponad podziałem. Synteza tutaj widzi jeden zbiór przepływu na bramkę, więc nie może podzielić ewolucji między zbiory.
FermionicLieTrotterrobi to w przestrzeni fermionowej, przed dekompozycją, co w ogóle umożliwia test zbieżności. -
Weryfikuj na podprzestrzeni. Kodowanie modów na kubitach jest wierne tylko tam, gdzie mówią stabilizatory. Ponieważ VC zachowuje , najtańszym wiarygodnym sprawdzeniem jest zrzutowanie stanu produktowego i porównanie gęstości: bez operatora splatającego i bez dopasowywania widm, które jest zawodne, gdy ograniczony hamiltonian jest zdegenerowany.
Zakodowany hamiltonian komutuje ze stabilizatorami, więc rzutowanie trzeba zastosować tylko do stanu początkowego. Ewolucja sama zachowuje podprzestrzeń. Na prawdziwym sprzęcie to także sprawia, że kodowanie jest użyteczne jako zasób wykrywania błędów: stabilizatory można mierzyć.
Dalej
Dwa kierunki rozszerzają powyższe i oba są zmianami składnika, a nie metody. Pierwszy to kodowanie: Verstraete-Cirac wybrano tutaj, ponieważ Ref. [1] podaje jego diagonalizujące operacje Cliffordda w postaci zamkniętej, ale Derby-Klassen zużywa jedną ancillę na nieparzystą płytkę zamiast jednej na węzeł, co daje stosunek kubitów do modów zamiast . Jego operatory transferu mają inne kształty Pauliego, więc przeniesienie sprowadza się do przepisania funkcji kodującej z kroku 3 i znalezienia operacji Cliffordda dla każdego nowego kształtu; grupowanie, układ i rusztowanie syntezy przenoszą się bez zmian.
Drugi to sama siatka. Wszystko tutaj zakłada otwarte brzegi i jeden gatunek fermionów. Brzegi okresowe zamykają każdą linię w cykl: strzałki nadal wszystkie komutują, bo każda spotyka następną „głowa do ogona”, ale dwa kształty Cliffordda z kroku 5 są zbudowane dla linii z końcami. Cykl węzłów niesie wiązań na orientację, tam gdzie linia niesie , więc wiązanie zamykające nie ma miejsca w konstrukcji i wymaga osobnej obsługi. Model ze spinem jest łatwiejszy: podwaja rejestr i dodaje wyrazy oddziaływania na węźle do grupy diagonalnej, nie ruszając zbiorów przepływu. Żaden nie narusza argumentu o stałej głębokości, ale oba zmieniają księgowanie, które, jak mówi pierwszy wniosek, jest tą częścią, którą dwa wymiary powiększają.
Łączność sprzętu nie jest tu omawiana. Każdy powyższy obwód jest zbudowany na abstrakcyjnym rejestrze, w którym dowolna para kubitów może oddziaływać, a podane głębokości są liczone w tym ustawieniu. Prawdziwe urządzenia mają ograniczoną mapę sprzężeń, a odwzorowanie tego kodowania na nią jest osobnym, poważnym problemem: rejestr VC to graf kubitów, którego bramki działają między węzłem a jego własną ancillą, między sąsiednimi węzłami i między sąsiednimi ancillami, więc układ musi utrzymać wszystkie trzy rodzaje par jako sąsiadujące jednocześnie. Jeśli nie może, transpiler wstawia bramki SWAP, a warstwy, które dodają, to dokładnie to, co konstrukcja o stałej głębokości miała odkupić. Ref. [1] podobnie podaje swoją głębokość przy założonym kwadratowym grafie łączności z CX jako jedynym natywnym bramką splątującą. Znalezienie dobrych układów i strategii routingu dla lokalnych kodowań na danej topologii urządzenia wykracza poza zakres tego przewodnika.
A. Gandon, S. Piccinelli, M. Rossmannek, F. Tacchino, A. Baiardi, J. Nys, and I. Tavernelli, Stabilizer-based quantum simulation of fermion dynamics with local qubit encodings (2026), arXiv:2512.11418v2.
F. Verstraete and J. I. Cirac, Mapping local Hamiltonians of fermions to local Hamiltonians of spins, J. Stat. Mech. 2005, P09012 (2005).
Y.-A. Chen and Y. Xu, Equivalence between fermion-to-qubit mappings in two spatial dimensions, PRX Quantum 4, 010326 (2023).