Symulacja dynamiki jednowymiarowego modelu Fermiego-Hubbarda za pomocą zbiorów przepływu
Funkcje opisane w tym przewodniku są obecnie dostępne tylko w API Pythona. Równoważna funkcjonalność pojawi się w API w C w przyszłym wydaniu.
Ten przewodnik buduje obwód dla dynamiki czasowej jednowymiarowego modelu Fermiego-Hubbarda, od zapisania hamiltonianu po sprawdzenie ewoluowanych gęstości na węzłach. Ciekawa jest w nim jedna idea, zaczerpnięta z koncepcji zbiorów przepływu (flow sets) Gandona i in. [1], pracy, która zainspirowała też TransferVertexOperator w tym pakiecie:
Zamiast grupować wyrazy hamiltonianu po odwzorowaniu fermion-kubit, grupuj je przed nim, w zbiory przepływu, czyli jednowymiarowe podzbiory skierowanego grafu oddziaływań fermionowych, których operatory transferu wzajemnie się komutują.
Ten wybór determinuje wszystko poniżej. Wymaga on następujących elementów:
-
Własnego kodowania fermion-kubit dopasowanego do zbiorów przepływu, które tutaj zużywa jeden kubit pomocniczy (ancilla), tak że liczba kubitów związana z implementacją danego wyrazu hamiltonianu nie rośnie już wraz z liczbą modów fermionowych (jak to ma miejsce w przypadku Jordana-Wignera (JW)).
-
Własnej syntezy, która wykorzystuje komutowanie w obrębie każdego zbioru. Zyskiem jest obwód, którego głębokość dwukubitowa jest stała względem rozmiaru układu, w przeciwieństwie do liniowego wzrostu przy trotteryzacji wyraz po wyrazie opartej na JW.
Mechanizm, który wprowadza do transpilera Twoje własne kodowanie (CustomF2QLayout i MapperFnEvolutionSynthesis), przenosi się na dowolny model.
Przewodnik po transpilacji dla etapów transpilera, do których odwołujemy się w całym tekście, oraz przewodnik po mapperach z ogólnym przepisem na pisanie własnego mappera.
Operatory transferu i zbiory przepływu
TransferVertexOperator jest zbudowany z operatorów wierzchołkowych i operatorów transferu . W terminach fermionowych operatorów kreacji i anihilacji,
więc mierzy obsadzenie modu (wynosi , gdy jest pusty, i , gdy jest zajęty), a przenosi fermion wzdłuż skierowanej krawędzi . Zauważ, że dwa indeksy nie są zamienne. Pierwszy indeks niesie kombinację z minusem, a drugi z plusem, co odróżnia od i nadaje krawędzi orientację.
Spełniają one mieszane relacje komutacji. Dwa operatory transferu działające na rozłączne węzły komutują trywialnie, ponieważ każdy jest parzystym iloczynem operatorów fermionowych. Ciekawy jest przypadek wspólnego węzła. Wtedy oba komutują, jeśli strzałki przepływają przez ten węzeł (jedna wchodzi, jedna wychodzi), a antykomutują, jeśli się zderzają (obie wchodzą albo obie wychodzą).
Regułę najłatwiej zobaczyć na rysunku. Narysowanie wierzchołków jako węzłów, a każdego jako strzałki od do daje skierowany graf oddziaływań, tutaj dla czterowęzłowego łańcucha używanego w całym tym przewodniku, który zawiera obie orientacje każdego wiązania:

Prześledź regułę na rysunku. Weźmy na przykład i . Jedna strzałka wchodzi do węzła 2, a druga z niego wychodzi, więc fermion przepływa wprost i oba operatory komutują. Spójrz teraz na i . Obie strzałki wskazują na węzeł 2. Zderzają się, więc te dwa operatory antykomutują.
To właśnie umożliwia zbiory przepływu. Wybierz zbiór strzałek tworzących skierowaną ścieżkę, a każda para albo styka się głowa do ogona, albo wcale się nie styka, więc cały zbiór komutuje, mimo że poszczególne operatory nakładają się na wspólnych węzłach. Ewolucja pod działaniem pojedynczego zbioru przepływu nie wprowadza więc żadnego błędu Trottera, a jak pokazuje krok 7, można ją też zrealizować przy stałej głębokości obwodu.
1. Hamiltonian Fermiego-Hubbarda
Jednowymiarowy model Fermiego-Hubbarda na węzłach (bezspinowy, z otwartymi brzegami) ma postać
Zgodnie z równaniem (9) z pracy [1] [1], człon przeskoku to . Oddziaływanie jest diagonalne, więc wyraża się je przez operatory wierzchołkowe za pomocą :
Oba składniki są budowane bezpośrednio jako TransferVertexOperator. Zauważ, że jest zapisywany jako wpis diagonalny (j, j):
>>> from collections import defaultdict
>>> from qiskit_fermions.operators import TransferVertexOperator
>>>
>>> def fermi_hubbard_1d(num_sites, tunneling, interaction):
...     data: defaultdict[tuple[tuple[int, int], ...], complex] = defaultdict(complex)
...     for j in range(num_sites - 1):
...         k = j + 1
...         # hopping: -t (a^dag_j a_k + a^dag_k a_j) = t (T_jk + T_kj)
...         data[((j, k),)] += tunneling
...         data[((k, j),)] += tunneling
...         # interaction: U n_j n_k with n_j = (1 - V_j) / 2
...         data[()] += interaction / 4
...         data[((j, j),)] -= interaction / 4
...         data[((k, k),)] -= interaction / 4
...         data[((j, j), (k, k))] += interaction / 4
...     return TransferVertexOperator.from_dict(data)
>>>
>>> num_sites = 4
>>> hamiltonian = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
>>> print(format(hamiltonian))
  1.500000e0 +0.000000e0j * ()
-5.000000e-1 +0.000000e0j * (V(0))
 5.000000e-1 +0.000000e0j * (V(0) V(1))
  1.000000e0 +0.000000e0j * (T(0,1))
  1.000000e0 +0.000000e0j * (T(1,0))
 -1.000000e0 +0.000000e0j * (V(1))
 5.000000e-1 +0.000000e0j * (V(1) V(2))
  1.000000e0 +0.000000e0j * (T(1,2))
  1.000000e0 +0.000000e0j * (T(2,1))
 -1.000000e0 +0.000000e0j * (V(2))
 5.000000e-1 +0.000000e0j * (V(2) V(3))
  1.000000e0 +0.000000e0j * (T(2,3))
  1.000000e0 +0.000000e0j * (T(3,2))
-5.000000e-1 +0.000000e0j * (V(3))
Węzły wewnętrzne dostają współczynnik przy , ponieważ występują w dwóch wiązaniach, podczas gdy węzły brzegowe występują tylko w jednym. Każdy wypisany tu wyraz występuje na narysowanym wyżej grafie. Wyrazy T(j,k) to jego strzałki, a wyrazy V(j) to jego węzły.
2. Podział na zbiory przepływu
Następnie oznacz każdy wyraz zbiorem przepływu, do którego należy. Służy do tego atrybut groups. Bramka Evolution nad pogrupowanym operatorem rozkłada się na jedną bramkę Evolution na grupę (krok 6 to wykorzystuje), więc podział ustalony tutaj na poziomie fermionowym przetrwa w obwodzie.
Dla łańcucha 1D dwa zbiory przepływu przeskoków to strzałki skierowane na wschód () i strzałki skierowane na zachód (). Diagonalne wyrazy oddziaływania komutują ze wszystkim, co diagonalne, i tworzą trzecią grupę:
>>> def flow_set_groups(operator):
...     groups = []
...     for terms, _ in operator.iter_terms():
...         match terms:
...             case [(left, right)] if right == left + 1:
...                 groups.append(0)  # east-oriented: T_{j,j+1}
...             case [(left, right)] if right == left - 1:
...                 groups.append(1)  # west-oriented: T_{j+1,j}
...             case _:
...                 groups.append(2)  # diagonal interaction terms
...     return groups
>>>
>>> hamiltonian.groups = flow_set_groups(hamiltonian)
>>> hamiltonian.num_groups()
3
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(index, sorted(terms for terms, _ in group.iter_terms()))
0 [[(0, 1)], [(1, 2)], [(2, 3)]]
1 [[(1, 0)], [(2, 1)], [(3, 2)]]
2 [[], [(0, 0)], [(0, 0), (1, 1)], [(1, 1)], [(1, 1), (2, 2)], [(2, 2)], [(2, 2), (3, 3)], [(3, 3)]]
Grupy 0 i 1 to dwa zbiory przepływu. Każdy zbiór jest skierowaną ścieżką wzdłuż łańcucha, więc z własności przepływu wszystkie wyrazy w obrębie grupy komutują.
Każda grupa musi też być hermitowska sama w sobie, ponieważ formuła iloczynowa potęguje grupy osobno, a tylko czynnik hermitowski ma ewolucję unitarną. groups_are_hermitian() to potwierdza:
>>> from qiskit_fermions.operators.terms.grouping import groups_are_hermitian
>>>
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
Warto się tu zatrzymać, ponieważ dwie grupy przeskoków są jednokierunkowe: grupa 0 zawiera tylko wyrazy skierowane na wschód, a grupa 1 tylko na zachód. Taki podział hamiltonianu zwykle łamałby hermitowskość, ponieważ potrzebuje obok siebie sprzężonego partnera . TransferVertexOperator unika tego problemu, ponieważ jest już sam w sobie hermitowski. Jest iloczynem dwóch operatorów Majorany (zobacz jego definicję w kroku 1), a nie gołego , więc jego obraz Jordana-Wignera ma rzeczywisty, a nie urojony współczynnik. Wybór tej reprezentacji operatora sprawia zatem, że jednokierunkowy zbiór przepływu jest w ogóle prawidłowym czynnikiem Trottera.
Etykiety wschód/zachód używane w całym tym przewodniku są geometryczne: łańcuch jest rysowany od lewej do prawej, a indeksy modów rosną w tym kierunku; wskazuje na wschód, a na zachód. Praca [1] jest niespójna wewnętrznie w tym nazewnictwie (tekst i rysunki się różnią), więc ten przewodnik celowo nie idzie za tekstem, tylko zachowuje etykiety z rysunku. Przy porównywaniu z pracą dopasuj zbiory przepływu według wag Pauliego (1 i 3 poniżej), a nie według słów określających strony świata.
3. Napisz własne kodowanie
Sekcja IV B pracy [1] klasyfikuje postacie, jakie może przyjąć lokalne kodowanie fermion-kubit po ograniczeniu do zbioru przepływu. Zwykły Jordan-Wigner używa kubitów i odwzorowuje każdy wyraz przeskoku na operator Pauliego o wadze 2. Klasyfikacja pokazuje, że wydanie dodatkowych kubitów kupuje strukturę w zakodowanych operatorach.
Zaimplementowane tu kodowanie to konstrukcja z delokalizowaną parzystością z dodatku B 2 (równania B4 i B5), która używa jednego kubitu pomocniczego, więc . Parzystość fermionowa jest delokalizowana na parę kubitów:
Indeks w ostatnim wyrażeniu wymusza dodatkowy kubit. Ostatnie wiązanie łańcucha ma , więc jego trafia na kubit , o jeden za ostatnim modem fermionowym . Ten końcowy kubit to ancilla i dlatego , a nie . Ten sam zasięg widać w , którego działa na ancillę dla .
Zysk widać od razu: cały jeden zbiór przepływu odwzorowuje się na sumę operatorów Pauliego o wadze 1.
Współczynniki są ustalone przez normalizację , a względny znak minus między dwiema orientacjami jest ustalony przez tożsamość iloczynową , którą powyższe operatory Pauliego spełniają. Pomyłka w którymkolwiek z nich daje operator, który spełnia relacje komutacji, ale nie reprezentuje już tego samego hamiltonianu, więc kodowanie warto zweryfikować numerycznie, jak pokazano w kroku 4.
Napisanie kodowania oznacza napisanie funkcji, która odwzorowuje pojedynczy uogólniony operator transferu na ciąg Pauliego; iterację po wyrazach i ich składanie obsługuje map_transfer_vertex_generators():
>>> from qiskit.quantum_info import SparseObservable
>>> from qiskit_fermions.mappers import map_transfer_vertex_generators
>>>
>>> def flow_set_action(action, num_qubits):
...     match action:
...         case (j, k) if j == k:
...             # vertex operator: V_j = Z_j Z_{j+1}
...             return SparseObservable.from_sparse_list(
...                 [("ZZ", [j, j + 1], 1.0)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j + 1:
...             # east-oriented transfer operator: weight 1
...             return SparseObservable.from_sparse_list(
...                 [("X", [k], -0.5)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j - 1:
...             # west-oriented transfer operator: weight 3
...             return SparseObservable.from_sparse_list(
...                 [("ZXZ", [k, k + 1, k + 2], 0.5)], num_qubits=num_qubits
...             )
...         case _:
...             raise ValueError(f"not a nearest-neighbor transfer operator: {action}")
>>>
>>> def flow_set_encoding(operator, num_qubits):
...     return map_transfer_vertex_generators(
...         operator,
...         lambda action: flow_set_action(action, num_qubits),
...         identity=lambda: SparseObservable.identity(num_qubits),
...         compose=SparseObservable.compose,
...     ).simplify()
MapperFnEvolutionSynthesis.mapper_fn oczekuje sygnatury (operator, num_qubits), a zwracanym typem musi być SparseObservable, co pozwala użyć funkcji bezpośrednio jako wtyczki transpilera. Zobacz krok 6.
Zastosowanie go do hamiltonianu z kroku 1 daje zakodowany operator na kubitach:
>>> num_qubits = num_sites + 1
>>> encoded = flow_set_encoding(hamiltonian, num_qubits)
>>> for label, indices, coeff in sorted(encoded.to_sparse_list()):
...     print(f"{label:3s} {str(indices):12s} {coeff.real:+.2f}")
    []           +1.50
X   [1]          -0.50
X   [2]          -0.50
X   [3]          -0.50
ZXZ [0, 1, 2]    +0.50
ZXZ [1, 2, 3]    +0.50
ZXZ [2, 3, 4]    +0.50
ZZ  [0, 1]       -0.50
ZZ  [0, 2]       +0.50
ZZ  [1, 2]       -1.00
ZZ  [1, 3]       +0.50
ZZ  [2, 3]       -1.00
ZZ  [2, 4]       +0.50
ZZ  [3, 4]       -0.50
Jest 14 wyrazów w trzech kształtach: przeskok przyjął postać X i ZXZ, oddziaływanie ZZ, a początkowe [] to identyczność, która wnosi tylko fazę globalną. Zauważ, że wyrazy ZZ sięgają najbliższych i następnych w kolejności sąsiadów; obejmuje kubity od do , co jest ceną delokalizacji parzystości.
Grupowanie według zbiorów przepływu ujawnia asymetrię, którą daje ta konstrukcja. Wypisz wagi Pauliego obecne w każdej grupie:
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     weights = {len(indices) for _, indices, _ in flow_set_encoding(group, num_qubits).to_sparse_list()}
...     print(index, sorted(weights))
0 [1]
1 [3]
2 [0, 2]
Zbiór przepływu skierowany na wschód (grupa 0) składa się w całości z operatorów Pauliego o wadze 1. Jego ewolucja czasowa jest więc warstwą rotacji jednokubitowych i nie wymaga żadnych bramek splątujących, podczas gdy w Jordanie-Wignerze każdy wyraz przeskoku ma wagę 2 i ich wymaga. To kompromis czasoprzestrzenny z pracy [1] w najprostszej postaci: jeden dodatkowy kubit zamienia połowę hamiltonianu przeskoków na rotacje jednokubitowe.
Zbiór przepływu skierowany na zachód (grupa 1) płaci za to wagą trzy, a oddziaływanie (grupa 2) ma wagę dwa, przy czym wpis o wadze zero to identyczność. Nic z tego nie jest jeszcze twierdzeniem o obwodzie; to, co synteza robi z tych wag, jest tematem kroków 6 i 7.
4. Weryfikacja kodowania
Własne kodowanie jest użyteczne tylko wtedy, gdy jest wierne, a napisane ręcznie warto sprawdzić. Ponieważ to kodowanie używa kubitów, przestrzeń Hilberta kubitów jest dwa razy większa niż fermionowa, więc zakodowany hamiltonian nie może być równy hamiltonianowi Jordana-Wignera wyraz po wyrazie. Łączy je natomiast izometria.
Skąd bierze się izometria: W Jordanie-Wignerze stan bazowy to ciąg obsadzeń; kubit przechowuje . To kodowanie przechowuje zamiast tego skumulowane parzystości. Zdefiniuj
więc bit zapisuje parzystość wszystkich obsadzeń do węzła włącznie. Jest takich bitów dla obsadzeń, skąd bierze się ancilla. Obsadzenie odzyskuje się jako różnicę sąsiednich bitów, . Zajęty węzeł pojawia się więc jako ściana domenowa między dwoma sąsiednimi bitami, dlatego kodowanie to nazywa się kodowaniem ścian domenowych (lub Kramersa-Wanniera). To także powód, dla którego : iloczyn dwóch sąsiednich odczytuje tę różnicę.
Zapisanie tego odwzorowania dla kilku stanów uwidacznia jego strukturę (zauważ, że jest ustalone, więc tylko połowa z stanów kubitowych należy do obrazu, a zatem mamy izometrię, a nie macierz unitarną):
>>> def domain_wall_bits(occupations):
...     parity = 0
...     bits = [0]
...     for occupation in occupations:
...         parity ^= occupation
...         bits.append(parity)
...     return bits
>>>
>>> for occupations in ([0, 0, 0, 0], [1, 0, 0, 0], [1, 1, 0, 0], [1, 0, 1, 0]):
...     bits = domain_wall_bits(occupations)
...     # little-endian: reversed() prints qubit 0 on the right, as Qiskit labels do
...     print("".join(map(str, occupations)), "->", "".join(str(b) for b in reversed(bits)))
0000 -> 00000
1000 -> 11110
1100 -> 00010
1010 -> 00110
Pojedynczy fermion w miejscu 0 przerzuca każdą skumulowaną parzystość powyżej niego, co jest właśnie działaniem delokalizacji. Zebranie tych kolumn w macierz daje izometrię , a kodowanie jest wierne, gdy splata oba hamiltoniany:
Oznacza to, że odwzorowanie stanu fermionowego w przestrzeń kubitową, a następnie jego ewolucja tam, musi dać ten sam wynik, co najpierw ewolucja w przestrzeni fermionowej, a potem odwzorowanie.
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp
>>> from qiskit_fermions.mappers.library import transfer_vertex_jordan_wigner
>>>
>>> def to_matrix(observable):
...     # SparseObservable carries no dense-matrix method, so route through
...     # SparsePauliOp. This is only ever needed for the checks below --
...     # the encoding itself never leaves SparseObservable.
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix()
>>>
>>> def domain_wall_isometry(num_sites):
...     isometry = np.zeros((2 ** (num_sites + 1), 2**num_sites), dtype=complex)
...     for index in range(2**num_sites):
...         occupations = [(index >> j) & 1 for j in range(num_sites)]
...         bits = domain_wall_bits(occupations)
...         isometry[sum(b << j for j, b in enumerate(bits)), index] = 1.0
...     return isometry
>>>
>>> isometry = domain_wall_isometry(num_sites)
>>> np.allclose(isometry.conj().T @ isometry, np.eye(2**num_sites))
True
>>>
>>> def intertwines(operator):
...     """Whether both mappings of `operator` agree through the isometry."""
...     flow = to_matrix(flow_set_encoding(operator, num_qubits))
...     reference = to_matrix(transfer_vertex_jordan_wigner(operator, num_sites).simplify())
...     return np.allclose(flow @ isometry, isometry @ reference)
>>>
>>> intertwines(hamiltonian)
True
>>> # and, more strongly, once per flow set: a product formula evolves the groups
>>> # separately, so each one has to be intertwined on its own
>>> all(intertwines(group) for group in hamiltonian.split_out_groups())
True
Relacja splatania zachodzi dokładnie i osobno dla każdego zbioru przepływu. To drugie, mocniejsze stwierdzenie jest tym, na czym opierają się późniejsze kroki: wzór produktowy ewoluuje grupy jedna po drugiej, a iloczyn splecionych czynników sam jest splecony, więc każde przybliżenie zbudowane z tych grup zgadza się między oboma kodowaniami, mimo że kodowania się różnią. Wnioskiem jest to, że widma muszą się zgadzać, a każda wartość własna Jordana-Wignera pojawia się dwukrotnie w większej przestrzeni, raz dla każdej wartości nieograniczonej parzystości globalnej:
>>> jw_matrix = to_matrix(transfer_vertex_jordan_wigner(hamiltonian, num_sites).simplify())
>>> flow_matrix = to_matrix(flow_set_encoding(hamiltonian, num_qubits))
>>>
>>> jw_spectrum = np.linalg.eigvalsh(jw_matrix)
>>> flow_spectrum = np.linalg.eigvalsh(flow_matrix)
>>> np.allclose(
...     np.sort(flow_spectrum),
...     np.sort(np.concatenate([jw_spectrum, jw_spectrum])),
... )
True
>>> print(f"{jw_spectrum[0]:.10f}  {flow_spectrum[0]:.10f}")
-1.8557725066  -1.8557725066
5. Zbuduj obwód fermionowy
Zanim w grę wejdą jakiekolwiek kubity, dynamika jest wyrażana na poziomie fermionowym. FermionicCircuit działa na modach fermionowych, a nie na kubitach, a bramka Evolution nad hamiltonianem stanowi cały obwód:
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution
>>> from qiskit_fermions.circuit.library.synthesis import FermionicLieTrotter
>>>
>>> total_time = 1.0
>>> circuit = FermionicCircuit(num_sites)
>>> circuit.append(
...     Evolution(
...         num_sites, hamiltonian, time=total_time, synthesis=FermionicLieTrotter()
...     ),
...     circuit.modes,
... )
>>> circuit.draw("mpl")
<Figure size ... with 1 Axes>

Jest jedno nieprzezroczyste pudełko obejmujące wszystkie cztery mody, a ciekawe jest to, na co się ono rozkłada. Argument synthesis określa jak: FermionicLieTrotter to wzór produktowy pierwszego rzędu, który dzieli operator według jego groups i ewoluuje każdą grupę po kolei. Zatem podział na zbiory przepływu z kroku 2 jest trotteryzacją, a pojedyncze wywołanie decompose() ją wykonuje, dając jedną bramkę Evolution na zbiór przepływu w kolejności grup: wschód, zachód, a potem oddziaływanie diagonalne, odpowiednio z 3, 3 i 8 wyrazami.
>>> flow_set_circuit = circuit.decompose()
>>> flow_set_circuit.draw("mpl")
<Figure size ... with 1 Axes>
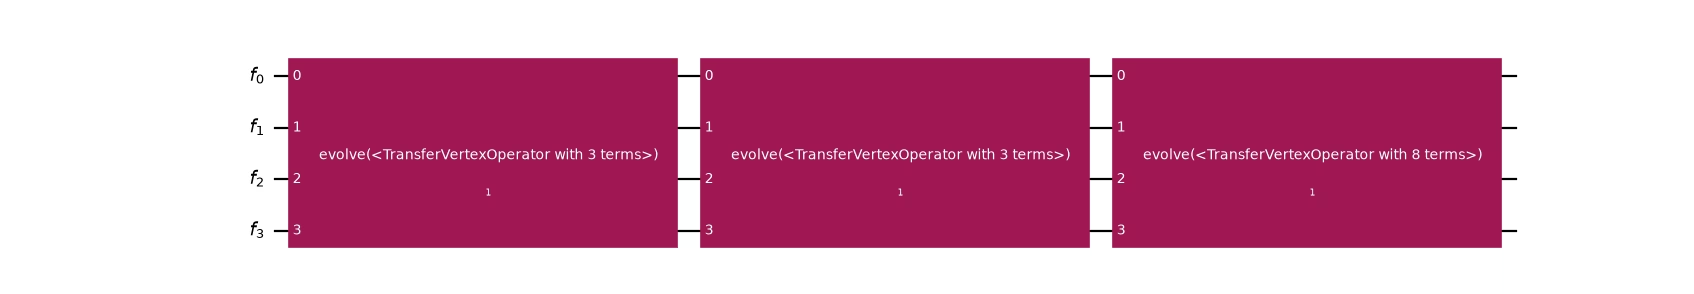
Zauważ, że dzieje się to w całości w przestrzeni fermionowej: żaden kubit nie został jeszcze wspomniany, a przybliżenie jest już dokonane. Liczba kroków Trottera należy więc również tutaj, jako reps, które dzieli czas i powtarza cały przebieg:
>>> def trotter_steps(reps):
...     step = FermionicCircuit(num_sites)
...     step.append(
...         Evolution(
...             num_sites,
...             hamiltonian,
...             time=total_time,
...             synthesis=FermionicLieTrotter(reps=reps),
...         ),
...         step.modes,
...     )
...     return step.decompose()
>>>
>>> trotter_steps(3).count_ops()["Evolution"]
9
Dziewięć bramek: trzy zbiory przepływu, przechodzone trzykrotnie, każdy przez jedną trzecią czasu. To właśnie cykliczne przechodzenie sprawia, że jest to trotteryzacja, a nie ponowne pocięcie jednej grupy. Powtarzanie pojedynczej grupy nic by nie dało, ponieważ kolejne wykładnicze tego samego operatora komutują, więc A(t/3) A(t/3) A(t/3) to po prostu A(t). Wzór, który odczytuje grupy, może je przeplatać; wzór zastosowany po odwzorowaniu nie może, bo grupowanie przestaje wtedy istnieć.
To jest krok, w którym grupowanie nabiera znaczenia. Każda wyemitowana bramka jest odwzorowywana i syntezowana niezależnie, więc wszystko w dalszych etapach działa na podziale ustalonym na poziomie fermionowym. Pominięcie dekompozycji przekazuje cały operator do następnego etapu, a grupowanie jest ignorowane.
6. Transpilacja z własnym kodowaniem
Kodowanie jest teraz gotowe do użycia przez transpiler. Potrzebne są jeszcze dwa elementy:
-
Układ (layout). Domyślny
TrivialF2QLayoutzakłada jeden kubit na modę, co w tej sytuacji jest błędne.CustomF2QLayoutwiąże rejestr fermionowy zQuantumRegistero innym rozmiarze, i w ten sposób kubity pomocnicze trafiają do potoku. -
Wtyczka syntezy.
MapperFnEvolutionSynthesisprzyjmuje bezpośrednio funkcję odwzorowującą, odwzorowuje nią hamiltonian bramkiEvolutioni emitujePauliEvolutionGate, zachowując konwencję . Jejproduct_formuladecyduje, jak ta bramka jest zamieniana na rotacje. Zauważ, że jest to drugi, niezależny wzór produktowy, działający na kubitach po odwzorowaniu: przekazywany jest tuLieTrotterz Qiskit, a krok 7 zastępuje go wzorem, który zna zbiory przepływu.
Ponieważ każde poniższe porównanie ponownie uruchamia ten potok, warto opakować go raz:
>>> from qiskit.circuit import QuantumRegister
>>> from qiskit.passmanager import MultiStagePassManager
>>> from qiskit_fermions.transpiler import FermionicCircuitToDAG, QuantumDAGToCircuit
>>> from qiskit_fermions.transpiler.passes import (
...     CustomF2QLayout,
...     F2QSynthesis,
...     MapperFnEvolutionSynthesis,
... )
>>>
>>> def flow_set_pass_manager(mode_register, product_formula=None):
...     '''Build the pipeline mapping `mode_register` with the flow-set encoding.'''
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         flow_set_encoding, product_formula=product_formula
...     )
...     # this encoding spends one ancilla on top of the fermionic modes
...     qubit_register = QuantumRegister(mode_register.size + 1, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from qiskit.synthesis import LieTrotter
>>>
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, LieTrotter())
>>> qubit_circuit = pass_manager.run(flow_set_circuit)
>>> qubit_circuit.num_qubits
5
Cztery mody fermionowe stały się pięciokubitowym obwodem, z kubitem pomocniczym dostarczonym przez własny układ.
Przyjrzyjmy się teraz, co faktycznie zawiera powstały obwód. Wielokrotna dekompozycja redukuje bramki ewolucji aż do U i CX, dzięki czemu dwukubitowy koszt obu porównywanych poniżej strategii syntezy jest mierzony w tej samej walucie: count_ops() podaje wtedy liczbę CX, a depth() przyjmuje funkcję filtrującą, aby zmierzyć głębokość dwukubitową. Zauważ, że to reps jest głębokością dekompozycji, niezwiązaną z liczbą kroków Trottera, którą wzór produktowy wykonuje i która w dalszej części tego przewodnika również nazywa się reps:
>>> decomposed = qubit_circuit.decompose(reps=6)
>>> decomposed.count_ops()["cx"]
26
>>> decomposed.depth(lambda instruction: len(instruction.qubits) == 2)
23
Dwadzieścia sześć bramek CX w dwudziestu trzech warstwach, więc prawie nic nie działa równolegle. Narysowanie obwodu pokazuje dlaczego:
>>> decomposed.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
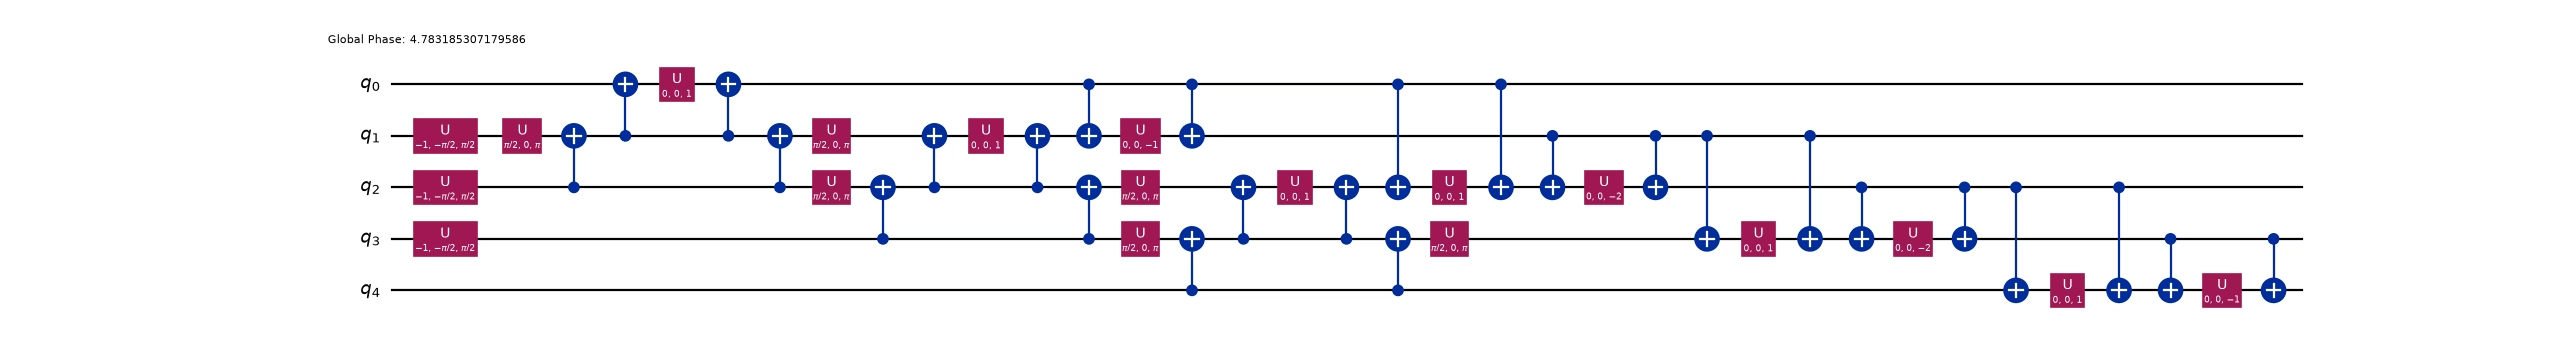
Każdy wyraz został skompilowany w izolacji: zmiana bazy, drabinka CX do pojedynczej rotacji, a potem cofnięcie drabinki. Zbiór przepływu o wadze 1 jest darmowy; jego wyrazy to pojedyncze rotacje bez drabinki wokół nich, ale każdy wyraz o wadze 3 kosztuje cztery bramki CX, a ponieważ drabinki są emitowane sekwencyjnie, nic się nie nakłada.
Zatem grupowanie przetrwa cały potok (trzy zbiory przepływu, trzy odwzorowane PauliEvolutionGate) i nadal daje niemal nic. Fermionowa trotteryzacja z kroku 5 wykonała swoje zadanie; marnuje ją wzór po stronie kubitów. LieTrotter otrzymuje zbiór wyrazów, o którym akurat nic mu nie powiedziano, i kompiluje każdy w izolacji. Nie może wiedzieć, że wzajemnie komutują, więc serializuje to, co mogłoby dzielić jedną zmianę bazy.
To jest luka, którą to kodowanie ma zamknąć: działają dwa wzory produktowe, a dotąd tylko fermionowy otrzymał informację o strukturze. Następny krok dostarcza syntezę po stronie kubitów, która również ją wykorzystuje.
7. Synteza uwzględniająca zbiory przepływu
Odzyskanie przewagi oznacza poinformowanie syntezy po stronie kubitów o strukturze. To jest sekcja IV C z pracy [1]: ponieważ wszystkie wyrazy zbioru przepływu komutują, można je jednocześnie zdiagonalizować jednym obwodem Cliffordowskim, obrócić we wspólnej bazie i obrócić z powrotem, zamiast robić to osobno dla każdego wyrazu. Odnośnik: [1].
W tym kodowaniu Clifford jest prosty. Sprzęganie łańcuchem bramek CZ między najbliższymi sąsiadami odwzorowuje
jednocześnie dla każdego . Jeden łańcuch CZ zamienia cały zbiór przepływu o wadze 3 (zachodni) w warstwę niezależnych jednokubitowych rotacji . Interfejs EvolutionSynthesis wymaga jedynie metody synthesize(), i tylko tę implementuje ta klasa. Nie niesie liczby kroków Trottera, ponieważ otrzymuje jeden zbiór przepływu naraz, więc nie może podzielić ewolucji między zbiory. Ten podział należy poziom wyżej, w przestrzeni fermionowej, gdzie F2FSynthesisPlugin widzi je wszystkie naraz (zobacz krok 9):
>>> from qiskit.circuit import QuantumCircuit
>>> from qiskit.synthesis.evolution import EvolutionSynthesis
>>>
>>> def cz_brickwork(circuit):
...     # emit even and odd bonds as two layers, so the CZs are scheduled in
...     # parallel: a chain of overlapping CZs has depth 2, not num_qubits - 1
...     #
...     # NOTE: CZ gates are diagonal, so they all commute and each is its own inverse.
...     # This whole layer is therefore self-inverse, which is why the conjugation below
...     # calls it twice rather than calling it and then its inverse.
...     for offset in (0, 1):
...         for j in range(offset, circuit.num_qubits - 1, 2):
...             circuit.cz(j, j + 1)
>>>
>>> # The interaction reaches nearest (distance 1) and next-nearest (distance 2)
>>> # neighbors, so every interior qubit carries four Rzz gates and can only do one at
>>> # a time: four layers is the best any schedule can do. These offsets achieve it.
>>> def rzz_layers(circuit, angles):
...     """Emit the diagonal Rzz gates in four layers of disjoint qubit pairs."""
...     near = [(j, k) for j, k in angles if k - j == 1]
...     far = [(j, k) for j, k in angles if k - j == 2]
...     schedule = [
...         [(j, k) for j, k in near if j % 2 == 0],
...         [(j, k) for j, k in far if j % 4 in (0, 1)],
...         [(j, k) for j, k in near if j % 2 == 1],
...         [(j, k) for j, k in far if j % 4 in (2, 3)],
...     ]
...     # emit layer by layer, since Qiskit's depth follows the order gates were added
...     for layer in schedule:
...         for j, k in layer:
...             circuit.rzz(angles[j, k], j, k)
>>>
>>> class FlowSetSynthesis(EvolutionSynthesis):
...     '''Synthesize one flow set of the encoded Hamiltonian at a time.'''
...
...     preserve_order = True
...
...     def synthesize(self, evolution):
...         circuit = QuantumCircuit(evolution.operator.num_qubits)
...         east, west, diagonal = [], [], {}
...
...         for label, indices, coeff in evolution.operator.to_sparse_list():
...             angle = 2 * evolution.time * coeff.real
...             match label, indices:
...                 case "", _:  # the identity contributes only a global phase
...                     circuit.global_phase -= angle / 2
...                 case "X", [qubit]:  # east flow set: already weight-1
...                     east.append((qubit, angle))
...                 case "ZXZ", [j, k, l] if (k, l) == (j + 1, j + 2):
...                     west.append((k, angle))  # needs the CZ conjugation below
...                 case "ZZ", [j, k]:  # interaction: diagonal, see rzz_layers above
...                     diagonal[min(j, k), max(j, k)] = angle
...                 case _:
...                     raise ValueError(f"unexpected Pauli term: {label} on {indices}")
...
...         # east flow set: bare rotations, no entangling gates at all
...         for qubit, angle in east:
...             circuit.rx(angle, qubit)
...
...         # west flow set: one CZ chain diagonalizes the WHOLE set at once
...         if west:
...             cz_brickwork(circuit)
...             for qubit, angle in west:
...                 circuit.rx(angle, qubit)
...             cz_brickwork(circuit)
...
...         if diagonal:
...             rzz_layers(circuit, diagonal)
...
...         return circuit
Łatwo przeoczyć dwa szczegóły. Własna EvolutionSynthesis musi udostępniać atrybut preserve_order, który odczytuje przebieg syntezy wysokiego poziomu.
Obie funkcje pomocnicze emitują swoje bramki w jawnych warstwach, a nie w kolejności wyrazów, ponieważ depth() szereguje bramki możliwie najwcześniej, w kolejności ich dodania. Skoro wszystkie bramki w obrębie jednego z tych zbiorów komutują, kolejność można wybrać dowolnie. Synteza wyraz po wyrazie wybiera ją źle. Emitowanie nakładającego się łańcucha CZ sekwencyjnie daje głębokość rosnącą z liczbą kubitów zamiast stałej 2, którą mógłby osiągnąć sprzęt.
Dlatego powyższa synteza nie niesie liczby kroków Trottera. Otrzymuje jeden zbiór przepływu na bramkę, więc powtórzenie wewnątrz niej powtarzałoby w obrębie zbioru, zamiast przechodzić cyklicznie między zbiorami:
repeating within one set:      A(t/2) A(t/2) B(t/2) B(t/2)
what a Trotterization needs:   A(t/2) B(t/2) A(t/2) B(t/2)
Pierwsza postać nic nie daje: kolejne wykładnicze tego samego operatora komutują, więc A(t/2) A(t/2) to po prostu A(t), a błąd pozostaje na poziomie jednego kroku, niezależnie od liczby żądanych kroków.
Liczba kroków należy zatem do fermionowego FermionicLieTrotter z kroku 5, który odczytuje groups i potrafi je przeplatać. Na tym polega podział pracy: wzór fermionowy decyduje, ile kroków i w jakiej kolejności, a ta klasa decyduje, jak tanio realizowany jest każdy powstały zbiór.
Aby wybrać kolejność, przekaż ją do MapperFnEvolutionSynthesis.product_formula, czyli argumentu, który przyjmuje flow_set_pass_manager. Nic poza tym w potoku (ani w obwodzie fermionowym, na którym działa) się nie zmienia:
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, FlowSetSynthesis())
>>>
>>> flow_circuit = pass_manager.run(flow_set_circuit).decompose(reps=6)
>>> flow_circuit.count_ops()["cx"]
22
>>> flow_circuit.depth(lambda instruction: len(instruction.qubits) == 2)
12
>>> flow_circuit.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
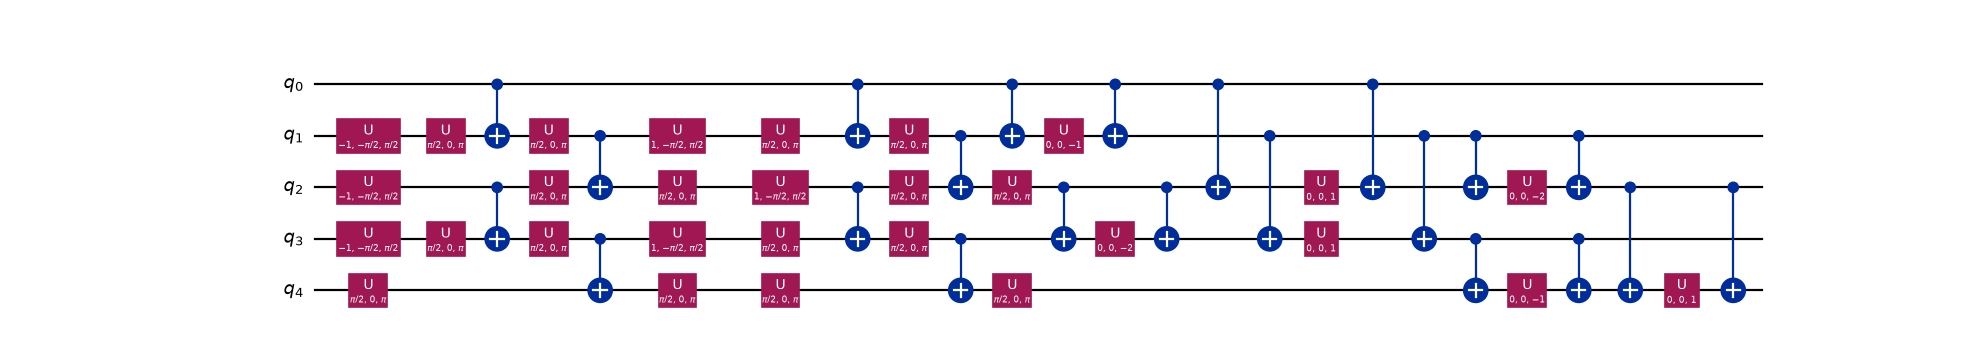
Z głębokości 23 przy 26 bramkach CX do głębokości 12 przy 22 bramkach CX. Zauważ, że to mniej bramek splątujących i niemal o połowę mniejsza głębokość. Porównując oba rysunki, różnica nie polega na tym, że bramki są tańsze, ale na tym, że się układają w stos. Seryjne drabinki zniknęły; bramki splątujące leżą teraz jedna nad drugą we wspólnych warstwach, ponieważ cały zachodni zbiór przepływu jest obracany w jednej wspólnej bazie, a oddziaływanie jest emitowane w warstwach rozłącznych par.
FlowSetSynthesis dopasowuje wzorce do bezwzględnych indeksów kubitów, co jest tu bezpieczne tylko dlatego, że każdy zbiór przepływu tego hamiltonianu obejmuje cały rejestr. Fermionowy wzór produktowy zawęża każdy czynnik do modów, których faktycznie dotyka, więc grupowanie, którego zbiory pokrywałyby tylko część łańcucha, dotarłoby ze zmienionymi etykietami i powyższe wzorce by nie pasowały.
Oba rysunki pokazują obwód po decompose(reps=6), który przepisuje wszystko do bazy U i CX, więc bramki CZ, Rx i Rzz emitowane przez FlowSetSynthesis nie są widoczne jako takie. Jest to celowe: umieszcza oba obwody w tej samej bazie, co jest jedynym sposobem, by powyższe liczby i głębokości dwukubitowe były porównywalne. Na tych rysunkach zwraca uwagę struktura warstw, a nie etykiety bramek.
8. Stała głębokość w dużej skali
Ciekawe jest nie to, ile jest bramek przy czterech modach, ale jak to skaluje się. Dwie warstwy CZ w układzie cegiełek nie rosną wraz z długością łańcucha, więc dwukubitowa głębokość jednego kroku Trottera powinna być stała. Pomiar bezpośrednio na pełnym hamiltonianie Fermiego-Hubbarda, znacznie poza zasięgiem symulacji siłowej:
>>> def evolution_stats(num_sites, product_formula):
...     operator = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
...     operator.groups = flow_set_groups(operator)
...
...     circuit = FermionicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, operator, time=total_time, synthesis=FermionicLieTrotter()
...         ),
...         circuit.modes,
...     )
...     circuit = circuit.decompose()  # one Evolution per flow set, as in step 5
...
...     pass_manager = flow_set_pass_manager(circuit.register, product_formula)
...     decomposed = pass_manager.run(circuit).decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     return decomposed.count_ops()["cx"], decomposed.depth(two_qubit)
>>>
>>> sites = [4, 10, 20, 50, 100]
>>> flow = [evolution_stats(n, FlowSetSynthesis()) for n in sites]
>>> lie_trotter = [evolution_stats(n, LieTrotter()) for n in sites]
>>>
>>> [depth for _, depth in flow]
[12, 12, 12, 12, 12]
>>> [depth for _, depth in lie_trotter]
[23, 47, 87, 207, 407]
Dwukubitowa głębokość pozostaje równa 12 od czterech modów do 100, podczas gdy LieTrotter rośnie liniowo do 407. Zbiory przepływu pozwalają trochę zrównoleglić w obrębie potoku, ale każdy zbiór jest nadal trotteryzowany wyraz po wyrazie, więc wzrost jest tylko spowolniony, a nie usunięty:
>>> import matplotlib.pyplot as plt
>>>
>>> figure, axes = plt.subplots(1, 2, figsize=(9, 3.5), layout="constrained")
>>> for panel, index, title in zip(axes, (1, 0), ("two-qubit depth", "CX count")):
...     _ = panel.plot(sites, [stat[index] for stat in lie_trotter], "o-", label="qubit-level")
...     _ = panel.plot(sites, [stat[index] for stat in flow], "s-", label="flow set")
...     _ = panel.set(xlabel="modes", title=title)
...     _ = panel.legend()
>>> figure
<Figure size ... with 2 Axes>

Liczba bramek rośnie liniowo w obu przypadkach (do zastosowania jest wyrazów i jest to nieuniknione), ale synteza zbiorów przepływu stosuje je w stałej liczbie równoległych warstw. To jest wynik stałej głębokości z pracy [1]. Odnośnik: [1].
Głębokość 12 rozkłada się na trzy zbiory przepływu jako 0 + 4 + 8, przy każdej długości łańcucha. Zbiór wschodni wnosi zero; to same rotacje Rx. Zbiór zachodni kosztuje 4, z dwóch warstw CZ w układzie cegiełek wchodzących i dwóch wychodzących; pominięcie oddziaływania zostawia dwukubitową głębokość cztery przy dowolnej długości łańcucha. Pozostałe osiem to oddziaływanie, którego wyrazy Rzz działają zarówno na najbliższych, jak i na następnych w kolejności sąsiadów, więc potrzebują czterech rozłącznych warstw, każda kosztująca dwie bramki CX. Cztery jest tu optymalne: każdy wewnętrzny kubit niesie cztery bramki Rzz (dwie do każdego sąsiada i dwie do każdego następnego w kolejności) i może brać udział tylko w jednej naraz, więc żaden harmonogram nie może być lepszy.
Dwie trzecie głębokości to oddziaływanie, co pokazuje, że to kodowanie wyróżnia się przy przeskokach, a więc przy dynamice łańcucha swobodnych fermionów. Zauważ jednak, że oddziaływanie nie komutuje z przeskokami. Pominięcie go nie jest przybliżeniem Fermiego-Hubbarda, lecz innym modelem. Warto zbadać, gdzie przypada równowaga dla danego problemu.
9. Sprawdź dynamikę
W odwzorowaniu ściany domenowej wzorzec obsadzeń staje się ciągiem skumulowanych parzystości, więc stan początkowy przygotowuje się inaczej niż w odwzorowaniu Jordana-Wignera. To łatwo przeoczana praktyczna konsekwencja delokalizacji parzystości. Funkcja pomocnicza z kroku 4 podaje właściwą etykietę:
>>> occupations = [1, 0, 1, 0]
>>> initial_label = "".join(str(b) for b in reversed(domain_wall_bits(occupations)))
>>> initial_label
'00110'
Po przygotowaniu stanu pozostają dwa pytania, które najlepiej zadawać osobno: czy synteza zbiorów przepływu oblicza właściwy wynik i czy oblicza go taniej?
Najpierw poprawność. FlowSetSynthesis i LieTrotter z Qiskit otrzymują te same zakodowane zbiory przepływu z tej samej fermionowej trotteryzacji, więc muszą realizować tę samą macierz unitarną z dokładnością do globalnej fazy. Własne operatory Cliffordowskie reorganizują pracę; nie zmieniają wyniku. Losowe wektory stanu wykrywają każdą rozbieżność znacznie taniej niż budowanie pełnej macierzy unitarnej:
>>> from qiskit.quantum_info import Statevector
>>>
>>> rng = np.random.default_rng(1234)
>>>
>>> def agrees_up_to_one_phase(reps, samples=3):
...     """Compare both qubit-side syntheses of the same fermionic Trotterization."""
...     step = trotter_steps(reps)
...     trotter = flow_set_pass_manager(step.register, LieTrotter()).run(step)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     trotter, flow = trotter.decompose(reps=6), flow.decompose(reps=6)
...     dimension = 2**trotter.num_qubits
...     residuals, phases = [], []
...     for _ in range(samples):
...         vector = rng.normal(size=dimension) + 1j * rng.normal(size=dimension)
...         state = Statevector(vector / np.linalg.norm(vector))
...         a = state.evolve(trotter).data
...         b = state.evolve(flow).data
...         overlap = np.vdot(a, b)
...         phases.append(overlap / abs(overlap))
...         residuals.append(np.linalg.norm(b - a * overlap / abs(overlap)))
...     # the SAME global phase must work for every input state
...     spread = max(abs(phase - phases[0]) for phase in phases)
...     return bool(max(residuals) < 1e-9), bool(spread < 1e-9)
>>>
>>> [agrees_up_to_one_phase(reps) for reps in (1, 3)]
[(True, True), (True, True)]
Obie połowy tego sprawdzenia mają znaczenie. Nakładanie o module jednostkowym dla pojedynczego stanu jest konieczne, ale niewystarczające: synteza, która źle ustaliła fazę zależną od stanu, nadal by je wykazała. Wymóg tej samej fazy dla kilku losowych stanów zamyka tę lukę. Sprawdzenie więcej niż jednej wartości reps również ma znaczenie, ponieważ potwierdza, że zgodność przetrwa przeplatanie zbiorów przepływu, a nie zachodzi tylko dla pojedynczego przebiegu.
Zatem wybór syntezy po stronie kubitów nie ma wpływu na dokładność, co czyni porównanie kosztów sensownym. Pozostaje pytanie, co kodowanie jako całość daje w porównaniu z oczywistą alternatywą: zwykłym kodowaniem Jordana-Wignera na num_sites kubitach, bez kubitu pomocniczego i bez własnych operatorów Cliffordowskich. W obu kolumnach różni się zarówno kodowanie, jak i synteza po stronie kubitów, ale powyższe sprawdzenie pokazało, że ta druga nie może wpływać na wynik, więc fidelity testuje kodowanie. Oba potoki startują też z tej samej fermionowej trotteryzacji, więc każda różnica w fidelity wskazywałaby na błąd, a nie na kompromis. Obie kolumny to kodowania, zbiory przepływu kontra Jordan-Wigner:
>>> def jordan_wigner_pass_manager(mode_register, product_formula):
...     """The same pipeline under plain Jordan-Wigner: one qubit per mode."""
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         transfer_vertex_jordan_wigner, product_formula=product_formula
...     )
...     qubit_register = QuantumRegister(mode_register.size, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from scipy.linalg import expm
>>>
>>> jw_state = np.zeros(2**num_sites, dtype=complex)
>>> jw_state[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> reference_jw = expm(-1j * total_time * jw_matrix) @ jw_state
>>> reference_flow = expm(-1j * total_time * flow_matrix) @ (isometry @ jw_state)
>>>
>>> def cost_and_fidelity(reps):
...     step = trotter_steps(reps)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     jw = jordan_wigner_pass_manager(step.register, LieTrotter()).run(step)
...     flow, jw = flow.decompose(reps=6), jw.decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     evolved_flow = Statevector.from_label(initial_label).evolve(flow).data
...     evolved_jw = Statevector(jw_state).evolve(jw).data
...     return (
...         abs(np.vdot(evolved_flow, reference_flow)) ** 2,
...         flow.count_ops()["cx"],
...         flow.depth(two_qubit),
...         abs(np.vdot(evolved_jw, reference_jw)) ** 2,
...         jw.count_ops()["cx"],
...         jw.depth(two_qubit),
...     )
>>>
>>> for reps in (1, 2, 4, 8):
...     flow_f, flow_cx, flow_d, jw_f, jw_cx, jw_d = cost_and_fidelity(reps)
...     print(
...         f"{reps} step(s):  flow set {flow_f:.6f}"
...         f" ({flow_cx:3d} CX, depth {flow_d:3d})"
...         f"   JW {jw_f:.6f} ({jw_cx:3d} CX, depth {jw_d:3d})"
...     )
1 step(s):  flow set 0.590661 ( 22 CX, depth  12)   JW 0.590661 ( 18 CX, depth  14)
2 step(s):  flow set 0.926656 ( 44 CX, depth  24)   JW 0.926656 ( 36 CX, depth  26)
4 step(s):  flow set 0.982053 ( 88 CX, depth  48)   JW 0.982053 ( 72 CX, depth  50)
8 step(s):  flow set 0.995395 (176 CX, depth  96)   JW 0.995395 (144 CX, depth  98)
Najpierw przeczytaj kolumnę fidelity: identyczna, co do każdej wypisanej cyfry, w dwóch różnych przestrzeniach Hilberta przy dwóch różnych kodowaniach. To właśnie fermionowa trotteryzacja przebija. Przybliżenie zostało ustalone w kroku 5, zanim wybrano któreś z kodowań, więc oba obwody niosą dokładnie błąd wzoru pierwszego rzędu nad trzema zbiorami przepływu, który maleje mniej więcej czterokrotnie przy podwojeniu liczby kroków.
Kodowania różnią się natomiast kosztem, a kompromis warto opisać wprost. Zbiór przepływu zużywa więcej bramek splątujących: 22 wobec 18 przy jednym kroku. Powodem nie jest kubit pomocniczy, bo nie niesie własnej bramki dwukubitowej. Powodem jest oddziaływanie, dokładnie tak, jak ostrzegał krok 3: delokalizacja parzystości zamienia trzy wyrazy ZZ między najbliższymi sąsiadami w siedem obejmujących najbliższych i następnych w kolejności sąsiadów, a każdy kosztuje dwie bramki CX. To cena za potanienie przeskoków.
Wygrywa też tylko nieznacznie pod względem głębokości przy tym rozmiarze (12 wobec 14), ponieważ cztery mody to za mało, by uwidoczniła się asymptotyka. Chodzi o skalowanie zmierzone w kroku 8: głębokość 12 jest stała, podczas gdy głębokość Jordana-Wignera rośnie z łańcuchem. Przy 14 modach jest to już 12 wobec 34.
Powyższe wywołania decompose() są niezbędne z dwóch niezależnych powodów.
evolve() i Operator używają dokładnej definicji PauliEvolutionGate, omijając własną syntezę po stronie kubitów. Weryfikacja na niezdekomponowanym obwodzie zgłasza doskonałe fidelity nawet dla celowo błędnej syntezy.
To samo dotyczy poziomu wyżej, syntezy fermionowej. Bramka Evolution, która nigdy nie jest dekomponowana, trafia w całości do etapu fermion-na-kubit, który odwzorowuje ją bez sięgania do Evolution.synthesis, więc reps po cichu nie miałoby żadnego efektu. trotter_steps z kroku 5 wykonuje tę dekompozycję; potok, który ustawia metodę przez F2FSynthesis, otrzymuje to samo rozwinięcie z samego przebiegu.
Jako ostatnie sprawdzenie krzyżowe, gęstości w miejscach obliczone w przestrzeni zakodowanej muszą odtwarzać wynik Jordana-Wignera. To sprawdzenie dotyczy kodowania, a nie obwodu, więc nie wchodzi w nie przybliżenie Trottera. Obie ewolucje czasowe są obliczane dokładnie, przez potęgowanie macierzy odpowiednich hamiltonianów. Każda rozbieżność wskazywałaby zatem na kodowanie, a nie na wzór produktowy:
>>> time = 0.8
>>> state_jw = np.zeros(2**num_sites, dtype=complex)
>>> state_jw[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> evolved_jw = expm(-1j * time * jw_matrix) @ state_jw
>>> evolved_flow = expm(-1j * time * flow_matrix) @ (isometry @ state_jw)
>>>
>>> for j in range(num_sites):
...     v_flow = to_matrix(
...         SparseObservable.from_sparse_list([("ZZ", [j, j + 1], 1.0)], num_qubits)
...     )
...     v_jw = to_matrix(SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_sites))
...     density_flow = (1 - np.vdot(evolved_flow, v_flow @ evolved_flow).real) / 2
...     density_jw = (1 - np.vdot(evolved_jw, v_jw @ evolved_jw).real) / 2
...     print(f"site {j}:  {density_flow:.10f}  {density_jw:.10f}")
site 0:  0.6507935456  0.6507935456
site 1:  0.5963201678  0.5963201678
site 2:  0.3365016619  0.3365016619
site 3:  0.4163846247  0.4163846247
Gęstości zgadzają się do dziesięciu miejsc po przecinku.
Co warto zapamiętać
-
Grupuj przed odwzorowaniem. Zbiory przepływu są definiowane na skierowanym fermionowym grafie oddziaływań, więc grupowanie wybiera się, gdy struktura problemu jest jeszcze dostępna. Atrybut
groupsprzenosi je do obwodu, gdzie pojedynczedecompose()zamienia je na jedną bramkęEvolutionna zbiór przepływu. -
Kubity pomocnicze kupują strukturę. Poświęcenie jednego dodatkowego kubitu zamienia cały zbiór przepływu w operatory Pauliego o wadze 1, których ewolucja nie potrzebuje bramek splątujących. Praca [1] obserwuje ten kompromis ogólnie. Odnośnik: [1]. Większe stosunki liczby kubitów do fermionów dopuszczają płytsze obwody ewolucji.
-
Własne kodowanie to jedna funkcja. Odwzoruj pojedynczy uogólniony operator transferu na ciąg Pauliego; resztę robią
map_transfer_vertex_generators()iMapperFnEvolutionSynthesis. -
Samo odwzorowanie i grupowanie nie wystarczą. Podział ewolucji na zbiory przepływu tylko spowolnił liniowy wzrost głębokości; synteza każdego zbioru wyraz po wyrazie nadal marnowała fakt, że jego wyrazy komutują. Dopiero dostarczenie
EvolutionSynthesisuwzględniającej zbiory przepływu uczyniło głębokość stałą. Własne kodowania, grupowanie i własna synteza uzupełniają się: potrzebne są wszystkie trzy. -
Dwa wzory produktowe, dwa zadania.
FermionicLieTrotterustala przybliżenie w przestrzeni fermionowej, gdzie grupowanie jest nadal widoczne, więc to on sam określa błąd Trottera i liczbę kroków.EvolutionSynthesispo stronie kubitów decyduje już tylko, jak tanio realizowany jest każdy zbiór: krok 9 potwierdza, że oba wybory dają tę samą macierz unitarną. Oddzielenie ich pozwala niezależnie dostrajać dokładność i koszt. Zobacz Synteza bramki Evolution w przestrzeni fermionowej. -
Zweryfikuj to. Kodowanie spełniające relacje komutacji może nadal reprezentować inny hamiltonian, jeśli współczynnik lub znak jest błędny. Sprawdzenie relacji splatania (lub, taniej, widma) to wychwytuje.
Powyższe FlowSetSynthesis jest celowo napisane dla tego kodowania na łańcuchu 1D. Dopasowuje wzorce do konkretnych etykiet Pauliego, które to kodowanie wytwarza, i zgłasza błąd przy wszystkim innym, zamiast po cichu wracać do ogólnego wzoru produktowego. Ogólna implementacja ma dwie połowy. Odczytanie struktury zbiorów przepływu z groups operatora jest tym, co robi już F2FSynthesisPlugin dla ewolucji. Wyprowadzenie diagonalizującego operatora Cliffordowskiego z grupy stabilizatorów, jak opisano w sekcji IV C pracy [1], jest tą połową, która pozostaje specyficzna dla kodowania. Odnośnik: [1].
Ponadto delokalizacja parzystości sprawia, że wyraz oddziaływania ma wagę 2, zamiast być diagonalny na pojedynczych kubitach, co jest kosztem odpowiadającym tańszym wyrazom przeskoków.
Dalej: dwa wymiary
Wszystko powyżej jest jednowymiarowe, i to celowo. Na łańcuchu zbiory przepływu to po prostu dwie orientacje strzałek, a kodowanie potrzebuje jednego kubitu pomocniczego. Żadne z tych uproszczeń nie przetrwa w dwóch wymiarach, a właśnie tam potrzebne są kodowania lokalne.
Na planarnej sieci zbiór przepływu to skierowana ścieżka (lub suma rozłącznych wierzchołkowo skierowanych ścieżek) przez graf oddziaływań, a znalezienie małego zbioru takich ścieżek pokrywającego każdą krawędź staje się samodzielnym problemem kombinatorycznym, a nie dwuwierszową klasyfikacją. Zmienia się też charakter kodowań; zamiast jednego kubitu pomocniczego dla całego łańcucha dodają po jednym na węzeł lub komórkę sieci. Verstraete-Cirac łączy każdy fermionowy węzeł z własnym kubitem pomocniczym, co daje stosunek kubitów do modów równy , podczas gdy Derby-Klassen umieszcza jeden pośrodku każdej nieparzystej płytki, co daje stosunek . Układ rejestru ma wtedy prawdziwie dwuwymiarową strukturę, a grupa stabilizatorów, na którą trzeba rzutować, nie jest już trywialna. Zakodowany hamiltonian jest wierny tylko na podprzestrzeni, co zmienia zarówno przygotowanie stanu, jak i przepis weryfikacji z kroku 4.
Elementy zbudowane w tym przewodniku to te, które się przenoszą: CustomF2QLayout dla rejestru, którego rozmiar różni się od liczby modów, map_transfer_vertex_generators() dla samego kodowania, MapperFnEvolutionSynthesis do podłączenia go do transpilera oraz własna EvolutionSynthesis, by struktura zbiorów przepływu się opłaciła. Różni się tylko kodowanie i dekompozycja na zbiory przepływu.
Przewodnik po zbiorach przepływu 2D podejmuje wątek tutaj, omawiając kodowanie Verstraete-Cirac na sieci kwadratowej: cztery zbiory przepływu, operator Cliffordowski o głębokości 2 dla każdego z nich oraz rzutowanie na stabilizatory, którego wymaga następnie weryfikacja.
A. Gandon, S. Piccinelli, M. Rossmannek, F. Tacchino, A. Baiardi, J. Nys, and I. Tavernelli, Stabilizer-based quantum simulation of fermion dynamics with local qubit encodings (2026), arXiv:2512.11418v2.