Ograniczanie wymiaru podprzestrzeni
W tym przewodniku pokażemy wpływ wymiaru podprzestrzeni na technikę samouzgodnionego odzyskiwania konfiguracji.
A priori nie wiemy, jaki wymiar podprzestrzeni jest właściwy, aby uzyskać docelowy poziom dokładności. Wiemy jednak, że zwiększanie wymiaru podprzestrzeni zwiększa dokładność metody. Możemy więc zbadać dokładność przewidywań w funkcji wymiaru podprzestrzeni. Określ cząsteczkę i jej właściwości.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pyscf": "pyscf", "qiskit_addon_sqd": "qiskit-addon-sqd"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import warnings

import pyscf
import pyscf.cc
import pyscf.mcscf

warnings.filterwarnings("ignore")

# Specify molecule properties
open_shell = False
spin_sq = 0

# Build N2 molecule
mol = pyscf.gto.Mole()
mol.build(
    atom=[["N", (0, 0, 0)], ["N", (1.0, 0, 0)]],
    basis="6-31g",
    symmetry="Dooh",
)

# Define active space
n_frozen = 2
active_space = range(n_frozen, mol.nao_nr())

# Get molecular integrals
scf = pyscf.scf.RHF(mol).run()
num_orbitals = len(active_space)
n_electrons = int(sum(scf.mo_occ[active_space]))
num_elec_a = (n_electrons + mol.spin) // 2
num_elec_b = (n_electrons - mol.spin) // 2
cas = pyscf.mcscf.CASCI(scf, num_orbitals, (num_elec_a, num_elec_b))
mo = cas.sort_mo(active_space, base=0)
hcore, nuclear_repulsion_energy = cas.get_h1cas(mo)
eri = pyscf.ao2mo.restore(1, cas.get_h2cas(mo), num_orbitals)

# Compute exact energy
exact_energy = cas.run().e_tot
converged SCF energy = -108.835236570775
CASCI E = -109.046671778080  E(CI) = -32.8155692383188  S^2 = 0.0000000
Wygeneruj losowe ciągi bitów, które posłużą jako zastępcze próbki z QPU.
import numpy as np
from qiskit_addon_sqd.counts import generate_bit_array_uniform

# Create a seed to control randomness throughout this workflow
rng = np.random.default_rng(24)

# Generate random samples
bit_array = generate_bit_array_uniform(
    10_000, num_orbitals * 2, rand_seed=rng
)
Wywołaj SQD z rosnącymi rozmiarami partii.
from qiskit_addon_sqd.fermion import diagonalize_fermionic_hamiltonian

list_samples_per_batch = [50, 200, 400, 600]

# SQD options
max_iterations = 5

# Eigenstate solver options
num_batches = 10
max_davidson_cycles = 200

energies = []
subspace_dimensions = []

for samples_per_batch in list_samples_per_batch:
    result = diagonalize_fermionic_hamiltonian(
        hcore,
        eri,
        bit_array,
        samples_per_batch=samples_per_batch,
        norb=num_orbitals,
        nelec=(num_elec_a, num_elec_b),
        num_batches=num_batches,
        max_iterations=max_iterations,
        symmetrize_spin=True,
        seed=rng,
    )
    energies.append(result.energy)
    subspace_dimensions.append(np.prod(result.sci_state.amplitudes.shape))
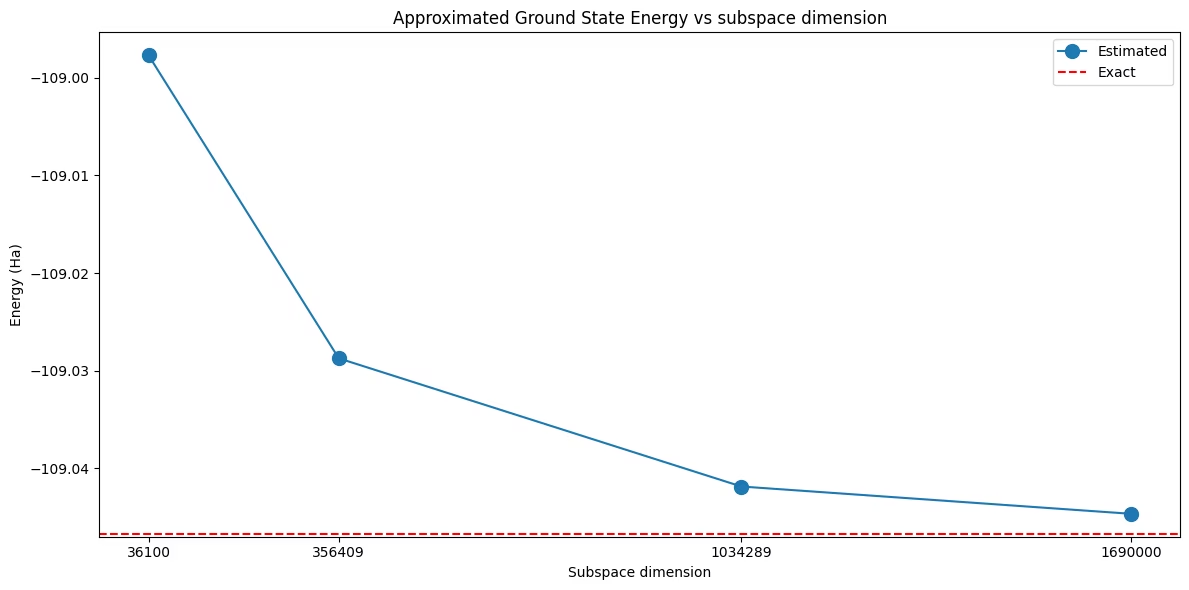
Ten wykres pokazuje, że zwiększanie wymiaru podprzestrzeni prowadzi do dokładniejszych wyników.
import matplotlib.pyplot as plt

# Data for energies plot
x1 = subspace_dimensions
y1 = np.array(energies) + nuclear_repulsion_energy

fig, axs = plt.subplots(1, 1, figsize=(12, 6))

# Plot energies
axs.plot(x1, y1, marker=".", markersize=20, label="Estimated")
axs.set_xticks(x1)
axs.set_xticklabels(x1)
axs.axhline(y=exact_energy, color="red", linestyle="--", label="Exact")
axs.set_title("Approximated Ground State Energy vs subspace dimension")
axs.set_xlabel("Subspace dimension")
axs.set_ylabel("Energy (Ha)")
axs.legend()

plt.tight_layout()
plt.show()
Ustawianie jawnego ograniczenia za pomocą max_dim
W powyższym przeglądzie wymiar podprzestrzeni był kontrolowany tylko pośrednio. samples_per_batch określa, ile ciągów bitów trafia do każdej partii, ale wymiar powstałej podprzestrzeni zależy od tego, ile różnych ciągów spinu alfa i spinu beta zawierają te ciągi bitów, a pula konfiguracji dostępnych do podpróbkowania rośnie z jednej iteracji odzyskiwania konfiguracji do następnej. Dlatego wymiary podprzestrzeni na osi poziomej powyżej są nieregularnymi liczbami, których nie wybieraliśmy.
Argument max_dim funkcji diagonalize_fermionic_hamiltonian ogranicza wymiar bezpośrednio. Ogranicza liczbę ciągów CI zachowywanych w każdym sektorze spinowym, a ponieważ podprzestrzeń jest rozpinana przez iloczyn kartezjański obu sektorów, jej wymiar jest iloczynem wymiarów obu sektorów:
-
max_dim=dogranicza oba sektory dodciągów, więc wymiar podprzestrzeni wynosi co najwyżejd ** 2. -
max_dim=(d_a, d_b)ogranicza sektory spinu alfa i spinu beta osobno, więc wymiar podprzestrzeni wynosi co najwyżejd_a * d_b. Gdysymmetrize_spin=True, oba ograniczenia muszą być równe. -
max_dim=None, czyli wartość domyślna, nie nakłada żadnego ograniczenia.
Gdy partia zawiera więcej ciągów, niż pozwala limit, najmniej istotne są odrzucane: najpierw zachowywane są ciągi przekazane przez include_configurations, następnie ciągi przeniesione z poprzedniej iteracji (zobacz carryover_threshold), a pozostałe miejsca są wypełniane próbkowanymi ciągami w kolejności malejącej częstości ich próbkowania.
Ponieważ max_dim ogranicza rozmiar największej diagonalizacji, jaką solwer wartości własnych będzie musiał wykonać, jest to wygodny sposób, by utrzymać solwer w budżecie czasu wykonania i pamięci: wybierz hojną wartość samples_per_batch i pozwól, by max_dim zdecydował, jak duża może urosnąć podprzestrzeń.
Poniżej powtarzamy badanie, tym razem utrzymując stałe samples_per_batch i zwiększając max_dim.
list_max_dim = [100, 200, 400, 800]

# Use a generous number of samples per batch, so that max_dim is what limits
# the dimension of the subspace
samples_per_batch = 600

energies_max_dim = []
subspace_dimensions_max_dim = []

for max_dim in list_max_dim:
    result = diagonalize_fermionic_hamiltonian(
        hcore,
        eri,
        bit_array,
        samples_per_batch=samples_per_batch,
        norb=num_orbitals,
        nelec=(num_elec_a, num_elec_b),
        num_batches=num_batches,
        max_iterations=max_iterations,
        symmetrize_spin=True,
        max_dim=max_dim,
        seed=rng,
    )
    energies_max_dim.append(result.energy)
    subspace_dimensions_max_dim.append(
        int(np.prod(result.sci_state.amplitudes.shape))
    )

print(f"max_dim:            {list_max_dim}")
print(f"subspace dimension: {subspace_dimensions_max_dim}")
max_dim:            [100, 200, 400, 800]
subspace dimension: [10000, 40000, 160000, 640000]
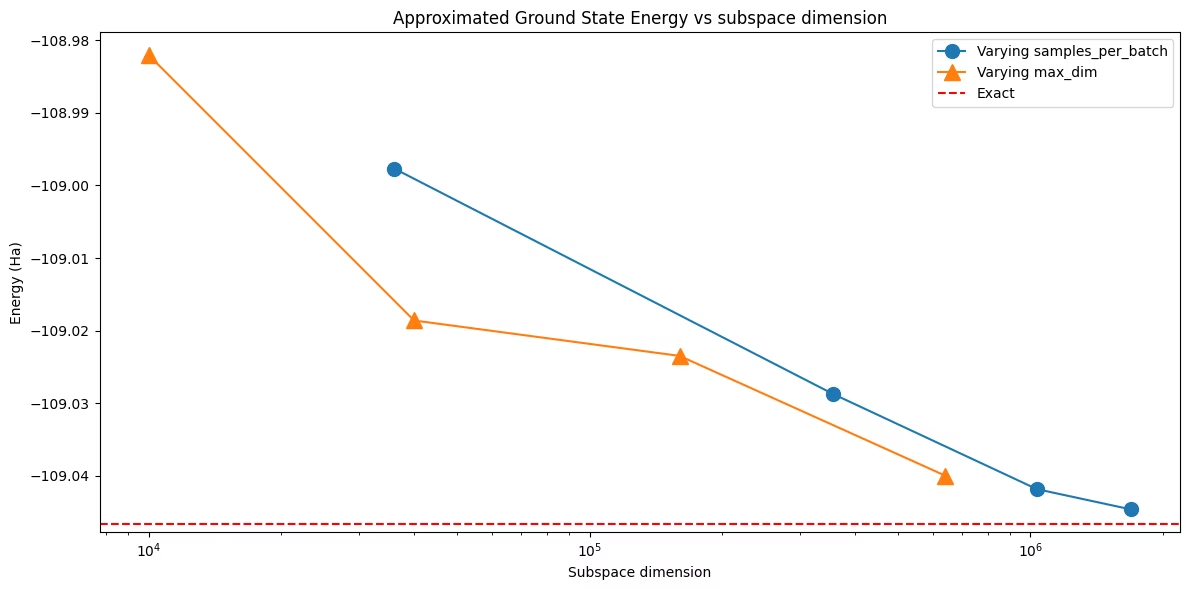
Wymiar podprzestrzeni wynosi teraz w każdym uruchomieniu dokładnie max_dim ** 2: został wybrany, a nie wykryty. Wykreślenie obu przeglądów razem pokazuje, że dokładność zależy od samego wymiaru podprzestrzeni, niezależnie od tego, którym argumentem go uzyskano. Obie krzywe nie muszą jednak dokładnie się pokrywać. Uruchomienia z max_dim pobierają 600 ciągów bitów na partię, a następnie zachowują najczęściej próbkowane ciągi, więc przy danym wymiarze mogą zachować lepszy zestaw konfiguracji niż uruchomienie, które osiągnęło ten wymiar, próbkując od początku mniej ciągów bitów.
fig, axs = plt.subplots(1, 1, figsize=(12, 6))

axs.plot(
    subspace_dimensions,
    np.array(energies) + nuclear_repulsion_energy,
    marker=".",
    markersize=20,
    label="Varying samples_per_batch",
)
axs.plot(
    subspace_dimensions_max_dim,
    np.array(energies_max_dim) + nuclear_repulsion_energy,
    marker="^",
    markersize=12,
    label="Varying max_dim",
)
axs.axhline(y=exact_energy, color="red", linestyle="--", label="Exact")
axs.set_xscale("log")
axs.ticklabel_format(axis="y", useOffset=False)
axs.set_title("Approximated Ground State Energy vs subspace dimension")
axs.set_xlabel("Subspace dimension")
axs.set_ylabel("Energy (Ha)")
axs.legend()

plt.tight_layout()
plt.show()