Symulacja dynamiki Bosego-Hubbarda z wyborem kodowania
Ten przewodnik buduje obwód dla dynamiki czasowej jednowymiarowego modelu Bosego-Hubbarda, od zapisania hamiltonianu po sprawdzenie wyewoluowanych gęstości węzłów względem dokładnego odniesienia. Ciekawa jest tu jedna idea:
Nie wybieraj kodowania bozonów na kubity podczas budowania obwodu. Zbuduj obwód na modach bozonowych i pozwól transpilatorowi zdecydować, jak te mody staną się kubitami.
W przypadku bozonów kodowanie niemal zawsze trzeba odroczyć. Mod bozonowy może zawierać dowolnie wiele cząstek, więc jego przestrzeń Focka jest nieskończenie wymiarowa i żadne kodowanie nie istnieje, dopóki nie wybierzesz najpierw obcięcia (liczby zachowywanych poziomów obsadzenia). W kodzie obcięcie podaje się jako największe obsadzenie, jakie może mieć mod, max_occupation , więc mod zachowujący poziomy ma max_occupation = 2 i .
Czyni to obcięcie parametrem kodowania, a nie fizyki, i jest to parametr, który chcesz zmieniać: zbyt małe daje błędny wynik, zbyt duże sprawia, że obwód jest niepotrzebnie szeroki. Jeśli odroczysz kodowanie do czasu transpilacji, możesz przeglądać różne obcięcia bez zmiany obwodu, hamiltonianu ani grupowania.
Przewodnik po operatorach opisuje strukturę danych operatora, przewodnik po maperach opisuje kodowania i przepis na napisanie własnego mapera, a przewodnik po transpilacji opisuje etapy transpilatora, do których odwołujemy się w całym tekście.
Obcięcie i jego koszt
Gdy obcinasz mod do poziomów, łamiesz kanoniczny komutator na najwyższym zachowanym poziomie [1], więc żadne kodowanie nie jest izomorfizmem algebr: kodowanie bozonowe odwzorowuje stany oraz operatory działające w obciętej podprzestrzeni. Dwie konsekwencje mają znaczenie dla wszystkiego, co następuje:
-
musi ograniczać obsadzenie osiągalne w dynamice, a nie tylko obsadzenie stanu początkowego.
-
Odwzorowanie nie komutuje z uporządkowaniem normalnym, więc zdecyduj raz, czy twój hamiltonian jest zdefiniowany w postaci uporządkowanej normalnie, i zachowaj spójność.
Przewodnik po maperach wyprowadza defekt i pokazuje obie konsekwencje na działającym kodzie.
1. Hamiltonian
Model Bosego-Hubbarda na sieci z wiązaniami ma postać
gdzie . Oddziaływanie zlicza pary bozonów w węźle, więc wymaga, aby węzeł mógł zawierać dwie cząstki naraz. W postaci uporządkowanej normalnie , i tej postaci używamy dalej.
Geometria wchodzi tylko przez listę krawędzi, więc nic nie jest specyficzne dla łańcucha:
>>> from qiskit_bosons.operators import BosonOperator, ann, cre
>>>
>>> def bose_hubbard(edges, num_sites, tunneling, interaction):
...     """Build the normal-ordered Bose-Hubbard Hamiltonian on an arbitrary lattice."""
...     terms = {}
...     for i, j in edges:
...         terms[(cre(i), ann(j))] = -tunneling
...         terms[(cre(j), ann(i))] = -tunneling
...     for i in range(num_sites):
...         # U/2 * n_i (n_i - 1), already normal-ordered
...         terms[(cre(i), cre(i), ann(i), ann(i))] = 0.5 * interaction
...     return BosonOperator.from_dict(terms)
>>>
>>> num_sites = 4
>>> edges = [(i, i + 1) for i in range(num_sites - 1)]
>>> hamiltonian = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> print(f"Number of terms: {len(hamiltonian)}")
Number of terms: 10
Warto najpierw sprawdzić dwie własności. Hamiltonian musi być hermitowski, aby było unitarne, i zachowuje całkowitą liczbę bozonów:
>>> hamiltonian.is_hermitian()
True
>>> hamiltonian.conserves_particle_number()
True
Teraz pytanie bozonowe: ile poziomów wymaga ten operator?
>>> hamiltonian.max_occupation()
2
Człon oddziaływania stosuje dwa operatory kreacji do jednego modu, więc mod musi pomieścić dwa bozony, aby człon w ogóle zadziałał. To maksymalne obsadzenie równe 2, czyli liczba, którą LevelSpec przyjmuje jako max_occupation. Mod zachowujący obsadzenia ma poziomy, więc max_occupation >= 2 to to samo wymaganie co .
To tylko dolne ograniczenie: wynika z jednokrotnego zastosowania operatora, a wielokrotne zastosowanie w trakcie ewolucji czasowej może sięgać dalej. Wyklucza odcięcia, które są na pewno za małe, a krok 6 rozstrzyga, jak duże musi być odcięcie dla tego modelu i stanu. mode_occupations() podaje to ograniczenie osobno dla każdego modu, z czym porównuje się odcięcie dla pojedynczego modu.
2. Grupowanie przed odwzorowaniem
Ewolucja jest trotteryzowana, a sposób podziału hamiltonianu decyduje o tym, co otrzymuje synteza. Dwa względy działają w tym samym kierunku.
Po pierwsze, fizyczny: pojedynczy człon przeskoku nie jest hermitowski. Hermitowska jest dopiero para . Jeśli ewoluujesz pod wpływem pojedynczego członu niehermitowskiego, operacja nie jest unitarna, a odwzorowany operator miałby zespolone współczynniki, które PauliEvolutionGate odrzuca. Dlatego dwa człony przeskoku każdego wiązania muszą pozostać razem.
Po drugie, wydajnościowy: wszystkie człony oddziaływania na węźle są diagonalne w bazie obsadzeń i wzajemnie komutują, więc mogą tworzyć jedną grupę i być syntezowane razem. To samo dotyczy wiązań, które nie mają wspólnego węzła. W łańcuchu takim zbiorem jest co drugie wiązanie: wiązania 0 i 2 działają na rozłączne pary modów, więc ich człony przeskoku komutują i mogą dzielić grupę, a wiązanie 1 tworzy własną grupę. Jeśli grupujesz wiązania parzyste i nieparzyste, potrzebujesz więc trzech grup, podczas gdy jedna grupa na wiązanie wymaga czterech. Mniej grup oznacza mniej czynników, a także płytszy obwód: z kodem Graya przy max_occupation = 2 głębokość dwukubitowa wynosi 95 wobec 139. To sieć decyduje, które wiązania mogą dzielić grupę, dlatego podział wybiera się właśnie tutaj.
Atrybut groups przenosi tę decyzję do obwodu: bramka Evolution nad zgrupowanym operatorem rozkłada się na jedną podewolucję na grupę. Podział jest wybierany na poziomie bozonowym, gdy struktura sieci jest jeszcze widoczna, i przetrwa nietknięty przez odwzorowanie. Przewodnik po grupowaniu opisuje kontrole, które powinno przechodzić grupowanie.
>>> def group_of(actions, edges):
...     """Assign each term to the even bonds, the odd bonds, or the on-site group."""
...     creations = sorted(mode for action, mode in actions if action)
...     annihilations = sorted(mode for action, mode in actions if not action)
...     if creations == annihilations:
...         return 2  # diagonal: the on-site interaction group
...     bond = tuple(sorted(set(creations) | set(annihilations)))
...     return edges.index(bond) % 2  # bonds 0 and 2 share a group, bond 1 has its own
>>>
>>> hamiltonian.groups = [group_of(actions, edges) for actions, _ in hamiltonian.iter_terms()]
>>> hamiltonian.num_groups()
3
Każda grupa musi sama być hermitowska, co zapewnia poprzednie łączenie w pary. groups_are_hermitian() sprawdza wszystkie grupy jednym wywołaniem:
>>> from qiskit_bosons.operators.terms import groups_are_hermitian
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
Aby zobaczyć, co zawiera każda grupa, rozdziel grupy:
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(f"group {index}: {len(group)} terms, hermitian={group.is_hermitian()}")
group 0: 4 terms, hermitian=True
group 1: 2 terms, hermitian=True
group 2: 4 terms, hermitian=True
Grupowanie na parzyste i nieparzyste jest wyborem, a alternatywę łatwo zmierzyć. Jeśli dasz każdemu wiązaniu własną grupę, potrzebujesz czterech grup, a ten sam obwód ma wtedy większą głębokość dwukubitową. Głębokość liczy się po sprowadzeniu obwodu do bramek kodem Graya przy max_occupation = 2, co wyjaśnia krok 4:
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution
>>> from qiskit_bosons.mappers import LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> def two_qubit_depth(operator):
...     """The two-qubit depth of one evolution under ``operator``, lowered with the Gray code."""
...     probe = BosonicCircuit(num_sites)
...     probe.append(Evolution(num_sites, operator, time=0.4), probe.modes)
...     pass_manager = generate_preset_occupation_pass_manager(LevelSpec(2, "gray"))
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(probe.decompose())
...     return lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
>>>
>>> per_bond = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> per_bond.groups = [
...     len(edges) if sorted(m for a, m in actions if a) == sorted(m for a, m in actions if not a)
...     else edges.index(tuple(sorted({m for _, m in actions})))
...     for actions, _ in per_bond.iter_terms()
... ]
>>> per_bond.num_groups(), two_qubit_depth(per_bond)
(4, 139)
>>> hamiltonian.num_groups(), two_qubit_depth(hamiltonian)
(3, 95)
3. Obwód bozonowy
Zwróć uwagę, czego w obwodzie brakuje. Nie ma obcięcia, kodowania ani liczby kubitów. Działa on na czterech modach bozonowych:
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution, InitializeModes
>>>
>>> total_time = 0.4
>>> occupation = [1, 1, 0, 0]  # one boson on each of the first two sites
>>>
>>> circuit = BosonicCircuit(num_sites)
>>> circuit.append(InitializeModes(occupation), circuit.modes)
>>> circuit.append(Evolution(num_sites, hamiltonian, time=total_time), circuit.modes)
>>> dict(circuit.count_ops())
{'InitializeModes': 1, 'Evolution': 1}

Przewody to mody bozonowe, a nie kubity. Zauważ, że InitializeModes przyjmuje liczby całkowite, a nie flagi: mod może zawierać dowolną liczbę bozonów, więc stan Focka to lista liczb obsadzeń.
Pojedyncze wywołanie decompose() zamienia grupowanie z kroku 2 na jedną bramkę na grupę:
>>> decomposed = circuit.decompose()
>>> dict(decomposed.count_ops())
{'Evolution': 3, 'InitializeModes': 1}
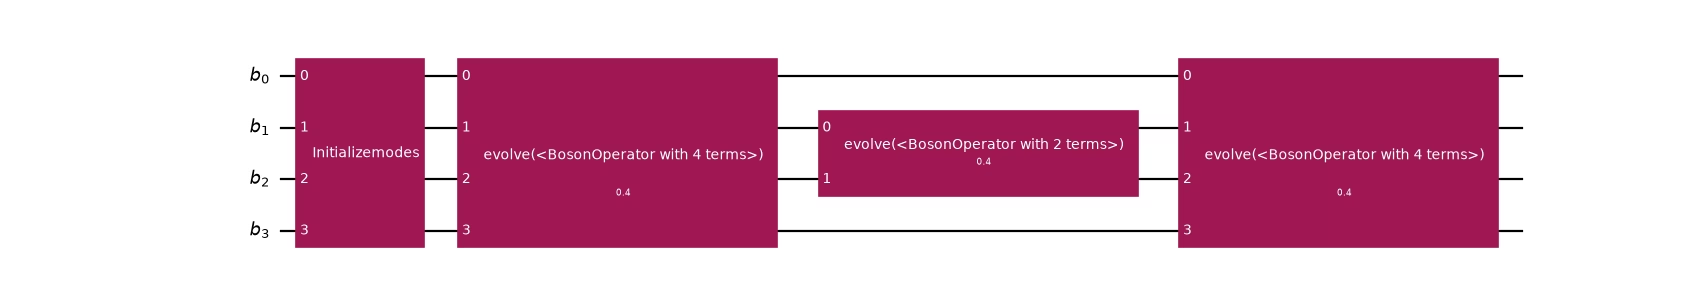
Pierwsza grupa zawiera wiązania na modach 0 i 1 oraz na modach 2 i 3, więc jej bramka obejmuje wszystkie cztery mody, podobnie jak grupa oddziaływań na węźle. Środkowe wiązanie ma własną bramkę na modach 1 i 2.
Jeśli pominiesz ten rozkład, grupowanie zostanie po prostu zignorowane. To, która metoda dokonuje podziału, wynika z synthesis bramki, z domyślnym BosonicLieTrotter; alternatywy pokazuje Synteza bramki Evolution w przestrzeni bozonowej.
4. Wybór kodowania w czasie transpilacji
Oto korzyść. Ten sam obwód jest sprowadzany cztery razy, przy czterech różnych wartościach LevelEncoding, przez zmianę jednego argumentu. LevelSpec łączy kodowanie z obcięciem każdego modu, a poniższy preset wyprowadza z tej jednej specyfikacji układ, przygotowanie stanu i odwzorowanie operatora (zobacz Opis obcięcia za pomocą LevelSpec). Ciąg taki jak "gray" jest akceptowany wszędzie tam, gdzie oczekiwane jest LevelEncoding.
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.mappers import LevelEncoding, LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> max_occupation = 2  # the largest occupation per mode, so d = max_occupation + 1 = 3 levels
>>>
>>> encodings = (
...     LevelEncoding.UNARY_PROJECTED,
...     LevelEncoding.UNARY_UNPROJECTED,
...     LevelEncoding.STANDARD_BINARY,
...     LevelEncoding.GRAY,
... )
>>> for encoding in encodings:
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     pass_manager.qubit = PassManager()  # keep the circuit as the pipeline synthesized it
...     qubit_circuit = pass_manager.run(decomposed)
...     basis = qubit_circuit.decompose(reps=6)
...     two_qubit = basis.depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"{encoding!s:18s} qubits={qubit_circuit.num_qubits:2d}  2q-depth={two_qubit:4d}")
unary_projected    qubits=12  2q-depth= 645
unary_unprojected  qubits=12  2q-depth= 383
standard_binary    qubits= 8  2q-depth= 218
gray               qubits= 8  2q-depth=  95
Te liczby przeczą naturalnemu przypuszczeniu. Kodowania unarne używają kubitów na mod wobec dla kodów zwartych, a przy kody zwarte wygrywają jednocześnie pod obydwoma względami: mniej kubitów i znacznie mniej bramek splątujących. Dwa warianty unarne różnią się emitowanym operatorem, a nie układem: LevelEncoding.UNARY_PROJECTED niesie rzutnik na co drugim kubicie modu, co czyni go najdroższym z czterech w ewolucji, a LevelEncoding.UNARY_UNPROJECTED pomija rzutniki i zgadza się z nim na podprzestrzeni one-hot. Przewodnik po maperach pokazuje oba operatory obok siebie i wyjaśnia, dlaczego kod Graya wygrywa ze standardowym binarnym (SB) na członach przeskoku.
Sawaya i in. podają to samo uporządkowanie [2]:
chociaż kod unarny wymaga zwykle więcej kubitów, ale mniej operacji, często zdarza się, że kod SB lub Graya jest wydajniejszy zarówno pod względem liczby kubitów, jak i liczby operacji
Ich wniosek jest taki, że najlepszy kod zależy od hamiltonianu i od , co jest najmocniejszym argumentem za tym, by nie ustalać wyboru w obwodzie.
Przy kodowaniu poziomów mod obejmuje kilka kubitów, więc rejestr kubitów jest szerszy niż rejestr modów. Preset używa OccupationB2QLayout, który wyprowadza szerokość rejestru z LevelSpec. Przewodnik po transpilacji omawia etapy, które uruchamia preset.
5. Weryfikacja względem dokładnej dynamiki
Żaden z poprzednich kroków nie dowodzi, że obwód jest poprawny. Aby to sprawdzić, porównaj gęstości węzłów po ewolucji z dokładnym odniesieniem obliczonym na zakodowanym hamiltonianie.
Odniesienie trzeba obliczyć w tej samej obciętej przestrzeni, w której działa obwód, ponieważ porównanie z obliczeniem bez obcięcia pomieszałoby błąd Trottera z błędem obcięcia, które są różnymi rzeczami i warto je rozdzielać (zobacz Obcinanie przestrzeni Focka).
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp, Statevector
>>> from scipy.sparse.linalg import expm_multiply
>>> from qiskit_bosons.mappers.library import occupation_encoding
>>>
>>> def sparse_matrix(operator, encoding):
...     """Map a bosonic operator and hand back a sparse qubit matrix."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     observable = occupation_encoding(operator, spec)
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
>>>
>>> def fock_index(occupation, encoding):
...     """The computational basis index encoding a product Fock state."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     return sum(
...         encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets)
...     )
>>>
>>> def densities(state, encoding):
...     """The per-site boson number <n_m> of an encoded state vector."""
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         matrix = sparse_matrix(number, encoding)
...         out.append(float((state.conj() @ (matrix @ state)).real))
...     return out
Mając to, wykonujemy dokładną ewolucję w obciętej przestrzeni:
>>> encoding = LevelEncoding.GRAY
>>> num_qubits = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
>>>
>>> initial = np.zeros(2**num_qubits, dtype=complex)
>>> initial[fock_index(occupation, encoding)] = 1.0
>>>
>>> evolved_exact = expm_multiply(
...     -1j * total_time * sparse_matrix(hamiltonian, encoding), initial
... )
>>> reference = densities(evolved_exact, encoding)
>>> for site, value in enumerate(reference):
...     print(f"site {site}: {value:.6f}")
site 0: 0.993834
site 1: 0.858853
site 2: 0.141309
site 3: 0.006004
Bozony rozchodzą się od zajętego końca łańcucha ku pustemu, a dwa bozony są zachowane:
>>> bool(np.isclose(sum(reference), 2.0))
True
Teraz obwód. Zauważ, że poprzednie odniesienie zbudowano bezpośrednio z initial, więc obwód porównywany z nim musi zawierać tylko ewolucję, ponieważ bramka InitializeModes ponownie przygotowałaby stan, który jest już przygotowany.
>>> from qiskit_bosons.circuit.library.synthesis import BosonicLieTrotter
>>>
>>> def trotter_densities(steps, encoding):
...     """Site densities after `steps` first-order Trotter steps of the grouped evolution."""
...     circuit = BosonicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, hamiltonian, time=total_time, synthesis=BosonicLieTrotter(reps=steps)
...         ),
...         circuit.modes,
...     )
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     qubit_circuit = pass_manager.run(circuit.decompose())
...     # decompose BEFORE evolving: see the warning that follows
...     basis = qubit_circuit.decompose(reps=6)
...     state = np.asarray(Statevector(initial).evolve(basis).data)
...     return densities(state, encoding)
>>>
>>> for steps in (1, 2, 4, 8, 16):
...     error = max(
...         abs(a - b) for a, b in zip(trotter_densities(steps, encoding), reference)
...     )
...     print(f"steps={steps:2d}  max density error = {error:.4f}")
steps= 1  max density error = 0.0843
steps= 2  max density error = 0.0389
steps= 4  max density error = 0.0183
steps= 8  max density error = 0.0088
steps=16  max density error = 0.0043
Błąd zmniejsza się o połowę, gdy liczba kroków się podwaja, co jest sygnaturą formuły iloczynowej pierwszego rzędu. To dowód, że rozbieżność jest błędem Trottera, a kodowanie jest wierne.
Powtórzenia wynikają z synthesis bramki, która trotteryzuje w przestrzeni bozonowej, gdzie grupowanie wciąż istnieje: każdy krok stosuje każdą grupę raz, a kroki następują po sobie. To coś innego niż przekazanie LieTrotter z reps > 1 do wtyczki syntezy na poziomie kubitów. Tam każda grupa jest już własną bramką PauliEvolutionGate, więc formuła tylko dzieli człony wewnątrz grupy i nigdy nie przeplata grup. Grupy nie komutują wzajemnie, więc zostaje pojedynczy zewnętrzny krok Trottera, którego błąd nie maleje, choćby reps było dowolnie duże. Synteza bramki Evolution w przestrzeni bozonowej porównuje oba podejścia i omawia wyższe rzędy.
Poprzednie wywołanie decompose() jest niezbędne. evolve() używa dokładnej definicji PauliEvolutionGate i całkowicie pomija formułę iloczynową. Jeśli weryfikujesz na nierozłożonym obwodzie, zobaczysz niemal idealną zgodność nawet dla celowo błędnej syntezy. Nierozłożony obwód wymusza też zbudowanie gęstego operatora , podczas gdy rozłożony obwód stosuje bramki pojedynczo. Inne symulatory mogą traktować bramkę inaczej, więc ta kontrola zależy od symulatora, a sprzęt zawsze wymaga postaci rozłożonej.
Wreszcie kontrola centralna: fizyka nie może zależeć od tego, które kodowanie wybrano.
>>> def exact_densities(encoding):
...     """Exact truncated-space densities, computed under a given encoding."""
...     width = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
...     start = np.zeros(2**width, dtype=complex)
...     start[fock_index(occupation, encoding)] = 1.0
...     evolved = expm_multiply(
...         -1j * total_time * sparse_matrix(hamiltonian, encoding), start
...     )
...     return densities(evolved, encoding)
>>>
>>> all(
...     bool(np.allclose(exact_densities(name), reference, atol=1e-10))
...     for name in encodings
... )
True
Liczby kubitów, struktury Pauliego i głębokości obwodów różnią się, a fizyka zgadza się do dziesięciu miejsc po przecinku. Kodowanie jest wyborem implementacyjnym, dlatego należy do transpilatora. Dwa warianty unarne zgadzają się tutaj, ponieważ symulowany stan pozostaje na podprzestrzeni one-hot; poza nią by się różniły.
6. Obcięcie jest parametrem zbieżności
Ostatni krok jest specyficzny dla bozonów. Dotąd wszędzie ustalone było max_occupation = 2, czyli . Obcięcie nie jest jednak dowolnym wyborem: to parametr zbieżności, a wynik jest wiarygodny dopiero wtedy, gdy przestaje się zmieniać (zobacz Obcinanie przestrzeni Focka).
Obwód nie zawiera obcięcia, więc sam obwód nie zmienia się, gdy zmienia się odcięcie: powtarzana jest tylko transpilacja. Zmienia się rozmiar wyniku, a przegląd jest tak tani jak tutaj tylko dlatego, że układ jest malutki. Poniższe odniesienie to dokładna klasyczna symulacja obciętej dynamiki, możliwa dla czterech węzłów, a rosnąca wykładniczo z liczbą kubitów. Dla problemu poza jej zasięgiem nie ma dokładnego odniesienia do porównania, a zbieżność trzeba oceniać innymi sposobami.
>>> def densities_at_cutoff(max_occ, encoding=LevelEncoding.GRAY):
...     """Exact truncated-space densities at a given cutoff."""
...     spec = LevelSpec(max_occ, encoding).resolve(num_sites)
...
...     start = np.zeros(2**spec.total_width, dtype=complex)
...     start[
...         sum(encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets))
...     ] = 1.0
...
...     def matrix(operator):
...         observable = occupation_encoding(operator, spec)
...         return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
...
...     evolved = expm_multiply(-1j * total_time * matrix(hamiltonian), start)
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         out.append(float((evolved.conj() @ (matrix(number) @ evolved)).real))
...     return out
>>>
>>> previous = None
>>> for max_occ in (1, 2, 3, 4):
...     current = densities_at_cutoff(max_occ)
...     # Report the drift bucketed rather than to full precision: after it reaches machine
...     # epsilon, the exact digits are arithmetic noise and vary between BLAS builds.
...     if previous is None:
...         drift = "--"
...     else:
...         gap = max(abs(a - b) for a, b in zip(current, previous))
...         drift = f"{gap:.0e}" if gap > 1e-12 else "< 1e-12"
...     print(f"d={max_occ + 1}  "
...           + " ".join(f"{x:.6f}" for x in current)
...           + f"   drift={drift}")
...     previous = current
d=2  0.993986 0.858173 0.141827 0.006014   drift=--
d=3  0.993834 0.858853 0.141309 0.006004   drift=7e-04
d=4  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
d=5  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
Przy max_occupation = 1 () każdy węzeł mieści co najwyżej jeden bozon, więc człon oddziaływania, który potrzebuje dwóch w węźle, w ogóle nie może zadziałać, a gęstości są przesunięte o około . Gdy dodasz trzeci poziom, wynik uwzględnia oddziaływanie, a od max_occupation = 3 wynik jest stacjonarny z dokładnością maszynową: zbieżny.
Powodem, dla którego zatrzymuje się to na max_occupation = 2, jest liczba cząstek. Hamiltonian zachowuje liczbę bozonów, a ten stan zawiera dwa, więc żaden węzeł nigdy nie może zawierać więcej niż dwóch, niezależnie od czasu ewolucji i od tego, czy oddziaływanie jest odpychające, czy przyciągające. Jeśli ewoluujesz do zamiast lub odwrócisz znak , gęstości przy max_occupation = 2 i wyższym pozostają niezmienione do .
To, co faktycznie podnosi wymaganie, to liczba bozonów. Trzy bozony na tym samym łańcuchu zmieniają się o około między max_occupation = 2 a 3 po tej samej krótkiej ewolucji i o około po . To stwierdzenie o tym modelu i wielkości zachowanej; jest to ograniczenie tylko dla operatorów zachowujących liczbę cząstek, a nie reguła ogólna, więc odcięcie trzeba przeglądać, a nie zgadywać.
Przegląd ma cenę także po stronie obwodu, której dokładne odniesienie nie pokazuje. Ten sam obwód bozonowy sprowadzony kodem Graya przy każdym odcięciu:
>>> for max_occ in (1, 2, 3, 4):
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occ, LevelEncoding.GRAY)
...     )
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(decomposed)
...     depth = lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"d={max_occ + 1}  qubits={lowered.num_qubits:2d}  2q-depth={depth:4d}")
d=2  qubits= 4  2q-depth=   8
d=3  qubits= 8  2q-depth=  95
d=4  qubits= 8  2q-depth= 217
d=5  qubits=12  2q-depth=1176
Każdy dodatkowy poziom kosztuje głębokość, a liczba kubitów skacze za każdym razem, gdy przekracza potęgę dwójki. Gdy zbiegasz po , wymieniasz więc dokładność na rozmiar obwodu, więc przegląd to coś więcej niż kontrola numeryczna.
Zauważ też, że prawie poprawne jest zbiegiem okoliczności związanym z obserwablą: gęstości węzłów ledwo się zmieniają, podczas gdy sam stan jest jakościowo błędny (nie ma składowej z podwójnym obsadzeniem). Jeśli jedna obserwabla jest zbieżna, nie dowodzi to, że zbieżna jest inna.
Co warto zapamiętać
-
Kodowanie jest sprawą transpilera. Obwód bozonowy z kroku 3 nie wspomina o obcięciu, kodowaniu ani liczbie kubitów. Cztery kodowania przekształciły go następnie w cztery różne obwody, z których wszystkie odtwarzają tę samą fizykę. Nic przed transpilerem nie musiało się zmienić.
-
W przypadku bozonów to nie tylko wygoda. Obcięcie jest parametrem zbieżności, który trzeba przeskanować, a który znajduje się wewnątrz kodowania. Obwód zbudowany dla ustalonego kodowania trzeba by przebudowywać dla każdej wartości .
-
Grupuj przed mapowaniem i grupuj ze względu na hermitowskość. Pojedynczy człon przeskoku nie jest hermitowski i nie można go zastosować w wykładniku; para wiązania na ręku jest hermitowska, a więc można ją wykładniczo potęgować. Podziel operator na grupy na poziomie bozonowym, gdzie sieć jest jeszcze widoczna. Jest to fizycznie konieczne, a atrybut
groupsistnieje po to, by przenieść tę decyzję dalej. -
Nie zakładaj, że kodowanie o niskiej wadze jest tanie. Dla kody zwarte przewyższają oba warianty unarne jednocześnie pod względem liczby kubitów i bramek, a wariant rzutowany jest najkosztowniejszy ze wszystkich. Mierz; punkt przecięcia zależy od .
-
Obcięcie łamie algebrę w sposób policzalny. Tylko na najwyższym zachowanym poziomie, o . Dlatego też mapowanie nie komutuje z uporządkowaniem normalnym.
Dalsze kroki
Ten przykład można rozszerzyć w dwóch kierunkach. Jeśli zastąpisz listę krawędzi łańcucha wiązaniami sieci kwadratowej, nie potrzeba żadnej innej zmiany, ponieważ zdefiniowana wcześniej funkcja bose_hubbard jest już niezależna od geometrii. Własne kodowanie (na przykład kod blokowo-unarny, który interpoluje między unarnym a zwartym) również podłącza się przez ten sam punkt styku MapperFnEvolutionSynthesis, którego używa preset.
-
Zasady projektowe reprezentacji operatorów wyjaśniają strukturę danych operatora stojącą za hamiltonianem.
-
Mapowanie reprezentacji operatorów omawia kodowania i pisanie własnego mappera.
-
Transpilacja obwodów bozonowych przeprowadza przez etapy, które wykonuje preset.
-
Synteza bramki Evolution w przestrzeni bozonowej pokazuje, jak zmniejszyć błąd Trottera w przestrzeni bozonowej.
Każda podana głębokość dotyczy abstrakcyjnego, w pełni połączonego rejestru. Mapowanie na rzeczywistą łączność sprzętu jest osobnym etapem, a bloki kubitów na tryb w kodowaniu zajętości dają routerowi zupełnie inną strukturę do pracy niż jeden kubit na tryb.
[1]
R. Somma, G. Ortiz, E. Knill i J. Gubernatis, Quantum Simulations of Physics Problems (2003), arXiv:quant-ph/0304063, sek. 4, równ. 22.
[2]
N. P. D. Sawaya, T. Menke, T. H. Kyaw, S. Johri, A. Aspuru-Guzik i G. G. Guerreschi, Resource-efficient digital quantum simulation of d-level systems for photonic, vibrational, and spin-s Hamiltonians, npj Quantum Information 6, 49 (2020), arXiv:1909.12847.